1. 前言
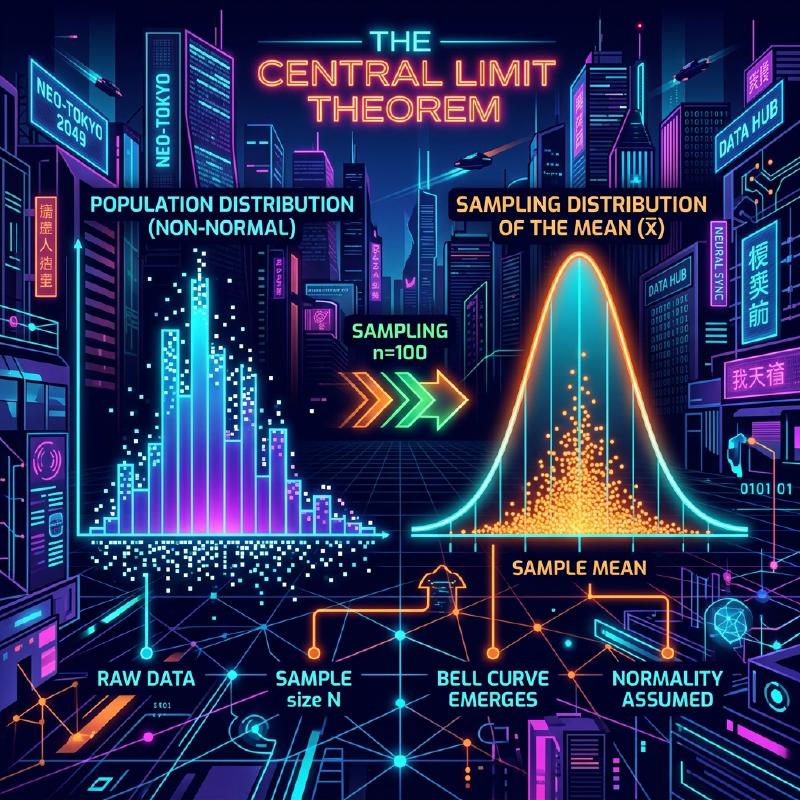
中央極限定理(Central Limit Theorem,CLT)是資料科學與統計學的重要基礎。本文討論觀測值獨立同分配、平均數有限且變異數有限並為正的基本情形。在這些條件下,標準化樣本平均數的分配會隨著樣本數增加而趨近標準常態分配;原始觀測值本身並不會變成常態分配。
本文將針對中央極限定理進行廣泛的解說,從直觀的印象到嚴謹的數學定義,再到實際的應用案例。
2. 什麼是中央極限定理?
中央極限定理(CLT)是機率論與統計學的重要定理。在其基本形式中,如果隨機變數獨立同分配,共同平均數有限且變異數有限並為正,那麼適當標準化後的和或平均數將依分配收斂於標準常態分配。柯西分配等不滿足條件的分配不能直接套用這一基本形式。
2.1 直觀理解
想像一下擲骰子。當擲一顆骰子時,出現的點數分配是均勻分配。然而,如果擲兩顆骰子並將其點數相加,分配就會呈現出以中央的7為頂點的三角形。進一步增加骰子的數量,其總和的分配就會越來越接近平滑的鐘形曲線,亦即 常態分配 。
2.2 數學定義
假設從某母體中隨機抽取的 \(n\) 個觀測值 \(X_1, X_2, \dots, X_n\) 獨立同分配(i.i.d.),共同平均數 \(\mu\) 有限,且變異數滿足 \(0<\sigma^2<\infty\)。
設樣本平均數為 \(\bar{X} = \frac{1}{n} \sum_{i=1}^{n} X_i\)。根據中央極限定理,當 \(n\) 足夠大時,如下所示標準化後的變數 \(Z\) 將收斂於標準常態分配 \(\mathcal{N}(0, 1)\)。
\[ Z = \frac{\bar{X} - \mu}{\frac{\sigma}{\sqrt{n}}} \xrightarrow{d} \mathcal{N}(0, 1) \text{ 當 } n \to \infty \]這裡,\(\xrightarrow{d}\) 表示依分配收斂。\(\text{ 當 } n \to \infty\) 表示樣本數趨近於無限大。
3. 中央極限定理的視覺化
為了直觀地理解中央極限定理的運作方式,以下使用Mermaid繪製了流程圖。
  graph TD
    A["原始分配(非常態分配)"] -->|"抽樣"| B["樣本1"]
    A -->|"抽樣"| C["樣本2"]
    A -->|"抽樣"| D["樣本N"]
    B -->|"計算平均數"| E["樣本平均數1"]
    C -->|"計算平均數"| F["樣本平均數2"]
    D -->|"計算平均數"| G["樣本平均數N"]
    E -->|"繪製分配"| H["近似常態分配"]
    F -->|"繪製分配"| H
    G -->|"繪製分配"| H
4. 使用Python進行模擬
除了理論之外,讓我們實際執行程式來驗證一下。我們將從均勻分配中抽取資料,並模擬其平均數的分配情況。
| |
執行這段程式碼可以發現,當 \(n=1\) 時是均勻分配,但隨著 \(n\) 的增大,直方圖越來越接近紅線的常態分配。
5. 中央極限定理的重要性與應用
中央極限定理的重要性在於:當適用條件成立且樣本數足夠大時,即使不知道母體的精確分配,也可以使用樣本平均數抽樣分配的常態近似進行假說檢定與建構信賴區間。小樣本或厚尾分配等情形仍須另行評估近似精確度。
5.1 統計推論的基礎
無論是在民意調查、品質管制還是A/B測試中,當我們從資料中推論某些結論時,其依據大多仰賴於中央極限定理。
5.2 誤差的累積
測量誤差與自然界中的許多雜訊可以建模為許多微小、獨立因素之和,因此有時可以用常態分配近似。常態分配也稱為高斯分配。
6. 深入探討:證明的方法
中央極限定理的嚴格證明需要使用特徵函數與泰勒展開式。這裡簡要介紹一下。
利用特徵函數 \(\phi_X(t) = E[e^{itX}]\),獨立隨機變數之和的特徵函數等於各個特徵函數的乘積。透過計算標準化變數 \(Z\) 的特徵函數並取 \(n \to \infty\) 的極限,可以證明其收斂於標準常態分配的特徵函數 \(e^{-t^2/2}\)。由此可證明分配本身收斂於常態分配。
7. 結語
中央極限定理是一個極其優美的定理,它揭示了混亂資料背後隱藏的秩序。透過理解這個定理,您將能在資料分析與統計模型建構中獲得更深刻的洞察。
附錄:詳細的數學背景與歷史
附錄 1:在機率論中的發展
中央極限定理有著深厚的歷史,起源於亞伯拉罕·棣美弗證明了二項分配的常態近似。之後,皮埃爾-西蒙·拉普拉斯對其進行了推廣,亞歷山大·李亞普諾夫在更一般的條件下給出了證明。在現代機率論中,存在林德伯格條件與李亞普諾夫條件等各種擴充。這些條件確保了個別隨機變數對總和沒有決定性的影響。這就解答了一個根本性的問題:為什麼自然界與社會科學中各種各樣的現象都能用常態分配來近似。
附錄 2:適用條件與定理的含義
在本文探討的基本形式中,要求 \(X_1,\ldots,X_n\) 獨立同分配,且具有有限平均數 \(\mu\) 與有限正變異數 \(0<\sigma^2<\infty\)。請在這一條件的範圍內理解「無論什麼分配」的說法。趨近於常態分配的是標準化後的和或樣本平均數的分配,而不是各個觀測值的分配發生了改變。
附錄 3:標準誤與大數法則
由獨立性可知,樣本平均數的期望值與變異數如下。標準誤是樣本平均數的標準差,而不是單筆觀測值的標準差。
\[ E[\bar X_n]=\mu,\qquad \operatorname{Var}(\bar X_n)=\frac{\sigma^2}{n},\qquad \operatorname{SE}(\bar X_n)=\frac{\sigma}{\sqrt n}. \]將樣本數增加至4倍,標準誤將減半。大數法則闡述了樣本平均數趨近於 \(\mu\),而中央極限定理則描述了其周圍的波動放大 \(\sqrt{n}\) 倍後的分配形狀。
附錄 4:基於特徵函數證明的補充
設 \(Y_i=(X_i-\mu)/\sigma\),\(Z_n=n^{-1/2}\sum_{i=1}^nY_i\)。由於 \(E[Y_i]=0\),\(E[Y_i^2]=1\),其特徵函數在原點附近可展開為:
\[ \phi_Y(t)=E[e^{itY}]=1-\frac{t^2}{2}+o(t^2)\quad(t\to0). \]根據獨立性可得下式。極限是標準常態分配的特徵函數,因此根據萊維連續性定理可知其依分配收斂。特徵函數與動差母函數不同,此證明並不需要動差母函數的存在。
\[ \phi_{Z_n}(t)=\left[\phi_Y\!\left(\frac{t}{\sqrt n}\right)\right]^n =\left[1-\frac{t^2}{2n}+o\!\left(\frac1n\right)\right]^n \longrightarrow e^{-t^2/2}. \]附錄 5:不適用的例子與近似精確度
柯西分配既沒有有限的平均數,也沒有有限的變異數,獨立的標準柯西變數的樣本平均數仍然是標準柯西分配。此外,如果所有的 \(X_i\) 都等於同一個非退化隨機變數,則它們是不獨立的,取平均值也不會減少離散程度。也沒有保證「只要 \(n\ge30\) 就足夠了」。所需的樣本數因偏度與尾部厚度而異。對於獨立但不同分配的擴充,必須確認諸如林德伯格條件或李亞普諾夫條件等附加條件。