1. Введение
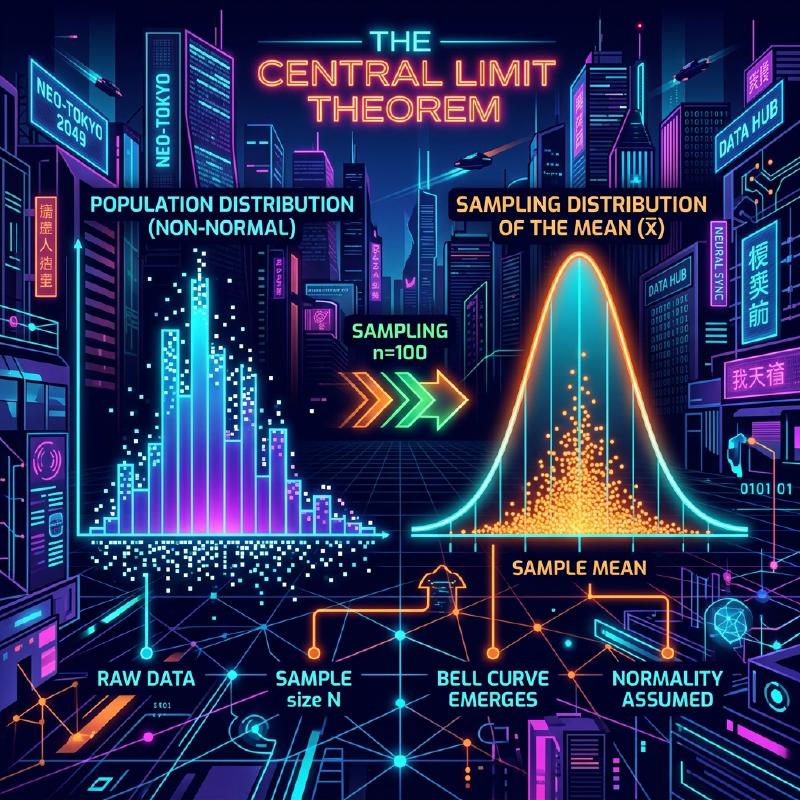
Центральная предельная теорема (ЦПТ) — важная основа науки о данных и статистики. Здесь рассматриваются независимые одинаково распределённые наблюдения с конечным математическим ожиданием и конечной положительной дисперсией. При этих условиях распределение стандартизированного выборочного среднего приближается к стандартному нормальному с ростом размера выборки. Распределение самих исходных наблюдений при этом не становится нормальным.
В этой статье мы подробно объясним Центральную предельную теорему: от интуитивного представления до строгого математического определения и примеров практического применения.
2. Что такое Центральная предельная теорема?
Центральная предельная теорема (ЦПТ) — важный результат теории вероятностей и статистики. В её базовой форме должным образом стандартизированная сумма или среднее независимых одинаково распределённых случайных величин сходится по распределению к стандартному нормальному, если общее математическое ожидание конечно, а дисперсия конечна и положительна. К распределениям, не удовлетворяющим этим условиям, например распределению Коши, эта форма неприменима.
2.1 Интуитивное понимание
Возьмем игральные кости. При броске одной кости распределение результатов является равномерным. Однако, если бросить две кости и сложить их значения, распределение принимает форму треугольника с вершиной на 7. Если мы продолжим увеличивать количество костей, распределение их суммы будет приближаться к плавной колоколообразной кривой, то есть к нормальному распределению.
2.2 Математическое определение
Предположим, что \(n\) наблюдений \(X_1, X_2, \dots, X_n\) независимы и одинаково распределены (н.о.р.), с конечным общим математическим ожиданием \(\mu\) и дисперсией \(0<\sigma^2<\infty\).
Пусть выборочное среднее равно \(\bar{X} = \frac{1}{n} \sum_{i=1}^{n} X_i\). Согласно Центральной предельной теореме, когда \(n\) достаточно велико, стандартизированная переменная \(Z\), как показано ниже, сходится к стандартному нормальному распределению \(\mathcal{N}(0, 1)\).
\[ Z = \frac{\bar{X} - \mu}{\frac{\sigma}{\sqrt{n}}} \xrightarrow{d} \mathcal{N}(0, 1) \text{ при } n \to \infty \]Здесь \(\xrightarrow{d}\) означает сходимость по распределению. \(\text{ при } n \to \infty\) указывает на то, что размер выборки стремится к бесконечности.
3. Визуализация Центральной предельной теоремы
Чтобы визуально понять, как работает Центральная предельная теорема, ниже представлена диаграмма процесса с использованием Mermaid.
  graph TD
    A["Исходное распределение (Ненормальное)"] -->|"Выборка"| B["Выборка 1"]
    A -->|"Выборка"| C["Выборка 2"]
    A -->|"Выборка"| D["Выборка N"]
    B -->|"Вычисление среднего"| E["Выборочное среднее 1"]
    C -->|"Вычисление среднего"| F["Выборочное среднее 2"]
    D -->|"Вычисление среднего"| G["Выборочное среднее N"]
    E -->|"Построение распределения"| H["Приближение к нормальному распределению"]
    F -->|"Построение распределения"| H
    G -->|"Построение распределения"| H
4. Симуляция с использованием Python
Вместо того чтобы ограничиваться теорией, давайте запустим программу, чтобы проверить это. Мы смоделируем извлечение данных из равномерного распределения и посмотрим, как распределено их среднее значение.
| |
Запустив этот код, вы можете убедиться, что при \(n=1\) мы получаем равномерное распределение, но по мере увеличения \(n\) гистограмма приближается к нормальному распределению (красная линия).
5. Важность и применение Центральной предельной теоремы
Если условия ЦПТ выполнены, а выборка достаточно велика, нормальное приближение распределения выборочного среднего позволяет проверять гипотезы и строить доверительные интервалы, не зная точного распределения генеральной совокупности. Для малых выборок или распределений с тяжёлыми хвостами точность приближения нужно оценивать отдельно.
5.1 Основа статистического вывода
Когда мы делаем выводы на основе данных, как, например, в опросах общественного мнения, контроле качества или A/B-тестировании, большая часть аргументации опирается на Центральную предельную теорему.
5.2 Накопление ошибок
Ошибки измерений и многие природные шумы можно моделировать как суммы небольших независимых воздействий, поэтому нормальное приближение может быть подходящим. Нормальное распределение также называют распределением Гаусса.
6. Углубление: Подход к доказательству
Для строгого доказательства Центральной предельной теоремы используются характеристические функции и разложение Тейлора. Вот краткий обзор.
Используя характеристическую функцию \(\phi_X(t) = E[e^{itX}]\), характеристическая функция суммы независимых случайных величин равна произведению их соответствующих характеристических функций. Если мы вычислим характеристическую функцию стандартизированной переменной \(Z\) и найдем предел при \(n \to \infty\), можно показать, что она сходится к характеристической функции стандартного нормального распределения \(e^{-t^2/2}\). Это доказывает, что само распределение сходится к нормальному.
7. Заключение
Центральная предельная теорема — чрезвычайно красивая теорема, которая показывает порядок, скрытый за хаотичными данными. Понимание этой теоремы позволит вам получить более глубокие знания в области анализа данных и построения статистических моделей.
Приложение: Подробный математический фон и история
Приложение 1: Развитие в теории вероятностей
История Центральной предельной теоремы уходит корнями в прошлое: она берет начало от Абрахама де Муавра, который показал нормальное приближение биномиального распределения. Позже она была расширена Пьером-Симоном Лапласом, а Александр Ляпунов представил доказательство при более общих условиях. В современной теории вероятностей существуют различные расширения, такие как условие Линдеберга и условие Ляпунова. Эти условия гарантируют, что отдельные случайные величины не оказывают доминирующего влияния на общую сумму. Это дает ответ на фундаментальный вопрос о том, почему различные явления в природе и социальных науках можно аппроксимировать нормальным распределением.
Приложение 2: Условия применения и смысл теоремы
В базовой форме, обсуждаемой в этом тексте, требуется, чтобы \(X_1,\ldots,X_n\) были независимыми и одинаково распределенными с конечным средним \(\mu\) и конечной положительной дисперсией \(0<\sigma^2<\infty\). Пожалуйста, понимайте выражение «любое распределение» в рамках этих условий. К нормальному распределению приближается распределение стандартизированной суммы или выборочного среднего, а распределение отдельных наблюдений не меняется.
Приложение 3: Стандартная ошибка и закон больших чисел
В силу независимости математическое ожидание и дисперсия выборочного среднего равны следующему. Стандартная ошибка — это стандартное отклонение выборочного среднего, а не отдельных наблюдений.
\[ E[\bar X_n]=\mu,\qquad \operatorname{Var}(\bar X_n)=\frac{\sigma^2}{n},\qquad \operatorname{SE}(\bar X_n)=\frac{\sigma}{\sqrt n}. \]Увеличение размера выборки в четыре раза уменьшает стандартную ошибку вдвое. Закон больших чисел утверждает, что выборочное среднее приближается к \(\mu\), а Центральная предельная теорема описывает форму распределения, умножая колебания вокруг него на \(\sqrt{n}\).
Приложение 4: Дополнительное доказательство с использованием характеристических функций
Пусть \(Y_i=(X_i-\mu)/\sigma\) и \(Z_n=n^{-1/2}\sum_{i=1}^nY_i\). Поскольку \(E[Y_i]=0\) и \(E[Y_i^2]=1\), характеристическую функцию можно разложить вблизи начала координат следующим образом.
\[ \phi_Y(t)=E[e^{itY}]=1-\frac{t^2}{2}+o(t^2)\quad(t\to0). \]Из независимости получается следующее уравнение. Поскольку предел является характеристической функцией стандартного нормального распределения, сходимость по распределению следует из теоремы непрерывности Леви. Характеристические функции и производящие функции моментов — это разные вещи, и для этого доказательства наличие производящей функции моментов не требуется.
\[ \phi_{Z_n}(t)=\left[\phi_Y\!\left(\frac{t}{\sqrt n}\right)\right]^n =\left[1-\frac{t^2}{2n}+o\!\left(\frac1n\right)\right]^n \longrightarrow e^{-t^2/2}. \]Приложение 5: Неприменимые примеры и точность аппроксимации
Распределение Коши не имеет ни конечного среднего, ни конечной дисперсии, и выборочное среднее независимых стандартных переменных Коши остается стандартным распределением Коши. Кроме того, если все \(X_i\) равны одной и той же невырожденной случайной величине, независимость отсутствует, и усреднение не уменьшит разброс. Также нет гарантии, что «\(n\ge30\) всегда достаточно». Необходимый размер выборки варьируется в зависимости от асимметрии и тяжелых хвостов. Для расширений на независимые, но неодинаково распределенные величины, необходимо проверить дополнительные условия, такие как условия Линдеберга или Ляпунова.