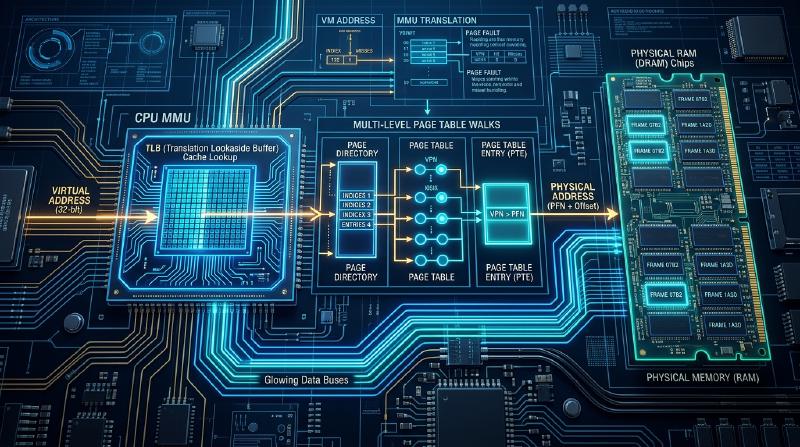
仮想記憶とページング機構の完全解剖:MMUからTLB、HugePage、そしてメモリ管理の深淵まで
現代のオペレーティングシステム(OS)とCPUアーキテクチャにおいて、最も複雑でありながら最も重要なシステムの一つが「仮想記憶(Virtual Memory)」と「ページング(Paging)」の機構です。アプリケーション開発者が普段意識することのないメモリ空間の背後では、ハードウェアのMMU(Memory Management Unit)とOSカーネルが密接に連携し、ナノ秒の世界で膨大なアドレス変換と例外処理を行っています。
本記事では、オペレーティングシステム内部構造とコンピュータアーキテクチャの観点から、仮想記憶システムの最深部を解剖します。x86-64アーキテクチャのページテーブル構造の完全なビットレイアウトから、TLBシュートダウンのIPIプロトコル、Linuxカーネルにおけるページフォルトの完全なトレース、Copy-on-Write(CoW)の物理メカニズム、メモリ回収(Reclaim)アルゴリズム、OOM Killerのスコア計算式に至るまで、低レイヤのメカニズムをソースコードレベル・レジスタレベルで徹底的に解説します。
第1章:仮想記憶の存在理由と歴史的背景
なぜコンピュータには仮想記憶が必要なのでしょうか。初期のコンピュータシステムでは、プログラムは物理メモリ(RAM)の特定のアドレスに直接アクセスしていました。しかし、マルチタスク環境が普及するにつれ、この「物理アドレス直接指定方式」は限界を迎えました。
1.1 メモリ保護とプロセス空間の完全な分離
仮想記憶の最大の目的は「セキュリティと安定性の担保」です。プロセスAがプロセスBのメモリを誤って(あるいは悪意を持って)書き換えてしまえば、システム全体がクラッシュしたり、機密情報が漏洩したりします。仮想記憶は、各プロセスに対して「自分専用の連続したメモリ空間を持っている」という幻想を与えます。これにより、プロセス間のメモリはハードウェアレベル(MMU)で厳格に分離され、不正なメモリアクセスは即座にトラップされ、セグメンテーションフォルトとして処理されます。ユーザー空間とカーネル空間の分離もこの機構によって実現されており、特権リングの遷移とメモリアクセス権限のチェックはハードウェアによって毎サイクル行われています。
1.2 物理メモリ容量の壁の打破とデマンドページングの思想
アプリケーションが要求するメモリ量が、搭載されている物理RAMの容量を超えることは珍しくありません。仮想記憶は、現在使用されていないメモリ領域(ページ)を二次記憶装置(HDD/SSD)に退避(スワップアウト)し、必要になったら再度読み込む(スワップイン)ことで、物理メモリ以上の広大なアドレス空間を提供します。また、プログラムの実行開始時に全てのコードやデータをメモリに読み込むのではなく、アクセスが発生した時点で初めてメモリにロードする「デマンドページング(要求時ページング)」の思想により、メモリの節約と起動の高速化を両立しています。
1.3 セグメンテーションからページングへのパラダイムシフト
初期のx86(80286等)では、可変長のブロックでメモリを管理する「セグメンテーション」が用いられました。CS(コードセグメント)、DS(データセグメント)などのレジスタを用いて、論理アドレスをベースアドレス+オフセットで計算する方式です。しかし、セグメンテーションは「外部フラグメンテーション(メモリの断片化)」を引き起こしやすく、管理が極めて煩雑でした。その後、80386の登場により、固定長(通常4KB)のブロックで管理する「ページング」が導入され、主流となりました。現代の64ビットOS(LinuxやWindows)は、セグメンテーションをフラットメモリモデル(ベースアドレス0、リミット最大)として事実上無効化し、ページングのみでメモリ管理を行っています。セグメンテーションは現在、スレッドローカルストレージ(TLS)の参照(FS/GSレジスタ)など、ごく一部の用途にのみ使われています。
第2章:x86-64におけるページテーブルの多段構造とビットレイアウトの完全解剖
64ビットアーキテクチャ(x86-64/AMD64)において、仮想アドレス空間は広大です。現在主流の「48ビット仮想アドレス空間」では、ハードウェアMMUが4段のページテーブルを走査します。
2.1 48bit/57bit仮想アドレス空間と正準形(Canonical Form)の制約
64ビットレジスタは16エクサバイトという広大なアドレス空間を表現できますが、現在のハードウェア実装ではコストと複雑さの観点から全てを使用していません。48ビット実装では、仮想アドレスのビット47から63まではすべて同じ値(符号拡張)でなければならないという制約があります。この制約を満たすアドレスを「正準形アドレス(Canonical Address)」と呼びます。
これにより、メモリ空間は中央に巨大な未使用領域(Non-canonicalホール)を持つ構造となり、下半分のユーザー空間(0x0000000000000000 ~ 0x00007FFFFFFFFFFF)と上半分のカーネル空間(0xFFFF800000000000 ~ 0xFFFFFFFFFFFFFFFF)に綺麗に二分されます。不正なポインタ(例えば最上位ビットにメタデータを埋め込んだポインタ)をデリファレンスすると、MMUはCanonical違反として即座に一般保護例外(#GP)を発生させます。近年、Intel Ice Lake以降のプロセッサでは、これをさらに拡張した57ビット仮想空間(5段ページテーブル)もサポートされ始めており、ペタバイト級のメモリを扱うクラウドインフラの基盤となっています。
2.2 4段ページテーブルの階層構造(PML4, PDPT, PD, PT)の詳細
48ビット仮想アドレスを物理アドレスに変換するために、x86-64は4階層のページテーブル(Radix Tree状のデータ構造)を使用します。各テーブルは4KBのサイズを持ち、512個の64ビット(8バイト)エントリを格納します(2^9 = 512)。仮想アドレスは以下のように分割され、各階層のインデックスとして機能します。
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - 最上位。CR3レジスタが物理ベースアドレスを指す。
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - 2MB HugePageの場合はここが終端となる。
- Bits 12-20 (9 bits): PT (Page Table) Index - 通常の4KBページにおける最終テーブル。
- Bits 0-11 (12 bits): Page Offset - 4KB(4096バイト)ページ内のオフセット。
2.3 ページテーブルエントリ(PTE)の64ビットレイアウト完全表
ページテーブルの各64bitエントリは、単なる物理アドレスのポインタではなく、強力なアクセス制御とキャッシュ制御を司るメタデータの集合体です。以下にx86-64のPTEの完全なビットレイアウトとその詳細な機能を示します。
- Bit 0 [P] Present: 1なら物理メモリ上に存在。0ならスワップアウト済み、または未割り当て。0の時にアクセスするとページフォルト(#PF)例外が発生。
- Bit 1 [R/W] Read/Write: 0ならRead-Only(書き込み不可)、1ならRead/Write可能。CoW(Copy-on-Write)の実装において極めて重要な役割を果たす。
- Bit 2 [U/S] User/Supervisor: 0なら特権モード(カーネル)のみアクセス可能。1ならユーザーモード(Ring 3)からもアクセス可能。KPTIやSMAPなどで厳密に管理される。
- Bit 3 [PWT] Page-level Write-Through: 1ならこのページに対するキャッシュの書き込みポリシーをWrite-Throughにする。0ならWrite-Back。
- Bit 4 [PCD] Page-level Cache Disable: 1ならこのページのキャッシュを無効化(Uncacheable)。メモリマップドI/O(MMIO)などでPCIeデバイスのレジスタに直接アクセスする際に使用。
- Bit 5 [A] Accessed: MMUがこのページにアクセス(ReadまたはWrite)した際にハードウェアによって自動的に1にセットされる。OSのLRUアルゴリズム(ページ回収)で参照ビットとして利用される。
- Bit 6 [D] Dirty: MMUがこのページに「書き込み」を行った際にハードウェアによって自動的に1にセットされる。ディスクへの書き戻し(スワップアウト)が必要かどうかをOSが判断するために必須のビット。
- Bit 7 [PAT] Page Attribute Table: PWT/PCDと組み合わせて、より詳細なメモリキャッシュタイプ(WC: Write-Combiningなど)を指定するためのインデックス。グラフィックメモリ(VRAM)への高速なバルク転送などで利用。
- Bit 8 [G] Global: 1なら、CR3レジスタが切り替わっても(コンテキストスイッチが発生しても)TLBからこのエントリをフラッシュしない。主にカーネル空間のページで使用され、システムコール時のTLBミスのペナルティを回避する。
- Bits 9-11 [AVL] Available: OS(カーネル)が自由に利用できる3ビット。Linuxではスワップエントリのメタデータや、NUMAノードの識別などに活用されることがある。
- Bits 12-51 [PFN] Physical Frame Number: 変換先の物理ページのベースアドレス(物理フレーム番号)。4KBアラインされているため下位12ビットは常に0として扱われる。
- Bits 52-62 [AVL/PKU] Available/Ignored: CPUの世代や機能拡張(Intel MPK: Memory Protection Keysなど)によって予約、またはOS使用可能領域。
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: 1ならこのページ上のデータを「命令として実行不可」にする。バッファオーバーフロー等によるデータ領域へのコードインジェクション攻撃を防ぐ強力なセキュリティ機構(DEP: Data Execution Prevention)。
このように、PTEの各ビットはOSのメモリ管理アルゴリズム(特にスワップ処理やセキュリティ保護、I/O制御)と密接に結合しており、ハードウェアとソフトウェアの境界線上のインターフェースとして極めて洗練された設計となっています。
第3章:MMUによるハードウェア・ページテーブルウォークと遅延の壁
仮想アドレスから物理アドレスへの変換は、CPUのコア内部に存在する**MMU (Memory Management Unit)**という専用ハードウェア回路によって行われます。
3.1 CR3レジスタを起点とするテーブルウォークのメカニズム
プロセッサのコントロールレジスタ CR3 には、現在実行中のプロセスのトップレベルページテーブル(PML4)の物理アドレスが格納されています。LinuxなどのOSは、コンテキストスイッチを行って別のプロセスにCPUの実行権を譲る際、この CR3 レジスタを新しいプロセスのPML4アドレスに書き換えます。これにより、プロセスのメモリ空間全体が瞬時に切り替わります。
以下に概念的なフローを示します。
- 仮想アドレスの最上位インデックスを取り出し、CR3が指すPML4テーブルの該当エントリを読み取る。
- PML4エントリのPFNを取り出し、次のPDPTテーブルの物理アドレスを算出。
- PDPTテーブルの該当エントリを読み取る。
- 同様にPDテーブル、PTテーブルと辿り、最終的な4KB物理ページのベースアドレスを得る。
- 最後に12ビットのページオフセットを加算し、完全な物理アドレスを構築する。
3.2 メモリバスアクセスと遅延(レイテンシ)という最大の壁
この4段ページテーブルウォークの最大の弱点は「メモリアクセスレイテンシ」です。仮想アドレス1つを変換するだけで、最悪の場合、物理メモリに対して4回のアクセス(PML4, PDPT, PD, PTの読み取り)が発生します。 現代のDRAMのアクセスレイテンシは約50〜100ナノ秒です。もし4回のメモリアクセスがすべてCPUのキャッシュ(L1/L2/L3)をミスしてDRAMまで到達した場合、それだけで数百ナノ秒のストールが発生します。CPUのクロックサイクルが0.3ナノ秒(3GHz)程度であることを考えると、これは数千サイクルに相当する致命的な遅延であり、CPUのパイプラインは完全に枯渇し停止してしまいます。 この極めて深刻なパフォーマンスの壁を打ち破るために設計されたのが、次に解説するTLBです。
第4章:マルチコア環境におけるTLBのアーキテクチャとシュートダウンの苦悩
TLB(Translation Lookaside Buffer)は、MMU内に組み込まれた「仮想アドレスから物理アドレスへの変換結果のキャッシュ」であり、超高速なSRAM(またはCAM: Content Addressable Memory)で構成されています。
4.1 TLBの階層構造とPCID(Process-Context Identifier)による最適化
最新のCPUでは、TLBもL1/L2の階層構造を持っています。L1 D-TLB(データ用)やL1 I-TLB(命令用)は非常に小容量(数十エントリ)ですが1サイクルで応答します。L2 TLBは数百から数千エントリを持ち、数サイクルで応答します。 TLBにエントリが存在しない場合(TLBミス)、前述のハードウェア・テーブルウォーク(ページウォーク)が発生します。これを支援するため、ページウォーク専用のキャッシュ(PWC: Page Walk Cache)も実装されています。
プロセスが切り替わると仮想アドレスの意味が変わるため、従来(x86の初期)はCR3の書き換え時にTLBを全消去(Flush)していました。しかし、これではコンテキストスイッチの直後にTLBミスが多発し、パフォーマンスが著しく低下します。 これを解決するために導入されたのが、**PCID(Process-Context Identifier)**という技術です(ARMアーキテクチャではASIDと呼ばれます)。TLBエントリにプロセスを一意に識別する12ビットのID(タグ)を付与することで、コンテキストスイッチ後も以前のプロセスのTLBエントリを保持し続けることが可能になり、Webサーバーやデータベースなどのマルチプロセス環境におけるパフォーマンスが劇的に向上しました。
4.2 TLBシュートダウン(TLB Shootdown)のインタープロセッサ割り込み(IPI)プロトコル
マルチコア環境において、仮想記憶システムは非常に厄介な同期問題に直面します。例えば、コア0(CPU0)上で動作するプロセスが特定のメモリ領域を munmap() で解放し、ページテーブルのPTEを無効化(Present = 0)したとします。しかし、コア1(CPU1)のローカルなTLBには、まだその仮想アドレスから物理アドレスへの「古い変換情報(Stale TLB Entry)」がキャッシュとして残っている可能性があります。
このままでは、コア1が解放済みのメモリにアクセスしてしまい、他のプロセスに割り当てられたデータを破壊したり、機密情報を読み取ってしまったりする深刻なセキュリティホールに繋がります。これを防ぐために、OSはコア1のTLBから該当エントリを強制的に削除させる必要があります。これが**TLBシュートダウン(TLB Shootdown)**です。
TLBシュートダウンは以下のステップ(IPIプロトコル)で厳密に実行されます:
- イニシエータ(コア0): ページテーブルを更新(PTEをクリア)した後、メモリバリア(
mfence等)を発行し、対象となる他のコア(コア1)のローカルAPIC(Advanced Programmable Interrupt Controller)に対して**IPI(Inter-Processor Interrupt: プロセッサ間割り込み)**を送信する。 - 待機(ビジーウェイト): コア0は、他のすべてのターゲットコアが割り込みを処理し終えるまでスピンロックで待機する。
- ターゲット(コア1): IPIを受信すると、現在実行中のユーザーコードを即座に中断し、カーネルの割り込みハンドラ(Linuxでは
smp_call_functionを経由したflush_tlb_func等)に遷移する。 - フラッシュ実行: コア1は自身のローカルTLBから指定された仮想アドレスのエントリを無効化する(x86では
INVLPG命令を使用、全フラッシュの場合はCR3を再ロード)。 - 完了通知: コア1はフラッシュ完了をメモリ上のフラグに書き込み、コア0の待機を解除する。その後、中断していた処理に復帰(
iret)する。
パフォーマンスのボトルネックとスケーラビリティの限界: TLBシュートダウンは、ハードウェアのIPI発行、割り込みのコンテキストスイッチ、パイプラインのフラッシュ、そして複数コア間のスピンロック待機を伴うため、数千〜数万サイクルを消費する極めて高コストな操作です。コア数が16, 64, 128と増えれば増えるほど、この同期コストは指数関数的に増加し、クラウドサーバーやHPCにおけるマルチスレッドアプリケーション(特に頻繁にメモリの確保・解放を繰り返すもの)の深刻なスケール阻害要因となっています。
第5章:Linuxカーネルにおけるページフォルト処理の完全なトレース
プログラムが、ページテーブルの Present ビットが0の領域や、権限のない領域(Read-Onlyに書き込もうとした、ユーザーモードからカーネル領域にアクセスした等)にアクセスすると、MMUは**ページフォルト例外(x86では Exception 14, #PF)**を発行します。ここから、Linuxカーネルの深遠なる例外処理への旅が始まります。
5.1 ページフォルトの制御フローとアーキテクチャ依存部のトレース
x86-64のLinuxカーネルにおいて、ページフォルトが発生した際の関数呼び出しグラフ(コールトレース)は以下のようになります。アーキテクチャ依存の低レベルハンドラから、アーキテクチャ非依存の汎用メモリ管理サブシステムへと制御が移ります。
asm_exc_page_fault(アセンブリ言語: arch/x86/entry/entry_64.S)- CPUが例外を検知し、ハードウェアが
CR2レジスタにフォルトが発生した仮想アドレスをセットし、割り込みスタックにレジスタ状態を退避してカーネルのエントリポイントにジャンプします。
- CPUが例外を検知し、ハードウェアが
exc_page_fault()(C言語: arch/x86/mm/fault.c)- アーキテクチャ依存のフォールトハンドラです。エラーコード(Read/Write、User/Kernel、PF等)を解析し、割り込みコンテキストの確認などを行います。
do_page_fault()/do_user_addr_fault()- フォルトが発生したのがカーネル空間(バグやvmalloc領域等)かユーザー空間かを判定します。ユーザー空間の場合、対象プロセスのメモリマップ(
vm_area_structの赤黒木・VMAリスト)を検索し、そのアドレスが正当な領域に属しているか(セグメンテーションフォルトでないか)を確認します。
- フォルトが発生したのがカーネル空間(バグやvmalloc領域等)かユーザー空間かを判定します。ユーザー空間の場合、対象プロセスのメモリマップ(
handle_mm_fault()(C言語: mm/memory.c)- ここからがアーキテクチャ非依存のコア関数です。ページテーブルの各階層(PGD -> P4D -> PUD -> PMD -> PTE)を走査し、まだテーブルが割り当てられていなければ中間ディレクトリを新規にアロケート(
pmd_alloc等)しながら、最終的なPTEのアドレスを特定します。
- ここからがアーキテクチャ非依存のコア関数です。ページテーブルの各階層(PGD -> P4D -> PUD -> PMD -> PTE)を走査し、まだテーブルが割り当てられていなければ中間ディレクトリを新規にアロケート(
5.2 メモリ割り当ての真髄:handle_mm_faultからの分岐
handle_mm_fault() は、特定したPTEの状態(PTEが空か、スワップアウトされているか、権限エラーか)に応じて、実際のページ割り当て処理を分岐させます。
do_anonymous_page()(デマンドページングの極致): PTEが完全に空(ゼロ)の場合に呼ばれます。ヒープ(mallocの裏側であるbrkやmmap)やスタックの拡張など、ファイルに紐付かない無名ページ(Anonymous Page)への初回アクセスです。カーネルはここで初めて物理メモリ(フレーム)をバディシステム(Buddy System)から確保し、ゼロクリアしてPTEにマッピングします。これにより、使われないメモリを節約します。do_fault()/__do_fault()(ファイルバックド・ページング):mmapされたファイルなどの初回アクセス時に呼ばれます。ページキャッシュからファイルデータを読み込み、あるいはファイルシステム(ext4やxfs)のドライバを呼び出してディスクからデータをロードし、ページテーブルにマッピングします。do_swap_page()(スワップインの苦痛): PTEのPresentビットが0だが、別のフラグビットにスワップ領域のオフセット情報が記録されている場合に呼ばれます。ディスク(スワップパーティションやスワップファイル)から物理メモリへデータをロードし直します。ディスクI/Oを伴うため、プロセスはここで長時間のSleep(ブロック)状態に入ります。do_wp_page()(Copy-on-Write): 後述するCoWの処理です。Present=1だが、Write権限がないページに書き込もうとした場合に呼ばれます。
5.3 Copy-on-Write(CoW)の物理メカニズムと参照カウントの魔法
Linuxプロセス生成の要である fork() システムコールは、CoW(Copy-on-Write)という遅延評価メカニズムによって極めて高速に動作します。親プロセスが数GBのメモリを使用していても、fork() が一瞬で完了する背後の物理メカニズムを解説します。
- ページテーブルの共有:
fork()が呼ばれると、カーネルは親プロセスのページテーブルを子プロセスへそのままコピーします。しかし、物理メモリそのものは一切コピーしません。親と子のPTEは、全く同じ物理メモリ(フレーム)を指し示します。 - Read-Onlyビットの強制設定(Write-Protect):
この時、カーネルは共有されたすべてのページのPTEの
R/Wビットを0(Read-Only)に強制的に書き換えます(元々書き込み可能であったデータ領域なども全てです)。 - 参照カウント(Reference Count)のインクリメント:
対象となる物理ページを管理するカーネル構造体(
struct pageの_refcount)をインクリメントし、「2つのプロセスから参照されている」状態にします。 - 書き込みとページフォルト(do_wp_pageのトリガー):
親または子のどちらかが、共有している変数やヒープ領域に書き込み(Write)を行おうとすると、ハードウェアMMUが
R/W=0を検知し、即座にページフォルトを発生させます。 - ページの複製(Duplication):
ページフォルトハンドラから
do_wp_page()が呼び出されます。カーネルはVMAのフラグを確認し、「これは不正アクセスではなく、正当なCoWによるフォルトだ」と判断します。新しい物理ページを1つバディシステムから確保し、元のページのデータを丸ごとコピー(copy_page)します。 - PTEの更新と参照カウントのデクリメント:
書き込みを行ったプロセスのPTEを新しい物理ページに向け直し、
R/Wビットを1(Read/Write可)にします。そして元の物理ページの参照カウントはデクリメントされます。もし参照カウントが1になれば、もう一方のプロセスがそのページを独占している状態となるため、次にそのプロセスがフォルトを起こした際は、メモリのコピーを行わずに単にR/Wビットを1に戻すだけで済みます(ページ再利用)。
このように、CoWはMMUのハードウェア保護機能(Read-Onlyトラップ)とカーネルのソフトウェア制御が見事に融合した芸術的なアルゴリズムであり、メモリの劇的な節約とプロセスの高速起動を実現しています。
第6章:メモリ回収(Reclaim)アルゴリズムの深淵とOOM Killerの断罪
物理メモリは有限です。システムが長期間稼働し、ファイルキャッシュやプロセスのヒープがメモリを食い尽くすと、OSは新たにメモリを確保するために、既存のメモリ領域を解放・回収(Reclaim)しなければなりません。このメモリ回収サブシステムは、Linuxカーネルの中でも最も複雑で難解な領域の一つです。
6.1 アクティブ/非アクティブLRUリストと疑似LRUアルゴリズム
Linuxカーネルは、物理ページを管理・追跡するためにLRU(Least Recently Used)リストを使用します。しかし、全ページを厳密なLRUで管理することはロックの競合や走査コストの面で不可能です。そこで、「Activeリスト」と「Inactiveリスト」の2つのキュー(リスト)を用いた疑似LRUアルゴリズム(Clockアルゴリズムの派生)を採用しています。
- Activeリスト: 最近頻繁にアクセスされている「ホット」なページの集合。ここは回収の対象にはなりません。
- Inactiveリスト: しばらくアクセスされていない「コールド」なページの集合。末尾(tail)にあるページから順番に回収の候補となります。
カーネルは、どのようにしてページがアクセスされたかを知るのでしょうか?ここで第2章で解説したPTEの Accessedビット(Aビット) が活躍します。カーネル(kswapd)はページテーブルを定期的に走査し、PTEからAビットを読み取り、ソフトウェア側にアクセス履歴を記録した上でAビットを0にクリアします。Aビットが再びハードウェアによって1にセットされていれば、そのページはActiveリストに留まるか、Inactiveから昇格します。セットされていなければ、徐々にInactiveリストの末尾へと降格していきます。
6.2 kswapdデーモンとダイレクトリクレイム(Direct Reclaim)の恐怖
メモリの空き容量(Free Pages)が特定のしきい値(ウォーターマーク:low)を下回ると、カーネルのバックグラウンドスレッドである kswapd(各NUMAノードごとに存在する)が目を覚まします。
kswapd は、Inactiveリストの末尾からページを取り出します。
- それがクリーンなファイルキャッシュ(変更されていないファイルデータ)であれば、単に破棄(Drop)してメモリを空けます。
- それがダーティな(変更された)ファイルキャッシュであれば、ディスクに書き戻し(Writeback)してから破棄します。
- それが無名ページ(プロセスのヒープやスタック)であれば、スワップ領域へ書き出します(スワップアウト)。
空き容量が
highウォーターマークに達するまでこのバックグラウンド作業を続けます。
しかし、アプリケーションのメモリ確保速度(メモリプレッシャー)が極めて高く、kswapd の回収速度が追いつかずに空きメモリが極限のしきい値(min ウォーターマーク)を割り込むと、ダイレクトリクレイム(Direct Reclaim) が発動します。
ダイレクトリクレイムとは、メモリを要求したプロセス(アプリケーション自身)のコンテキストで、直接メモリ回収処理(キャッシュの破棄やスワップアウト)を同期的に実行させる仕組みです。ダイレクトリクレイムに入ると、アプリケーションの実行(malloc やページフォルトの完了)は完全にストール(停止)するため、数百ミリ秒から数秒に及ぶ深刻なパフォーマンス低下(レイテンシスパイク)の直接的な原因となります。データベースやリアルタイムシステムでは、これを避けるためのチューニング(vm.swappiness やウォーターマークの調整)が必須です。
6.3 OOM Killerのスコア計算式とプロセスの断罪
ダイレクトリクレイムを行っても、スワップ領域も枯渇し、キャッシュも削りきり、どうしてもメモリを確保できない場合、Linuxカーネルは最終手段として OOM (Out Of Memory) Killer を召喚します。
OOM Killerは、システム全体がメモリ不足でパニック(カーネルクラッシュや完全なフリーズ)に陥るのを防ぐため、メモリを大量に消費しているプロセスを「強制終了(SIGKILL)」させてメモリを奪い返します。犠牲者を決定する冷酷なアルゴリズムが存在します。
どのプロセスを殺すかの決定は、oom_score という評価値に基づいて行われます(カーネルの mm/oom_kill.c にある oom_badness() 関数で計算されます)。
OOM Scoreの基本的な計算ロジック(概念):
- 基本スコア: プロセスが現在使用しているメモリ量(RSS: Resident Set Size + ページテーブル量 + スワップ使用量)が総メモリに占める割合。最大1000ポイント。つまり、多くメモリを消費しているプロセス(メモリリークを起こしているプロセス等)ほど殺されやすい。
- ルート権限ペナルティ緩和: rootユーザー権限で動作しているプロセス(システムの中核デーモンなど)は、システム維持に不可欠である可能性が高いため、スコアが少し割引(マイナス)され、殺されにくくなります。
- ユーザー調整値 (OOM Score Adj):
/proc/[pid]/oom_score_adj(-1000 から +1000)の値が加算されます。システム管理者はこれを使ってOOM Killerの挙動をコントロールできます。この値が -1000 に設定されたプロセス(例: sshd、kubelet、データベースのマスタープロセスなど)は「OOM Killerの対象外(無敵)」となります。
OOM Killerが発動した際は、カーネルログ(dmesg または /var/log/messages)に「Out of memory: Killed process 1234 (java)」といったメッセージと共に、当時のプロセスリスト、各スコア、メモリ状態の詳細なダンプが出力されます。システム管理者はこのログとスコア計算メカニズムを理解することで、予期せぬプロセス終了の原因を究明し、適切なリソース制限(cgroupsやulimit)を設定することができます。
第7章:最新の超高速メモリ技法とハードウェアセキュリティ
7.1 2MB/1GB HugePagesの威力とTHPの功罪
第3章と第4章で述べたTLBミスとテーブルウォークの遅延を解決する強力な手段が「HugePage」です。 通常の4KBページの代わりに、2MB(Page Directoryの段階で物理アドレスを直接指す、つまりPT階層をスキップする)や1GB(PDPTの段階で直接指す)の巨大なページを使用します。
これにより、1つのTLBエントリで広大なメモリ領域(4KBの512倍、または26万倍)をカバーできるため、TLBミスが劇的に減少します。大量のメモリにランダムアクセスするデータベース(Oracle, PostgreSQL)や仮想化環境(KVM/QEMU)ではHugePageの使用がパフォーマンスチューニングの必須項目となっています。
Linuxの**THP (Transparent Huge Pages)**は、アプリケーションが意識しなくても、カーネルのバックグラウンドスレッド(khugepaged)が連続した4KBページを自動的に2MBのHugePageに統合(デフラグ)してくれる仕組みです。しかし、メモリの断片化が進んだ環境では、この統合処理(メモリコンパクション)自体がCPUを大きく消費し、レイテンシスパイクを引き起こすため、RedisなどのインメモリKVSではTHPを無効化(never または madvise)することが推奨されています。
7.2 カーネルページテーブル分離(KPTI)とMeltdown対策の代償
2018年に発覚したCPUの投機的実行の脆弱性「Meltdown (CVE-2017-5754)」は、ユーザープロセスからカーネルのメモリ空間(キャッシュ)を不正に読み取ることができるという、ハードウェアの根幹を揺るがす致命的な欠陥でした。
これへの対策としてOS側に導入されたのがKPTI (Kernel Page-Table Isolation)(初期はKAISERと呼ばれた)です。
従来は、コンテキストスイッチのオーバーヘッドを減らすため、ユーザー空間の実行時でもページテーブルの上半部にはカーネル領域全体がマップされていました(PTEのU/Sビットで特権チェックを行い、アクセスは拒否されるという前提でした)。しかし投機的実行はこの特権チェックをすり抜けてしまいました。
KPTI導入後は、ユーザー実行時にはカーネルの大部分をマップしない「最小限のシャドウページテーブル(User PGD)」を使用します。システムコールや割り込みでカーネル空間に遷移する際、必ず CR3 レジスタを切り替えて完全なカーネルページテーブル(Kernel PGD)にロードし直す必要があります。
これによりセキュリティは完全に担保されましたが、システムコールや割り込みのたびに高コストなCR3切り替え(およびPCID/TLBフラッシュの管理)が発生するため、I/Oインテンシブなアプリケーション(Syscallを多用するWebサーバーやDB)においては、数%〜十数%に及ぶ無視できないパフォーマンスオーバーヘッドをもたらしました。
7.3 Direct I/Oとゼロコピー技術の進化
ファイルI/Oを最適化するために、OSは仮想記憶の仕組みを極限まで応用します。
mmap() システムコールを使用すると、ファイルの中身を直接仮想アドレス空間にマッピングします。アクセスするとページフォルトが発生し、ページキャッシュにファイルデータが読み込まれ、ユーザー空間からポインタとして直接アクセス可能になります。
さらに、ネットワーク送受信やストレージI/Oにおいて、カーネル空間(ページキャッシュ)とユーザー空間のバッファ間でのCPUによるデータコピー(コンテキストスイッチに伴うコピー)を省くため、ゼロコピー技術が活用されています。sendfile() システムコールや最新の io_uring、AF_XDP では、NICやNVMeドライブのDMA(Direct Memory Access)コントローラと連携し、ページテーブルのPTEを操作してカーネルのページをユーザー空間に直接「付け替える(リマップする)」ことで、メモリコピーのオーバーヘッドを完全にゼロにしています。ここでも、根本のメカニズムとしてページテーブルの巧みな操作が行われています。
結び
仮想記憶とページング機構は、OSカーネルとCPU(ハードウェア)が奏でる極めて高度なシンフォニーです。ページテーブルの1ビットのフラグ設定、TLBのシュートダウンを巡るスピンロックの苦悩、CoWの参照カウントによるメモリの魔法、そしてOOM Killerの冷酷なヒューリスティクスに至るまで、その深層には「限られた物理リソースをいかに安全かつ高速に抽象化し、プロセスに無限の幻想を与えるか」というコンピュータサイエンスの叡智が詰まっています。
低レイヤのメカニズムを理解することは、C/C++やRustといったシステムプログラミング言語での最適化(キャッシュラインを意識したデータ構造設計や、mmapの効果的な利用)だけでなく、GoやJavaなどの高水準言語におけるガベージコレクション(GC)の停止時間(STW)やメモリアロケータ(jemallocやtcmalloc)の挙動を深く理解する上でも不可欠です。システムの「魔術」のベールを剥がし、ハードウェアとカーネルの鼓動を直に感じることで、より洗練され、スケーラブルなソフトウェアを設計できる優れたアーキテクトへの道が開けることでしょう。