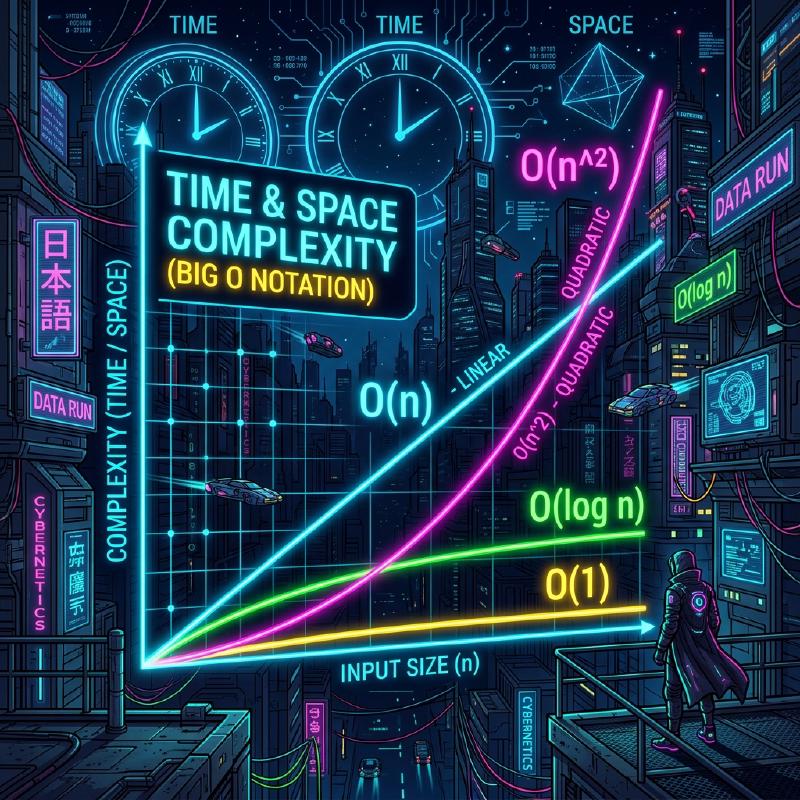
はじめに:なぜアルゴリズムの効率性が重要なのか
ソフトウェア開発において、私たちは日々様々な問題に対してコードを書いて解決策を提示しています。その際、単に「動くコード」を書くだけでなく、「効率的に動くコード」を書くことが求められます。データ量が少ないうちは非効率なプログラムでも一瞬で完了するため問題にはなりませんが、データが数百万、数千万と増えた途端にシステムがフリーズしたかのように応答しなくなることがあります。
そこで重要になるのが、アルゴリズムの効率性を評価する指標である「計算量(Complexity)」です。ハードウェア(CPUやメモリ)の性能がどれほど向上しようとも、アルゴリズム自体の効率が悪ければ、データ量の増大に立ち向かうことはできません。
本記事では、計算量とは何かという基本から、アルゴリズムの性能を示す標準的な記法である「O記法(ビッグオー記法、Big O Notation)」、そして時間計算量と空間計算量の違いについて、Pythonの具体的なコード例を交えて徹底的に解説します。これを読み終える頃には、自分の書いたコードがどれくらい効率的なのかを論理的に説明できるようになっているはずです。
1. 計算量(Complexity)とは?
アルゴリズムの性能を評価するためには、実際の実行時間をストップウォッチで測ることはあまり意味がありません。なぜなら、実行時間は実行環境(マシンのスペック、OS、使用言語など)に大きく依存するからです。そこで、環境に依存しない普遍的な評価基準として用いられるのが計算量です。
計算量には大きく分けて2つの概念があります。
- 時間計算量(Time Complexity) アルゴリズムが処理を完了するまでに必要な「ステップ数(演算回数)」を評価する指標です。実行時間に直結します。
- 空間計算量(Space Complexity) アルゴリズムが実行時にどれだけの「メモリ空間(記憶容量)」を必要とするかを評価する指標です。
現代のコンピュータはメモリ容量が非常に大きいため、時間計算量がより重視される傾向にありますが、組み込みシステムや大規模なデータ処理においては空間計算量も依然として極めて重要です。
2. O記法(ビッグオー記法)の基本
計算量を表現する際、最も一般的に使われるのがO記法(Big O Notation)です。O記法は、入力データのサイズ $n$ が十分に大きくなったとき、アルゴリズムの計算量がどのように増加していくか(増加の割合の上限)を示す数学的な記法です。
O記法の重要な3つのルール
O記法を用いて計算量を導き出す際、以下のルールに従って式を簡略化します。
- 最悪のケース(Worst Case)を想定する アルゴリズムの性能は、入力データの並び順などによって変化することがあります。O記法では通常「一番運が悪かった場合(最も時間がかかる場合)」を基準とします。
- 定数項を無視する $O(2n)$ や $O(n + 5)$ はすべて $O(n)$ と表現されます。入力サイズ $n$ が無限大に近づくとき、定数倍の違いは本質的な増加のペースに影響を与えないと見なすためです。
- 最も影響の大きい項のみを残す 例えば、計算ステップ数が $n^2 + 3n + 100$ だった場合、$n$ が大きくなると $n^2$ の影響が圧倒的に大きくなります。したがって、下位の項を切り捨てて $O(n^2)$ と表現します。
これにより、アルゴリズムの本質的なスケーラビリティ(拡張性)をシンプルに評価することができます。
3. 代表的な時間計算量とPythonでの実例
ここからは、よく遭遇する時間計算量のクラスを速い順に見ていき、それぞれの具体的なPythonコード例を紹介します。
O(1): 定数時間(Constant Time)
入力サイズ $n$ に関係なく、常に一定のステップ数で処理が終わるアルゴリズムです。究極の理想形と言えます。
| |
配列のインデックスアクセスや、ハッシュテーブル(辞書)へのアクセス、値の代入などは $O(1)$ です。
O(log n): 対数時間(Logarithmic Time)
入力サイズ $n$ が増えるにつれて実行時間は増えますが、その増加ペースは非常に緩やかです。アルゴリズムが進行するごとに、探索範囲が半分になっていくような処理が該当します。代表例は二分探索(Binary Search)です。
| |
100万件のデータがあっても、たかだか20回程度の比較で目的の値を見つけることができます($2^{20} \approx 1,000,000$)。
O(n): 線形時間(Linear Time)
入力サイズ $n$ に比例して実行時間が増加します。データを最初から最後まで順番に1回ずつ調べる処理がこれにあたります。
| |
配列内の最大値を探す処理や、全要素の合計を求める処理も $O(n)$ になります。
O(n log n): 準線形時間(Linearithmic Time)
$O(n)$ と $O(\log n)$ の積です。実用的な最速の比較ソートアルゴリズム(マージソート、クイックソート、ヒープソートなど)の多くは、この計算量を持ちます。
| |
配列を半分に分割していくプロセスが $\log n$ 層あり、それぞれの層でマージ処理に $n$ のステップがかかるため、$O(n \log n)$ となります。
O(n^2): 二乗時間・多項式時間(Quadratic Time)
入力サイズの2乗に比例して実行時間が増加します。ループが2重にネストされているアルゴリズムの典型です。バブルソートや挿入ソート、選択ソートなどが該当します。
| |
データ量が10倍になると実行時間は100倍になるため、大きなデータセットに対しては実用的ではありません。
O(2^n): 指数時間(Exponential Time)
入力サイズが1増えるごとに、実行時間が倍増する非常に非効率なアルゴリズムです。フィボナッチ数列を単純な再帰で求めるアルゴリズムなどが代表的です。
| |
この実装では同じ計算を何度も繰り返してしまうため、$n$ が40や50になるだけで、実行に数分から数時間かかるようになります。(※このような場合は動的計画法やメモ化を使うことで $O(n)$ に改善できます)。
O(n!): 階乗時間(Factorial Time)
最も計算量の増加が激しいアルゴリズムです。巡回セールスマン問題の全探索(すべての順列を試すブルートフォースアプローチ)などで見られます。
| |
$n=10$ 程度であれば計算可能ですが、$n=20$ になるとスーパーコンピュータでも宇宙の寿命ほどの時間がかかると言われています。
4. 空間計算量(Space Complexity)について
時間計算量だけでなく、アルゴリズムが実行中にどれだけの「追加メモリ」を必要とするかを表す空間計算量も重要です。ここでもO記法が使われます。
データ構造自体のサイズ vs 補助スペース
空間計算量を考える際、入力データそのものを保持するためのメモリと、アルゴリズムが処理の過程で追加で必要とするメモリ(補助スペース:Auxiliary Space)を区別して考えることがあります。通常、アルゴリズムの文脈で空間計算量と言えば「補助スペース」を指すことが多いです。
- O(1) の空間計算量: バブルソートのように、入力配列の中で要素を交換するだけでソートが完了するアルゴリズム(in-placeアルゴリズム)。追加で必要なのは数個の一時変数のみです。
- O(n) の空間計算量: マージソートのように、分割・統合の過程で元の配列と同じサイズの新しい配列を作成する必要がある場合。
再帰呼び出しとコールスタック
空間計算量で見落とされがちなのが、関数を再帰的に呼び出す際のコールスタックの消費です。
| |
この階乗を計算する再帰関数は、変数などのメモリ消費は少なく見えますが、再帰の深さが最大 $n$ に到達するため、システム内部のコールスタックに $n$ 個の関数呼び出し情報が積まれます。したがって、空間計算量は $O(n)$ となります。
5. データ構造とアルゴリズムの計算量まとめ表
代表的なデータ構造における操作の時間計算量(平均/最悪ケース)と空間計算量の一覧です。
データ構造別の時間計算量
| データ構造 | アクセス | 検索 | 挿入 | 削除 | 空間計算量 |
|---|---|---|---|---|---|
| 配列 (Array) | $O(1)$ | $O(n)$ | $O(n)$ | $O(n)$ | $O(n)$ |
| 連結リスト (Linked List) | $O(n)$ | $O(n)$ | $O(1)$※ | $O(1)$※ | $O(n)$ |
| ハッシュテーブル (Hash Table) | N/A | $O(1)$ | $O(1)$ | $O(1)$ | $O(n)$ |
| 二分探索木 (BST) | $O(\log n)$ | $O(\log n)$ | $O(\log n)$ | $O(\log n)$ | $O(n)$ |
※連結リストの挿入・削除は、挿入/削除ポイントのノードが既知の場合に $O(1)$ となります。
主要ソートアルゴリズムの比較
| アルゴリズム | 最良時間 | 平均時間 | 最悪時間 | 空間計算量 | 特徴 |
|---|---|---|---|---|---|
| バブルソート | $O(n)$ | $O(n^2)$ | $O(n^2)$ | $O(1)$ | 実装が単純だが遅い |
| 挿入ソート | $O(n)$ | $O(n^2)$ | $O(n^2)$ | $O(1)$ | データがほぼソート済みの時に高速 |
| マージソート | $O(n \log n)$ | $O(n \log n)$ | $O(n \log n)$ | $O(n)$ | 安定で確実だがメモリを食う |
| クイックソート | $O(n \log n)$ | $O(n \log n)$ | $O(n^2)$ | $O(\log n)$ | 平均的に最速。実務で多用される |
6. 実務における計算量のトレードオフ
実際のシステム開発では、「時間計算量を小さく(速く)するために、空間計算量を大きく(メモリを多く使う)する」というトレードオフ(Time-Memory Trade-off)が頻繁に発生します。
代表的な例がキャッシュ(メモ化)です。過去の計算結果をハッシュテーブルや配列(メモリ=空間)に保存しておくことで、同じ計算を再度行う手間(時間)を省き、$O(2^n)$ かかる処理を $O(n)$ に劇的に改善する動的計画法などがこれに該当します。
また、頻繁に検索を行うシステムでは、データを配列で持っておいて都度 $O(n)$ で探すのではなく、メモリを追加で消費してでもハッシュテーブルを構築し、検索を $O(1)$ で行えるように設計するのがベストプラクティスです。
おわりに
計算量とO記法は、単なるコンピュータサイエンスの理論ではなく、実用的なソフトウェアエンジニアリングにおいて欠かせない「エンジニアの共通言語」です。 「このループ処理は $O(n^2)$ だから、データが増えるとボトルネックになるな」 「ここではメモリ(空間計算量)を犠牲にしてでも、ハッシュテーブルを使って時間計算量を $O(1)$ に下げよう」 このように、計算量を常に意識しながらコーディングを行うことで、スケーラブルでパフォーマンスの高い優れたアプリケーションを設計できるようになるでしょう。
アルゴリズムの選択一つで、システムの未来が大きく変わるということをぜひ覚えておいてください。