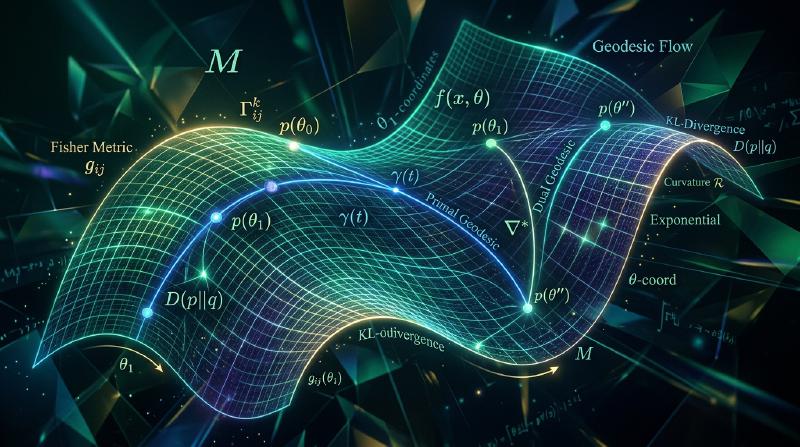
情報幾何学(Information Geometry)は、確率分布のなす空間に微分幾何学の構造を導入し、統計的推測や機械学習、情報理論の本質を幾何学的な直観のもとに解き明かす、日本発の世界的理論です。甘利俊一博士らによって体系化されたこの理論は、現在ではAI・ディープラーニングの根幹を支える自然勾配法(Natural Gradient Descent)や、量子情報理論、統計物理学といった幅広い分野にまで応用され、現代科学における「共通言語」としての地位を確立しつつあります。
本記事では、この情報幾何学の深淵なる世界を、数学的厳密性と幾何学的直観、そして具体的な計算例を交えながら、可能な限り詳細かつ体系的に解説します。単なる数式の羅列にとどまらず、「なぜ確率分布の空間は曲がっているのか」「なぜフィッシャー情報行列が計量テンソルとなるのか」という根源的な問いから始まり、双対接続、エントロピーの幾何学、そして最先端の機械学習や神経科学への応用まで、情報幾何学の全貌を描き出します。
第1章:情報幾何学の夜明けと甘利俊一の直観
ユークリッド空間の統計から確率分布の曲がった空間へ
古典的な統計学やデータ解析において、我々は無意識のうちにデータをユークリッド空間上の点として扱ってきました。例えば、パラメータ \(\theta = (\theta_1, \theta_2, \dots, \theta_n)\) を持つ統計モデルを考えるとき、パラメータ空間を平坦な空間とみなし、パラメータ間の距離を通常のユークリッド距離で測ることが頻繁に行われます。二乗誤差を最小化する最小二乗法なども、このユークリッド幾何学的な直観に基づいています。
しかし、確率分布をパラメータ付けする空間は、本当に「平坦」なのでしょうか?
正規分布 \(N(\mu, \sigma^2)\) を例にとってみましょう。パラメータ空間は平均 \(\mu\) と分散 \(\sigma^2 > 0\) からなる上半平面 \(\{(\mu, \sigma^2) \in \mathbb{R} \times \mathbb{R}_{>0}\}\) です。ここで、2つの正規分布の組を考えます。
- \(N(0, 1)\) と \(N(0.1, 1)\)
- \(N(0, 100)\) と \(N(0.1, 100)\)
パラメータのユークリッド距離で見れば、どちらの組も距離は \(0.1\) で等しいことになります。しかし、確率分布としての「識別可能性」や「情報の違い」という観点からはどうでしょうか。 分散が \(1\) と小さい場合、平均が \(0.1\) ずれるだけで分布の形状は有意に変化し、データから両者を区別することは比較的容易です。一方、分散が \(100\) と極めて大きい場合、分布は平べったく広がっており、平均が \(0.1\) ずれたところで分布の重なりは非常に大きく、データから両者を区別することは至難の業です。
すなわち、「分布としての本来の違い」は、パラメータのユークリッド距離とは一致しません。分散が大きい領域では、平均のわずかな変化は分布の形状にほとんど影響を与えず、逆に分散が小さい領域では劇的な変化をもたらします。これは、確率分布のパラメータ空間が一様ではなく、場所によって「距離の尺度が異なる曲がった空間(リーマン多様体)」であることを強く示唆しています。
確率分布族はなぜ多様体なのか
情報幾何学は、統計モデル(確率分布の族)を微分可能多様体(Differentiable Manifold)として定式化します。
ある確率空間 \(\mathcal{X}\) 上の確率分布の族を \(S\) とします。この族が \(n\) 個の連続な実数パラメータ \(\theta = (\theta^1, \dots, \theta^n)\) によって一意に指定され、確率密度関数 \(p(x; \theta)\) が \(\theta\) に関して滑らかであるとき、\(S\) を \(n\) 次元の統計多様体(Statistical Manifold)と呼びます。
\[ S = \{ p(x; \theta) \mid \theta \in \Theta \subset \mathbb{R}^n \} \]ここで、\(\theta\) は多様体 \(S\) 上の「局所座標系(Local Coordinate System)」に他なりません。多様体の理論において、座標系は本質的なものではなく、単なる表現の一つに過ぎません。例えば正規分布の場合、パラメータとして \((\mu, \sigma^2)\) を選ぶこともできれば、\((\mu, \sigma)\) や \((\frac{\mu}{\sigma^2}, -\frac{1}{2\sigma^2})\) を選ぶことも可能です。
情報幾何学の真髄は、「座標系の取り方に依存しない、確率分布族そのものが持つ内在的な幾何学構造」を明らかにすることにあります。甘利俊一は、C.R. Raoが提唱した「フィッシャー情報行列を計量とするリーマン多様体」という概念をさらに深化させ、アフィン接続(Affine Connection)の概念を導入することで、確率分布の空間に「曲がり具合(曲率)」だけでなく「直線の概念(測地線)」や「双対性」という豊穣な構造を見出しました。
第2章:リーマン多様体としての統計モデル
多様体において「距離」と「角度」を定義するためには、リーマン計量(Riemannian Metric)が必要です。統計多様体における自然なリーマン計量とは何でしょうか。
スコア関数とフィッシャー情報行列
統計学において、対数尤度関数 \(\log p(x; \theta)\) のパラメータに関する偏微分は「スコア関数(Score Function)」と呼ばれ、重要な役割を果たします。
\[ \partial_i \ell(x; \theta) = \frac{\partial}{\partial \theta^i} \log p(x; \theta) \]\[ E_\theta[\partial_i \ell(x; \theta)] = \int \frac{\partial p(x; \theta)}{\partial \theta^i} dx = \frac{\partial}{\partial \theta^i} \int p(x; \theta) dx = 0 \]\[ g_{ij}(\theta) = E_\theta \left[ \partial_i \ell(x; \theta) \partial_j \ell(x; \theta) \right] \]C.R. Rao (1945) は、このフィッシャー情報行列がテンソルの変換則を満たす正値対称行列であることに着目し、これを統計多様体のリーマン計量(フィッシャー計量)として採用することを提案しました。
\[ ds^2 = \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j \]これにより、統計モデルはリーマン多様体 \((S, G)\) となります。2つの近接する確率分布 \(p(x; \theta)\) と \(p(x; \theta + d\theta)\) の間の微小な「距離の二乗」は、このフィッシャー計量によって測られます。
不変計量としてのチェンツォフの定理
なぜフィッシャー情報行列を計量として選ぶべきなのでしょうか。単なる思いつきではなく、そこには深い数学的必然性があります。
N.N. Chentsov (1972) は、統計的な推測の枠組みにおいて要求される「不変性(Invariance)」を定式化しました。統計的推論は、データの表現方法や十分統計量への変換(マルコフ写像)によって結果が変わるべきではありません。 チェンツォフの定理は、「有限集合上の確率分布からなる多様体において、マルコフ写像の下で単調性(縮小性)を満たすリーマン計量は、定数倍を除いてフィッシャー情報計量に限られる」という驚くべき事実を示しました。
つまり、確率分布の空間において「情報が減少しない」という自然な統計的要請を満たす距離の測り方は、フィッシャー計量しか存在しないのです。これは、フィッシャー計量が統計学に特有の内在的かつ必然的な幾何学構造であることを証明しています。
正規分布族におけるフィッシャー計量の具体計算例
\[ p(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) \]\[ \log p = -\log(\sqrt{2\pi}) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2} \]\[ \partial_\mu \log p = \frac{x-\mu}{\sigma^2}, \quad \partial_\sigma \log p = -\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3} \]\[ g_{\mu\mu} = E\left[ \left(\frac{x-\mu}{\sigma^2}\right)^2 \right] = \frac{1}{\sigma^2} \]\[ g_{\sigma\sigma} = E\left[ \left(-\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3}\right)^2 \right] = \frac{2}{\sigma^2} \]\[ g_{\mu\sigma} = g_{\sigma\mu} = 0 \]\[ ds^2 = \frac{1}{\sigma^2} d\mu^2 + \frac{2}{\sigma^2} d\sigma^2 \]これは、アンリ・ポアンカレが提唱した双曲幾何学(非ユークリッド幾何学の一種)のモデルであるポアンカレ上半平面の計量(定数倍の違いを除く)と完全に一致します。すなわち、正規分布の空間は負の定曲率を持つ双曲空間であることがわかります。 先ほどの直観通り、\(\sigma\) が大きい(分散が大きい)領域では計量テンソル \(1/\sigma^2\) が小さくなり、パラメータの変動が「距離」として小さく評価されることが数式からも裏付けられました。
第3章:双対接続と \(\alpha\)-接続の深淵
リーマン計量だけでは、空間の「曲がり具合」を完全に記述することはできません。「どの方向が真っ直ぐか」を定めるアフィン接続(Affine Connection)が必要です。甘利俊一の最大の功績は、統計多様体には無限に多くの自然な接続が存在し、それらが「双対性(Duality)」という美しい構造を成していることを発見した点にあります。
\(\alpha\)-接続の定義
甘利は、実数パラメータ \(\alpha\) を用いて、\(\alpha\)-接続と呼ばれるアフィン接続の族を導入しました。その接続係数 \(\Gamma_{ij,k}^{(\alpha)}\) は以下のように定義されます。
\[ \Gamma_{ij,k}^{(\alpha)} = E \left[ \left( \partial_i \partial_j \ell + \frac{1 - \alpha}{2} \partial_i \ell \partial_j \ell \right) \partial_k \ell \right] \]\(\alpha = 0\) のときの \(0\)-接続は、フィッシャー計量から一意に定まるレヴィ・チヴィタ接続(Levi-Civita Connection)に一致します。これは通常のリーマン幾何学で用いられる接続です。しかし、情報幾何学において最も重要な役割を果たすのは \(\alpha = 1\) と \(\alpha = -1\) の接続です。
e-接続とm-接続、そして双対平坦空間
- e-接続(\(\alpha = 1\) 指数接続): 指数型分布族(Exponential Family)を扱う際に自然に現れる接続です。
- m-接続(\(\alpha = -1\) 混合接続): 混合型分布族(Mixture Family)を扱う際に自然に現れる接続です。
この2つの接続は、フィッシャー計量 \(g_{ij}\) に関して「双対(Dual)」の関係にあります。リーマン多様体において、2つのベクトル場の内積(計量)の微分が、それぞれの接続による共変微分の和として表されるとき、それらは双対接続と呼ばれます。
\[ X \langle Y, Z \rangle = \langle \nabla_X^{(e)} Y, Z \rangle + \langle Y, \nabla_X^{(m)} Z \rangle \]特筆すべきは、指数型分布族(例えば正規分布、ポアソン分布、ガンマ分布など)の空間は、e-接続に関して「平坦(曲率テンソルがゼロ)」であり、同時にm-接続に関しても「平坦」であるという事実です。このような空間を双対平坦空間(Dually Flat Space)と呼びます。
双対平坦空間では、e-接続に関して真っ直ぐな線(e-測地線)と、m-接続に関して真っ直ぐな線(m-測地線)が存在します。さらに、これらの空間ではパラメータ系として、互いにルジャンドル変換(Legendre Transformation)で結ばれる双対座標系(自然パラメータ \(\theta\) と期待値パラメータ \(\eta\))が存在します。
一般化ピタゴラスの定理
双対平坦空間の美しさは、「一般化ピタゴラスの定理(Generalized Pythagorean Theorem)」に集約されます。
ユークリッド空間では、3点 \(P, Q, R\) が \(\angle PQR = 90^\circ\) の直角三角形をなすとき、\(d(P, R)^2 = d(P, Q)^2 + d(Q, R)^2\) が成り立ちます。 情報幾何学の双対平坦空間においては、点 \(P, Q, R\)(確率分布)を結ぶ曲線が、e-測地線とm-測地線からなり、それらが点 \(Q\) においてフィッシャー計量の意味で「直交」しているとき、分布間のダイバージェンス(非対称な距離の概念)に関して次式が厳密に成立します。
\[ D(P \parallel R) = D(P \parallel Q) + D(Q \parallel R) \]この定理は、統計学における情報量規準や、機械学習におけるEMアルゴリズムの収束性、射影定理(Information Projection)を幾何学的に完全に説明するものであり、情報幾何学の金字塔とも言える結果です。
第4章:ダイバージェンスとエントロピーの幾何学
リーマン幾何学における距離は対称(\(d(x, y) = d(y, x)\))ですが、情報理論における確率分布間の「違い」の尺度は一般に非対称です。情報幾何学は、この非対称な距離「ダイバージェンス(Divergence)」と双対平坦空間の幾何学構造を見事に結びつけます。
Kullback-Leibler情報量(KLダイバージェンス)
\[ D_{KL}(P \parallel Q) = \int p(x) \log \frac{p(x)}{q(x)} dx \]KLダイバージェンスは距離の公理を満たしません(非対称であり、三角不等式も満たさない)。しかし、点 \(Q\) が点 \(P\) に限りなく近づく極限において、KLダイバージェンスのテイラー展開の2次の項は、正確にフィッシャー情報行列と一致します。
\[ D_{KL}(\theta \parallel \theta + d\theta) \approx \frac{1}{2} \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j \]すなわち、KLダイバージェンスはマクロな非対称距離であり、そのミクロな極限(無限小距離)がフィッシャー計量(リーマン幾何学)を誘導しているのです。
ブレグマン・ダイバージェンスとルジャンドル変換
双対平坦空間において、ダイバージェンスはより一般的な「ブレグマン・ダイバージェンス(Bregman Divergence)」として定式化されます。 凸関数 \(\psi(\theta)\)(キュムラント母関数や自由エネルギーに対応)を考えます。ブレグマン・ダイバージェンス \(D_\psi(\theta_P \parallel \theta_Q)\) は、点 \(\theta_Q\) における凸関数の接平面と、点 \(\theta_P\) における凸関数の値との「誤差」として定義されます。
\[ D_\psi(\theta_P \parallel \theta_Q) = \psi(\theta_P) - \psi(\theta_Q) - \sum_i (\theta_P^i - \theta_Q^i) \frac{\partial \psi(\theta_Q)}{\partial \theta^i} \]\[ \eta_i = \frac{\partial \psi(\theta)}{\partial \theta^i}, \quad \phi(\eta) = \sum_i \theta^i \eta_i - \psi(\theta) \]情報幾何学において、KLダイバージェンスは指数型分布族上のブレグマン・ダイバージェンスそのものであり、双対パラメータ \(\theta\)(自然パラメータ)と \(\eta\)(期待値パラメータ)を用いることで、ダイバージェンスは双対な関数 \(\psi, \phi\) を用いた極めて対称的で美しい正準形(Canonical form)で書き表すことができます。
\[ D(P \parallel Q) = \psi(\theta_P) + \phi(\eta_Q) - \sum_i \theta_P^i \eta_Q^i \]この数式は、情報幾何学が単なる微分幾何学の応用ではなく、ルジャンドル変換や凸解析と深く結びついた「情報理論固有の幾何学」であることを如実に物語っています。
第5章:ディープラーニングと自然勾配降下法
情報幾何学は、理論的な美しさにとどまらず、現代のAI、特にディープラーニング(深層学習)において極めて実践的な威力を発揮しています。その最たる例が「自然勾配降下法(Natural Gradient Descent; NGD)」です。
通常の勾配降下法の限界
\[ w_{t+1} = w_t - \eta \nabla L(w_t) \]しかし、通常の勾配 \(\nabla L\) は、パラメータ空間が「平坦なユークリッド空間」であることを前提としています。第1章で見たように、ニューラルネットワークが表現する確率モデルのパラメータ空間は、フィッシャー計量によって曲がったリーマン多様体です。 ユークリッド空間の勾配(最急降下方向)は、リーマン多様体上では真の最急降下方向とは一致しません。そのため、パラメータのスケールや座標変換によって学習の軌跡が大きく変化し、最適化の効率が著しく低下する「プラトー(学習の停滞)」現象が頻発します。
フィッシャー計量によるパラメータ更新:自然勾配法
1998年、甘利俊一はリーマン多様体上での真の最急降下方向である「自然勾配(Natural Gradient)」を提唱しました。多様体上の勾配 \(\tilde{\nabla} L\) は、通常の勾配 \(\nabla L\) にフィッシャー情報行列の逆行列 \(F^{-1}\) を掛けたものになります。
\[ \tilde{\nabla} L(w) = F(w)^{-1} \nabla L(w) \]\[ w_{t+1} = w_t - \eta F(w_t)^{-1} \nabla L(w_t) \]自然勾配法は、パラメータ空間の曲率(フィッシャー情報行列)を考慮することで、パラメータの取り方(座標系)に依存しない不変な学習を実現します。これにより、損失関数の等高線が歪んだ谷底のような地形であっても、直線的に最適解へと向かうことが可能となり、学習速度が飛躍的に向上します。これは、ニュートン法のような2次最適化手法と似ていますが、ヘッセ行列の代わりに半正定値性が保証されたフィッシャー情報行列を用いる点で、確率モデルに最適化された手法と言えます。
K-FACによる近似計算の実装とブレイクスルー
理論的には強力な自然勾配法ですが、ディープラーニングへの適用には大きな壁がありました。数千万から数百億のパラメータを持つ現代のニューラルネットワークにおいて、巨大なフィッシャー情報行列 \(F\)(サイズ \(N \times N\))を計算し、その逆行列を求めることは計算量の観点から絶望的(\(O(N^3)\))でした。
この問題を解決したのが、James Martens と Roger Grosse らが2015年に提案した K-FAC (Kronecker-factored Approximate Curvature) という手法です。 彼らは、ニューラルネットワークの層間のパラメータにおけるフィッシャー情報行列が、入力の共分散行列と出力の勾配の共分散行列の「クロネッカー積(Kronecker Product)」で精度良く近似できることを示しました。
\[ F_{layer} \approx A \otimes S \](ここで \(A\) は活性化値の共分散、\(S\) は事前活性化の勾配の共分散)
クロネッカー積の性質 \((A \otimes S)^{-1} = A^{-1} \otimes S^{-1}\) を利用することで、巨大な行列の逆行列計算を、はるかに小さな行列の逆行列計算に分解でき、計算コストを劇的に削減(\(O(N^3)\) から \(O(n^3)\) へ、\(n\) は層の幅)することに成功しました。K-FACの実装により、自然勾配法は現実的な計算時間で大規模な深層学習モデル(ResNetやTransformerなど)に適用可能となり、分散学習環境において極めて高速な収束を示すことが実証されています。これは情報幾何学がAIの限界を突破した歴史的瞬間でした。
第6章:統計物理学、量子情報、神経科学への拡張
情報幾何学の汎用性は統計学や機械学習にとどまりません。その根底にある「確率と情報の幾何学」は、多くの科学分野に波及しています。
量子情報幾何学
古典的な確率分布を扱う情報幾何学は、量子力学における「密度行列(Density Matrix)」を扱う**量子情報幾何学(Quantum Information Geometry)**へと自然に拡張されます。 量子系では、観測量の非可換性(演算子が順序によって結果が変わること)に起因して、フィッシャー計量に相当するものが一意に定まりません。その代わり、Bures計量(SLDフィッシャー情報量)やKubo-Mori-Bogoliubov計量といった複数のリーマン計量が存在し、それぞれが異なる物理的・情報論的意味を持ちます。量子情報幾何学は、量子状態の推定精度の限界(量子クラメール・ラオの不等式)や、量子もつれ(エンタングルメント)の幾何学的解明、量子アルゴリズムの最適化など、量子コンピュータや量子通信の理論的基盤として急速に発展しています。
自由エネルギー原理と神経科学(予測符号化)
脳神経科学の分野において、Karl Fristonが提唱する**自由エネルギー原理(Free Energy Principle; FEP)**は、脳が「驚き(Surprise)」を最小化するように知覚と行動を推論するシステムであると仮定します。 この推論プロセスは、変分ベイズ推論(Variational Bayesian Inference)として定式化され、そこでは脳内の内部モデルの確率分布と、外部環境の真の分布との間のKLダイバージェンス(変分自由エネルギー)を最小化する最適化問題に帰着します。
情報幾何学の視点から見れば、脳は確率分布の多様体上を、ダイバージェンスの勾配(すなわち自然勾配)に従って動く力学系として解釈できます。知覚(内部状態の更新)と行動(外部環境への働きかけ)は、双対平坦空間におけるe-射影とm-射影の反復アルゴリズムとして美しく記述されるのです。情報幾何学は、知能の根源的なメカニズムを解き明かすための数学的言語を提供しています。
現代数学のフロンティアとして
純粋数学の観点からも、情報幾何学は新たなパラダイムを提示しました。アフィン微分幾何学、ヘッセ幾何学、シンプレクティック幾何学との深い繋がりが解明されつつあります。特に、Wasserstein幾何学(最適輸送理論)と情報幾何学の統合は、現在の数学および機械学習における最もホットな研究トピックの一つです。KLダイバージェンス(情報幾何)が「情報」の移動を測るのに対し、Wasserstein距離は「質量」の移動を測ります。これら2つの幾何学を融合させる試みは、深層生成モデル(拡散モデルやGAN)の理論的解明に直結しています。
結び:情報が織りなす宇宙の形
甘利俊一が「統計モデルは曲がっているのではないか」という直観から生み出した情報幾何学は、今や統計学の枠を越え、機械学習、量子物理学、神経科学を結びつける壮大な理論体系へと成長しました。 確率分布を単なる関数としてではなく、幾何学的な「空間」として捉えることで、我々は情報の動き、学習の軌跡、そして知能の本質を視覚的に理解することができます。
フィッシャー情報計量が教える「情報の曲がり具合」。 双対接続が導く「一般化ピタゴラスの定理」。 そして、自然勾配法が切り拓く「AIの高速な進化」。
情報幾何学は、我々がデータという名の星々から、真理という名の星座を見出すための、最も洗練された「羅針盤」であり続けるでしょう。この美しくも深淵なるリーマン多様体の探求は、まだ始まったばかりなのです。