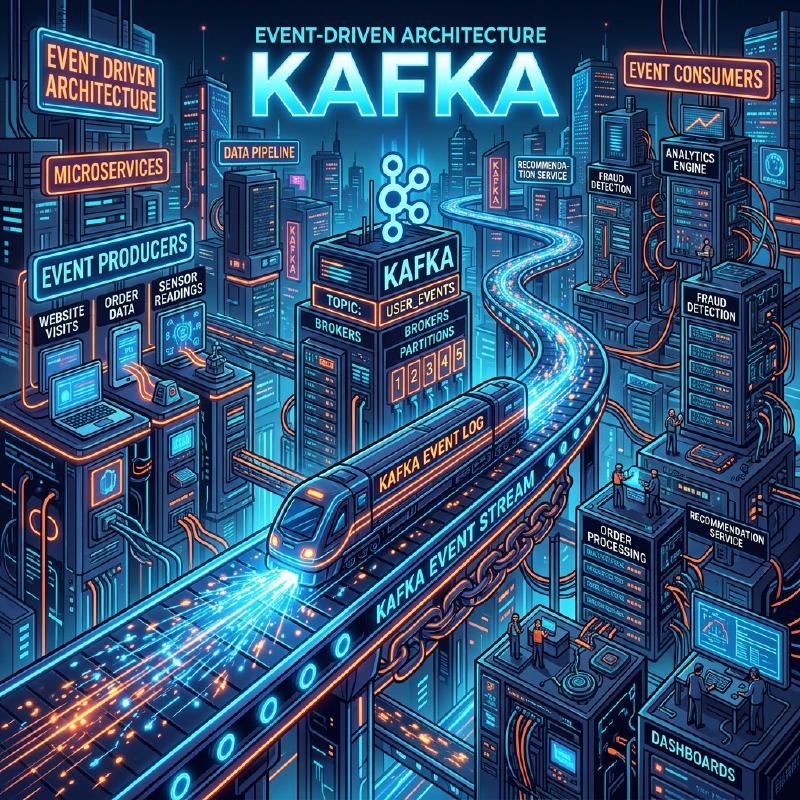
1. はじめに:なぜ今、イベント駆動アーキテクチャなのか?
近年、システム開発の現場では、巨大で複雑なモノリス(一枚岩)システムから、独立した小さなサービスの集合体である「マイクロサービスアーキテクチャ」への移行が進んでいます。マイクロサービス化によって各開発チームは独立してデプロイでき、スケールアウトも容易になるなど多くのメリットを享受できます。
しかし、サービスを分割すると新たに「サービス間通信」という複雑な問題に直面します。REST APIやgRPCのような「同期通信(Synchronous Communication)」は直感的で実装しやすい反面、呼び出し先の応答を待つ必要があるため、一時的なスパイクによる遅延や障害がシステム全体に波及する「カスケード障害」を引き起こすリスクがあります。
この課題を根本から解決するためのパラダイムが「イベント駆動アーキテクチャ(Event-Driven Architecture: EDA)」です。コンポーネント間で直接通信するのではなく、「イベント」と呼ばれる状態変化の通知を非同期にやり取りすることで、システム間の結合度を極限まで下げ、堅牢でスケーラブルなシステムを構築します。
本記事では、イベント駆動アーキテクチャの基本概念から、それを支えるメッセージブローカーの代表格である「RabbitMQ」と「Apache Kafka」の詳細なアーキテクチャ、比較、そして実運用で直面する高度な設計パターン(Saga、Outboxなど)までを徹底的に解説します。
2. イベント駆動アーキテクチャ(EDA)の基礎
イベント駆動アーキテクチャの中心にあるのは「イベント」という概念です。イベントとは、「システム内で過去に発生した意味のある事実」を指します。(例:「ユーザーが登録された」「注文が確定した」「在庫が減少した」など)
2.1 パブリッシュ・サブスクライブ(Pub/Sub)モデル
イベント駆動アーキテクチャの最も一般的な実装形態が、Pub/Subモデルです。
- パブリッシャー(Publisher / Producer): イベントを生成し、メッセージブローカーに送信(パブリッシュ)します。
- サブスクライバー(Subscriber / Consumer): ブローカーから特定のイベントを受信(サブスクライブ)して処理を行います。
このモデルの最大の利点は、「送信者と受信者がお互いを知る必要がない(空間的・時間的な分離)」という点です。パブリッシャーは「誰がそのイベントを処理するか」を気にする必要がなく、ただブローカーにイベントを投げるだけです。また、サブスクライバーがダウンしていても、イベントはブローカーに保持されるため、復旧後に処理を再開できます。
2.2 メッセージキューとメッセージブローカーの役割
これらの中継を担うのがメッセージブローカー(またはメッセージキュー)です。これにより以下のメリットが得られます。
- 非同期化(Asynchronous Processing): 重い処理をバックグラウンドに逃がすことで、ユーザーへの即時応答(レイテンシ低下)を実現します。
- 疎結合(Decoupling): サービス同士の依存関係が断ち切られ、それぞれを独立して開発・デプロイ・スケール可能になります。
- トラフィックの平準化(ピークカット / バッファリング): 突然のアクセス集中(スパイク)が起きても、キューが一時的にメッセージを溜め込むことで、後続のワーカーが自身のペースで処理を継続でき、システムのクラッシュを防ぎます。
3. RabbitMQ:伝統的で柔軟なメッセージブローカー
RabbitMQは、AMQP (Advanced Message Queuing Protocol) を実装したオープンソースのメッセージブローカーです。「スマートブローカー・ダムコンシューマー(賢いブローカーと愚直なコンシューマー)」という設計思想に基づいており、メッセージのルーティングや状態管理など、複雑な仕事はブローカー側が担当します。
3.1 RabbitMQのコアコンポーネント
- Producer: メッセージを送信するアプリケーション。
- Exchange: Producerからメッセージを受け取り、ルール(バインディング)に従って適切なQueueにルーティングする「郵便局」のような役割。
- Queue: メッセージが格納されるバッファ(キュー)。
- Consumer: Queueからメッセージを取り出して処理するアプリケーション。
3.2 柔軟なルーティング機構(Exchange Types)
RabbitMQの最大の強みは、Exchangeによる非常に柔軟なメッセージのルーティング機能です。
- Direct Exchange: メッセージの「ルーティングキー」とQueueの「バインディングキー」が完全一致した場合にメッセージを送ります。
- Topic Exchange: ワイルドカード(
*や#)を用いて、パターンマッチングによる柔軟なルーティングを行います。(例:user.created.*) - Fanout Exchange: バインドされているすべてのQueueに、無条件でメッセージをブロードキャスト(一斉送信)します。
3.3 メッセージの状態管理とACK
RabbitMQでは、Consumerがメッセージを正しく処理し終わった後、ブローカーに対して「処理完了(ACK: Acknowledgement)」を送信します。ACKを受け取ると、RabbitMQはQueueからそのメッセージを削除します。もしConsumerがクラッシュしてACKが返らなかった場合、メッセージはQueueに戻され、他のConsumerに再配信されます。
適したユースケース:
- 重い処理をバックグラウンドワーカーに任せるタスクキュー(例:画像のサムネイル生成、PDFレポート作成)。
- 複雑なルーティング条件が必要なメッセージング。
- ジョブの確実な1回処理(At-Least-Once)と細かい状態管理が必要なシステム。
4. Apache Kafka:分散イベントストリーミングプラットフォーム
Apache Kafkaは、LinkedInによって開発された分散型のストリーミングプラットフォームです。RabbitMQとは対照的に「ダムブローカー・スマートコンシューマー」というアプローチを取ります。ブローカーはただ高速にデータをディスクに書き込み、データの読み出し位置(オフセット)の管理などはコンシューマー側で行います。
4.1 Kafkaのコアコンポーネントとアーキテクチャ
- Topic: メッセージを分類するカテゴリ。RabbitMQのQueueに似ていますが、データは消費されてもすぐには消えません。
- Partition: Topicを物理的に分割したもの。Partitionを利用することでデータを複数サーバーに分散し、高いスケーラビリティと並列処理を実現します。
- Offset: 各Partition内のメッセージにつけられる連番。Consumerは自分がどこまで読み進めたか(オフセット)を記録しながら処理を進めます。
- Consumer Group: 複数のConsumerが協力して1つのTopicを処理するためのグループ。1つのPartitionは、同じグループ内の1つのConsumerによってのみ読み取られます。
4.2 永続化(Commit Log)とリプレイ性
Kafkaの本質は「分散型の追記専用ログ(Commit Log)」です。送られてきたメッセージは順序を保ったままディスクに永続化されます。RabbitMQのように「読まれたら消える」のではなく、設定された保持期間(Retention Period:例えば7日間など)が経過するまでディスクに残ります。
これにより、過去に遡ってデータを再処理する「イベントのリプレイ」が可能です。新しいサービスを追加した際に、過去1ヶ月分の全データを一から読み込ませて初期状態を構築する、といったことが容易に行えます。
4.3 圧倒的なパフォーマンス
KafkaはOSのページキャッシュを最大限に活用し、ゼロコピー技術(ディスクからネットワークへ直接データを転送)を用いることで、毎秒数百万件という驚異的なスループットを実現します。
適したユースケース:
- 大規模なWebサイトのアクセスログやユーザー行動のトラッキング(ログアグリゲーション)。
- リアルタイムなストリームデータ処理。
- 過去のイベント履歴が重要となるイベントソーシングのイベントストア。
5. RabbitMQ vs Kafka の比較まとめ
どちらを選ぶべきかは、システムの要件によって明確に分かれます。
| 比較項目 | RabbitMQ | Apache Kafka |
|---|---|---|
| アーキテクチャ | メッセージキュー(スマートブローカー) | イベントストリーミング(ダムブローカー) |
| データの永続性 | 消費・ACK完了後に削除 | 設定期間中ディスクに保持(リプレイ可能) |
| ルーティング | Exchangeを通じた柔軟なルーティング | トピックベースのシンプルなPub/Sub |
| スループット | 数万〜数十万 メッセージ/秒 | 数百万 メッセージ/秒以上 |
| 順序の保証 | 単一キュー・単一Consumerで保証 | パーティション単位での厳密な順序保証 |
| 主な得意領域 | タスクキュー、確実な非同期ジョブ、複雑な配付 | ビッグデータパイプライン、ストリーム処理、イベントリプレイ |
単一のトランザクション内で「メールを送信する」「決済APIを叩く」といった確実なタスク実行を求めるならRabbitMQが適しています。一方、全社的なデータのハブとして、マイクロサービス間の大量のデータ連携やアナリティクスを構築するならKafkaが圧倒的に有利です。
6. イベント駆動設計の高度なパターンと運用プラクティス
イベント駆動アーキテクチャを本格的に導入すると、分散システムならではの特有の問題(整合性の担保、エラー時の復旧など)に直面します。これらを解決するための重要な設計パターンをいくつか紹介します。
6.1 トランザクショナル・アウトボックス(Transactional Outbox)パターン
マイクロサービスでは、自身のデータベースを更新し、同時にKafkaなどにイベントをパブリッシュする要件がよくあります。「DB更新」と「イベント発行」の間にプロセスがクラッシュすると、データ不整合が起きます。 これを防ぐのがOutboxパターンです。DB更新と同じトランザクション内で、「送信予定のイベント」をDB内の専用テーブル(Outboxテーブル)に書き込みます。その後、非同期のワーカー(またはCDC: Change Data Capture ツール)がそのテーブルを監視し、確実にブローカーへメッセージを送信します。
6.2 冪等性(Idempotency)の確保
分散ネットワークにおいて、「Exactly-Once(厳密に1回だけの処理)」をシステム全体で保証することは非常に困難であり、コストがかかります。通常は「At-Least-Once(少なくとも1回は届く)」を前提とします。 そのため、メッセージを受信するコンシューマー側は、**「同じメッセージを複数回受信しても、システムの状態が初回受信時と同じになる性質(冪等性)」**を持つように設計しなければなりません。処理済みのイベントIDをDBに記録しておき、重複していればスキップするなどの実装が必要です。
6.3 サーガ(Saga)パターン
複数のマイクロサービスにまたがる分散トランザクションを管理する手法です。同期的な2相コミット(2PC)はロックが長くかかりスケーラビリティを阻害するため、EDAではSagaが推奨されます。 各サービスが自身のローカルトランザクションをコミットし、次のステップへ進むためのイベントを発行します。もし途中のサービスでエラーが発生した場合は、それまで成功したトランザクションを取り消すための「補償トランザクション(Compensating Transaction)」を逆順に実行していく仕組みです。
6.4 デッドレターキュー(DLQ: Dead Letter Queue)
フォーマットエラーや一時的なAPI障害などで、何度リトライしても処理できない「毒入りメッセージ(Poison Pill)」が存在すると、コンシューマーがスタックしてしまいます。処理に一定回数失敗したメッセージは、専用のキュー(DLQ)に退避させることで、メインラインの処理を止めずに後からエンジニアが原因調査と再処理を行えるようにします。
6.5 分散トレーシングとオブザーバビリティ
イベントが複数のサービスとブローカーを経由して非同期にバケツリレーされるため、「どこでエラーが起きたのか」「なぜ遅いのか」を特定するのが非常に難しくなります。
イベント生成時に一意のTrace ID(相関ID)を付与し、各コンポーネントがログを出力する際にそのIDを含めるようにします。OpenTelemetryやJaegerなどの分散トレーシングツールを活用することで、イベントのライフサイクル全体を可視化(オブザーバビリティの向上)することが、安定運用の絶対条件となります。
7. おわりに
イベント駆動アーキテクチャ(EDA)とメッセージキューは、現代の分散システムにおいてスケーラビリティと回復力を高めるための「銀の弾丸」に近い強力なツールです。しかし、それに伴う複雑さ(非同期エラー処理、イベントの重複、トレーシングの困難さ)も同時に引き受ける必要があります。
RabbitMQのような堅牢で柔軟なメッセージキューを利用して非同期ジョブを処理するのか、あるいはKafkaのようなストリーミングプラットフォームを利用して企業全体のデータパイプラインを構築するのか。技術の特性を深く理解し、解決したいビジネス上の課題に合わせて適切なツールとアーキテクチャパターンを選択することが、成功するシステム設計への第一歩となります。