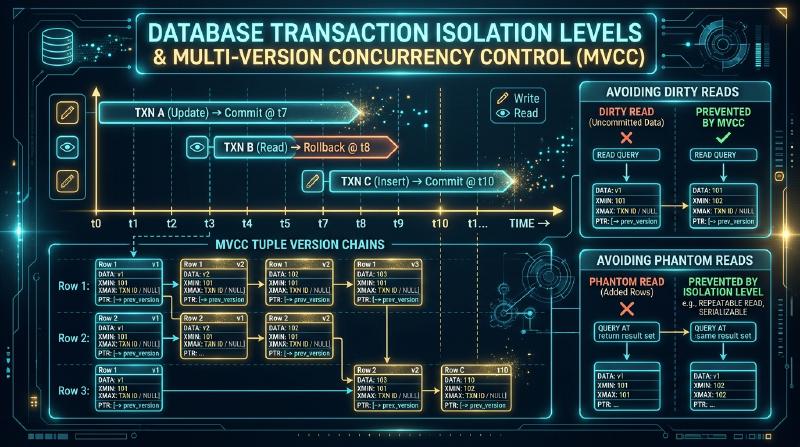
データベースのトランザクション分離レベルとMVCC:ACIDの現実と多版同時実行制御
現代のソフトウェアアーキテクチャにおいて、リレーショナルデータベース管理システム(RDBMS)は依然としてデータ永続化の要であり続けています。その中核を成すのが「トランザクション」という概念であり、特にACID特性(Atomicity, Consistency, Isolation, Durability)は、堅牢なシステムを構築するための基礎理論として広く認知されています。しかし、ACID特性の中でも「Isolation(分離性)」は、理論と実践の間で最も大きな乖離が存在する領域です。
本稿では、データベースのトランザクション分離レベルの歴史的背景から、ANSI SQL-92標準の限界、そして現代のデータベースエンジンが採用するMulti-Version Concurrency Control(MVCC:多版同時実行制御)の内部構造に至るまで、極めて詳細かつ学術的・実践的な視点から深掘りします。特に、PostgreSQLとMySQL(InnoDB)という二大オープンソースRDBMSのMVCC実装の決定的差異を解剖し、分散データベースの最前線であるシリアライザブル・スナップショット分離(SSI)までを網羅する、総計12,000文字を超える超大作としてお届けします。
第1章:ACID特性の神話と並行処理のジレンマ
1.1 直列化可能性(Serializability)の理想
トランザクションのIsolation(分離性)が目指す究極の理想形は「直列化可能性(Serializability)」です。これは、複数のトランザクションが同時に並行して実行された場合でも、その実行結果が「トランザクションを何らかの順序で1つずつ直列(シリアル)に実行した場合の結果と等価になる」という性質を指します。
システム上でトランザクション $T_1$ と $T_2$ が同時に実行されるとき、並行実行によるインターリーブ(操作の交差)がどのように発生しようとも、最終的なデータベースの状態が「$T_1 \rightarrow T_2$」または「$T_2 \rightarrow T_1$」の順で実行した結果と完全に一致していれば、そのスケジュールは直列化可能であると定義されます。この直列化可能性が保証されていれば、アプリケーション開発者は並行処理によるデータの不整合(レースコンディションや不適切な上書きなど)を一切意識することなく、ビジネスロジックの構築に専念できます。
1.2 ロックによる直列化の性能崩壊
初期のデータベースシステムでは、この直列化可能性を保証するために「ツーフェーズロック(2PL: Two-Phase Locking)」と呼ばれる厳格なロック機構が採用されていました。2PLでは、トランザクションはデータを読み書きする前に必ずロック(共有ロックまたは排他ロック)を取得し(フェーズ1:Growing Phase)、トランザクションの終了時(コミットまたはロールバック時)にすべてのロックを解放します(フェーズ2:Shrinking Phase)。
しかし、この厳格なロック機構には致命的な欠陥がありました。それは「性能の極端な劣化」です。
- 読み取り操作が書き込み操作をブロックする。
- 書き込み操作が読み取り操作をブロックする。
- ロック競合による待機時間の増大と、デッドロックの頻発。
トラフィックが増大し、多数のユーザーが同時にデータベースにアクセスするようになると、2PLによる完全な直列化はシステムのボトルネックとなり、スループットは急激に低下しました。システムは「データの整合性」と「並行処理性能(スループット)」という、トレードオフのジレンマに直面することになります。
1.3 同時実行制御の歴史と妥協
このジレンマを解決するため、データベース工学の研究者たちは「分離レベル(Isolation Level)」という概念を導入しました。これは、完全な直列化可能性を一部緩和し、特定のデータ不整合(異常:Anomaly)の発生を許容する代わりに、並行処理性能を向上させるという「妥協の産物」です。アプリケーションの要件に応じて、整合性と性能のバランスを選択できるようにしたのです。
第2章:ANSI SQL-92標準の分離レベルとその批判
2.1 ANSI SQL-92標準による分離レベルの定義
1992年に制定されたSQL標準規格「SQL-92」では、並行処理によって発生する可能性のある3つの代表的な異常(Phenomena)に基づいて、4つの分離レベルを定義しました。
定義された3つの異常(Phenomena)
- Dirty Read(ダーティリード / 汚れ読み): トランザクション $T_1$ がデータを更新し、まだコミットしていない状態で、別のトランザクション $T_2$ がその未コミットデータを読み取ってしまう現象。$T_1$ がロールバックされた場合、$T_2$ は存在しない幻のデータを読み取ったことになります。
- Non-repeatable Read(ノンリピータブルリード / 反復不能読み取り): トランザクション $T_1$ が同じ行を2回読み取る間に、別のトランザクション $T_2$ がその行を更新・コミットしてしまう現象。$T_1$ の1回目と2回目の読み取り結果が異なってしまいます。
- Phantom Read(ファントムリード / 幻影読み取り): トランザクション $T_1$ が特定の検索条件で複数の行を読み取る間に、別のトランザクション $T_2$ がその条件に合致する新しい行を挿入(または削除)しコミットする現象。$T_1$ が同じ条件で再検索すると、行数が増減してしまいます。
SQL-92による4つの分離レベル
SQL-92は、これらの異常の発生を防ぐ度合いに応じて分離レベルを定義しました。
- Read Uncommitted: ダーティリードを許容する。
- Read Committed: ダーティリードを防ぐが、ノンリピータブルリードとファントムリードは許容する。
- Repeatable Read: ダーティリードとノンリピータブルリードを防ぐが、ファントムリードは許容する。
- Serializable: すべての異常を防ぎ、完全な直列化可能性を保証する。
2.2 Berensonらによる批判論文『A Critique of ANSI SQL Isolation Levels』
SQL-92標準の定義は一見すると非常に明確で論理的に見えます。しかし、1995年にHal Berenson、Jim Gray(チューリング賞受賞者)、Phil Bernsteinらデータベース界の巨匠たちによって発表された論文『A Critique of ANSI SQL Isolation Levels』は、このANSI標準の定義に壊滅的な打撃を与えました。
この論文で指摘されたSQL-92標準の主な欠陥は以下の通りです。
1. ロックベースの暗黙の前提
SQL-92の定義は、暗黙のうちに「データベースがロックベースの同時実行制御(2PL)で実装されていること」を前提としていました。しかし、1990年代には既にMVCC(後述)やその他の楽観的同時実行制御(OCC)を採用するデータベースが登場し始めており、ロックを前提とした異常の定義は時代遅れになりつつありました。
2. 定義の曖昧さと不完全性
SQL-92で定義された3つの異常(Dirty Read, Non-repeatable Read, Phantom Read)だけでは、並行処理で発生し得るすべての異常を網羅できていないことが指摘されました。 例えば、**「ダーティライト(Dirty Write)」**という現象があります。これは、未コミットのトランザクションが書き込んだデータを、別の未コミットトランザクションが上書きしてしまう現象ですが、SQL-92標準にはダーティライトに関する言及がありません。すべての分離レベル(Read Uncommittedを含む)はダーティライトを防止しなければならない(さもなければデータベースの内部整合性が崩壊する)にもかかわらず、標準規格はその点に触れていなかったのです。
3. 新たな異常の発見
論文では、SQL-92標準には存在しない新たな異常が複数定義されました。代表的なものが以下の2つです。
- Lost Update(ロストアップデート / 更新喪失): 2つのトランザクションが同時に同じデータを読み取り、それぞれが計算結果を書き戻す際に、一方の更新がもう一方の更新を上書きして消し去ってしまう現象。
- Write Skew(書き込みスキュー): 後述するスナップショット分離に特有の現象。
Berensonらの論文は、SQL-92標準が分離レベルを数学的・厳密に定義できていないことを証明し、データベース業界に多大な衝撃を与えました。現在のデータベース理論において、ANSI SQL-92の分離レベル定義は「歴史的背景として学ぶべきもの」であり、「厳密な技術的定義としては不十分なもの」として扱われています。
第3章:スナップショット分離(Snapshot Isolation)と書き込みスキュー
3.1 Repeatable Readとスナップショット分離の違い
Berensonらの論文で特に注目されたのが**「スナップショット分離(Snapshot Isolation: SI)」**という新しい分離レベルの提唱です。
MVCCを採用する多くのデータベース(PostgreSQLやOracleなど)において、「Repeatable Read」として提供されている分離レベルの実態は、実はこの「スナップショット分離」です。スナップショット分離では、各トランザクションは開始時点におけるデータベースの一貫した「スナップショット(過去の静止状態)」に対して読み取りを行います。
- トランザクション開始時以降に行われた他トランザクションによる更新は一切見えません(ノンリピータブルリードの防止)。
- レコードの存在そのものを過去の時点で固定するため、他トランザクションによるINSERTも見えません(ファントムリードの防止)。
つまり、スナップショット分離はSQL-92が定義する「Repeatable Read」の要件を満たすだけでなく、多くの場合「ファントムリード」まで防いでしまいます。では、スナップショット分離は「Serializable」と等価なのでしょうか? 答えは「否」です。スナップショット分離には**「書き込みスキュー(Write Skew)」**という、直列化可能ではない致命的な異常が存在するからです。
3.2 医師のオンコール当番問題と書き込みスキュー(Write Skew)
書き込みスキューを理解するための最も有名な例が「医師のオンコール(当番)システム」です。
【ビジネスルール】 病院のシフト管理システムがあり、「最低でも1人の医師は常にオンコール(待機)状態でなければならない」というルールがあるとします。
現在、AliceとBobの2人の医師がオンコール状態です(on_call = true)。
このとき、AliceとBobが偶然同時に「気分が悪いのでオンコールを外れたい」と考え、それぞれの端末からシフト変更のトランザクションを開始しました。
【トランザクションの流れ(スナップショット分離の下で)】
- [Tx1: Alice] スナップショットを取得。現在オンコールなのはAliceとBobの2人であることを確認。
SELECT count(*) FROM doctors WHERE on_call = true;-> 結果: 2 - [Tx2: Bob] スナップショットを取得。同じくAliceとBobの2人であることを確認。
SELECT count(*) FROM doctors WHERE on_call = true;-> 結果: 2 - [Tx1: Alice] ルール(オンコールは1人以上)を満たすと判断し、自分自身をオンコールから外す。
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] 同じくルールを満たすと判断し、自分自身をオンコールから外す。
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] コミット成功。
- [Tx2: Bob] コミット成功。(AliceとBobは別のレコードを更新しているため、行ロックは競合しません)
【結果】 Tx1とTx2が両方コミットされた結果、オンコールの医師が「0人」になってしまいました。ビジネスルールが崩壊しています。
これが**書き込みスキュー(Write Skew)**です。 直列化可能(Serializable)であれば、Tx1とTx2のどちらかが先に直列実行されるため、後から実行されたトランザクションはオンコールの人数が「1人」であることを検知し、自身を外す操作をアボート(ロールバック)できたはずです。しかし、スナップショット分離では、互いに異なるデータ行(Alice行とBob行)を更新しているため衝突が検知されず、ビジネスルールの不整合を引き起こしてしまいます。
3.3 ReadOnly Anomaly(読み取り専用異常)
さらに、スナップショット分離には「読み取り専用トランザクション」が介在することで直列化可能性が崩れるReadOnly Anomalyという極めて特殊な異常も存在します。 銀行口座の預金残高と利息付与の例などで示されるこの異常は、更新トランザクション同士では競合が発生しないにもかかわらず、読み取り専用トランザクションが過去のスナップショットを見ることで、「論理的にあり得ない時間軸の状態」を読み取ってしまう現象です。これらの異常の存在により、スナップショット分離は厳密な意味でのSerializableとは区別されます。
第4章:MVCC(Multi-Version Concurrency Control)の動作原理
ここまで分離レベルの理論と異常について述べてきましたが、現代のデータベースはこれらをどのように制御しているのでしょうか。その核心技術が**MVCC(Multi-Version Concurrency Control:多版同時実行制御)**です。
4.1 「読み取りは書き込みをブロックせず、書き込みは読み取りをブロックしない」
MVCCの最大の設計思想であり、ロックベースの制御(2PL)と決定的に異なる点は、「読み取りと書き込みが互いにブロックしない」という点にあります。 レコードを更新する際、MVCCデータベースは既存のレコードを直接上書き(In-place update)しません。代わりに、新しいバージョンのレコード(版・タプル)を作成し、古いバージョンのレコードも同時に保持します。
データベース内には、同じレコードの複数のバージョン(過去から現在に至る履歴)が同時に存在することになります。 トランザクションがデータを読み取る際は、自身の「トランザクションID(XID)」や「開始時刻(タイムスタンプ)」に基づき、システム内に存在する多数のバージョンの中から「自分が読むべき正しい過去のバージョン」を算出して読み取ります。
これにより、あるトランザクションがレコードを書き換えている最中であっても、他のトランザクションは「書き換えられる前の過去のバージョン」を読み取ることができ、ロックによる待機を回避できます。
4.2 タプルの版管理チェーンと可視性(Visibility)ルール
MVCCにおいて最も重要なアルゴリズムは、「どのトランザクションが、どのバージョンのデータを見ることができるか」を判定する**可視性ルール(Visibility Rule)**です。
各トランザクションには、開始時に単調増加する一意のトランザクションID(XID)が割り当てられます。 データベースに保存される各レコードのバージョン(タプル)には、メタデータとして以下の情報が付与されます。
- 作成XID: このバージョンをINSERT/UPDATEによって作成したトランザクションのID。
- 削除XID: このバージョンをUPDATE/DELETEによって論理的に削除した(無効化した)トランザクションのID。
トランザクション $T_i$ がデータ行を読むとき、以下の基本ルールに基づいて可視性を判定します。
- コミットされているか: 作成XIDのトランザクションが既にコミットされているか?
- 未来ではないか: 作成XIDは、$T_i$ が開始された時点より過去のトランザクションか?
- 削除されていないか: 削除XIDが設定されていない、または削除XIDのトランザクションがまだコミットされていない、あるいは $T_i$ 開始時点より未来のトランザクションか?
これらの条件を厳密に評価することで、各トランザクションに一貫したスナップショットを提供しています。
第5章:PostgreSQL vs MySQL (InnoDB) のMVCC実装の決定的差異
MVCCの基本理念は同じでも、その内部実装はデータベース製品によって驚くほど異なります。ここでは、オープンソース界の双璧をなすPostgreSQLとMySQL(InnoDB)のMVCCアーキテクチャを比較解剖します。
5.1 PostgreSQLのMVCC実装:ヒープ内追記とVACUUMの必然性
PostgreSQLのMVCCは、非常にユニークかつ直感的な**「追記型(Append-only)アーキテクチャ」**を採用しています。
5.1.1 xminとxmaxによるビット判定ロジック
PostgreSQLのテーブルの実体であるデータファイル(ヒープ)内には、各行(タプル)のヘッダに xmin と xmax という2つのトランザクションIDが記録されています。
xmin(Transaction ID of Insert): このタプルを作成したトランザクションのXID。xmax(Transaction ID of Delete): このタプルを削除(または更新による旧版の論理削除)したトランザクションのXID。
【UPDATE操作の挙動】
PostgreSQLにおいて UPDATE は、論理的には DELETE と INSERT の組み合わせとして処理されます。
- 古いタプルの
xmaxに、現在のトランザクションXIDを書き込む。(論理削除) - 全く新しいタプルをヒープの空き領域に作成し、新しいデータを書き込み、
xminに現在のトランザクションXIDをセットする。(新規追加)
つまり、新旧両方のタプルが、同じテーブルデータファイル(ヒープ)内に混在して保存されます。
5.1.2 巨大な利点と致命的な課題:VACUUMの存在
このアーキテクチャの最大の利点は、ロールバックが極めて高速であることです。トランザクションがアボートした場合、追加したタプルを「未コミット」として扱うだけで済み、データの書き戻し処理が不要です。
しかし、致命的な課題として**「不要タプル(Dead Tuples)の肥大化」**があります。
UPDATEやDELETEを繰り返すと、誰からも参照されなくなった古いバージョンのタプル(xmax がコミット済みの古いトランザクションIDになっているタプル)がヒープ内に無限に蓄積されていきます。これを放置すると、テーブルの物理サイズが爆発的に膨張し、シーケンシャルスキャンのパフォーマンスが壊滅的に低下します。
この不要タプルを物理的に削除し、空き領域を再利用可能にするためのシステムプロセスが**VACUUM**(および自動で実行される autovacuum デーモン)です。PostgreSQLの運用においてVACUUMのチューニングが極めて重要とされる理由は、このMVCCアーキテクチャの根幹に起因しています。
5.2 MySQL InnoDBのMVCC実装:インプレース更新とUndoログの動的再構築
一方、MySQLのデフォルトストレージエンジンであるInnoDBは、Oracle Databaseに近い**「インプレース更新(In-place update)とUndoログ(ロールバックセグメント)」**によるアーキテクチャを採用しています。
5.2.1 クラスタインデックスとインプレース更新
InnoDBのテーブルは、主キーをベースにしたB+Tree(クラスタインデックス)として構成されています。
InnoDBにおいて UPDATE が実行されると、PostgreSQLのように新しい行を追記するのではなく、**B+Tree上のデータ行を直接上書き(In-place update)**します。
では、他のトランザクションが過去のスナップショットを読みたい場合はどうするのでしょうか? そのためにInnoDBは、上書きする前の「古いデータ」を、専用の領域である**Undoログ(Undo Log Segment)**に退避させます。
5.2.2 ロールポインタ(Roll Pointer)による過去の動的再構築
InnoDBの各データ行の隠しカラムには、以下の2つが含まれています。
DB_TRX_ID: この行を最後に挿入または更新したトランザクションのID。DB_ROLL_PTR(Roll Pointer): この行の「1つ古いバージョン」が保存されているUndoログ内の場所を指し示すポインタ。
トランザクションが過去のスナップショットを読み取るプロセスは以下のようになります。
- B+Treeから最新のデータ行を読み取る。
DB_TRX_IDを確認し、自分のスナップショットより未来のトランザクションによる更新であれば、この最新行は読んではいけないと判断する。DB_ROLL_PTRをたどり、Undoログから過去のバージョンのデータを取得する。- Undoログ上のデータを用いて、メモリ上で過去のレコードの状態を**動的に再構築(Rollback in memory)**する。
- それでもまだ未来の更新であれば、さらにUndoログのチェーンを過去へと遡る。
5.2.3 InnoDBの利点と課題
このアーキテクチャの利点は、メインのテーブル領域(テーブルスペース)が肥大化しにくいことです。最新のデータは常にB+Treeの適切な位置にあり、過去のバージョンは別領域(Undoログ)に隔離されているため、物理的な走査効率が高く保たれます(PostgreSQLのような大規模なVACUUMは不要で、Undoログのパージプロセスがバックグラウンドで軽く動作します)。
一方で欠点は、過去のスナップショットを大量に読み取るような長時間実行トランザクション(バッチ処理やmysqldumpなど)が存在する場合、Undoログを深く遡ってデータを再構築するオーバーヘッドが発生し、読み取りパフォーマンスが低下することです。また、Undoログ自体が肥大化し、ディスクスペースを圧迫するリスクも抱えています。
第6章:シリアライザブル・スナップショット分離(SSI)と分散データベースの最前線
MVCCの進化は、ここで終わりません。第3章で説明した通り、スナップショット分離(SI)には「書き込みスキュー」などの異常が存在し、完全なSerializableではありませんでした。しかし、アプリケーション開発者に並行処理の複雑さを意識させないためには、完全なSerializableを、MVCCの高い性能を維持したまま実現する必要があります。
6.1 シリアライザブル・スナップショット分離(SSI)の誕生
2008年、Michael Cahillらによる論文で**「Serializable Snapshot Isolation (SSI)」**という画期的なアルゴリズムが発表されました。これは、MVCCアーキテクチャをベースにしながら、完全な直列化可能性(Serializable)を保証する技術です。PostgreSQLはバージョン9.1から、いち早くこのSSIを「Serializable」分離レベルの実装として採用しました。
SSIの動作原理:競合グラフと危険構造(rw-antidependency)
SSIは、ロックによるブロックを行いません。その代わり、トランザクションの実行中に「どのデータが読み取られ(Read)、どのデータが書き込まれたか(Write)」を細かく追跡(トラッキング)します。
SSIは、トランザクション間の競合関係を監視し、**「rw-antidependency(読み取り・書き込みの反依存性)」**と呼ばれる特定の競合パターンを探します。 具体的には、トランザクション $T_1$ が過去のバージョンのデータを読み取り、そのデータを後に別のトランザクション $T_2$ が上書きコミットするような関係です。 SSIは内部的にトランザクションの競合グラフを構築し、「rw-antidependencyの矢印が2つ連続する構造(危険構造)」を検知した瞬間、直列化可能性が崩壊する可能性があると判断して、一方のトランザクションを強制的にアボート(ロールバック)させます。
これにより、書き込みスキュー(例:医師のオンコール問題)のような異常が発生する前にトランザクションを停止させ、結果的に完全なSerializableを保証します。楽観的並行性制御(OCC)の究極形と言えるでしょう。
6.2 分散データベースにおけるMVCC:Spanner, CockroachDB, TiDB
現代のデータベース技術は、単一サーバーの限界を超え、世界中のデータセンターに分散配置される分散SQLデータベース(NewSQL)へと進化しています。分散環境において、グローバルな一貫性を持つMVCCを実現することは、物理法則に対する挑戦でもありました。
Google SpannerとTrueTime API
GoogleのSpannerは、分散システムにおけるトランザクションの順序付け問題を解決するためにTrueTime APIを開発しました。 各サーバーの時計(物理クロック)は必ずズレる(クロックスキュー)という前提の下、GPSと原子時計を組み合わせ、現在時刻を「不確実性の範囲(タイムウィンドウ)」として提供します。 SpannerのMVCCは、トランザクションのコミット時にこのTrueTimeの不確実性ウィンドウが過ぎるのを待つ(Commit Wait)ことで、「因果関係のあるトランザクションは、必ずタイムスタンプ順序が正しくなる(外部一貫性 / External Consistency)」ことを物理的に保証しました。
CockroachDBとHLC(Hybrid Logical Clock)
Spannerにインスパイアされたオープンソースの分散データベースであるCockroachDBは、高価な原子時計を使わずにこれに近い一貫性を実現するため、**HLC(ハイブリッド論理クロック)**を採用しています。 NTPによる物理クロックの同期と、Lamport論理クロック(イベント間の因果関係に基づくカウンタ)を組み合わせることで、分散ノード間でグローバルに一貫したMVCCのスナップショットタイムスタンプを生成し、SSI(Serializable Snapshot Isolation)を分散環境で実現しています。
TiDBとPercolatorモデル
PingCAP社が開発するTiDBは、Google Percolatorのモデルをベースにした分散トランザクションモデルを採用しています。 グローバルなタイムスタンプを払い出す単一のコンポーネント(Placement Driver: PD)を用意し、各ノードのストレージエンジン(TiKV)がそのタイムスタンプを用いてローカルにMVCCを処理するアーキテクチャです。2PC(Two-Phase Commit)をベースにしながらも、ロックの保持期間を最小化し、分散環境での巨大なトランザクションとMVCCを両立させています。
結論:ACIDの向こう側へ
データベースのトランザクション分離レベルは、決して単なる暗記項目ではありません。それは、データの一貫性とシステムのパフォーマンスという、背反する要求をいかにして調和させるかという、数十年におよぶコンピュータサイエンスの闘いの歴史そのものです。
ANSI SQL-92の不完全な定義から始まり、MVCCによる並行処理の飛躍的向上、PostgreSQLとInnoDBというアーキテクチャの分岐、そしてSSIや分散データベースによる究極の一貫性への挑戦。 これらの内部構造を深く理解することは、より堅牢で、高パフォーマンスなアプリケーションを設計するための強力な武器となるはずです。
私たちは今、ACID特性が単なる「神話」ではなく、高度なアルゴリズムと物理的な時計の同期によって「現実」のものとして実装される時代を生きています。データの海を航海するエンジニアにとって、データベースエンジンの深淵を知ることは、決して尽きることのない知的な探求の旅なのです。