1. Introduction
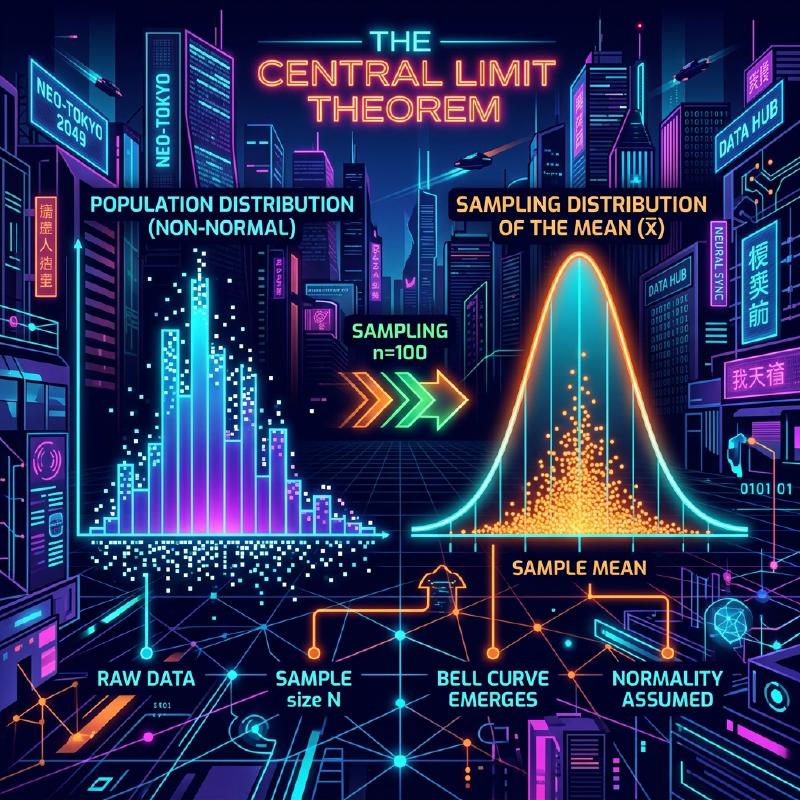
Le théorème central limite (TCL) est fondamental en science des données et en statistique. Nous considérons ici des observations indépendantes et identiquement distribuées, de moyenne finie et de variance finie strictement positive. Sous ces conditions, la loi de la moyenne empirique centrée et réduite tend vers la loi normale centrée réduite lorsque la taille de l’échantillon augmente. Les observations initiales ne deviennent pas elles-mêmes normales.
Dans cet article, nous expliquerons largement le Théorème Central Limite, depuis une image intuitive jusqu’à une définition mathématique stricte et des exemples d’applications pratiques.
2. Qu’est-ce que le Théorème Central Limite ?
Le théorème central limite (TCL) est un résultat important des probabilités et de la statistique. Dans sa forme élémentaire, la somme ou la moyenne convenablement centrée et réduite de variables indépendantes et identiquement distribuées converge en loi vers la loi normale centrée réduite, à condition que leur moyenne commune soit finie et leur variance finie strictement positive. Cette forme ne s’applique pas aux lois qui ne satisfont pas ces conditions, comme la loi de Cauchy.
2.1 Compréhension Intuitive
Prenons l’exemple des dés. Lorsque vous lancez un seul dé, la distribution des résultats est une distribution uniforme. Cependant, lorsque vous lancez deux dés et prenez leur somme, la distribution devient un triangle culminant à 7 au centre. Au fur et à mesure que vous augmentez encore le nombre de dés, la distribution de leur somme s’approche d’une courbe douce en forme de cloche, c’est-à-dire une distribution normale.
2.2 Définition Mathématique
Supposons que les \(n\) observations \(X_1, X_2, \dots, X_n\) soient indépendantes et identiquement distribuées (i.i.d.), de moyenne commune finie \(\mu\) et de variance \(0<\sigma^2<\infty\).
Soit la moyenne empirique \(\bar{X} = \frac{1}{n} \sum_{i=1}^{n} X_i\). Selon le Théorème Central Limite, lorsque \(n\) est suffisamment grand, la variable standardisée \(Z\) comme illustré ci-dessous converge vers la distribution normale standard \(\mathcal{N}(0, 1)\).
\[ Z = \frac{\bar{X} - \mu}{\frac{\sigma}{\sqrt{n}}} \xrightarrow{d} \mathcal{N}(0, 1) \text{ pour } n \to \infty \]Ici, \(\xrightarrow{d}\) signifie la convergence en distribution. \(\text{ pour } n \to \infty\) indique que la taille de l’échantillon approche de l’infini.
3. Visualisation du Théorème Central Limite
Pour comprendre visuellement comment fonctionne le Théorème Central Limite, voici un diagramme de processus utilisant Mermaid.
  graph TD
    A["Distribution d'Origine (Non Normale)"] -->|"Échantillonnage"| B["Échantillon 1"]
    A -->|"Échantillonnage"| C["Échantillon 2"]
    A -->|"Échantillonnage"| D["Échantillon N"]
    B -->|"Calcul de la Moyenne"| E["Moyenne empirique 1"]
    C -->|"Calcul de la Moyenne"| F["Moyenne empirique 2"]
    D -->|"Calcul de la Moyenne"| G["Moyenne empirique N"]
    E -->|"Dessin de la Distribution"| H["Approximation à la Distribution Normale"]
    F -->|"Dessin de la Distribution"| H
    G -->|"Dessin de la Distribution"| H
4. Simulation avec Python
Au lieu de se contenter de la théorie, exécutons un programme pour vérifier cela. Nous allons simuler l’extraction de données à partir d’une distribution uniforme et voir comment leur moyenne est distribuée.
| |
Lorsque vous exécutez ce code, vous pouvez confirmer que pour \(n=1\), c’est une distribution uniforme, mais à mesure que \(n\) augmente, l’histogramme s’approche de la ligne rouge de la distribution normale.
5. Importance et Applications du Théorème Central Limite
Lorsque les conditions du TCL sont remplies et que l’échantillon est suffisamment grand, une approximation normale de la loi de la moyenne empirique permet de réaliser des tests d’hypothèses et de construire des intervalles de confiance sans connaître la loi exacte de la population. La précision doit être évaluée séparément pour les petits échantillons ou les lois à queues lourdes.
5.1 Fondement de l’Inférence Statistique
Lorsque nous déduisons quelque chose à partir des données, comme dans les sondages d’opinion, le contrôle qualité ou les tests A/B, une grande partie du raisonnement repose sur le Théorème Central Limite.
5.2 Accumulation des Erreurs
Les erreurs de mesure et de nombreux bruits naturels peuvent être modélisés comme des sommes de petits facteurs indépendants ; une approximation normale peut alors être adaptée. La loi normale est aussi appelée loi gaussienne.
6. Pour Aller Plus Loin : Approche de la Preuve
Les fonctions caractéristiques et le développement de Taylor sont utilisés pour une preuve stricte du Théorème Central Limite. En voici un bref aperçu.
En utilisant la fonction caractéristique \(\phi_X(t) = E[e^{itX}]\), la fonction caractéristique de la somme de variables aléatoires indépendantes est le produit de leurs fonctions caractéristiques respectives. Lorsque nous calculons la fonction caractéristique de la variable standardisée \(Z\) et prenons la limite pour \(n \to \infty\), on peut montrer qu’elle converge vers \(e^{-t^2/2}\), qui est la fonction caractéristique de la distribution normale standard. Cela prouve que la distribution elle-même converge vers une distribution normale.
7. Conclusion
Le Théorème Central Limite est un théorème extrêmement beau qui montre l’ordre caché derrière des données chaotiques. En comprenant ce théorème, vous pourrez acquérir des connaissances plus approfondies dans l’analyse de données et la construction de modèles statistiques.
Annexe : Contexte Mathématique Détaillé et Histoire
Annexe 1 : Développement dans la Théorie des Probabilités
L’histoire du Théorème Central Limite est profonde, trouvant son origine avec Abraham de Moivre qui a montré l’approximation normale de la distribution binomiale. Elle a ensuite été étendue par Pierre-Simon Laplace, et Aleksandr Lyapunov a fourni une preuve sous des conditions plus générales. Dans la théorie des probabilités moderne, il existe diverses extensions telles que la condition de Lindeberg et la condition de Lyapunov. Ces conditions garantissent que les variables aléatoires individuelles n’ont pas d’influence dominante sur la somme totale. Cela donne une réponse à la question fondamentale de savoir pourquoi divers phénomènes dans la nature et les sciences sociales peuvent être approximés par une distribution normale.
Annexe 2 : Conditions d’Application et Signification du Théorème
Dans la forme de base discutée dans ce texte, il est requis que \(X_1,\ldots,X_n\) soient indépendantes et identiquement distribuées, avec une moyenne finie \(\mu\) et une variance positive finie \(0<\sigma^2<\infty\). Veuillez comprendre l’explication “n’importe quelle distribution” dans le cadre de ces conditions. Ce qui s’approche d’une distribution normale, c’est la distribution de la somme standardisée ou de la moyenne empirique, et la distribution des observations individuelles ne change pas.
Annexe 3 : Erreur-type et Loi des Grands Nombres
En raison de l’indépendance, l’espérance et la variance de la moyenne empirique sont les suivantes. L’erreur-type est l’écart type de la moyenne empirique, et non celui des observations individuelles.
\[ E[\bar X_n]=\mu,\qquad \operatorname{Var}(\bar X_n)=\frac{\sigma^2}{n},\qquad \operatorname{SE}(\bar X_n)=\frac{\sigma}{\sqrt n}. \]Multiplier par quatre la taille de l’échantillon réduit de moitié l’erreur-type. La loi des grands nombres stipule que la moyenne empirique s’approche de \(\mu\), et le Théorème Central Limite décrit la forme de la distribution en multipliant la fluctuation autour d’elle par \(\sqrt{n}\).
Annexe 4 : Preuve Supplémentaire Utilisant des Fonctions Caractéristiques
Soit \(Y_i=(X_i-\mu)/\sigma\) et \(Z_n=n^{-1/2}\sum_{i=1}^nY_i\). Puisque \(E[Y_i]=0\) et \(E[Y_i^2]=1\), la fonction caractéristique peut être développée près de l’origine comme suit.
\[ \phi_Y(t)=E[e^{itY}]=1-\frac{t^2}{2}+o(t^2)\quad(t\to0). \]D’après l’indépendance, on obtient l’équation suivante. Puisque la limite est la fonction caractéristique de la distribution normale standard, la convergence en distribution découle du théorème de continuité de Lévy. Les fonctions caractéristiques et les fonctions génératrices de moments sont différentes, et l’existence d’une fonction génératrice de moments n’est pas nécessaire pour cette preuve.
\[ \phi_{Z_n}(t)=\left[\phi_Y\!\left(\frac{t}{\sqrt n}\right)\right]^n =\left[1-\frac{t^2}{2n}+o\!\left(\frac1n\right)\right]^n \longrightarrow e^{-t^2/2}. \]Annexe 5 : Exemples Inapplicables et Précision de l’Approximation
La distribution de Cauchy n’a ni moyenne finie ni variance finie, et la moyenne empirique de variables de Cauchy standard indépendantes reste une distribution de Cauchy standard. De plus, si toutes les \(X_i\) sont égales à la même variable aléatoire non dégénérée, il n’y a pas d’indépendance, et prendre la moyenne ne réduit pas la dispersion. Il n’y a aucune garantie que “\(n\ge30\) est toujours suffisant”. La taille de l’échantillon requise varie en fonction de l’asymétrie et de l’épaisseur des queues. Pour les extensions aux cas qui sont indépendants mais non identiquement distribués, il est nécessaire de vérifier des conditions supplémentaires telles que les conditions de Lindeberg ou de Lyapunov.