虛擬記憶體與分頁機制的完全解剖:從MMU到TLB、HugePage,以及記憶體管理的深淵
在現代的作業系統(OS)與CPU架構中,最複雜卻也是最重要的系統之一,就是「虛擬記憶體(Virtual Memory)」與「分頁(Paging)」機制。在應用程式開發者平時不會注意到的記憶體空間背後,硬體的MMU(Memory Management Unit,記憶體管理單元)與OS核心正密切地協同合作,在奈秒的世界裡進行龐大的位址轉換與例外處理。
本文將從作業系統內部結構與電腦架構的觀點,解剖虛擬記憶體系統的最深處。從x86-64架構的分頁表結構之完整位元配置(Bit Layout)、TLB擊落(TLB Shootdown)的IPI協定、Linux核心中分頁錯誤(Page Fault)的完整追蹤、寫入時複製(Copy-on-Write, CoW)的物理機制、記憶體回收(Reclaim)演算法,到OOM Killer的分數計算公式,我們將從原始碼層級與暫存器層級徹底解說這些底層機制。
第1章:虛擬記憶體的存在理由與歷史背景
為什麼電腦需要虛擬記憶體呢?在早期的電腦系統中,程式會直接存取實體記憶體(RAM)的特定位址。然而,隨著多工環境的普及,這種「直接指定實體位址的方式」便迎來了極限。
1.1 記憶體保護與行程空間的完全分離
虛擬記憶體的最大目的是「確保安全性與穩定性」。如果行程A不小心(或惡意地)改寫了行程B的記憶體,就會導致整個系統崩潰或機密資訊外洩。虛擬記憶體給予每個行程一種「擁有自己專屬的連續記憶體空間」的幻覺。藉此,行程之間的記憶體在硬體層級(MMU)被嚴格分離,不合法的記憶體存取會立即被捕捉(Trap),並作為分段錯誤(Segmentation Fault)處理。使用者空間與核心空間的分離也是藉由這項機制實現的,特權層級(Privilege Ring)的轉換與記憶體存取權限的檢查,都會在每個週期由硬體執行。
1.2 打破實體記憶體容量的極限與需求分頁的思想
應用程式所要求的記憶體量超過系統搭載的實體RAM容量,這點並不罕見。虛擬記憶體會將目前未使用的記憶體區域(分頁,Page)轉移(Swap Out,置換出)到次要儲存裝置(HDD/SSD)中,並在需要時再次讀入(Swap In,置換入),從而提供比實體記憶體還要廣大的位址空間。此外,程式開始執行時並不會將所有程式碼與資料讀入記憶體,而是到了發生存取時才首次載入記憶體的「需求分頁(Demand Paging)」思想,同時兼顧了節省記憶體與加快啟動速度。
1.3 從分段到分頁的典範轉移
早期的x86(如80286)使用了以可變長度區塊來管理記憶體的「分段(Segmentation)」機制。這是一種使用CS(程式碼區段)、DS(資料區段)等暫存器,並以基底位址加偏移量來計算邏輯位址的方式。然而,分段很容易引發「外部碎片(External Fragmentation,記憶體碎片化)」,管理起來極為繁雜。其後,隨著80386的問世,引入了以固定長度(通常為4KB)區塊進行管理的「分頁(Paging)」,並成為主流。現代的64位元作業系統(如Linux或Windows)將分段設定為平坦記憶體模型(Flat Memory Model,基底位址0、限制最大),實際上使其無效化,僅透過分頁來進行記憶體管理。分段目前僅被用於極少數的用途,例如執行緒區域儲存區(TLS)的參照(FS/GS暫存器)。
第2章:x86-64中分頁表的多層結構與位元配置完全解剖
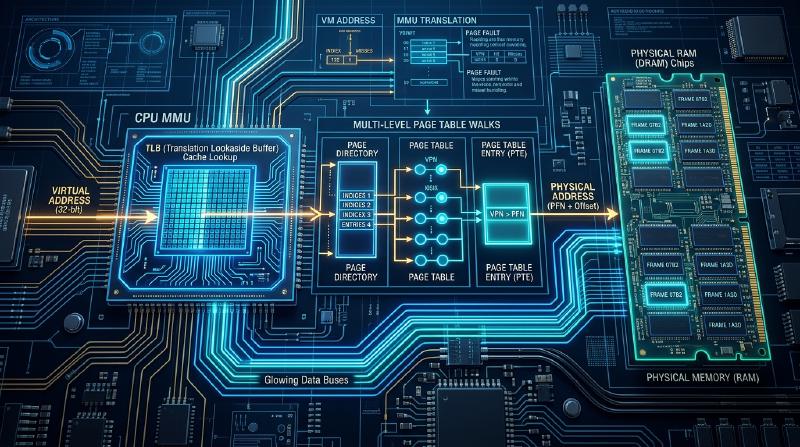
在64位元架構(x86-64/AMD64)中,虛擬位址空間非常廣大。在目前主流的「48位元虛擬位址空間」中,硬體MMU會尋訪4層的分頁表。
2.1 48bit/57bit虛擬位址空間與正準形式(Canonical Form)的限制
雖然64位元暫存器可以表示高達16 Exabytes的廣大位址空間,但基於成本與複雜度的考量,目前的硬體實作並沒有使用到全部。在48位元的實作中,有一個限制是虛擬位址的第47至第63位元必須全部是相同的值(符號擴充)。滿足這個限制的位址便稱為「正準形式位址(Canonical Address)」。
藉此,記憶體空間的結構便會在中央擁有一塊巨大的未使用區域(Non-canonical洞),並漂亮地一分為二:下半部的使用者空間(0x0000000000000000 ~ 0x00007FFFFFFFFFFF)與上半部的核心空間(0xFFFF800000000000 ~ 0xFFFFFFFFFFFFFFFF)。若對不合法的指標(例如在最高位元嵌入元資料的指標)進行解指標(Dereference),MMU會立即將其視為違反Canonical規則,並引發一般保護例外(General Protection Fault, #GP)。近年來,在Intel Ice Lake之後的處理器中,也開始支援進一步擴充的57位元虛擬空間(5層分頁表),成為處理Petabyte等級記憶體的雲端基礎設施之基石。
2.2 4層分頁表的階層結構(PML4, PDPT, PD, PT)詳細說明
為了將48位元虛擬位址轉換為實體位址,x86-64使用了4個階層的分頁表(基底樹/Radix Tree狀的資料結構)。每個分頁表的大小皆為4KB,並存放512個64位元(8位元組)的項目(Entry)(2^9 = 512)。虛擬位址會被分割如下,並作為每個階層的索引來發揮作用。
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - 最上層。CR3暫存器會指向其物理基底位址。
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - 在2MB HugePage的情況下,這裡就是終點。
- Bits 12-20 (9 bits): PT (Page Table) Index - 一般4KB分頁中的最終表格。
- Bits 0-11 (12 bits): Page Offset - 4KB(4096位元組)分頁內的偏移量。
2.3 分頁表項目(PTE)的64位元配置完全解析
分頁表中的每個64位元項目,不單純只是實體位址的指標,而是掌管強大存取控制與快取控制的元資料(Metadata)集合體。以下列出x86-64 PTE的完整位元配置及其詳細功能。
- Bit 0 [P] Present: 若為1,表示存在於實體記憶體上。若為0,表示已置換出(Swapped out),或是尚未分配。在0的狀態下存取,會發生分頁錯誤(#PF)例外。
- Bit 1 [R/W] Read/Write: 若為0,表示唯讀(Read-Only,不可寫入);若為1,表示可讀寫(Read/Write)。在實作CoW(Copy-on-Write)時扮演極其重要的角色。
- Bit 2 [U/S] User/Supervisor: 若為0,表示只有特權模式(核心)才能存取。若為1,表示從使用者模式(Ring 3)也能存取。會被KPTI或SMAP等機制嚴格管理。
- Bit 3 [PWT] Page-level Write-Through: 若為1,會將此分頁的快取寫入策略設為Write-Through。若為0,則為Write-Back。
- Bit 4 [PCD] Page-level Cache Disable: 若為1,則將此分頁的快取無效化(Uncacheable)。通常用於記憶體映射I/O(MMIO)等直接存取PCIe裝置暫存器的情況。
- Bit 5 [A] Accessed: 當MMU存取(Read或Write)此分頁時,會由硬體自動將其設為1。在OS的LRU演算法(分頁回收)中被用作參照位元。
- Bit 6 [D] Dirty: 當MMU對此分頁進行「寫入」時,會由硬體自動將其設為1。這是OS用來判斷是否需要將其寫回硬碟(置換出)的必備位元。
- Bit 7 [PAT] Page Attribute Table: 與PWT/PCD組合使用,用來指定更詳細的記憶體快取類型(如WC: Write-Combining)的索引。通常用於對顯示卡記憶體(VRAM)進行高速的大量傳輸。
- Bit 8 [G] Global: 若為1,即使CR3暫存器發生切換(發生上下文切換,Context Switch),也不會將此項目從TLB中清除(Flush)。主要用於核心空間的分頁,以避免系統呼叫時發生TLB Miss帶來的效能懲罰。
- Bits 9-11 [AVL] Available: 作業系統(核心)可自由利用的3個位元。在Linux中,有時會被活用於置換項目的元資料,或NUMA節點的識別等。
- Bits 12-51 [PFN] Physical Frame Number: 轉換目標的實體分頁之基底位址(實體幀號)。因為是4KB對齊(Aligned),所以低位的12個位元永遠被視為0。
- Bits 52-62 [AVL/PKU] Available/Ignored: 根據CPU的世代或功能擴充(如Intel MPK: Memory Protection Keys),作為保留或作業系統可使用的區域。
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: 若為1,則將此分頁上的資料設為「不可作為指令執行」。這是用來防止緩衝區溢位等針對資料區段進行程式碼注入攻擊的強大安全機制(DEP: Data Execution Prevention)。
如上所述,PTE的各個位元與OS的記憶體管理演算法(特別是置換處理、安全保護、I/O控制)緊密結合,作為硬體與軟體邊界上的介面,是非常洗鍊的設計。
第3章:由MMU進行的硬體分頁表尋訪與延遲之壁
從虛擬位址到實體位址的轉換,是由存在於CPU核心內部的**MMU (Memory Management Unit,記憶體管理單元)**這個專用硬體電路來執行的。
3.1 以CR3暫存器為起點的分頁表尋訪機制
處理器的控制暫存器 CR3 中,存放著目前執行中行程的最高層級分頁表(PML4)的實體位址。當Linux等作業系統執行上下文切換,將CPU的執行權讓給其他行程時,便會將這個 CR3 暫存器改寫為新行程的PML4位址。藉此,行程的記憶體空間整體就會在瞬間完成切換。
以下說明概念性的流程。
- 取出虛擬位址的最高層索引,並讀取CR3所指向的PML4表格中的對應項目。
- 取出PML4項目的PFN,算出下一個PDPT表格的實體位址。
- 讀取PDPT表格的對應項目。
- 同樣地尋訪PD表格、PT表格,並取得最終的4KB實體分頁的基底位址。
- 最後加上12位元的分頁偏移量,建構出完整的實體位址。
3.2 記憶體匯流排存取與延遲(Latency)這個最大的障礙
這種4層分頁表尋訪最大的弱點在於「記憶體存取延遲」。光是轉換1個虛擬位址,在最糟的情況下,會對實體記憶體發生4次存取(讀取PML4, PDPT, PD, PT)。 現代DRAM的存取延遲大約為50到100奈秒。如果4次記憶體存取都錯過了CPU的快取(L1/L2/L3)而到達DRAM,光是這樣就會發生數百奈秒的停滯(Stall)。考慮到CPU的時脈週期大約是0.3奈秒(3GHz),這相當於是數千個週期的致命延遲,CPU的管線(Pipeline)將會完全枯竭並停止運作。 為了解決這個極為嚴重的效能瓶頸,所設計出來的機制就是接下來要解說的TLB。
第4章:多核心環境下的TLB架構與擊落(Shootdown)的苦惱
TLB(Translation Lookaside Buffer,轉譯後備緩衝區)是內建於MMU中的「虛擬位址到實體位址轉換結果的快取」,由超高速的SRAM(或CAM: Content Addressable Memory)所構成。
4.1 TLB的階層結構與透過PCID(Process-Context Identifier)的最佳化
在最新的CPU中,TLB也擁有L1/L2的階層結構。L1 D-TLB(資料用)與L1 I-TLB(指令用)雖然容量非常小(數十個項目),但能以1個週期回應。L2 TLB則擁有數百到數千個項目,並以數個週期回應。 當TLB中不存在該項目時(TLB Miss),便會發生前述的硬體分頁表尋訪(Page Walk)。為了支援這項操作,也實作了分頁尋訪專用的快取(PWC: Page Walk Cache)。
因為行程切換後,虛擬位址的意義就會改變,因此在過去(x86早期),改寫CR3時會將TLB全部清除(Flush)。然而,這會導致上下文切換後頻繁發生TLB Miss,使得效能顯著下降。 為了解決這個問題所引入的技術,就是PCID(Process-Context Identifier)(在ARM架構中稱為ASID)。透過在TLB項目中賦予一個能唯一識別行程的12位元ID(標籤),使得在上下文切換後也能繼續保留先前行程的TLB項目,這讓Web伺服器或資料庫等多行程環境的效能獲得了戲劇性的提升。
4.2 TLB擊落(TLB Shootdown)的處理器間中斷(IPI)協定
在多核心環境中,虛擬記憶體系統面臨著非常棘手的同步問題。例如,假設在核心0(CPU0)上執行的行程透過 munmap() 釋放了特定的記憶體區域,並將分頁表的PTE無效化(Present = 0)。然而,在核心1(CPU1)的區域TLB中,可能還殘留著該虛擬位址到實體位址的「舊轉換資訊(Stale TLB Entry)」快取。
如果放任不管,核心1就會存取到已釋放的記憶體,進而破壞分配給其他行程的資料,或是讀取到機密資訊,造成嚴重的安全性漏洞。為了防止這種情況,OS必須強制核心1從其TLB中刪除該對應項目。這就是所謂的TLB擊落(TLB Shootdown)。
TLB擊落會嚴格按照以下步驟(IPI協定)執行:
- 發起者(核心0): 更新分頁表(清除PTE)後,發出記憶體屏障(如
mfence),並對目標的其他核心(核心1)的區域APIC(Advanced Programmable Interrupt Controller)發送IPI(Inter-Processor Interrupt: 處理器間中斷)。 - 待機(忙碌等待,Busy-wait): 核心0會以自旋鎖(Spinlock)待機,直到所有其他的目標核心處理完中斷為止。
- 目標(核心1): 收到IPI後,會立即中斷目前正在執行的使用者程式碼,並轉移到核心的中斷處理常式(在Linux中,是經由
smp_call_function呼叫flush_tlb_func等)。 - 執行清除: 核心1會從自身的區域TLB中將指定的虛擬位址項目無效化(在x86中使用
INVLPG指令;若是全部清除,則重新載入CR3)。 - 完成通知: 核心1將清除完成的狀態寫入記憶體上的旗標,以解除核心0的待機。隨後,恢復被中斷的處理(
iret)。
效能瓶頸與擴展性的極限: TLB擊落牽涉到硬體的IPI發出、中斷的上下文切換、管線清除,以及多個核心之間的自旋鎖待機,因此這是一項會消耗數千至數萬個週期的極高成本操作。隨著核心數增加到16、64、128等,這種同步成本會呈指數級別增加,成為雲端伺服器或HPC中多執行緒應用程式(特別是頻繁重複配置與釋放記憶體的應用程式)在擴展時嚴重的阻礙因素。
第5章:Linux核心中分頁錯誤處理的完整追蹤
當程式存取分頁表中 Present 位元為0的區域,或是沒有權限的區域(例如試圖寫入Read-Only區域、從使用者模式存取核心區域等)時,MMU會發出分頁錯誤例外(在x86中為 Exception 14, #PF)。從這裡開始,便展開了Linux核心深奧的例外處理之旅。
5.1 分頁錯誤的控制流程與架構相依部分的追蹤
在x86-64的Linux核心中,發生分頁錯誤時的函式呼叫圖(Call Trace)如下所示。控制權將從與架構相依的低階處理常式,轉移到與架構無關的通用記憶體管理子系統。
asm_exc_page_fault(組合語言: arch/x86/entry/entry_64.S)- CPU偵測到例外,硬體將發生錯誤的虛擬位址寫入
CR2暫存器,並將暫存器狀態備份到中斷堆疊後,跳躍至核心的進入點。
- CPU偵測到例外,硬體將發生錯誤的虛擬位址寫入
exc_page_fault()(C語言: arch/x86/mm/fault.c)- 與架構相依的錯誤處理常式。會解析錯誤碼(Read/Write、User/Kernel、PF等),並進行中斷上下文的確認等工作。
do_page_fault()/do_user_addr_fault()- 判定發生錯誤的是核心空間(Bug或vmalloc區域等)還是使用者空間。若是使用者空間,會搜尋目標行程的記憶體映射(
vm_area_struct的紅黑樹、VMA串列),並確認該位址是否屬於合法的區域(確認是否為分段錯誤)。
- 判定發生錯誤的是核心空間(Bug或vmalloc區域等)還是使用者空間。若是使用者空間,會搜尋目標行程的記憶體映射(
handle_mm_fault()(C語言: mm/memory.c)- 從這裡開始是與架構無關的核心函式。會尋訪分頁表的各個階層(PGD -> P4D -> PUD -> PMD -> PTE),如果尚未配置表格,則一邊新配置中間目錄(如
pmd_alloc),一邊找出最終的PTE位址。
- 從這裡開始是與架構無關的核心函式。會尋訪分頁表的各個階層(PGD -> P4D -> PUD -> PMD -> PTE),如果尚未配置表格,則一邊新配置中間目錄(如
5.2 記憶體配置的真髓:來自handle_mm_fault的分歧
handle_mm_fault() 會根據找出的PTE狀態(PTE是否為空、是否已被置換出、是否為權限錯誤等),將實際的分頁配置處理進行分歧。
do_anonymous_page()(需求分頁的極致): 在PTE完全為空(零)的情況下被呼叫。這是對不與檔案綁定的匿名分頁(Anonymous Page)的首次存取,如堆積(malloc背後的brk或mmap)或堆疊的擴充等。核心在這裡才首次從夥伴系統(Buddy System)中取得實體記憶體(幀),並清零後映射到PTE中。藉此可以節省未使用的記憶體。do_fault()/__do_fault()(檔案支援分頁,File-backed Paging): 在首次存取被mmap的檔案等情況下被呼叫。會從分頁快取(Page Cache)讀取檔案資料,或是呼叫檔案系統(ext4或xfs)的驅動程式,從硬碟將資料載入並映射到分頁表。do_swap_page()(置換入的痛苦): 當PTE的Present位元為0,但其他旗標位元中記錄著置換區域的偏移量資訊時被呼叫。會將資料從硬碟(置換分割區或置換檔)重新載入實體記憶體中。因為伴隨著硬碟I/O,行程在這裡會進入長時間的Sleep(阻塞)狀態。do_wp_page()(Copy-on-Write): 這是稍後會說明的CoW處理。在Present=1,但試圖對沒有Write權限的分頁進行寫入時被呼叫。
5.3 寫入時複製(Copy-on-Write, CoW)的物理機制與參照計數的魔法
作為Linux行程生成樞紐的 fork() 系統呼叫,能藉由CoW(Copy-on-Write,寫入時複製)這種延遲評估(Lazy Evaluation)機制極為高速地運作。即使父行程使用了數GB的記憶體,fork() 也能在一瞬間完成,以下解說其背後的物理機制。
- 分頁表的共用:
當呼叫
fork()時,核心會將父行程的分頁表原封不動地複製給子行程。然而,實體記憶體本身卻完全不進行複製。父行程與子行程的PTE指向了完全相同的實體記憶體(幀)。 - Read-Only位元的強制設定(Write-Protect):
此時,核心會將所有被共用分頁的PTE之
R/W位元強制改寫為0(Read-Only)(就連原本可寫入的資料區段等也全都會被改寫)。 - 參照計數(Reference Count)的遞增:
將管理目標實體分頁的核心結構體(
struct page的_refcount)遞增,使其成為「被2個行程參照」的狀態。 - 寫入與分頁錯誤(觸發do_wp_page):
當父行程或子行程的任何一方,試圖對共用的變數或堆積區域進行寫入(Write)時,硬體MMU會偵測到
R/W=0,並立即引發分頁錯誤。 - 分頁的複製(Duplication):
會從分頁錯誤處理常式中呼叫
do_wp_page()。核心會確認VMA的旗標,並判斷「這不是不合法存取,而是正當的CoW所引發的錯誤」。接著從夥伴系統取得1個新的實體分頁,並將原本分頁的資料完整複製過去(copy_page)。 - PTE的更新與參照計數的遞減:
將進行了寫入的行程之PTE重新指向新的實體分頁,並將
R/W位元設為1(可Read/Write)。同時將原本實體分頁的參照計數遞減。如果參照計數變為1,表示另一個行程已獨佔該分頁,因此下次該行程發生錯誤時,便不需進行記憶體的複製,只需單純將R/W位元改回1即可(分頁重複使用)。
如上所述,CoW是MMU的硬體保護功能(Read-Only捕捉)與核心的軟體控制完美融合的一套充滿藝術性的演算法,實現了大幅節省記憶體與行程的高速啟動。
第6章:記憶體回收(Reclaim)演算法的深淵與OOM Killer的定罪
實體記憶體是有限的。當系統長時間運作,檔案快取或行程的堆積耗盡了記憶體時,OS為了取得新的記憶體,便必須釋放並回收(Reclaim)現有的記憶體區域。這個記憶體回收子系統是Linux核心中最複雜且難解的領域之一。
6.1 活躍/非活躍LRU串列與偽LRU演算法
Linux核心為管理並追蹤實體分頁,使用了LRU(Least Recently Used)串列。然而,由於鎖的競爭以及尋訪成本的問題,要用嚴格的LRU來管理所有分頁是不可能的。因此,採用了使用「Active串列」與「Inactive串列」這2個佇列(串列)的偽LRU演算法(Clock演算法的衍生)。
- Active串列: 最近頻繁被存取的「熱(Hot)」分頁之集合。這裡不會成為回收的目標。
- Inactive串列: 一段時間未被存取的「冷(Cold)」分頁之集合。位於尾端(Tail)的分頁會依序成為回收的候選對象。
核心是如何得知分頁是否被存取過呢?這時,在第2章解說過的PTE的 Accessed位元(A位元) 便會發揮作用。核心(kswapd)會定期尋訪分頁表,從PTE讀取A位元,在軟體端記錄下存取歷史後,再將A位元清除為0。如果A位元再次被硬體設為1,該分頁就會保留在Active串列,或從Inactive晉升上來。若沒有被設定,則會慢慢降級到Inactive串列的尾端。
6.2 kswapd守護行程與直接回收(Direct Reclaim)的恐懼
當記憶體的可用空間(Free Pages)低於特定閾值(Watermark:low)時,作為核心背景執行緒的 kswapd(每個NUMA節點都有一個)便會醒來。
kswapd 會從Inactive串列的尾端取出分頁。
- 如果是乾淨(Clean)的檔案快取(未被修改的檔案資料),則單純地將其捨棄(Drop)以清出記憶體。
- 如果是髒(Dirty)的(被修改過的)檔案快取,則將其寫回(Writeback)硬碟後再捨棄。
- 如果是匿名分頁(行程的堆積或堆疊),則會將其寫出至置換區域(置換出)。
這項背景作業會一直持續,直到可用空間達到
high閾值為止。
然而,如果應用程式配置記憶體的速度(記憶體壓力,Memory Pressure)極高,導致 kswapd 的回收速度趕不上,使可用記憶體跌破極限的閾值(min 閾值)時,便會發動直接回收(Direct Reclaim)。
直接回收是一種在要求記憶體的行程(應用程式自身)的上下文中,直接同步執行記憶體回收處理(捨棄快取或置換出)的機制。一旦進入直接回收,應用程式的執行(如 malloc 或分頁錯誤的完成)會完全停滯(Stall),這將成為導致數百毫秒至數秒嚴重效能下降(延遲突波,Latency Spike)的直接原因。在資料庫或即時系統中,為了避免這種情況,必須進行調校(如調整 vm.swappiness 或閾值)。
6.3 OOM Killer的分數計算公式與對行程的定罪
即使進行了直接回收,如果置換區域也已枯竭、快取也已砍光,仍然無論如何都無法取得記憶體的話,Linux核心會召喚 OOM (Out Of Memory) Killer 作為最後手段。
OOM Killer為防止整個系統因記憶體不足而陷入恐慌(核心崩潰或完全凍結),會將大量消耗記憶體的行程「強制終止(SIGKILL)」以奪回記憶體。存在著一套用來決定犧牲者的冷酷演算法。
決定要殺死哪個行程,是基於名為 oom_score 的評估值來進行的(由核心 mm/oom_kill.c 中的 oom_badness() 函式計算)。
OOM Score的基本計算邏輯(概念):
- 基本分數: 行程目前所使用的記憶體量(RSS: Resident Set Size + 分頁表量 + 置換使用量)佔總記憶體的比例。最高1000分。也就是說,消耗越多記憶體的行程(發生記憶體洩漏的行程等),就越容易被殺死。
- Root權限懲罰減免: 以root使用者權限執行的行程(如系統核心守護行程等),因有較高機率是維持系統不可或缺的,所以分數會稍微打折(扣分),變得較不容易被殺死。
- 使用者調整值 (OOM Score Adj): 會加上
/proc/[pid]/oom_score_adj(-1000 到 +1000)的值。系統管理員可以透過這個值來控制OOM Killer的行為。將這個值設定為 -1000 的行程(例: sshd、kubelet、資料庫的主行程等)會成為「不受OOM Killer影響(無敵)」的狀態。
當OOM Killer發動時,核心日誌(dmesg 或 /var/log/messages)會輸出如「Out of memory: Killed process 1234 (java)」之類的訊息,並伴隨著當時的行程清單、各項分數、記憶體狀態的詳細傾印(Dump)。系統管理員可以透過理解這份日誌與分數計算機制,來查明預料之外行程終止的原因,並設定適當的資源限制(如cgroups或ulimit)。
第7章:最新的超高速記憶體技法與硬體安全
7.1 2MB/1GB HugePages的威力與THP的功過
在第3章與第4章中所述,為解決TLB Miss與分頁表尋訪延遲的一項強大手段就是「HugePage」。 使用取代一般4KB分頁的2MB(在Page Directory階段直接指向實體位址,也就是跳過PT階層)或1GB(在PDPT階段直接指向)巨大分頁。
藉此,1個TLB項目便能涵蓋廣大的記憶體區域(4KB的512倍,或26萬倍),從而戲劇性地減少TLB Miss。在隨機存取大量記憶體的資料庫(Oracle、PostgreSQL)或虛擬化環境(KVM/QEMU)中,使用HugePage已成為效能調校的必備項目。
Linux的THP (Transparent Huge Pages,透明巨型分頁),是即使應用程式沒有意識到,核心背景執行緒(khugepaged)也會自動將連續的4KB分頁統合(重組)為2MB HugePage的機制。然而,在記憶體碎片化嚴重的環境下,這項統合處理(記憶體緊縮,Memory Compaction)本身就會大量消耗CPU,並引發延遲突波,因此在Redis等記憶體內(In-Memory)KVS中,通常建議停用THP(設為 never 或 madvise)。
7.2 核心分頁表隔離(KPTI)與Meltdown對策的代價
2018年被發現的CPU推測執行(Speculative Execution)漏洞「Meltdown (CVE-2017-5754)」,是一項能從使用者行程不合法地讀取核心記憶體空間(快取),動搖硬體根基的致命缺陷。
作為針對此漏洞的對策而導入作業系統端的機制,就是KPTI (Kernel Page-Table Isolation,核心分頁表隔離)(初期稱為KAISER)。
過去,為了減少上下文切換的負擔(Overhead),即使在執行使用者空間時,分頁表的上半部也會映射整個核心區域(前提是會透過PTE的U/S位元進行特權檢查,並拒絕存取)。但推測執行卻能鑽過這層特權檢查。
導入KPTI後,在使用者執行時,會使用不映射大部分核心區域的「最小限度影子分頁表(Shadow Page Table, User PGD)」。當透過系統呼叫或中斷轉移到核心空間時,必須強制切換 CR3 暫存器,重新載入完整的核心分頁表(Kernel PGD)。
這樣一來,雖然完全確保了安全性,但因為每次系統呼叫或中斷都會發生高成本的CR3切換(以及PCID/TLB清除的管理),在I/O密集型應用程式(頻繁使用Syscall的Web伺服器或DB)中,帶來了高達數%到十幾%不容忽視的效能負擔。
7.3 Direct I/O與零複製技術的進化
為了最佳化檔案I/O,OS將虛擬記憶體的機制應用到了極致。
使用 mmap() 系統呼叫,會將檔案內容直接映射到虛擬位址空間。存取時會發生分頁錯誤,隨後檔案資料會被讀入分頁快取,如此一來便能從使用者空間作為指標直接進行存取。
此外,在網路收發或儲存裝置I/O中,為了省去由CPU在核心空間(分頁快取)與使用者空間緩衝區之間進行資料複製(伴隨上下文切換的複製),廣泛活用了**零複製(Zero-Copy)**技術。在 sendfile() 系統呼叫或最新的 io_uring、AF_XDP 中,透過與網卡(NIC)或NVMe磁碟的DMA(Direct Memory Access)控制器連動,並操作分頁表的PTE,將核心的分頁直接「替換(Remap)」到使用者空間,使記憶體複製的負擔完全歸零。在這裡,巧妙地操作分頁表同樣作為最根本的機制在運作。
結語
虛擬記憶體與分頁機制,是OS核心與CPU(硬體)所合奏出的一首極為高深的交響曲。從分頁表1個位元的旗標設定、圍繞TLB擊落的自旋鎖苦惱、基於CoW參照計數的記憶體魔法,到OOM Killer冷酷的啟發式演算法(Heuristics),其深層蘊藏著「如何安全且高速地抽象化有限的實體資源,給予行程無限的幻覺」這種計算機科學的智慧。
理解底層的機制,不僅對於在C/C++或Rust等系統程式語言中進行最佳化(例如意識到快取列(Cache Line)的資料結構設計,或有效利用mmap)有所幫助,對於深入理解Go或Java等高階語言中的垃圾回收(GC)停頓時間(STW)以及記憶體分配器(如jemalloc或tcmalloc)的行為來說,也是不可或缺的。揭開系統「魔術」的面紗,直接感受硬體與核心的脈動,將為您鋪平道路,成為能設計出更為洗鍊且具擴展性軟體的優秀架構師。