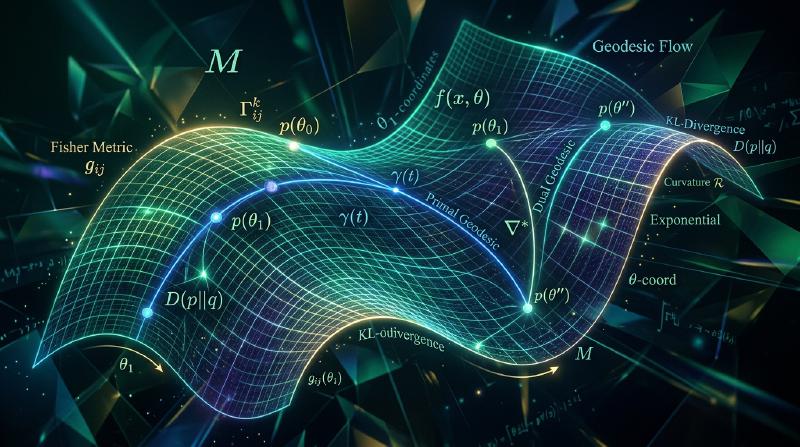
資訊幾何學(Information Geometry)是將微分幾何學的結構引入機率分佈所構成的空間中,在幾何學直觀的基礎上解開統計推論、機器學習以及資訊理論本質的日本發源世界級理論。由甘利俊一博士等人體系化的這個理論,現在已應用於支撐 AI 與深度學習根基的自然梯度法(Natural Gradient Descent)、量子資訊理論、統計物理學等廣泛領域,並逐漸確立其作為現代科學「共通語言」的地位。
本篇文章將盡可能詳細且有系統地解說資訊幾何學這個深淵的世界,並交織數學的嚴密性、幾何學的直觀以及具體的計算範例。不僅僅是公式的羅列,而是從「為什麼機率分佈的空間是彎曲的?」「為什麼費雪資訊矩陣會成為度量張量?」這類根本的疑問開始,一直到對偶聯絡、熵的幾何學,以及在最先進機器學習與神經科學上的應用,描繪出資訊幾何學的全貌。
第1章:資訊幾何學的黎明與甘利俊一的直觀
從歐幾里得空間的統計到機率分佈的彎曲空間
在古典統計學與資料分析中,我們常在無意識間將資料視為歐幾里得空間上的點來處理。例如,當考慮具有參數 $\theta = (\theta_1, \theta_2, \dots, \theta_n)$ 的統計模型時,經常將參數空間視為平坦的空間,並以一般的歐幾里得距離來測量參數間的距離。最小化平方誤差的最小平方法等,也是基於這種歐幾里得幾何學的直觀。
然而,將機率分佈參數化的空間,真的是「平坦」的嗎?
以常態分佈 $N(\mu, \sigma^2)$ 為例。參數空間是由平均值 $\mu$ 與變異數 $\sigma^2 > 0$ 所組成的上半平面 $\{(\mu, \sigma^2) \in \mathbb{R} \times \mathbb{R}_{>0}\}$。在此,我們考慮兩組常態分佈:
- $N(0, 1)$ 與 $N(0.1, 1)$
- $N(0, 100)$ 與 $N(0.1, 100)$
若以參數的歐幾里得距離來看,這兩組的距離都是 $0.1$,是相等的。但是,若從作為機率分佈的「可識別性」或「資訊的差異」之觀點來看又如何呢? 當變異數為 $1$ 較小時,平均值只要偏移 $0.1$,分佈的形狀就會產生顯著的變化,要從資料中區分兩者相對容易。另一方面,當變異數為 $100$ 極大時,分佈平坦地向外擴張,平均值即使偏移 $0.1$,分佈的重疊部分依然非常大,要從資料中區分兩者是一件極其困難的事。
也就是說,「作為分佈的本質差異」並不與參數的歐幾里得距離一致。在變異數較大的區域,平均值的微小變化幾乎不影響分佈的形狀;反之,在變異數較小的區域,則會帶來劇烈的變化。這強烈暗示了機率分佈的參數空間並非均勻,而是依據位置不同、「距離的尺度會有所不同的彎曲空間(黎曼流形)」。
為什麼機率分佈族是流形
資訊幾何學將統計模型(機率分佈的族群)公式化為可微流形(Differentiable Manifold)。
假設某個機率空間 $\mathcal{X}$ 上的機率分佈族為 $S$。當這個族能由 $n$ 個連續的實數參數 $\theta = (\theta^1, \dots, \theta^n)$ 唯一指定,且機率密度函數 $p(x; \theta)$ 對於 $\theta$ 是平滑的時候,我們稱 $S$ 為 $n$ 維的統計流形(Statistical Manifold)。
$$ S = \{ p(x; \theta) \mid \theta \in \Theta \subset \mathbb{R}^n \} $$在這裡,$\theta$ 無非是流形 $S$ 上的「局部座標系(Local Coordinate System)」。在流形的理論中,座標系並非本質上的東西,僅僅是其中一種表現方式。例如在常態分佈的情況下,參數可以選擇 $(\mu, \sigma^2)$,也可以選擇 $(\mu, \sigma)$ 或是 $(\frac{\mu}{\sigma^2}, -\frac{1}{2\sigma^2})$。
資訊幾何學的真髓,在於闡明「不依賴座標系選取方式,機率分佈族本身所具有的內在幾何學結構」。甘利俊一進一步深化了由 C.R. Rao 所提倡的「以費雪資訊矩陣為度量的黎曼流形」概念,藉由引入仿射聯絡(Affine Connection)的概念,在機率分佈的空間中,不僅找出了「彎曲程度(曲率)」,還發掘了「直線的概念(測地線)」與「對偶性」等豐富的結構。
第2章:作為黎曼流形的統計模型
為了在流形中定義「距離」與「角度」,我們需要黎曼度量(Riemannian Metric)。在統計流形中,自然的黎曼度量究竟是什麼呢?
分數函數與費雪資訊矩陣
在統計學中,對數概似函數 $\log p(x; \theta)$ 對參數的偏微分被稱為「分數函數(Score Function)」,扮演著重要的角色。
$$ \partial_i \ell(x; \theta) = \frac{\partial}{\partial \theta^i} \log p(x; \theta) $$$$ E_\theta[\partial_i \ell(x; \theta)] = \int \frac{\partial p(x; \theta)}{\partial \theta^i} dx = \frac{\partial}{\partial \theta^i} \int p(x; \theta) dx = 0 $$$$ g_{ij}(\theta) = E_\theta \left[ \partial_i \ell(x; \theta) \partial_j \ell(x; \theta) \right] $$C.R. Rao (1945) 注意到這個費雪資訊矩陣是滿足張量轉換規則的正定對稱矩陣,並提議將其採用為統計流形的黎曼度量(費雪度量)。
$$ ds^2 = \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$藉此,統計模型便成為了黎曼流形 $(S, G)$。兩個相鄰的機率分佈 $p(x; \theta)$ 與 $p(x; \theta + d\theta)$ 之間微小的「距離平方」,即可藉由這個費雪度量來測量。
作為不變度量的千佐夫定理
為什麼應該選擇費雪資訊矩陣作為度量呢?這並非單純的突發奇想,而是有著深刻的數學必然性。
N.N. Chentsov (1972) 將在統計推論框架中所要求的「不變性(Invariance)」進行了公式化。統計推論不應因為資料的表現方式或向充分統計量的轉換(馬可夫映射)而改變結果。 千佐夫定理(Chentsov’s Theorem)展示了一個驚人的事實:「在由有限集合上的機率分佈所構成的流形中,於馬可夫映射下滿足單調性(收縮性)的黎曼度量,除常數倍外,僅限於費雪資訊度量」。
也就是說,在機率分佈的空間中,滿足「資訊不減少」此一自然統計要求的距離測量方式,只有費雪度量。這證明了費雪度量是統計學特有、內在且必然的幾何學結構。
常態分佈族中費雪度量的具體計算範例
$$ p(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) $$$$ \log p = -\log(\sqrt{2\pi}) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2} $$$$ \partial_\mu \log p = \frac{x-\mu}{\sigma^2}, \quad \partial_\sigma \log p = -\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3} $$$$ g_{\mu\mu} = E\left[ \left(\frac{x-\mu}{\sigma^2}\right)^2 \right] = \frac{1}{\sigma^2} $$$$ g_{\sigma\sigma} = E\left[ \left(-\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3}\right)^2 \right] = \frac{2}{\sigma^2} $$$$ g_{\mu\sigma} = g_{\sigma\mu} = 0 $$$$ ds^2 = \frac{1}{\sigma^2} d\mu^2 + \frac{2}{\sigma^2} d\sigma^2 $$這與亨利·龐加萊所提倡的雙曲幾何學(非歐幾里得幾何學的一種)之模型,即龐加萊上半平面的度量(除常數倍差異外)完全一致。也就是說,常態分佈的空間是具有負常曲率的雙曲空間。 如同先前的直觀,在 $\sigma$ 較大(變異數較大)的區域中,度量張量 $1/\sigma^2$ 變小,這也從數學公式中印證了參數的變動會被評估為較小的「距離」。
第3章:對偶聯絡與 $\alpha$-聯絡的深淵
僅靠黎曼度量無法完全描述空間的「彎曲程度」。我們需要仿射聯絡(Affine Connection)來決定「哪個方向是筆直的」。甘利俊一最大的功績在於,他發現在統計流形中存在著無限多個自然的聯絡,而這些聯絡構成了一種名為「對偶性(Duality)」的優美結構。
$\alpha$-聯絡的定義
甘利利用實數參數 $\alpha$,引入了被稱為 $\alpha$-聯絡的仿射聯絡族。其聯絡係數 $\Gamma_{ij,k}^{(\alpha)}$ 定義如下:
$$ \Gamma_{ij,k}^{(\alpha)} = E \left[ \left( \partial_i \partial_j \ell + \frac{1 - \alpha}{2} \partial_i \ell \partial_j \ell \right) \partial_k \ell \right] $$當 $\alpha = 0$ 時的 $0$-聯絡,與由費雪度量唯一決定的列維-奇維塔聯絡(Levi-Civita Connection)一致。這是在一般黎曼幾何學中所使用的聯絡。然而,在資訊幾何學中扮演最重要角色的是 $\alpha = 1$ 與 $\alpha = -1$ 的聯絡。
e-聯絡與 m-聯絡,以及對偶平坦空間
- e-聯絡($\alpha = 1$ 指數聯絡):在處理指數型分佈族(Exponential Family)時自然出現的聯絡。
- m-聯絡($\alpha = -1$ 混合聯絡):在處理混合型分佈族(Mixture Family)時自然出現的聯絡。
這兩個聯絡關於費雪度量 $g_{ij}$ 具有「對偶(Dual)」的關係。在黎曼流形中,當兩個向量場的內積(度量)的微分可以表示為它們各自在聯絡下的共變微分之和時,它們被稱為對偶聯絡。
$$ X \langle Y, Z \rangle = \langle \nabla_X^{(e)} Y, Z \rangle + \langle Y, \nabla_X^{(m)} Z \rangle $$值得特別一提的事實是,指數型分佈族(例如常態分佈、卜瓦松分佈、伽瑪分佈等)的空間,關於 e-聯絡是「平坦的(曲率張量為零)」,同時關於 m-聯絡也是「平坦的」。這樣的空間被稱為對偶平坦空間(Dually Flat Space)。
在對偶平坦空間中,存在著關於 e-聯絡為筆直的線(e-測地線),以及關於 m-聯絡為筆直的線(m-測地線)。此外,在這些空間中,作為參數系,存在著藉由勒讓德轉換(Legendre Transformation)互相連結的對偶座標系(自然參數 $\theta$ 與期望值參數 $\eta$)。
廣義畢氏定理
對偶平坦空間的優美之處,可以濃縮為「廣義畢氏定理(Generalized Pythagorean Theorem)」。
在歐幾里得空間中,當 3 點 $P, Q, R$ 構成 $\angle PQR = 90^\circ$ 的直角三角形時,$d(P, R)^2 = d(P, Q)^2 + d(Q, R)^2$ 成立。 在資訊幾何學的對偶平坦空間中,連結點 $P, Q, R$(機率分佈)的曲線由 e-測地線與 m-測地線構成,當它們在點 $Q$ 於費雪度量意義上「正交」時,關於分佈間散度(非對稱距離的概念)的下列等式會嚴格成立:
$$ D(P \parallel R) = D(P \parallel Q) + D(Q \parallel R) $$這個定理在幾何學上完全解釋了統計學中的資訊量準則、機器學習中 EM 演算法的收斂性,以及投影定理(Information Projection),可說是資訊幾何學的巔峰之作。
第4章:散度與熵的幾何學
黎曼幾何學中的距離是對稱的($d(x, y) = d(y, x)$),但在資訊理論中,機率分佈之間「差異」的尺度通常是非對稱的。資訊幾何學將這個非對稱的距離「散度(Divergence)」與對偶平坦空間的幾何學結構完美地結合在一起。
Kullback-Leibler 資訊量(KL 散度)
$$ D_{KL}(P \parallel Q) = \int p(x) \log \frac{p(x)}{q(x)} dx $$KL 散度並不滿足距離的公理(非對稱,且不滿足三角不等式)。然而,在點 $Q$ 無限逼近點 $P$ 的極限下,KL 散度泰勒展開的二次項,會精確地與費雪資訊矩陣一致。
$$ D_{KL}(\theta \parallel \theta + d\theta) \approx \frac{1}{2} \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$換句話說,KL 散度是巨觀的非對稱距離,而其微觀極限(無窮小距離)則誘導出了費雪度量(黎曼幾何學)。
布雷格曼散度與勒讓德轉換
在對偶平坦空間中,散度被公式化為更一般性的「布雷格曼散度(Bregman Divergence)」。 考慮凸函數 $\psi(\theta)$(對應於累積生成函數或自由能)。布雷格曼散度 $D_\psi(\theta_P \parallel \theta_Q)$ 定義為點 $\theta_Q$ 上凸函數的切平面,與點 $\theta_P$ 上凸函數值之間的「誤差」。
$$ D_\psi(\theta_P \parallel \theta_Q) = \psi(\theta_P) - \psi(\theta_Q) - \sum_i (\theta_P^i - \theta_Q^i) \frac{\partial \psi(\theta_Q)}{\partial \theta^i} $$$$ \eta_i = \frac{\partial \psi(\theta)}{\partial \theta^i}, \quad \phi(\eta) = \sum_i \theta^i \eta_i - \psi(\theta) $$在資訊幾何學中,KL 散度本身就是在指數型分佈族上的布雷格曼散度。藉由使用對偶參數 $\theta$(自然參數)與 $\eta$(期望值參數),散度可以使用對偶函數 $\psi, \phi$ 寫成極為對稱且優美的典範形式(Canonical form)。
$$ D(P \parallel Q) = \psi(\theta_P) + \phi(\eta_Q) - \sum_i \theta_P^i \eta_Q^i $$這個數學公式如實地訴說著,資訊幾何學並非單純是微分幾何學的應用,而是與勒讓德轉換及凸分析深度結合的「資訊理論固有的幾何學」。
第5章:深度學習與自然梯度下降法
資訊幾何學不僅停留在理論的優美上,在現代的 AI,特別是深度學習中也發揮了極其實用的威力。其中最顯著的例子就是「自然梯度下降法(Natural Gradient Descent; NGD)」。
一般梯度下降法的極限
$$ w_{t+1} = w_t - \eta \nabla L(w_t) $$然而,一般的梯度 $\nabla L$ 是建立在參數空間為「平坦的歐幾里得空間」之前提下。如同第 1 章所述,類神經網路所表示的機率模型參數空間,是藉由費雪度量彎曲的黎曼流形。 歐幾里得空間的梯度(最陡下降方向),在黎曼流形上並不等同於真正的最陡下降方向。因此,學習的軌跡會因參數的尺度或座標轉換而產生巨大變化,導致最佳化效率顯著降低的「平原(學習停滯)」現象頻繁發生。
基於費雪度量的參數更新:自然梯度法
1998 年,甘利俊一提倡了在黎曼流形上真正的最陡下降方向,也就是「自然梯度(Natural Gradient)」。流形上的梯度 $\tilde{\nabla} L$ 等於一般的梯度 $\nabla L$ 乘上費雪資訊矩陣的反矩陣 $F^{-1}$。
$$ \tilde{\nabla} L(w) = F(w)^{-1} \nabla L(w) $$$$ w_{t+1} = w_t - \eta F(w_t)^{-1} \nabla L(w_t) $$自然梯度法藉由考量參數空間的曲率(費雪資訊矩陣),實現了不依賴參數選取方式(座標系)的不變學習。這使得即使損失函數的等高線是扭曲谷底般的地形,也能直線朝向最佳解邁進,讓學習速度飛躍性地提升。這與牛頓法這類二次最佳化手法相似,但由於使用了保證半正定性的費雪資訊矩陣來取代海森矩陣,可說是針對機率模型最佳化的手法。
藉由 K-FAC 的近似計算實作與突破
雖然自然梯度法在理論上很強大,但要應用於深度學習卻有一堵巨大的高牆。在擁有數千萬至數百億參數的現代類神經網路中,要計算巨大的費雪資訊矩陣 $F$(大小為 $N \times N$)並求出其反矩陣,從計算量的觀點來看是令人絕望的($O(N^3)$)。
解決這個問題的,是 James Martens 與 Roger Grosse 等人於 2015 年提出的 K-FAC (Kronecker-factored Approximate Curvature) 手法。 他們展示了類神經網路層間參數的費雪資訊矩陣,可以藉由輸入的共變異數矩陣與輸出梯度的共變異數矩陣的「克羅內克積(Kronecker Product)」來進行高精度的近似。
$$ F_{layer} \approx A \otimes S $$(這裡 $A$ 是激勵值的共變異數,$S$ 是預激勵梯度的共變異數)
利用克羅內克積的性質 $(A \otimes S)^{-1} = A^{-1} \otimes S^{-1}$,可以將巨大矩陣的反矩陣計算,分解為遠小於原矩陣的反矩陣計算,成功地將計算成本戲劇性地削減(從 $O(N^3)$ 降至 $O(n^3)$,$n$ 為層的寬度)。藉由 K-FAC 的實作,自然梯度法變得能在現實的計算時間內應用於大規模深度學習模型(如 ResNet 或 Transformer 等),並在分散式學習環境中被證實能展現極快的收斂速度。這是資訊幾何學突破 AI 極限的歷史性瞬間。
第6章:向統計物理學、量子資訊、神經科學的擴展
資訊幾何學的通用性不只侷限於統計學或機器學習。其根底的「機率與資訊的幾何學」,已波及眾多科學領域。
量子資訊幾何學
處理古典機率分佈的資訊幾何學,自然而然地擴展到了處理量子力學中「密度矩陣(Density Matrix)」的量子資訊幾何學(Quantum Information Geometry)。 在量子系統中,由於可觀測量的不可交換性(運算子會因順序而改變結果),相當於費雪度量的量無法唯一確定。取而代之的是,存在著多個黎曼度量,例如 Bures 度量(SLD 費雪資訊量)與 Kubo-Mori-Bogoliubov 度量,各自具有不同的物理與資訊理論意義。量子資訊幾何學作為量子電腦與量子通訊的理論基礎,正快速地發展,應用於量子狀態估計精度的極限(量子克拉梅爾-拉奧不等式)、量子纏結(Entanglement)的幾何學闡明、量子演算法的最佳化等。
自由能原理與神經科學(預測編碼)
在腦神經科學領域,由 Karl Friston 所提倡的自由能原理(Free Energy Principle; FEP),假設大腦是一個為了最小化「驚訝(Surprise)」而推論知覺與行動的系統。 這個推論過程被公式化為變分貝式推論(Variational Bayesian Inference),歸結為最小化大腦內內部模型的機率分佈與外部環境真實分佈之間 KL 散度(變分自由能)的最佳化問題。
從資訊幾何學的觀點來看,大腦可以被解釋為一個在機率分佈流形上,沿著散度梯度(即自然梯度)移動的動力系統。知覺(內部狀態的更新)與行動(對外部環境的作用),被優美地描述為對偶平坦空間中 e-投影與 m-投影的反覆演算法。資訊幾何學為解開智慧的根本機制提供了數學語言。
作為現代數學的尖端
從純數學的觀點來看,資訊幾何學也提出了新的典範。它與仿射微分幾何學、海森幾何學、辛幾何學之間的深層關聯正逐漸被闡明。特別是 Wasserstein 幾何學(最佳傳輸理論)與資訊幾何學的整合,是目前數學與機器學習中最熱門的研究主題之一。KL 散度(資訊幾何)測量的是「資訊」的移動,而 Wasserstein 距離測量的是「質量」的移動。融合這兩種幾何學的嘗試,正直接連結到深度生成模型(擴散模型與 GAN)的理論闡明。
結語:資訊交織出的宇宙形狀
甘利俊一從「統計模型是否是彎曲的」這個直觀中所孕育出的資訊幾何學,如今已超越了統計學的框架,成長為連結機器學習、量子物理學、神經科學的宏大理論體系。 藉由將機率分佈不單純視為函數,而是作為幾何學的「空間」來掌握,我們得以視覺化地理解資訊的流動、學習的軌跡以及智慧的本質。
費雪資訊度量所教導的「資訊的彎曲程度」。 對偶聯絡所推導出的「廣義畢氏定理」。 以及,自然梯度法所開拓的「AI 的高速進化」。
資訊幾何學將會持續作為我們從名為資料的繁星中,找出名為真理的星座的最洗鍊「羅盤」。這場美麗而深淵的黎曼流形探索,才剛剛開始。