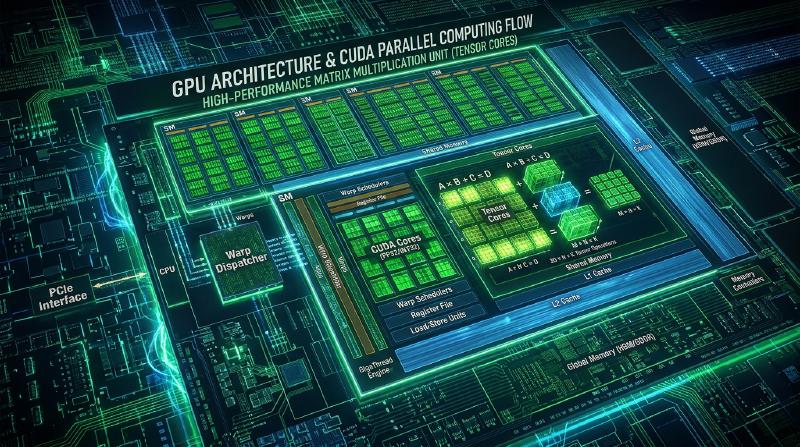
GPU超平行架構與CUDA物理學:SIMT、Warp、Tensor Core的運算原理
支撐現代高階計算科學、人工智慧、深度學習(Deep Learning)以及高解析度電腦圖學的根基技術,這就是GPU(Graphics Processing Unit,圖形處理器)。本文將深入探討GPU的架構,以及在之上運作的平行運算基礎設施CUDA(Compute Unified Device Architecture)的物理與硬體層面。我們不單純討論程式設計的語法,而是從串流多處理器(SM)、SIMT執行模型、Warp排程、Tensor Core以及記憶體階層等角度,徹底解剖硬體「為什麼會被設計成這樣」以及「如何榨出極致的運算吞吐量」。
第1章:CPU與GPU設計理念的分歧點
1.1 追求低延遲 vs 追求高吞吐量
通用處理器CPU(Central Processing Unit)與專注於平行運算的GPU,從其誕生背景來看,設計理念就存在根本的差異。CPU的進化是以「如何讓單一任務(執行緒)更快完成」這種「低延遲(延遲最小化)」為最高指導原則。相對地,GPU則追求「將大量任務捆綁起來,整體在單位時間內能完成多少處理量」的「高吞吐量(處理量最大化)」。
CPU必須迅速處理作業系統的控制、帶有複雜分支條件的應用程式執行、來自使用者的隨機中斷處理等不可預測的操作。為此,它搭載了高階的分支預測電路、亂序執行(Out-of-Order Execution,改變指令順序執行的機制)以及巨大的L1/L2/L3快取記憶體,在隱藏記憶體存取延遲的同時,將單一執行緒的效能提升至極限。
相較之下,GPU最初是為了處理在螢幕上的數百萬個像素套用相同著色運算這類高度可平行化的任務而生。與其將晶粒面積分配給複雜的控制電路或巨大的快取,它選擇了將單純的算術邏輯單元(ALU: Arithmetic Logic Unit)鋪滿至極限。
1.2 晶粒面積中快取、控制電路、ALU的分配比例
如何分配矽晶粒(半導體晶片)有限的面積(電晶體預算),決定了兩者架構差異的關鍵。
- CPU的晶粒面積分配:晶粒的一半以上被大容量快取記憶體(SRAM)與高階控制電路(分支預測、指令擷取、解碼、排程等)所佔據。實際執行運算的ALU所佔比例相對較小。
- GPU的晶粒面積分配:快取記憶體與控制電路被壓低至必要最小限度,晶粒的大部分被數千至數萬個ALU(CUDA核心)所佔據。
GPU並非依靠快取來隱藏記憶體存取的延遲,而是透過「上下文切換(Context Switching)」來隱藏。當某一群執行緒正在等待來自記憶體的資料抵達時,它會立即執行另一群執行緒的運算,使運算器始終保持在運作狀態(高佔用率:Occupancy)。這就是GPU追求「高吞吐量」的實體實現。由於硬體層級的多執行緒技術(Hardware Multithreading)執行得極為輕量,其前提是存在著數千至數萬個並行執行的執行緒。
第2章:SIMT執行模型的本質
2.1 SIMD與SIMT的差異
在平行處理的分類中,雖然有Flynn氏分類法(Flynn’s taxonomy),但GPU的執行模型經常被拿來與SIMD(Single Instruction, Multiple Data)比較。CPU的向量擴充指令(如AVX等)是純粹的SIMD,以1個指令同時處理多筆資料(例如存放在256位元寬暫存器中的8個32位元浮點數)。在SIMD中,要讓資料的每個元素執行不同的分支(if-else)是非常困難的。
另一方面,NVIDIA提倡的CUDA執行模型被稱為SIMT(Single Instruction, Multiple Threads)。在SIMT中,多個獨立的「執行緒」組成群組(後述的「Warp」),共用並執行相同的指令。但是,與SIMD不同的是,SIMT的各個執行緒擁有獨立的暫存器狀態與指令位址計數器(在程式設計模型上)。因此,程式設計師在撰寫程式碼時,可以彷彿各個執行緒都在獨立運作一般。
2.2 以32個執行緒為單位的「Warp」
GPU硬體並不會個別排程執行緒,而是以**將32個執行緒組合而成的「Warp」**為單位進行管理與執行。(在AMD的GPU中被稱為Wavefront,有時採用64個執行緒為單位)。
串流多處理器(SM)內的指令擷取與解碼單元,會以Warp為單位擷取1個指令,並將相同指令派發(Dispatch)給Warp內的32個執行緒。也就是說,Warp內的32個執行緒,在實體上是完全同時地,針對各自擁有的不同資料執行相同指令。這就是SIMT的核心。
2.3 Warp Divergence(分支發散)的實體懲罰
雖然各執行緒表現得彷彿擁有獨立的程式計數器,但在實體上,Warp內的全部執行緒必須執行相同的指令。那麼,如果程式碼中存在如 if-else 的條件分支,且Warp內的執行緒之間對分支條件的真偽產生了分歧,會發生什麼事呢?
這個現象被稱為Warp Divergence(分支發散)。
當發生Warp Divergence時,硬體會透過以下步驟進行處理:
- 首先,僅對
if條件為真的執行緒(活動執行緒)執行指令。此時,條件為假的執行緒會被「遮罩(無效化)」,運算結果不會被寫入。 - 接著,轉移至
else條件(或條件為假時的路徑),這次會將剛才被遮罩的執行緒設為活動,並遮罩剛才為真的執行緒來執行指令。
也就是說,當存在多個分支路徑時,硬體不得不以序列(串列)而非平行的方式來執行這些路徑。作為一個極端的例子,如果Warp內的32個執行緒遵循了32種不同的分支路徑,執行時間將會暴增為32倍。Warp Divergence是讓GPU運算吞吐量銳減的最大因素之一,也是在演算法設計中最應避免的反面模式(Anti-pattern)。從實體上來看,這意味著ALU即使消耗了電力,卻因為被遮罩而沒有產生有效的運算結果,發生了「無效週期」。
第3章:串流多處理器(SM)的硬體解剖
GPU是由多個**串流多處理器(SM: Streaming Multiprocessor)**的集合體所構成。SM正是GPU真正的運算引擎。在最新的架構(例:Hopper H100)中,單一GPU晶粒上搭載了超過100個SM。
3.1 SM內部的管線結構
SM內部進一步被分割為多個子分割區(通常是4個),每個分割區都有獨立的Warp排程器與派發單元。
- Warp排程器(Warp Scheduler):選擇處於可執行狀態(暫存器與記憶體已準備就緒的狀態)的Warp。GPU的排程器能以零負荷(Zero-overhead)切換Warp,這是隱藏記憶體存取延遲的關鍵。
- 派發單元(Dispatch Unit):向已排程的Warp發出指令。
- CUDA核心(INT32 / FP32 / FP64 ALU):進行實際整數運算與浮點數運算的單元。
- 載入/儲存單元(LD/ST Unit):負責記憶體的讀寫。
- 特殊功能單元(SFU):高速計算sin、cos、exp、倒數等超越函數的專用硬體。
指令管線被設計得非常深,擁有擷取、解碼、排程、暫存器讀取、執行(多個週期)以及寫回等各個階段。FP32的FMA(Fused Multiply-Add)運算的延遲通常需要數個至十幾個週期,但透過每個週期從不同的Warp發出指令,能讓管線始終保持全滿。
3.2 巨大的暫存器檔案與暫存器壓力
SM中搭載了CPU無法比擬的巨大暫存器檔案(例如:每個SM為64KB至256KB的SRAM)。這是為了保持在SM上同時執行的數千個執行緒的所有上下文。
上下文切換能以零週期完成,是因為不需要將執行緒的暫存器狀態退避(Spill)到記憶體中。然而,如果每個執行緒使用的暫存器數量增加,SM內能同時啟動的Warp數量(佔用率)就會下降。這被稱為暫存器壓力(Register Pressure)。當暫存器枯竭時,資料會被退避(Spill)到低速的區域記憶體(實體上是全域記憶體的一部分),導致效能呈現毀滅性的下降。
3.3 共用記憶體(Shared Memory)與Bank衝突
SM中存在著程式設計師可明確控制的超高速晶片上記憶體,即共用記憶體(Shared Memory)。它與L1快取共用相同的實體SRAM區域,但作為明確的資料快取發揮作用,並用於區塊內執行緒間的資料共用與同步。
共用記憶體的實體結構被分割成多個稱為**記憶體Bank(Memory Banks)**的獨立模組(通常為32個)。連續的32位元位址會被交錯(Interleave)分配到不同的Bank。
當Warp內的32個執行緒同時存取不同的Bank時,存取會被完全平行地(在1個週期內)處理。這被稱為無Bank衝突(Bank Conflict-Free)。 然而,如果多個執行緒同時試圖存取相同Bank的不同位址時,請求就會被序列化,產生懲罰(延遲)。這被稱為Bank衝突(Bank Conflict)。例如,2路的Bank衝突會使存取時間變為2倍,最糟情況下32路的衝突會延遲32倍。在矩陣轉置等演算法中,由於步幅存取(Stride Access)會發生嚴重的Bank衝突,因此必須使用填補(Padding,插入虛擬資料以偏移記憶體位址的技巧)來迴避衝突的高階最佳化是不可或缺的。
第4章:Tensor Core的乘加運算管線
在Volta架構中首次導入,並讓後續GPU效能發生飛躍性提升的革命性硬體,這就是Tensor Core(張量核心)。AI與深度學習爆發性的發展,若沒有Tensor Core是無法談起的。
4.1 矩陣乘加運算(MMA)的硬體實作
深度學習運算的大部分是神經網路權重矩陣與輸入資料的矩陣相乘(GEMM: General Matrix Multiply)。作為計算式可表示為 $D = A \times B + C$ ($A, B$ 為輸入矩陣,$C$ 為累加器矩陣)。
在傳統的CUDA核心中,這項矩陣乘法是使用FMA(Fused Multiply-Add)指令逐個元素進行計算的。相對地,Tensor Core是在硬體層級上以1個週期(或數個週期)一次完成小型矩陣(例如:4x4或16x16)的乘加運算的專用電路。
實體上,它將數十個至數百個乘法器與巨大的加法樹以線路直接連接,不需要將中間結果寫回暫存器就能一口氣完成乘加運算。這使得其與一般的CUDA核心相比,每單位面積的運算吞吐量(TFLOPS)有著數量級的高低之分。
4.2 Mixed-Precision(混合精度)的極意
Tensor Core的另一個精髓是支援**Mixed-Precision(混合精度)**運算。 在深度學習中,有許多場合在計算過程中並不需要高精度(FP32/FP64)。Tensor Core擁有一個管線:以低精度(FP16、BF16,甚至更低的FP8、INT8、INT4)讀取輸入矩陣 $A$ 與 $B$,在內部以低精度進行乘法後,再以較高的精度(FP32或INT32)進行加法(累加,Accumulate)處理。
- FP16 / BF16:訓練的標準。BF16(Bfloat16)的指數部分與FP32一樣有8位元,因為動態範圍廣而容易防止梯度消失。
- FP8 / INT8 / INT4:加速推論(Inference)的王牌。由於資料傳輸量(記憶體頻寬)也被削減,因此吞吐量會戲劇性地提升。
在Hopper架構中,導入了能戲劇性加速Transformer模型計算的「FP8 Tensor Core」,相較於FP32,在理論上實現了數十倍的吞吐量。從軟體端(CUDA),可透過 wmma(Warp-Level Matrix Multiply and Accumulate)API或 mma.sync PTX指令直接驅動Tensor Core,讓Warp內的執行緒協作,進行將矩陣片段載入暫存器、運算、儲存等極度複雜的集合處理(Collective Operation)。
第5章:CUDA記憶體階層與最佳化技巧
GPU的計算能力無論多高,一旦資料供應成為瓶頸,就無法發揮效能(記憶體牆問題)。可以說,CUDA程式設計中的最佳化有九成是「記憶體存取最佳化」。
5.1 全域記憶體的合併存取(Coalescing)
GPU的主記憶體(HBM或GDDR),也就是全域記憶體,擁有非常寬廣的頻寬(例如數TB/s),但延遲也高達數百週期,非常巨大。
最大化全域記憶體存取效率的絕對原則就是合併存取(Coalescing)。 GPU的記憶體控制器會以32位元組、64位元組或128位元組為單位的交易(Transaction)對記憶體進行存取。當Warp內的32個執行緒存取記憶體時,如果這些記憶體位址落在連續的區域內(對齊的128位元組邊界內),硬體會將這些請求合併(Coalesce)成1次的記憶體交易來處理。
反之,如果執行緒存取隨機的位址,或是進行步幅(有間隔)的存取,就不會進行合併,而會產生多次交易。這被稱為「非合併存取(Uncoalesced Access)」,會導致有效記憶體頻寬降至十分之一以下,是致命的效能Bug。
5.2 CUDA C++程式碼範例:矩陣轉置的最佳化與共用記憶體
以下是迴避非合併存取,並活用共用記憶體來戲劇性改善效能的矩陣轉置(Matrix Transpose)最佳化核心(Kernel)程式碼範例。
| |
這段程式碼的重點有3個:
- 讀取時的合併存取:從
idata的讀取是朝著threadIdx.x連續的X方向進行,因此能完美合併。 - 寫入時的合併存取:向
odata的寫入,也透過交換區塊的座標,設計為朝threadIdx.x方向連續,從而實現合併。 - 共用記憶體上的填補:藉由偏移1個元素的
tile[TILE_DIM][TILE_DIM + 1](填補),完全排除了寫入時在列方向(tile[threadIdx.x][threadIdx.y + j])存取時的Bank衝突。
5.3 快取階層與特殊記憶體
- L1/L2快取策略:在近期的GPU架構中,程式設計師可以使用PTX指令(
.ca,.cg,.cs等)作為提示來控制快取的行為。例如,對於只會存取一次的資料,可以繞過L2快取(串流存取),以防止快取污染。 - 紋理記憶體(Texture Memory) / 常數記憶體(Constant Memory):專門用於影像處理的紋理記憶體,會針對具有2D空間局部性的存取活用專用快取。常數記憶體則對於所有執行緒讀取相同常數的廣播存取,能展現極高的效率。
第6章:深度學習時代的GPU未來
不僅是單一GPU的效能提升,系統整體的擴展性(Scaling)也是當前計算科學的尖端領域。
6.1 透過NVLink與NVSwitch的超高速互相連接
巨大的LLM(大型語言模型)無法收納於單一GPU的記憶體(例如80GB或144GB)中。為了進行模型平行化(張量平行或管線平行),GPU之間必須每秒交換兆位元組級(Terabyte)的資料。 傳統的PCIe(PCI Express)匯流排無法提供這等頻寬,因此NVIDIA開發了稱為NVLink的獨有高速內部連接技術。進一步地,透過稱為NVSwitch的交換器晶片,能將8基或256基GPU以完全無阻塞(Non-blocking)的交叉開關(Crossbar Switch)連接,構築出彷彿是1台巨大GPU般運作的叢集。
6.2 Transformer Engine與FP8生態系
為了對自然語言處理,甚至影像與語音辨識上都成為實質標準的Transformer架構進行最佳化,Hopper架構中搭載了稱為Transformer Engine的專用硬體與軟體協作機制。 這是一套動態監視張量的統計資訊,逐層自動切換FP8與FP16運算精度(動態縮放,Dynamic Scaling)的機制,能在防止精度劣化的同時,實現極致的運算速度與記憶體頻寬的節約。
6.3 GPU叢集的縮放定律與未來展望
正如OpenAI的「Scaling Laws(縮放定律)」所示,隨著模型參數數量與計算量的增加,AI的效能持續在提升。隨之而來,GPU已經從單純的處理器,進化成了透過光纖連接數萬基,「資料中心本身就是一台巨大的GPU(超級電腦)」。
未來的架構進化,將朝著導入矽光子技術(光互連)、CPO(Co-Packaged Optics),以及從SRAM到HBM的3D堆疊技術的進一步高階化前進。然而,「透過平行處理將吞吐量極大化」這項從GPU誕生時就未曾改變的DNA,今後也將繼續開拓計算科學的最前線。
【追加論考】GPU中的排程與佔用率之數學分析
title: “圖形運算處理器的超平行架構與CUDA物理學:SIMT、Warp、Tensor Core的運算原理” description: “將高吞吐量追求至極限的圖形運算處理器內部設計。SM、Warp排程、Tensor Core與共用記憶體最佳化的精髓。” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
圖形運算處理器的超平行架構與CUDA物理學:SIMT、Warp、Tensor Core的運算原理
支撐現代高階計算科學、人工智慧、深度學習(Deep Learning)以及高解析度電腦圖學的根基技術,這就是圖形運算處理器(Graphics Processing Unit)。本文將深入探討圖形運算處理器的架構,以及在之上運作的平行運算基礎設施CUDA(Compute Unified Device Architecture)的物理與硬體層面。我們不單純討論程式設計的語法,而是從串流多處理器(SM)、SIMT執行模型、Warp排程、Tensor Core以及記憶體階層等角度,徹底解剖硬體「為什麼會被設計成這樣」以及「如何榨出極致的運算吞吐量」。
追補第1章的補充:通用運算處理器與圖形運算處理器設計理念的分歧點
1.1 追求低延遲 vs 追求高吞吐量
通用處理器,即通用運算處理器(Central Processing Unit),與專注於平行運算的圖形運算處理器,從其誕生背景來看,設計理念就存在根本的差異。通用運算處理器的進化是以「如何讓單一任務(執行緒)更快完成」這種「低延遲(延遲最小化)」為最高指導原則。相對地,圖形運算處理器則追求「將大量任務捆綁起來,整體在單位時間內能完成多少處理量」的「高吞吐量(處理量最大化)」。
通用運算處理器必須迅速處理作業系統的控制、帶有複雜分支條件的應用程式執行、來自使用者的隨機中斷處理等不可預測的操作。為此,它搭載了高階的分支預測電路、亂序執行(Out-of-Order Execution,改變指令順序執行的機制)以及巨大的L1/L2/L3快取記憶體,在隱藏記憶體存取延遲的同時,將單一執行緒的效能提升至極限。
相較之下,圖形運算處理器最初是為了處理在螢幕上的數百萬個像素套用相同著色運算這類高度可平行化的任務而生。與其將晶粒面積分配給複雜的控制電路或巨大的快取,它選擇了將單純的算術邏輯單元(ALU: Arithmetic Logic Unit)鋪滿至極限。
1.2 晶粒面積中快取、控制電路、ALU的分配比例
如何分配矽晶粒(半導體晶片)有限的面積(電晶體預算),決定了兩者架構差異的關鍵。
- 通用運算處理器的晶粒面積分配:晶粒的一半以上被大容量快取記憶體(SRAM)與高階控制電路(分支預測、指令擷取、解碼、排程等)所佔據。實際執行運算的ALU所佔比例相對較小。
- 圖形運算處理器的晶粒面積分配:快取記憶體與控制電路被壓低至必要最小限度,晶粒的大部分被數千至數萬個ALU(CUDA核心)所佔據。
圖形運算處理器並非依靠快取來隱藏記憶體存取的延遲(Latency),而是透過「上下文切換」來隱藏。當某一群執行緒正在等待來自記憶體的資料抵達時,它會立即執行另一群執行緒的運算,使運算器始終保持在運作狀態(高佔用率:Occupancy)。這就是圖形運算處理器追求「高吞吐量」的實體實現。由於硬體層級的多執行緒技術(Hardware Multithreading)執行得極為輕量,其前提是存在著數千至數萬個並行執行的執行緒。
追補第2章的補充:SIMT執行模型的本質
2.1 SIMD與SIMT的差異
在平行處理的分類中,雖然有Flynn氏分類法(Flynn’s taxonomy),但圖形運算處理器的執行模型經常被拿來與SIMD(Single Instruction, Multiple Data)比較。通用運算處理器的向量擴充指令(如AVX等)是純粹的SIMD,以1個指令同時處理多筆資料(例如存放在256位元寬暫存器中的8個32位元浮點數)。在SIMD中,要讓資料的每個元素執行不同的分支(if-else)是非常困難的。
另一方面,NVIDIA提倡的CUDA執行模型被稱為SIMT(Single Instruction, Multiple Threads)。在SIMT中,多個獨立的「執行緒」組成群組(後述的「Warp」),共用並執行相同的指令。但是,與SIMD不同的是,SIMT的各個執行緒擁有獨立的暫存器狀態與指令位址計數器(在程式設計模型上)。因此,程式設計師在撰寫程式碼時,可以彷彿各個執行緒都在獨立運作一般。
2.2 以32個執行緒為單位的「Warp」
圖形運算處理器的硬體並不會個別排程執行緒,而是以**將32個執行緒組合而成的「Warp」**為單位進行管理與執行。(在AMD的圖形運算處理器中被稱為Wavefront,有時採用64個執行緒為單位)。
串流多處理器(SM)內的指令擷取與解碼單元,會以Warp為單位擷取1個指令,並將相同指令派發(Dispatch)給Warp內的32個執行緒。也就是說,Warp內的32個執行緒,在實體上是完全同時地,針對各自擁有的不同資料執行相同指令。這就是SIMT的核心。
2.3 Warp Divergence(分支發散)的實體懲罰
雖然各執行緒表現得彷彿擁有獨立的程式計數器,但在實體上,Warp內的全部執行緒必須執行相同的指令。那麼,如果程式碼中存在如 if-else 的條件分支,且Warp內的執行緒之間對分支條件的真偽產生了分歧,會發生什麼事呢?
這個現象被稱為Warp Divergence(分支發散)。
當發生Warp Divergence時,硬體會透過以下步驟進行處理:
- 首先,僅對
if條件為真的執行緒(活動執行緒)執行指令。此時,條件為假的執行緒會被「遮罩(無效化)」,運算結果不會被寫入。 - 接著,轉移至
else條件(或條件為假時的路徑),這次會將剛才被遮罩的執行緒設為活動,並遮罩剛才為真的執行緒來執行指令。
也就是說,當存在多個分支路徑時,硬體不得不以序列(串列)而非平行的方式來執行這些路徑。作為一個極端的例子,如果Warp內的32個執行緒遵循了32種不同的分支路徑,執行時間將會暴增為32倍。Warp Divergence是讓圖形運算處理器運算吞吐量銳減的最大因素之一,也是在演算法設計中最應避免的反面模式。從實體上來看,這意味著ALU即使消耗了電力,卻因為被遮罩而沒有產生有效的運算結果,發生了「無效週期」。
追補第3章的補充:串流多處理器(SM)的硬體解剖
圖形運算處理器是由多個**串流多處理器(SM: Streaming Multiprocessor)**的集合體所構成。SM正是圖形運算處理器真正的運算引擎。在最新的架構(例:Hopper H100)中,單一圖形運算處理器晶粒上搭載了超過100個SM。
3.1 SM內部的管線結構
SM內部進一步被分割為多個子分割區(通常是4個),每個分割區都有獨立的Warp排程器與派發單元。
- Warp排程器(Warp Scheduler):選擇處於可執行狀態(暫存器與記憶體已準備就緒的狀態)的Warp。圖形運算處理器的排程器能以零負荷切換Warp,這是隱藏記憶體存取延遲的關鍵。
- 派發單元(Dispatch Unit):向已排程的Warp發出指令。
- CUDA核心(INT32 / FP32 / FP64 ALU):進行實際整數運算與浮點數運算的單元。
- 載入/儲存單元(LD/ST Unit):負責記憶體的讀寫。
- 特殊功能單元(SFU):高速計算sin、cos、exp、倒數等超越函數的專用硬體。
指令管線被設計得非常深,擁有擷取、解碼、排程、暫存器讀取、執行(多個週期)以及寫回等各個階段。FP32的FMA(Fused Multiply-Add)運算的延遲通常需要數個至十幾個週期,但透過每個週期從不同的Warp發出指令,能讓管線始終保持全滿。
3.2 巨大的暫存器檔案與暫存器壓力
SM中搭載了通用運算處理器無法比擬的巨大暫存器檔案(例如:每個SM為64KB至256KB的SRAM)。這是為了保持在SM上同時執行的數千個執行緒的所有上下文。
上下文切換能以零週期完成,是因為不需要將執行緒的暫存器狀態退避(Spill)到記憶體中。然而,如果每個執行緒使用的暫存器數量增加,SM內能同時啟動的Warp數量(佔用率)就會下降。這被稱為暫存器壓力(Register Pressure)。當暫存器枯竭時,資料會被退避到低速的區域記憶體(實體上是全域記憶體的一部分),導致效能呈現毀滅性的下降。
3.3 共用記憶體(Shared Memory)與Bank衝突
SM中存在著程式設計師可明確控制的超高速晶片上記憶體,即共用記憶體(Shared Memory)。它與L1快取共用相同的實體SRAM區域,但作為明確的資料快取發揮作用,並用於區塊內執行緒間的資料共用與同步。
共用記憶體的實體結構被分割成多個稱為**記憶體Bank(Memory Banks)**的獨立模組(通常為32個)。連續的32位元位址會被交錯(Interleave)分配到不同的Bank。
當Warp內的32個執行緒同時存取不同的Bank時,存取會被完全平行地(在1個週期內)處理。這被稱為無Bank衝突。 然而,如果多個執行緒同時試圖存取相同Bank的不同位址時,請求就會被序列化,產生懲罰(延遲)。這被稱為Bank衝突(Bank Conflict)。例如,2路的Bank衝突會使存取時間變為2倍,最糟情況下32路的衝突會延遲32倍。在矩陣轉置等演算法中,由於步幅存取會發生嚴重的Bank衝突,因此必須使用填補(Padding,插入虛擬資料以偏移記憶體位址的技巧)來迴避衝突的高階最佳化是不可或缺的。
追補第4章的補充:Tensor Core的乘加運算管線
在Volta架構中首次導入,並讓後續圖形運算處理器效能發生飛躍性提升的革命性硬體,這就是Tensor Core(張量核心)。AI與深度學習爆發性的發展,若沒有Tensor Core是無法談起的。
4.1 矩陣乘加運算(MMA)的硬體實作
深度學習運算的大部分是神經網路權重矩陣與輸入資料的矩陣相乘(GEMM: General Matrix Multiply)。作為計算式可表示為 $D = A \times B + C$ ($A, B$ 為輸入矩陣,$C$ 為累加器矩陣)。
在傳統的CUDA核心中,這項矩陣乘法是使用FMA(Fused Multiply-Add)指令逐個元素進行計算的。相對地,Tensor Core是在硬體層級上以1個週期(或數個週期)一次完成小型矩陣(例如:4x4或16x16)的乘加運算的專用電路。
實體上,它將數十個至數百個乘法器與巨大的加法樹以線路直接連接,不需要將中間結果寫回暫存器就能一口氣完成乘加運算。這使得其與一般的CUDA核心相比,每單位面積的運算吞吐量(TFLOPS)有著數量級的高低之分。
4.2 Mixed-Precision(混合精度)的極意
Tensor Core的另一個精髓是支援**Mixed-Precision(混合精度)**運算。 在深度學習中,有許多場合在計算過程中並不需要高精度(FP32/FP64)。Tensor Core擁有一個管線:以低精度(FP16、BF16,甚至更低的FP8、INT8、INT4)讀取輸入矩陣 $A$ 與 $B$,在內部以低精度進行乘法後,再以較高的精度(FP32或INT32)進行加法(累加)處理。
- FP16 / BF16:訓練的標準。BF16(Bfloat16)的指數部分與FP32一樣有8位元,因為動態範圍廣而容易防止梯度消失。
- FP8 / INT8 / INT4:推論(Inference)加速的王牌。由於資料傳輸量(記憶體頻寬)也被削減,因此吞吐量會戲劇性地提升。
在Hopper架構中,導入了能戲劇性加速Transformer模型計算的「FP8 Tensor Core」,相較於FP32,在理論上實現了數十倍的吞吐量。從軟體端(CUDA),可透過 wmma(Warp-Level Matrix Multiply and Accumulate)API或 mma.sync PTX指令直接驅動Tensor Core,讓Warp內的執行緒協作,進行將矩陣片段載入暫存器、運算、儲存等極度複雜的集合處理。
追補第5章的補充:CUDA記憶體階層與最佳化技巧
圖形運算處理器的計算能力無論多高,一旦資料供應成為瓶頸,就無法發揮效能(記憶體牆問題)。可以說,CUDA程式設計中的最佳化有九成是「記憶體存取最佳化」。
5.1 全域記憶體的合併存取(Coalescing)
圖形運算處理器的主記憶體(HBM或GDDR),也就是全域記憶體,擁有非常寬廣的頻寬(例如數TB/s),但延遲也高達數百週期,非常巨大。
最大化全域記憶體存取效率的絕對原則就是合併存取(Coalescing)。 圖形運算處理器的記憶體控制器會以32位元組、64位元組或128位元組為單位的交易(Transaction)對記憶體進行存取。當Warp內的32個執行緒存取記憶體時,如果這些記憶體位址落在連續的區域內(對齊的128位元組邊界內),硬體會將這些請求合併(Coalesce)成1次的記憶體交易來處理。
反之,如果執行緒存取隨機的位址,或是進行步幅(有間隔)的存取,就不會進行合併,而會產生多次交易。這被稱為「非合併存取」,會導致有效記憶體頻寬降至十分之一以下,是致命的效能Bug。
5.2 CUDA C++程式碼範例:矩陣轉置的最佳化與共用記憶體
以下是迴避非合併存取,並活用共用記憶體來戲劇性改善效能的矩陣轉置(Matrix Transpose)最佳化核心程式碼範例。
| |
這段程式碼的重點有3個:
- 讀取時的合併存取:從
idata的讀取是朝著threadIdx.x連續的X方向進行,因此能完美合併。 - 寫入時的合併存取:向
odata的寫入,也透過交換區塊的座標,設計為朝threadIdx.x方向連續,從而實現合併。 - 共用記憶體上的填補:藉由偏移1個元素的
tile[TILE_DIM][TILE_DIM + 1](填補),完全排除了寫入時在列方向(tile[threadIdx.x][threadIdx.y + j])存取時的Bank衝突。
5.3 快取階層與特殊記憶體
- L1/L2快取策略:在近期的圖形運算處理器架構中,程式設計師可以使用PTX指令(
.ca,.cg,.cs等)作為提示來控制快取的行為。例如,對於只會存取一次的資料,可以繞過L2快取(串流存取),以防止快取污染。 - 紋理記憶體 / 常數記憶體:專門用於影像處理的紋理記憶體,會針對具有2D空間局部性的存取活用專用快取。常數記憶體則對於所有執行緒讀取相同常數的廣播存取,能展現極高的效率。
追補第6章的補充:深度學習時代中的圖形運算處理器未來
不僅是單一圖形運算處理器的效能提升,系統整體的擴展性也是當前計算科學的尖端領域。
6.1 透過NVLink與NVSwitch的超高速互相連接
巨大的LLM(大型語言模型)無法收納於單一圖形運算處理器的記憶體(例如80GB或144GB)中。為了進行模型平行化(張量平行或管線平行),圖形運算處理器之間必須每秒交換兆位元組級的資料。 傳統的PCIe(PCI Express)匯流排無法提供這等頻寬,因此NVIDIA開發了稱為NVLink的獨有高速內部連接技術。進一步地,透過稱為NVSwitch的交換器晶片,能將8基或256基圖形運算處理器以完全無阻塞的交叉開關連接,構築出彷彿是1台巨大圖形運算處理器般運作的叢集。
6.2 Transformer Engine與FP8生態系
為了對自然語言處理,甚至影像與語音辨識上都成為實質標準的Transformer架構進行最佳化,Hopper架構中搭載了稱為Transformer Engine的專用硬體與軟體協作機制。 這是一套動態監視張量的統計資訊,逐層自動切換FP8與FP16運算精度(動態縮放)的機制,能在防止精度劣化的同時,實現極致的運算速度與記憶體頻寬的節約。
6.3 圖形運算處理器叢集的縮放定律與未來展望
正如OpenAI的「Scaling Laws(縮放定律)」所示,隨著模型參數數量與計算量的增加,AI的效能持續在提升。隨之而來,圖形運算處理器已經從單純的處理器,進化成了透過光纖連接數萬基,「資料中心本身就是一台巨大的圖形運算處理器(超級電腦)」。
未來的架構進化,將朝著導入矽光子技術(光互連)、CPO(Co-Packaged Optics),以及從SRAM到HBM的3D堆疊技術的進一步高階化前進。然而,「透過平行處理將吞吐量極大化」這項從圖形運算處理器誕生時就未曾改變的DNA,今後也將繼續開拓計算科學的最前線。
結語:航向計算科學的極北
GPU的架構,是人類至今為止所創造出最複雜、且最專注於吞吐量的計算引擎。如果說CPU是「一台超高效能的F1賽車」,那麼GPU就可以比喻為「數萬台砂石車在統一指揮下同時運送物資的巨大物流系統」。
基於SIMT以Warp為單位的指令執行、能在零週期切換數千執行緒的硬體排程、將頻寬發揮至極限的合併存取,以及牽引深度學習突破的Tensor Core管線。這一切,都是工程師們在「物理定律的極限(光速、熱、電力、矽的微縮極限)內,如何將浮點數運算總量最大化」這種幾近瘋狂的執念結晶。
對於未來的軟體工程師、AI研究員、HPC研究者而言,理解GPU架構已不再只是單純的教養。這是為了直覺掌握在框架(PyTorch或TensorFlow)背後發生了什麼事,以及將硬體能力發揮至極限的「必修科目」。 避免記憶體的Bank衝突、排除Warp Divergence、讓資料持續填滿Tensor Core的管線。在這些最佳化的盡頭,過去需要超級電腦耗費數個月才能完成的計算,如今在桌上的幾張GPU中只需數小時就能完成的未來,正已成為現實。
我們現在正生活在人類歷史上最令人興奮的電腦架構黃金時代。理解CUDA物理學與GPU超平行架構的精髓,並孕育出次世代創新的,或許正是正在閱讀這篇文章的你。
專有名詞解釋(Glossary)
- SM (Streaming Multiprocessor):GPU的主要運算區塊。相當於CPU中的核心,但其內部包含了大量的CUDA核心、Warp排程器、共用記憶體等。
- SIMT (Single Instruction, Multiple Threads):Warp內的全部執行緒共用相同指令,並對獨立資料進行運算的GPU獨有執行模型。
- Warp:32個執行緒的集合體。硬體排程與指令發出的最小單位。
- Warp Divergence(分支發散):Warp內的執行緒之間分支條件分歧,執行路徑序列化而導致吞吐量降低的現象。
- Tensor Core(張量核心):在硬體層級一口氣處理矩陣乘加運算(MMA)的專用電路。專精於深度學習的加速。
- Coalesced Access(合併存取):當Warp內的執行緒存取連續記憶體位址時,硬體會將其合併為1個交易以實現大頻寬的機制。
- Shared Memory(共用記憶體):搭載於SM內部,由程式設計師控制的超高速L1便箋式記憶體(Scratchpad Memory)。
- Bank Conflict(Bank衝突):在共用記憶體中,多個執行緒同時存取同一Bank的不同位址,導致存取被序列化的懲罰。
- Occupancy(佔用率):能在SM上同時設為活動狀態的Warp數與理論最大值的實際比例。越高越容易隱藏記憶體存取延遲。
- Register Spilling(暫存器退避/溢出):執行緒使用的暫存器數量超過硬體上限,溢出的資料被退避至低速記憶體(區域記憶體)的現象。
參考文獻與推薦閱讀清單
- NVIDIA CUDA C++ Programming Guide:所有CUDA程式設計師必讀的官方文件。網羅了記憶體存取模式與最佳化的最佳實踐。
- NVIDIA Ampere / Hopper Architecture Whitepaper:記載了Tensor Core管線、非同步記憶體傳輸、Transformer Engine硬體實作細節的官方白皮書。
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson):電腦架構的古典名著。能深入學習CPU與GPU設計理念的差異、快取階層、指令層級平行性。
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu):從演算法設計觀點解說CUDA程式設計的教科書。詳細解說了共用記憶體的區塊化(Tiling)技巧、歸約(Reduction)、前綴和(Prefix Sum)等的實作。
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking:學術論文。透過微基準測試(Microbenchmarking),揭開了NVIDIA未公開的快取延遲與Tensor Core精確吞吐量的傑作。
本文所解說的架構知識,或許有部分會隨著硬體的進化而過時,但「最大化頻寬、引出平行性、隱藏延遲」這項根本的物理原則,將作為計算機科學的普遍真理而長存。