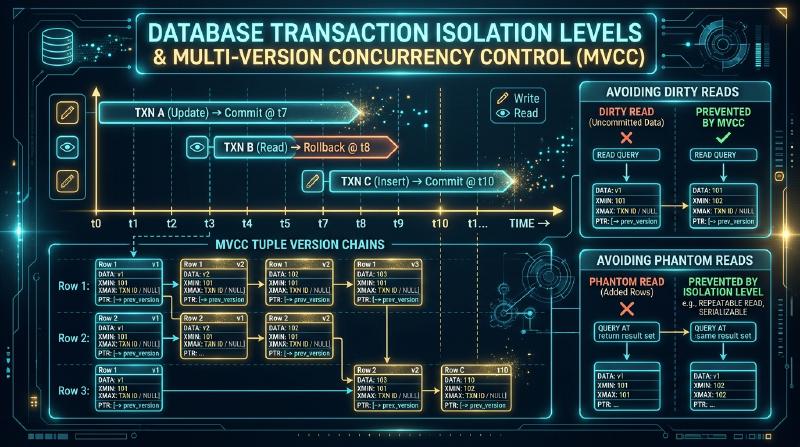
資料庫的交易隔離級別與MVCC:ACID的現實與多版本並發控制
在現代軟體架構中,關聯式資料庫管理系統(RDBMS)依然是資料持久化的核心。其核心概念為「交易(Transaction)」,特別是ACID特性(Atomicity, Consistency, Isolation, Durability),被廣泛認知為建構穩健系統的基礎理論。然而,在ACID特性之中,「Isolation(隔離性)」是理論與實務之間存在最大落差的領域。
本文將從資料庫交易隔離級別的歷史背景出發,探討ANSI SQL-92標準的局限性,乃至現代資料庫引擎所採用的多版本並發控制(MVCC:Multi-Version Concurrency Control)的內部結構,以極其詳細且兼具學術與實務的視角進行深入剖析。特別是,我們將解剖PostgreSQL與MySQL(InnoDB)這兩大開源RDBMS在MVCC實作上的決定性差異,並網羅分散式資料庫最前線的可序列化快照隔離(SSI),為您呈現這篇總計超過12,000字的長篇大作。
第1章:ACID特性的神話與並發處理的困境
1.1 可序列化(Serializability)的理想
交易的Isolation(隔離性)所追求的終極理想型態是「可序列化(Serializability)」。這指的是即使多個交易同時並發執行,其執行結果也「與將這些交易以某種順序一個接一個序列(串行)執行時的結果等價」的性質。
當系統上同時執行交易 $T_1$ 和 $T_2$ 時,無論並發執行引發何種交錯(操作的交織),只要最終的資料庫狀態與按「$T_1 \rightarrow T_2$」或「$T_2 \rightarrow T_1$」順序執行的結果完全一致,該排程即被定義為可序列化。只要保證了這種可序列化,應用程式開發者就完全不需要顧慮並發處理所帶來的資料不一致(如競爭條件或不當的覆寫等),而能專注於業務邏輯的建構。
1.2 鎖定導致序列化的效能崩潰
在早期的資料庫系統中,為了保證這種可序列化,採用了稱為「二階段鎖定(2PL: Two-Phase Locking)」的嚴格鎖定機制。在2PL中,交易在讀寫資料前必須先取得鎖定(共用鎖定或排他鎖定)(階段1:Growing Phase),並在交易結束時(提交或還原時)釋放所有鎖定(階段2:Shrinking Phase)。
然而,這種嚴格的鎖定機制存在致命的缺陷。那就是「效能的極度劣化」。
- 讀取操作會阻塞寫入操作。
- 寫入操作會阻塞讀取操作。
- 鎖定競爭導致等待時間增加,且頻繁發生死結。
當流量增加,大量使用者同時存取資料庫時,基於2PL的完全序列化會成為系統的瓶頸,導致吞吐量急劇下降。系統將面臨「資料一致性」與「並發處理效能(吞吐量)」之間的權衡困境。
1.3 並發控制的歷史與妥協
為了解決這個困境,資料庫工程的研究人員引入了「隔離級別(Isolation Level)」的概念。這是一種「妥協的產物」,它部分放寬了完全可序列化的要求,允許特定資料不一致(異常:Anomaly)的發生,以此來提升並發處理效能。這使得開發者可以根據應用程式的需求,在一致性與效能之間做出選擇。
第2章:ANSI SQL-92標準的隔離級別及其批評
2.1 ANSI SQL-92標準定義的隔離級別
1992年制定的SQL標準規格「SQL-92」,基於並發處理可能發生的3種代表性異常(Phenomena),定義了4種隔離級別。
所定義的3種異常(Phenomena)
- Dirty Read(髒讀): 交易 $T_1$ 更新了資料但尚未提交的狀態下,被另一個交易 $T_2$ 讀取到該未提交資料的現象。如果 $T_1$ 隨後被還原,$T_2$ 等同於讀取了不存在的幻影資料。
- Non-repeatable Read(不可重複讀取): 交易 $T_1$ 兩次讀取同一列資料的期間,另一個交易 $T_2$ 更新並提交了該列資料的現象。這會導致 $T_1$ 第一次與第二次的讀取結果不同。
- Phantom Read(幻讀): 交易 $T_1$ 以特定搜尋條件讀取多列資料的期間,另一個交易 $T_2$ 插入(或刪除)了符合該條件的新資料列並提交的現象。當 $T_1$ 以相同條件再次搜尋時,會發現列數增加或減少。
SQL-92的4種隔離級別
SQL-92根據防止這些異常發生的程度,定義了隔離級別。
- Read Uncommitted: 允許髒讀。
- Read Committed: 防止髒讀,但允許不可重複讀取與幻讀。
- Repeatable Read: 防止髒讀與不可重複讀取,但允許幻讀。
- Serializable: 防止所有異常,保證完全的可序列化。
2.2 Berenson等人的批評論文《A Critique of ANSI SQL Isolation Levels》
SQL-92標準的定義乍看之下非常明確且具邏輯性。然而,1995年由Hal Berenson、Jim Gray(圖靈獎得主)、Phil Bernstein等資料庫界巨擘所發表的論文《A Critique of ANSI SQL Isolation Levels》,對這個ANSI標準的定義給予了毀滅性的打擊。
該論文指出的SQL-92標準主要缺陷如下:
1. 基於鎖的隱含前提
SQL-92的定義隱含地假設「資料庫是以基於鎖的並發控制(2PL)所實作的」。然而,在1990年代,已經開始出現採用MVCC(後述)或其他樂觀並發控制(OCC)的資料庫,以鎖定為前提的異常定義已逐漸過時。
2. 定義的模糊與不完整性
論文指出,僅憑SQL-92定義的3種異常(Dirty Read, Non-repeatable Read, Phantom Read),並無法涵蓋並發處理中可能發生的所有異常。 例如,有一種稱為**「髒寫(Dirty Write)」**的現象。這是指未提交交易寫入的資料,被另一個未提交交易覆寫的現象,但在SQL-92標準中並未提及髒寫。儘管所有的隔離級別(包含Read Uncommitted)都必須防止髒寫(否則資料庫的內部一致性將會崩潰),標準規格卻未觸及這一點。
3. 新異常的發現
論文中定義了多個SQL-92標準中不存在的新異常。其中最具代表性的是以下2個:
- Lost Update(遺失更新): 兩個交易同時讀取相同資料,並各自將計算結果寫回時,其中一方的更新覆寫並消除了另一方更新的現象。
- Write Skew(寫入偏差): 後述快照隔離中特有的現象。
Berenson等人的論文證明了SQL-92標準未能對隔離級別進行數學上、嚴格的定義,對資料庫業界帶來了極大的衝擊。在當前的資料庫理論中,ANSI SQL-92的隔離級別定義被視為「應該了解的歷史背景」,並被當作「作為嚴格技術定義並不充分的東西」來對待。
第3章:快照隔離(Snapshot Isolation)與寫入偏差
3.1 Repeatable Read與快照隔離的差異
在Berenson等人的論文中特別受到關注的,是**「快照隔離(Snapshot Isolation: SI)」**這種新隔離級別的提倡。
在許多採用MVCC的資料庫(如PostgreSQL與Oracle等)中,作為「Repeatable Read」提供的隔離級別,其實質正是這個「快照隔離」。在快照隔離中,每個交易都會針對其開始時的資料庫一致「快照(過去的靜止狀態)」進行讀取。
- 交易開始後由其他交易進行的更新將完全不可見(防止不可重複讀取)。
- 由於資料列的存在本身被固定在過去的時點,其他交易所進行的INSERT也同樣不可見(防止幻讀)。
換言之,快照隔離不僅滿足了SQL-92定義的「Repeatable Read」要件,在很多情況下甚至連「幻讀」也一併防止了。那麼,快照隔離是否等同於「Serializable」呢? 答案是「否定」的。因為快照隔離中存在一種稱為**「寫入偏差(Write Skew)」**的致命異常,這使其無法達到可序列化。
3.2 醫師值班問題與寫入偏差(Write Skew)
理解寫入偏差最著名的例子是「醫師的待命(值班)系統」。
【業務規則】 假設有一套醫院排班管理系統,規定「隨時必須至少有1名醫師處於待命(on-call)狀態」。
目前,Alice與Bob兩位醫師處於待命狀態(on_call = true)。
此時,Alice與Bob恰好同時覺得「身體不適想取消待命」,並各自從終端機發起了更改排班的交易。
【交易流程(在快照隔離下)】
- [Tx1: Alice] 取得快照。確認目前處於待命狀態的是Alice與Bob兩人。
SELECT count(*) FROM doctors WHERE on_call = true;-> 結果: 2 - [Tx2: Bob] 取得快照。同樣確認是Alice與Bob兩人。
SELECT count(*) FROM doctors WHERE on_call = true;-> 結果: 2 - [Tx1: Alice] 判斷符合規則(待命1人以上),將自己從待命中移除。
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] 同樣判斷符合規則,將自己從待命中移除。
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] 提交成功。
- [Tx2: Bob] 提交成功。(由於Alice與Bob更新的是不同的資料列,因此資料列鎖定不會衝突)
【結果】 Tx1與Tx2雙雙提交的結果是,待命醫師變成了「0人」。業務規則徹底崩潰。
這就是寫入偏差(Write Skew)。 如果是可序列化(Serializable),Tx1與Tx2其中一方會先被序列執行,後執行的交易就會偵測到待命人數為「1人」,從而中止(還原)移除自己的操作。然而,在快照隔離下,由於雙方更新的是不同的資料列(Alice列與Bob列),衝突未被偵測到,進而引發了業務規則的不一致。
3.3 ReadOnly Anomaly(唯讀異常)
此外,快照隔離還存在一種極其特殊的異常,稱為ReadOnly Anomaly,這是在「唯讀交易」介入時導致可序列化崩壞的現象。 這個異常常見於銀行帳戶存款餘額與利息發放的例子中,儘管更新交易之間沒有發生衝突,但唯讀交易由於查看了過去的快照,從而讀取到了「邏輯上不可能存在的時間軸狀態」。由於這些異常的存在,快照隔離在嚴格意義上被區別於Serializable。
第4章:MVCC(Multi-Version Concurrency Control)的運作原理
到目前為止,我們已經討論了隔離級別的理論與異常,那麼現代資料庫是如何控制這些情況的呢?其核心技術就是MVCC(Multi-Version Concurrency Control:多版本並發控制)。
4.1 「讀取不阻塞寫入,寫入不阻塞讀取」
MVCC最大的設計思想,也是與基於鎖的控制(2PL)最決定性的差異,在於「讀取與寫入互不阻塞」。 當更新資料列時,MVCC資料庫不會直接覆寫(In-place update)現有資料列。取而代之的是,它會建立新版本的資料列(版本/元組),同時保留舊版本的資料列。
在資料庫中,同一資料列的多個版本(從過去到現在的歷史紀錄)會同時存在。 當交易讀取資料時,會根據自身的「交易ID(XID)」或「開始時間(時間戳記)」,從系統中存在的大量版本中計算出「自己應該讀取的正確過去版本」來讀取。
這使得即使某個交易正在改寫資料列,其他交易仍然可以讀取「改寫前的過去版本」,從而避免了因鎖定造成的等待。
4.2 元組的版本管理鏈與可見性(Visibility)規則
在MVCC中最重要的演算法,是判定「哪個交易能夠看到哪個版本的資料」的可見性規則(Visibility Rule)。
每個交易在開始時都會被分配一個單調遞增的唯一交易ID(XID)。 資料庫中儲存的每個資料列版本(元組),都會附加上以下資訊作為中繼資料:
- 建立XID: 透過INSERT/UPDATE建立此版本的交易ID。
- 刪除XID: 透過UPDATE/DELETE邏輯刪除(無效化)此版本的交易ID。
當交易 $T_i$ 讀取資料列時,會基於以下基本規則判定可見性:
- 是否已提交: 建立XID的交易是否已經提交?
- 是否非未來: 建立XID是否為早於 $T_i$ 開始時的過去交易?
- 是否未被刪除: 刪除XID是否未設定,或者刪除XID的交易尚未提交,又或者它是晚於 $T_i$ 開始時的未來交易?
透過嚴格評估這些條件,可以為每個交易提供一致的快照。
第5章:PostgreSQL與MySQL (InnoDB) MVCC實作的決定性差異
雖然MVCC的基本理念相同,但其內部實作會因資料庫產品而有驚人的差異。在此,我們將比較剖析開源界兩大巨頭PostgreSQL與MySQL(InnoDB)的MVCC架構。
5.1 PostgreSQL的MVCC實作:堆疊內附加與VACUUM的必然性
PostgreSQL的MVCC採用了非常獨特且直觀的**「附加型(Append-only)架構」**。
5.1.1 基於xmin與xmax的位元判定邏輯
在PostgreSQL資料表實體的資料檔(堆疊, Heap)中,每一列(元組)的標頭裡都記錄了 xmin 與 xmax 這兩個交易ID。
xmin(Transaction ID of Insert): 建立此元組的交易XID。xmax(Transaction ID of Delete): 刪除(或因更新而邏輯刪除舊版本)此元組的交易XID。
【UPDATE操作的行為】
在PostgreSQL中,UPDATE 在邏輯上被處理為 DELETE 與 INSERT 的組合。
- 將目前的交易XID寫入舊元組的
xmax。(邏輯刪除) - 在堆疊的空閒空間中建立一個全新元組,寫入新資料,並將目前的交易XID設定在
xmin。(新增)
也就是說,新舊兩個元組會混合儲存在同一個資料表資料檔(堆疊)中。
5.1.2 巨大的優勢與致命的課題:VACUUM的存在
這個架構最大的優勢在於還原(Rollback)速度極快。如果交易被中止,只需將新增的元組視為「未提交」即可,不需要進行資料的寫回處理。
然而,致命的課題是**「無用元組(Dead Tuples)的肥大化」**。
如果不斷重複UPDATE或DELETE,不再被任何人參照的舊版本元組(xmax 為已提交的舊交易ID的元組)將會在堆疊中無限累積。如果放任不管,資料表的實體大小將會爆發性膨脹,導致循序掃描的效能遭遇毀滅性的下降。
為了解決這個問題,用於物理刪除這些無用元組,使空閒空間可被重複利用的系統程序,就是**VACUUM**(以及自動執行的 autovacuum 守護行程)。在PostgreSQL的維運中,VACUUM的調校被認為極為重要,其原因正是源於這個MVCC架構的根本。
5.2 MySQL InnoDB的MVCC實作:就地更新與Undo日誌的動態重建
另一方面,MySQL的預設儲存引擎InnoDB採用了更接近Oracle Database的**「就地更新(In-place update)與Undo日誌(還原區段)」**架構。
5.2.1 叢集索引與就地更新
InnoDB的資料表是以主鍵為基礎的B+Tree(叢集索引)構成的。
當在InnoDB中執行 UPDATE 時,它不會像PostgreSQL那樣附加新資料列,而是直接覆寫(In-place update)B+Tree上的資料列。
那麼,如果其他交易想讀取過去的快照該怎麼辦呢? 為此,InnoDB會將覆寫前的「舊資料」退避至專用區域,也就是Undo日誌(Undo Log Segment)。
5.2.2 透過Roll Pointer動態重建過去
InnoDB每一筆資料列的隱藏欄位中,包含了以下兩個項目:
DB_TRX_ID: 最後一次插入或更新此列的交易ID。DB_ROLL_PTR(Roll Pointer): 指向Undo日誌中儲存此列「上一個舊版本」位置的指標。
交易讀取過去快照的過程如下:
- 從B+Tree讀取最新資料列。
- 確認
DB_TRX_ID,如果是由晚於自己快照的未來交易進行的更新,則判斷不可讀取此最新資料列。 - 追蹤
DB_ROLL_PTR,從Undo日誌中取得過去版本的資料。 - 使用Undo日誌上的資料,在記憶體中**動態重建(Rollback in memory)**過去記錄的狀態。
- 如果仍然是未來的更新,則繼續追溯Undo日誌鏈往更過去尋找。
5.2.3 InnoDB的優勢與課題
這個架構的優勢在於主資料表區域(資料表空間)不容易肥大化。最新的資料始終位於B+Tree的適當位置,而過去的版本被隔離在其他區域(Undo日誌)中,因此保持了較高的物理走訪效率(不需要像PostgreSQL那樣大規模的VACUUM,Undo日誌的清除程序會在背景輕量運作)。
缺點則是,當存在需要讀取大量過去快照的長時間執行交易(如批次處理或mysqldump等)時,為了追溯Undo日誌以重建資料,會產生額外負擔(Overhead),導致讀取效能下降。此外,Undo日誌本身也有肥大化並壓縮磁碟空間的風險。
第6章:可序列化快照隔離(SSI)與分散式資料庫的最前線
MVCC的進化並未就此停止。如第3章所述,快照隔離(SI)存在著「寫入偏差」等異常,並非完全的Serializable。然而,為了讓應用程式開發者不必顧慮並發處理的複雜性,有必要在維持MVCC高效能的同時,實現完全的Serializable。
6.1 可序列化快照隔離(SSI)的誕生
2008年,Michael Cahill等人的論文發表了一種劃時代的演算法——「可序列化快照隔離(Serializable Snapshot Isolation, SSI)」。這是一種以MVCC架構為基礎,卻能保證完全可序列化(Serializable)的技術。PostgreSQL從9.1版開始,便率先採用了SSI作為其「Serializable」隔離級別的實作。
SSI的運作原理:衝突圖與危險結構(rw-antidependency)
SSI不會利用鎖定進行阻塞。取而代之的是,它會在交易執行期間精細地追蹤(Tracking)「哪些資料被讀取(Read),哪些資料被寫入(Write)」。
SSI會監控交易間的衝突關係,尋找稱為**「rw-antidependency(讀寫反依賴性)」**的特定衝突模式。 具體而言,就是交易 $T_1$ 讀取了過去版本的資料,而該資料隨後被另一個交易 $T_2$ 覆寫並提交的關係。 SSI會在內部建構交易的衝突圖,當偵測到「rw-antidependency箭頭連續出現兩次的結構(危險結構)」的瞬間,便會判斷可序列化有可能被破壞,進而強制中止(還原)其中一個交易。
藉此,可以在發生寫入偏差(如:醫師值班問題)等異常之前停止交易,最終保證完全的Serializable。可以說這是樂觀並發控制(OCC)的終極型態。
6.2 分散式資料庫中的MVCC:Spanner, CockroachDB, TiDB
現代資料庫技術已經超越了單一伺服器的限制,進化為分散部署於全球資料中心的分散式SQL資料庫(NewSQL)。在分散式環境中,實現具備全球一致性的MVCC,曾經是一項挑戰物理法則的難題。
Google Spanner與TrueTime API
Google的Spanner為了跨分散式系統解決交易排序的問題,開發了TrueTime API。 基於各伺服器的時鐘(物理時鐘)必定會產生誤差(時鐘偏移)的前提,它結合了GPS與原子鐘,將現在時間以「不確定性範圍(時間窗)」的形式提供。 Spanner的MVCC透過在交易提交時等待這個TrueTime的不確定性時間窗過去(Commit Wait),從物理上保證了「具備因果關係的交易,其時間戳記順序必定正確(外部一致性 / External Consistency)」。
CockroachDB與HLC(Hybrid Logical Clock)
CockroachDB是一款受Spanner啟發的開源分散式資料庫,為了在不使用昂貴原子鐘的情況下實現接近於此的一致性,採用了HLC(混合邏輯時鐘)。 透過結合NTP的物理時鐘同步與Lamport邏輯時鐘(基於事件間因果關係的計數器),它能在分散式節點間產生全球一致的MVCC快照時間戳記,並在分散式環境中實現了SSI(Serializable Snapshot Isolation)。
TiDB與Percolator模型
由PingCAP公司開發的TiDB,採用了基於Google Percolator模型的分散式交易模型。 這是一種準備了單一元件(Placement Driver: PD)來派發全球時間戳記,各節點的儲存引擎(TiKV)再使用該時間戳記在本地處理MVCC的架構。雖然以2PC(二階段提交)為基礎,但它將鎖定保持的時間降至最低,成功在分散式環境中兼顧了龐大的交易與MVCC。
結論:邁向ACID的彼岸
資料庫的交易隔離級別,絕不僅僅只是死記硬背的項目。它代表著數十年來電腦科學的奮鬥史,關於如何調和資料一致性與系統效能這兩個背道而馳的需求。
從ANSI SQL-92不完整的定義開始,歷經MVCC帶來的並發處理飛躍性提升、PostgreSQL與InnoDB架構的分歧,再到SSI與分散式資料庫對終極一致性的挑戰。 深入理解這些內部結構,勢必能成為您設計更穩健、更高效能應用程式的強大武器。
我們現在正生活在一個ACID特性不再只是「神話」,而是透過高階演算法與物理時鐘同步被實作為「現實」的時代。對於在資料之海中航行的工程師而言,探索資料庫引擎的深淵,將是一場永無止境的知性探求之旅。