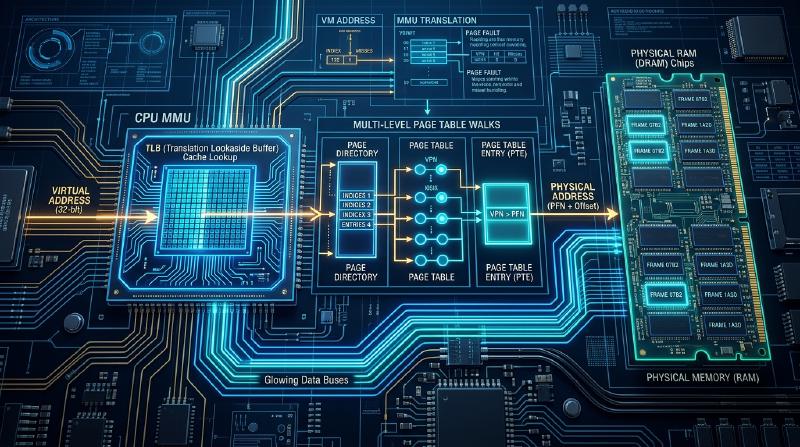
虚拟内存与分页机制完全解剖:从MMU到TLB、HugePage,以及内存管理的深渊
在现代操作系统(OS)和CPU架构中,最复杂且最重要的系统之一就是“虚拟内存(Virtual Memory)”和“分页(Paging)”机制。在应用程序开发者平时不会注意到的内存空间背后,硬件的MMU(内存管理单元)和操作系统内核紧密协作,在纳秒级的世界中进行着海量的地址转换和异常处理。
本文将从操作系统内部结构和计算机架构的角度,解剖虚拟内存系统的最深处。从x86-64架构页表结构的完整位布局,到TLB击落(Shootdown)的IPI协议、Linux内核中缺页异常的完整追踪、写时复制(CoW)的物理机制、内存回收(Reclaim)算法,直到OOM Killer的分数计算公式,我们将在源码级别和寄存器级别彻底讲解这些底层机制。
第一章:虚拟内存的存在理由与历史背景
为什么计算机需要虚拟内存?在早期的计算机系统中,程序直接访问物理内存(RAM)的特定地址。然而,随着多任务环境的普及,这种“物理地址直接指定方式”达到了极限。
1.1 内存保护与进程空间的完全分离
虚拟内存最大的目的是“确保安全性和稳定性”。如果进程A错误地(或恶意地)重写了进程B的内存,整个系统就会崩溃,或者机密信息会被泄露。虚拟内存给每个进程提供了一种“拥有自己专属的连续内存空间”的错觉。由此,进程间的内存在硬件级别(MMU)被严格分离,非法的内存访问会立即被陷入(trap),并作为段错误(Segmentation fault)来处理。用户空间和内核空间的分离也是通过这种机制实现的,特权环的转换和内存访问权限的检查在硬件中每个周期都在进行。
1.2 打破物理内存容量壁垒与按需分页思想
应用程序请求的内存量超过所搭载的物理RAM容量,这并不罕见。虚拟内存将当前未使用的内存区域(页)换出(Swap out)到二级存储设备(HDD/SSD)中,并在需要时重新读入(Swap in),从而提供比物理内存更广阔的地址空间。此外,程序开始执行时,并非将所有代码和数据读入内存,而是基于“按需分页(Demand Paging)”的思想,在发生访问时才首次加载到内存中,这兼顾了节省内存和加快启动速度。
1.3 从分段到分页的范式转换
在早期的x86(如80286等)中,使用了以可变长度块来管理内存的“分段(Segmentation)”机制。它使用CS(代码段)、DS(数据段)等寄存器,通过基地址加偏移量的方式计算逻辑地址。然而,分段很容易引起“外部碎片(External Fragmentation)”,并且管理极其繁琐。随后,随着80386的出现,引入了以固定长度(通常为4KB)块进行管理的“分页(Paging)”机制,并成为主流。现代的64位OS(如Linux和Windows)事实上将分段作为平坦内存模型(基地址0,限制最大)使其失效,仅通过分页来进行内存管理。分段目前仅用于极少数用途,例如引用线程局部存储(TLS)(FS/GS寄存器)。
第二章:x86-64中页表的多级结构与位布局完全解剖
在64位架构(x86-64/AMD64)中,虚拟地址空间极其广阔。在当前主流的“48位虚拟地址空间”中,硬件MMU会遍历4级页表。
2.1 48位/57位虚拟地址空间与规范形式(Canonical Form)限制
64位寄存器可以表示16艾字节(Exabytes)如此广阔的地址空间,但在当前的硬件实现中,出于成本和复杂性的考虑,并没有全部使用。在48位实现中,存在一个限制,即虚拟地址的第47位到63位必须全部是相同的值(符号扩展)。满足此限制的地址被称为“规范形式地址(Canonical Address)”。
由此,内存空间变成了在中央拥有巨大未使用区域(Non-canonical hole)的结构,被漂亮地一分为二:下半部分的用户空间(0x0000000000000000 ~ 0x00007FFFFFFFFFFF)和上半部分的内核空间(0xFFFF800000000000 ~ 0xFFFFFFFFFFFFFFFF)。如果解引用了一个非法的指针(例如在最高位嵌入了元数据的指针),MMU会立即将其作为Canonical违规,产生一般保护异常(#GP)。近年来,从Intel Ice Lake以后的处理器开始,也开始支持进一步扩展的57位虚拟空间(5级页表),这成为了处理PB级内存的云基础设施的基础。
2.2 4级页表层次结构(PML4, PDPT, PD, PT)详情
为了将48位虚拟地址转换为物理地址,x86-64使用了4层页表(基数树/Radix Tree状的数据结构)。每个表的大小为4KB,存储512个64位(8字节)条目(2^9 = 512)。虚拟地址被分割如下,并作为各层的索引发挥作用。
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - 最顶层。CR3寄存器指向物理基地址。
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - 对于2MB的HugePage,这里就是终点。
- Bits 12-20 (9 bits): PT (Page Table) Index - 普通4KB页的最终表。
- Bits 0-11 (12 bits): Page Offset - 4KB(4096字节)页内的偏移量。
2.3 页表项(PTE)的64位布局完整表
页表的每个64位条目不仅仅是一个物理地址的指针,还是掌控强大访问控制和缓存控制的元数据集合体。以下是x86-64的PTE的完整位布局及其详细功能。
- Bit 0 [P] Present: 如果为1,则存在于物理内存上。如果为0,则已被换出,或者未分配。为0时访问会产生缺页异常(#PF)。
- Bit 1 [R/W] Read/Write: 如果为0,则只读(不可写),如果为1,则可读/写。在写时复制(CoW)的实现中发挥极其重要的作用。
- Bit 2 [U/S] User/Supervisor: 如果为0,则仅特权模式(内核)可以访问。如果为1,则用户模式(Ring 3)也可以访问。受KPTI或SMAP等严格管理。
- Bit 3 [PWT] Page-level Write-Through: 如果为1,则该页的缓存写入策略为直写(Write-Through)。如果为0,则为回写(Write-Back)。
- Bit 4 [PCD] Page-level Cache Disable: 如果为1,则禁用该页的缓存(Uncacheable)。用于内存映射I/O(MMIO)等直接访问PCIe设备寄存器的情况。
- Bit 5 [A] Accessed: 当MMU访问(读或写)该页时,由硬件自动设置为1。在OS的LRU算法(页面回收)中作为引用位被利用。
- Bit 6 [D] Dirty: 当MMU对该页进行“写入”时,由硬件自动设置为1。这是OS判断是否需要写回磁盘(换出)的必需位。
- Bit 7 [PAT] Page Attribute Table: 与PWT/PCD结合使用,用于指定更详细的内存缓存类型(如WC: Write-Combining等)的索引。在向显存(VRAM)进行高速批量传输等时使用。
- Bit 8 [G] Global: 如果为1,即使CR3寄存器发生切换(发生上下文切换),也不会从TLB中刷新此条目。主要用于内核空间的页,以避免系统调用时发生TLB未命中的惩罚。
- Bits 9-11 [AVL] Available: 操作系统(内核)可以自由使用的3个位。在Linux中,有时用于交换条目的元数据,或识别NUMA节点等。
- Bits 12-51 [PFN] Physical Frame Number: 转换目标的物理页基地址(物理帧号)。由于是4KB对齐,低12位始终作为0处理。
- Bits 52-62 [AVL/PKU] Available/Ignored: 根据CPU代数或功能扩展(如Intel MPK: Memory Protection Keys等)保留,或者是OS可用区域。
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: 如果为1,则该页上的数据“不可作为指令执行”。防止由于缓冲区溢出等引起向数据区域进行代码注入攻击的强大安全机制(DEP: Data Execution Prevention)。
这样,PTE的每一位都与OS的内存管理算法(尤其是交换处理、安全保护、I/O控制)紧密结合,作为硬件和软件边界上的接口,是极其精妙的设计。
第三章:MMU的硬件页表遍历与延迟壁垒
从虚拟地址到物理地址的转换是由存在于CPU核心内部的专用硬件电路——**MMU(Memory Management Unit,内存管理单元)**来完成的。
3.1 以CR3寄存器为起点的表遍历机制
处理器的控制寄存器 CR3 中存储着当前正在执行进程的最顶层页表(PML4)的物理地址。Linux等OS在进行上下文切换,将CPU执行权让给另一个进程时,会将该 CR3 寄存器重写为新进程的PML4地址。由此,进程的内存空间整体瞬间切换。
概念性的流程如下:
- 取出虚拟地址的最高位索引,读取CR3所指向的PML4表的相应条目。
- 取出PML4条目的PFN,计算下一个PDPT表的物理地址。
- 读取PDPT表的相应条目。
- 同样地追踪PD表、PT表,得到最终的4KB物理页基地址。
- 最后加上12位的页偏移量,构建出完整的物理地址。
3.2 内存总线访问与延迟(Latency)这个最大的壁垒
这4级页表遍历最大的弱点是“内存访问延迟”。仅仅转换1个虚拟地址,在最坏的情况下,会对物理内存产生4次访问(读取PML4、PDPT、PD、PT)。 现代DRAM的访问延迟大约为50~100纳秒。如果4次内存访问都在CPU缓存(L1/L2/L3)中未命中并到达DRAM,仅此就会产生数百纳秒的停顿。考虑到CPU的时钟周期大约为0.3纳秒(3GHz),这相当于数千个周期的致命延迟,CPU的流水线将完全枯竭并停止。 为了打破这种极其严重的性能壁垒而设计出来的,就是接下来要解说的TLB。
第四章:多核环境下TLB架构与击落的苦恼
TLB(Translation Lookaside Buffer,转换后备缓冲区)是嵌入在MMU中的“虚拟地址到物理地址转换结果的缓存”,由超高速的SRAM(或CAM: Content Addressable Memory)组成。
4.1 TLB的层次结构与PCID(进程上下文标识符)优化
在最新的CPU中,TLB也具有L1/L2的层次结构。L1 D-TLB(数据用)和L1 I-TLB(指令用)容量非常小(几十个条目),但能在1个周期内响应。L2 TLB拥有数百到数千个条目,能在几个周期内响应。 当TLB中不存在条目(TLB未命中)时,就会发生前面描述的硬件表遍历(页遍历)。为了辅助这一过程,还实现了专门用于页遍历的缓存(PWC: Page Walk Cache)。
因为进程切换后虚拟地址的含义会发生改变,所以在以前(x86早期),重写CR3时会清空(Flush)整个TLB。但是,这样会导致上下文切换后TLB未命中频发,性能显著下降。 为了解决这个问题而引入的技术是PCID(Process-Context Identifier,进程上下文标识符)(在ARM架构中称为ASID)。通过给TLB条目附加唯一标识进程的12位ID(标签),使得在上下文切换后依然能够保持之前进程的TLB条目,这极大地提升了Web服务器、数据库等多进程环境下的性能。
4.2 TLB击落(TLB Shootdown)的处理器间中断(IPI)协议
在多核环境下,虚拟内存系统面临着非常棘手的同步问题。例如,假设在核心0(CPU0)上运行的进程使用 munmap() 释放了特定的内存区域,并使页表中的PTE失效(Present = 0)。然而,在核心1(CPU1)本地的TLB中,可能还作为缓存残留着从该虚拟地址到物理地址的“旧的转换信息(Stale TLB Entry)”。
如果这样放任不管,核心1就会访问已释放的内存,可能破坏分配给其他进程的数据,或者读取机密信息,导致严重的安全漏洞。为了防止这种情况,OS必须强制核心1从其TLB中删除相应的条目。这就是TLB击落(TLB Shootdown)。
TLB击落严格按照以下步骤(IPI协议)执行:
- 发起者(核心0): 更新页表(清除PTE)后,发出内存屏障(如
mfence),向目标其他核心(核心1)的本地APIC(高级可编程中断控制器)发送IPI(Inter-Processor Interrupt,处理器间中断)。 - 等待(自旋等待): 核心0通过自旋锁等待所有其他目标核心完成中断处理。
- 目标(核心1): 收到IPI后,立即中断当前正在执行的用户代码,进入内核的中断处理程序(在Linux中通过
smp_call_function进入flush_tlb_func等)。 - 执行刷新: 核心1使其本地TLB中指定虚拟地址的条目失效(在x86中使用
INVLPG指令,全刷新时重新加载CR3)。 - 完成通知: 核心1将完成刷新的标志写入内存,解除核心0的等待。之后,恢复之前中断的处理(
iret)。
性能瓶颈与可扩展性极限: TLB击落伴随着硬件IPI的发出、中断上下文切换、流水线刷新以及多核间的自旋锁等待,是消耗数千至数万个周期的极高成本操作。核心数量如果增加到16、64、128等,这个同步成本将呈指数级增加,这已经成为云服务器和HPC中多线程应用程序(尤其是频繁重复内存分配和释放的程序)面临的严重阻碍扩展的因素。
第五章:Linux内核缺页异常处理的完整追踪
当程序访问页表的 Present 位为0的区域,或者没有权限的区域(如尝试写入只读区域、从用户模式访问内核区域等)时,MMU会发出缺页异常(x86中为 Exception 14, #PF)。由此,Linux内核深邃的异常处理之旅便开始了。
5.1 缺页异常的控制流与架构相关部分的追踪
在x86-64的Linux内核中,发生缺页异常时的函数调用图(调用追踪)如下。控制权从架构相关的低级处理程序转移到架构无关的通用内存管理子系统。
asm_exc_page_fault(汇编语言: arch/x86/entry/entry_64.S)- CPU检测到异常,硬件将发生错误的虚拟地址设置到
CR2寄存器中,将寄存器状态保存到中断栈中,并跳转到内核的入口点。
- CPU检测到异常,硬件将发生错误的虚拟地址设置到
exc_page_fault()(C语言: arch/x86/mm/fault.c)- 架构相关的故障处理程序。分析错误代码(读/写、用户/内核、PF等),确认中断上下文等。
do_page_fault()/do_user_addr_fault()- 判断发生异常的是在内核空间(如Bug或vmalloc区域等)还是用户空间。如果是用户空间,则搜索目标进程的内存映射(
vm_area_struct的红黑树和VMA列表),确认该地址是否属于合法的区域(是否是段错误)。
- 判断发生异常的是在内核空间(如Bug或vmalloc区域等)还是用户空间。如果是用户空间,则搜索目标进程的内存映射(
handle_mm_fault()(C语言: mm/memory.c)- 这里开始是架构无关的核心函数。遍历页表的各级(PGD -> P4D -> PUD -> PMD -> PTE),如果表尚未分配,则在分配中间目录(如
pmd_alloc等)的同时,确定最终的PTE地址。
- 这里开始是架构无关的核心函数。遍历页表的各级(PGD -> P4D -> PUD -> PMD -> PTE),如果表尚未分配,则在分配中间目录(如
5.2 内存分配的精髓:handle_mm_fault的分支
handle_mm_fault() 根据确定的PTE状态(PTE为空、已换出或权限错误),分支进入实际的页面分配处理。
do_anonymous_page()(按需分页的极致): 当PTE完全为空(全零)时被调用。这是对不与文件关联的匿名页(Anonymous Page)的首次访问,例如扩展堆(malloc背后的brk或mmap)或栈。内核在这里首次从伙伴系统(Buddy System)分配物理内存(帧),将其清零并映射到PTE。这可以节省未使用的内存。do_fault()/__do_fault()(文件后备分页): 在首次访问mmap的文件等时调用。从页缓存中读取文件数据,或者调用文件系统(如ext4或xfs)的驱动程序从磁盘加载数据,并映射到页表中。do_swap_page()(换入的痛苦): PTE的Present位为0,但在另一个标志位中记录了交换区偏移量信息时调用。从磁盘(交换分区或交换文件)将数据重新加载到物理内存中。因为伴随磁盘I/O,进程在此会进入长时间的休眠(阻塞)状态。do_wp_page()(写时复制): 稍后解释的CoW处理。在Present=1,但尝试写入没有写权限的页时调用。
5.3 写时复制(CoW)的物理机制与引用计数的魔法
Linux进程创建的核心 fork() 系统调用,通过一种称为CoW(Copy-on-Write,写时复制)的延迟评估机制,运行得极其迅速。即使父进程使用了数GB的内存,fork() 也能在一瞬间完成,下面解释其背后的物理机制。
- 页表共享:
当调用
fork()时,内核将父进程的页表直接原样复制给子进程。但是,物理内存本身完全不复制。父子进程的PTE指向完全相同的物理内存(帧)。 - 强制设置只读位(Write-Protect):
此时,内核强制将共享的所有页的PTE的
R/W位重写为0(只读)(包括原本可写的数据区域等全部如此)。 - 增加引用计数(Reference Count):
将管理目标物理页的内核结构体(
struct page的_refcount)加1,使其进入“被两个进程引用”的状态。 - 写入与缺页异常(触发do_wp_page):
当父进程或子进程中的任何一方尝试向共享变量或堆区域进行写入(Write)时,硬件MMU检测到
R/W=0,并立即触发缺页异常。 - 页面复制(Duplication):
从缺页异常处理程序调用
do_wp_page()。内核检查VMA标志,判断“这不是非法访问,而是合法的CoW导致的缺页”。从伙伴系统分配一个新物理页,并将原页的数据整个复制过去(copy_page)。 - 更新PTE并减少引用计数:
将执行写入操作的进程的PTE重新指向新的物理页,并将
R/W位设置为1(可读写)。然后,原物理页的引用计数减1。如果引用计数变为1,就意味着另一个进程独占了该页,当该进程下次发生缺页异常时,就不需要复制内存,只需将R/W位改回1即可(页面重用)。
如此一来,CoW是MMU硬件保护功能(只读陷阱)和内核软件控制完美融合的艺术级算法,实现了内存的剧烈节省和进程的快速启动。
第六章:内存回收(Reclaim)算法的深渊与OOM Killer的裁决
物理内存是有限的。当系统长期运行,文件缓存和进程堆耗尽内存时,OS为了确保新的内存,必须释放并回收(Reclaim)现有的内存区域。这个内存回收子系统是Linux内核中最复杂、最难懂的领域之一。
6.1 活跃/非活跃LRU列表与伪LRU算法
Linux内核使用LRU(Least Recently Used,最近最少使用)列表来管理和跟踪物理页。然而,要通过严格的LRU管理所有页面,在锁争用和遍历成本方面是不可能的。因此,采用了使用“Active列表”和“Inactive列表”两个队列(列表)的伪LRU算法(Clock算法的派生)。
- Active列表: 最近频繁被访问的“热”页面集合。这里不会成为回收的目标。
- Inactive列表: 一段时间未被访问的“冷”页面集合。从末尾(tail)的页面开始依次成为回收候选。
内核如何知道页面是否被访问过呢?这就要靠第二章中讲解的PTE的 Accessed位(A位) 发挥作用了。内核(kswapd)定期遍历页表,从PTE读取A位,在软件层面记录访问历史后,将A位清零。如果A位再次被硬件设置为1,则该页保留在Active列表中,或者从Inactive提升。如果未被设置,则逐渐降级到Inactive列表的末尾。
6.2 kswapd守护进程与直接回收(Direct Reclaim)的恐怖
当内存空闲量(Free Pages)低于特定阈值(水位线:low)时,内核后台线程 kswapd(每个NUMA节点存在一个)就会苏醒。
kswapd 从Inactive列表末尾取出页面。
- 如果它是干净的文件缓存(未修改的文件数据),只需将其丢弃(Drop)来腾出内存。
- 如果它是脏的(修改过的)文件缓存,则先写回(Writeback)磁盘,然后丢弃。
- 如果它是匿名页(进程的堆或栈),则写出到交换区(换出)。
它会持续这项后台工作,直到空闲容量达到
high水位线。
然而,如果应用程序分配内存的速度(内存压力)极高,kswapd 的回收速度跟不上,空闲内存跌破极限阈值(min 水位线),就会触发直接回收(Direct Reclaim)。
直接回收是指,在请求内存的进程(应用程序本身)的上下文中,直接同步执行内存回收处理(丢弃缓存或换出)的机制。一旦进入直接回收,应用程序的执行(malloc 或缺页异常的完成)就会完全停滞(Stall),这是导致长达数百毫秒甚至几秒的严重性能下降(延迟毛刺,Latency Spike)的直接原因。在数据库或实时系统中,必须进行调优(调整 vm.swappiness 或水位线)以避免这种情况发生。
6.3 OOM Killer的分数计算公式与进程裁决
即使进行了直接回收,交换区也被耗尽,缓存也被清空,仍旧无法分配到内存时,Linux内核会作为最终手段召唤 OOM (Out Of Memory) Killer。
OOM Killer为了防止整个系统因内存不足而陷入恐慌(内核崩溃或完全冻结),会强制终止(SIGKILL)消耗大量内存的进程,从而夺回内存。这里存在着决定牺牲者的冷酷算法。
决定杀哪个进程是基于一个叫做 oom_score 的评价值进行的(在内核的 mm/oom_kill.c 中的 oom_badness() 函数中计算)。
OOM Score的基本计算逻辑(概念):
- 基础分数: 进程当前使用的内存量(RSS: Resident Set Size + 页表量 + 交换区使用量)占总内存的比例。最大1000分。也就是说,消耗内存越多的进程(例如发生内存泄漏的进程等),越容易被杀。
- Root权限惩罚减免: 以root用户权限运行的进程(如系统核心守护进程等),很可能是维持系统所必需的,因此分数会稍微打折(减去一些),变得不容易被杀。
- 用户调整值 (OOM Score Adj): 会加上
/proc/[pid]/oom_score_adj(-1000 到 +1000)的值。系统管理员可以使用它来控制OOM Killer的行为。将此值设置为 -1000 的进程(例如:sshd、kubelet、数据库的主进程等)将成为“OOM Killer的豁免对象(无敌)”。
当OOM Killer被触发时,内核日志(dmesg 或 /var/log/messages)中会输出类似“Out of memory: Killed process 1234 (java)”的提示信息,同时还会输出当时的进程列表、各自的分数、内存状态的详细转储。系统管理员通过理解此日志和分数计算机制,可以查明意外进程终止的原因,并设置适当的资源限制(cgroups或ulimit)。
第七章:最新的超高速内存技术与硬件安全
7.1 2MB/1GB HugePages的威力与THP的功过
解决第三章和第四章中所述的TLB未命中和表遍历延迟的强大手段就是“HugePage”。 使用2MB(在Page Directory阶段直接指向物理地址,即跳过PT层级)或1GB(在PDPT阶段直接指向)的巨大页面来代替普通的4KB页面。
由此,1个TLB条目就可以覆盖广阔的内存区域(4KB的512倍,或26万倍),从而急剧减少TLB未命中。在对海量内存进行随机访问的数据库(Oracle, PostgreSQL)或虚拟化环境(KVM/QEMU)中,使用HugePage已成为性能调优的必修课。
Linux的**THP (Transparent Huge Pages,透明大页)**是一种即使应用程序不感知,内核后台线程(khugepaged)也会将连续的4KB页面自动合并(碎片整理)为2MB HugePage的机制。然而,在内存碎片化严重的环境中,这种合并处理(内存规整,Memory Compaction)本身会大量消耗CPU,引发延迟毛刺,因此在Redis等内存KVS中,建议禁用THP(设为 never 或 madvise)。
7.2 内核页表隔离(KPTI)与Meltdown对策的代价
2018年被曝光的CPU推测执行漏洞“Meltdown (CVE-2017-5754)”,是一个可以从用户进程非法读取内核内存空间(缓存)的、动摇硬件根基的致命缺陷。
为了应对此问题,在OS端引入了KPTI (Kernel Page-Table Isolation,内核页表隔离)(初期称为KAISER)。
过去,为了减少上下文切换的开销,即使在用户空间执行时,页表的上半部分也映射了整个内核区域(前提是通过PTE的U/S位进行特权检查来拒绝访问)。然而推测执行绕过了这种特权检查。
引入KPTI后,用户执行时使用不映射内核大部分的“最小影子页表(User PGD)”。在通过系统调用或中断过渡到内核空间时,必须切换 CR3 寄存构并重新加载完整的内核页表(Kernel PGD)。
这完全确保了安全性,但因为每次系统调用或中断都会发生高成本的CR3切换(以及PCID/TLB刷新的管理),在I/O密集型应用程序(大量使用Syscall的Web服务器或DB)中,带来了几%到百分之十几的不可忽视的性能开销。
7.3 Direct I/O与零拷贝技术的进化
为了优化文件I/O,OS将虚拟内存机制发挥到了极致。
使用 mmap() 系统调用时,会将文件的内容直接映射到虚拟地址空间。访问时发生缺页异常,将文件数据读入页缓存,从用户空间就可以作为指针直接访问。
此外,在网络收发或存储I/O中,为了省去内核空间(页缓存)与用户空间缓冲区之间由CPU进行的数据拷贝(伴随上下文切换的拷贝),活用了**零拷贝(Zero Copy)**技术。在 sendfile() 系统调用,或者最新的 io_uring、AF_XDP 中,通过与网卡(NIC)或NVMe驱动器的DMA(Direct Memory Access)控制器协作,操作页表的PTE,直接将内核页“挂载(重映射)”到用户空间,使内存拷贝的开销完全变为零。在这里,也是通过巧妙的页表操作作为根本机制来实现的。
结语
虚拟内存和分页机制是OS内核和CPU(硬件)共同奏响的极高水准交响乐。从页表1个比特标志的设置,围绕TLB击落的自旋锁苦恼,CoW引用计数的内存魔法,直到OOM Killer冷酷的启发式算法,其深处浓缩着“如何安全且高速地抽象有限物理资源,给进程提供无限的幻觉”这一计算机科学的智慧。
理解底层机制,不仅对于C/C++或Rust等系统编程语言中的优化(考虑缓存行的数据结构设计,以及mmap的有效利用)必不可少,而且对于深刻理解Go或Java等高级语言中的垃圾回收(GC)的停顿时间(STW)或内存分配器(jemalloc或tcmalloc)的行为也至关重要。揭开系统的“魔法”面纱,直接感受硬件和内核的脉动,将为你开启一条通往能够设计出更加优雅、可扩展软件的优秀架构师之路。