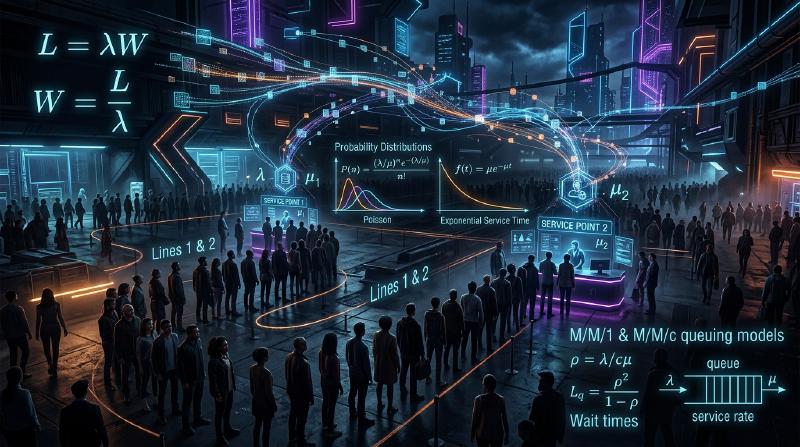
引言:为什么旁边的收银台总是比较快?
在超市或便利店排队结账时,你是否曾觉得,相比自己选择的队伍,旁边的队伍总是前进得更快?这通常被认为只是一种心理错觉(墨菲定律),但实际上存在着数学依据。
因为你没有排的队伍总是多于你排的队伍,从概率上讲,“除了你之外的某个队伍比你的队伍前进得快”的可能性非常高。像这样,澄清直觉与概率统计之间的偏差,并运用数学方法来优化整个系统效率的理论,就是“排队论(Queuing Theory)”。本文将从排队论的历史、肯德尔记号(Kendall’s Notation)、利特尔法则(Little’s Law)的证明、Python模拟,以及在现代IT基础设施中的应用等多个方面,进行全面透彻的讲解。
1. 排队论的历史背景:A.K. 埃尔朗的挑战
排队论诞生于1909年,由丹麦数学家兼工程师 阿格纳·克拉鲁普·埃尔朗 (Agner Krarup Erlang) 创立。当时他在哥本哈根电话公司工作,面临着一个现实问题:“电话局的交换机需要配备多少条线路,才能让客户无需等待即可通话?”
当时的电话需要接线员手动插拔插头来连接线路。如果线路太少,“占线”的概率就会升高,导致客户满意度下降。另一方面,如果盲目增加线路,又会造成巨大的成本。为了解决这种权衡问题,埃尔朗利用泊松分布和指数分布对电话呼叫的到达和通话时间进行了建模,推导出了埃尔朗公式(Erlang B formula / Erlang C formula)。这就是排队论的诞生。
2. 排队论的基本概念
排队系统主要由以下三个要素组成:
  graph LR
    A["客户到达 (Arrival)"] --> B["队列 (Queue)"]
    B --> C["服务窗口 (Server)"]
    C --> D["离开 (Departure)"]
- 到达过程 (Arrival Process): 客户(或任务、数据包等)到达系统的时间间隔。在很多情况下,它被建模为泊松过程(到达时间间隔服从指数分布)。
- 服务过程 (Service Process): 提供服务所需的时间。这也常利用指数分布或一般分布进行建模。
- 窗口数量 (Number of Servers): 处理客户的收银台或服务器的数量。
肯德尔记号 (Kendall’s Notation)
为了对排队模型进行分类,大卫·肯德尔(David Kendall)在1953年提出了一种记法,被称为“肯德尔记号”。一般采用 A/B/C/K/N/D 的形式,但常常省略为 A/B/C。
- A (Arrival): 到达时间间隔的概率分布(例:M = 马尔可夫/指数分布,D = 确定性/恒定,G = 一般分布)
- B (Service): 服务时间的概率分布(例:M, D, G)
- C (Servers): 窗口(服务器)数量
- K (Capacity): 系统的最大容量(省略时为无限大 $\infty$)
- N (Population): 潜在客户群体大小(省略时为无限大 $\infty$)
- D (Discipline): 服务规则(例:FCFS = 先到先服务,LCFS = 后到先服务,省略时为FCFS)
最基本且最著名的模型是 M/M/1 模型。这意味着“到达时间间隔服从指数分布 (M)”、“服务时间服从指数分布 (M)”、“窗口数量为1 (1)”。
3. M/M/1 模型的数学分析
让我们用数学公式来解开 M/M/1 排队系统。
参数定义
- $\lambda$ (Lambda): 平均到达率。单位时间内到达的平均客户数。
- $\mu$ (Mu): 平均服务率。单位时间内能够处理的平均客户数。
- $\rho$ (Rho): 流量密度 (利用率/系统负荷)。$\rho = \lambda / \mu$。
为了系统能够稳定运行,必须满足 $\rho < 1$(即 $\lambda < \mu$)。如果 $\rho \ge 1$,客户的到达速度将超过处理能力,队列将会无限延长。
主要公式
当 M/M/1 模型处于稳态时,可以推导出以下重要指标:
- $$ L = \frac{\rho}{1 - \rho} = \frac{\lambda}{\mu - \lambda} $$
- $$ W = \frac{L}{\lambda} = \frac{1}{\mu - \lambda} $$
- $$ L_q = L - \rho = \frac{\rho^2}{1 - \rho} $$
- $$ W_q = \frac{L_q}{\lambda} = \frac{\rho}{\mu - \lambda} $$
利用率的陷阱:为什么队列会突然变长
请注意公式 $L = \rho / (1 - \rho)$。
- 当 $\rho = 0.5$ (系统利用率 50%) 时, $L = 1$ 人。
- 当 $\rho = 0.8$ (系统利用率 80%) 时, $L = 4$ 人。
- 当 $\rho = 0.9$ (系统利用率 90%) 时, $L = 9$ 人。
- 当 $\rho = 0.95$ (系统利用率 95%) 时,$L = 19$ 人。
当系统利用率超过90%时,即使到达率略微增加,队列的长度也会呈爆炸性增长。这为IT基础设施的一条铁律提供了数学证明,即在服务器或系统的负载测试中,“使CPU使用率始终保持在95%是非常危险的”。要想系统稳定运行,预留余量(Buffer)是不可或缺的。
4. 利特尔法则 (Little’s Law)
排队论中最强大且最具普遍性的定理之一就是“利特尔法则”。由约翰·利特尔 (John Little) 于1961年证明。
定理陈述: 在处于稳态的系统中,系统内的平均客户数 ($L$) 等于到达率 ($\lambda$) 与客户的平均逗留时间 ($W$) 的乘积。
$$ L = \lambda \times W $$为什么这个法则如此惊人?
利特尔法则的伟大之处在于,它完全不依赖于系统的内部结构或概率分布。无论是 M/M/1 还是 G/G/k,无论是先到先服务 (FCFS) 还是后到先服务 (LCFS),只要系统处于稳态,它就必然成立。
具体例子:咖啡店 假设一家咖啡店平均每小时有60位客人光顾($\lambda = 60 \text{ 人/小时} = 1 \text{ 人/分钟}$)。客人平均在店内逗留20分钟($W = 20 \text{ 分钟}$)。 此时,店内平均客人数 $L$ 为: $L = 1 \text{ 人/分钟} \times 20 \text{ 分钟} = 20 \text{ 人}$ 由此可以预测,店内通常会有大约20个座位被占用。像这样,即便是黑盒系统,也可以通过外部可观测的指标来估算内部状态。
5. 使用 Python 进行排队模拟
除了理论,让我们实际运行程序来验证一下。我们将使用 Python 的事件驱动型模拟库 simpy 来模拟 M/M/1 排队模型。
| |
运行这段代码,可以确认模拟结果会收敛到非常接近理论值 $W_q$ 的水平。即使系统变得复杂,难以用解析方法求解的 M/G/1 或多服务器模型,也可以通过这种模拟方法来预测性能。
6. 在 IT 基础设施中的应用
排队论是现代计算机科学和 IT 基础设施设计中不可或缺的概念。
1. Web 服务器的负载均衡 (Load Balancing)
Web 请求(HTTP 请求)的到达是一个典型的排队模型。当单台服务器(M/M/1)无法处理时,就会引入负载均衡器将请求分散到多台服务器上。这可以作为 M/M/c 模型进行分析,从而计算出需要运行多少台服务器才能将平均响应时间控制在目标值以下。
2. 网络路由与丢包 (Packet Loss)
互联网路由器内部有缓冲区(内存),用于存放等待发送的数据包。这可以看作是一个容量有限的排队模型(M/M/1/K)。在缓冲区已满时到达的数据包会被丢弃(Drop)。运用排队论,可以确定满足容许丢包率所需的缓冲区大小。
3. 云计算的自动扩缩容 (Auto Scaling)
在 AWS 或 GCP 等云环境中,通常会使用根据流量自动增减服务器的自动扩缩容功能。当利用率 $\rho$ 超过一定的阈值(例:70%)时就添加服务器,这个规则正是基于排队论中“当利用率接近1时,等待时间就会发散”的性质。
结语:用数学公式克服日常的烦躁
从“为什么旁边的收银台看起来总是比较快?”这个疑问出发,我们发现它与通信网络、交通拥堵、医院候诊室,乃至最前沿的云服务器优化息息相关,连接着支配世界上所有“等待”的普遍法则。
我们在日常生活中因“等待时间”而产生的烦躁,从整个系统的视角来看,也不过是遵循着利特尔法则和泊松分布的、井然有序的数学现象而已。下次当你排在长长的队伍中时,与其烦躁不安,不如观察一下:“当前的到达率 $\lambda$ 是多少呢?”“利用率 $\rho$ 是不是快到极限了?”也许,等待的时间也会变得稍微充实一些。