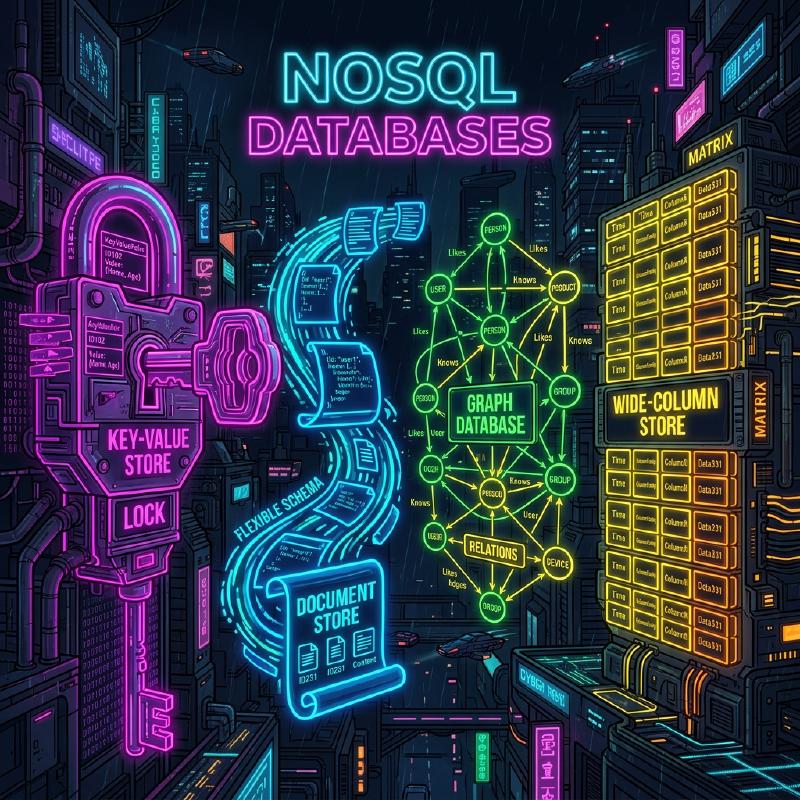
在现代系统开发中,作为数据存储和管理手段的数据库选择具有极其重要的意义。过去曾是关系型数据库(RDBMS)一枝独秀的时代,但在当今数据多样化、数据量大规模化的背景下, NoSQL (Not Only SQL)数据库开始发挥重要作用。
NoSQL 数据库并非单一技术,而是针对特定用例进行优化的各种数据模型的总称。本文将在阐明 RDBMS 与 NoSQL 的决定性差异的基础上,详细且全面地讲解 4 种代表性的 NoSQL 数据模型—— 键值型(KVS) 、 文档导向型 、 图数据库型 以及 宽列型 的各自特性、优缺点以及合适的用例。
1. 什么是 NoSQL?深入了解其与 RDBMS 的差异
为了正确选择 NoSQL,首先必须明确理解它与传统关系型数据库(RDBMS)的区别。RDBMS(如 MySQL、PostgreSQL、Oracle 等)多年来一直是企业级系统的核心。它们擅长严格保证数据的一致性(ACID 特性),并支持复杂的表连接(JOIN)以及通过 SQL 进行的灵活查询。
然而,随着 Web 服务规模的扩大和非结构化数据的激增,RDBMS 架构难以应对的挑战逐渐浮出水面。由此诞生的便是 NoSQL。NoSQL 和 RDBMS 的主要区别如下。
无模式与数据结构的灵活性
RDBMS 需要预先定义严格的模式(表的列名和数据类型)。一旦定义了模式,修改它的成本会很高,这有时会损害开发的敏捷性。 另一方面,许多 NoSQL 数据库采用了 无模式 或模式灵活的方法。无需事先完全定义数据结构,可以根据应用程序的需求变化动态改变数据的形态。可以说这一特性与敏捷开发和微服务架构非常契合。
水平可扩展性(Scale-out)
提高 RDBMS 性能的基本方法是增加服务器 CPU 或内存的 向上扩展(垂直扩展,Scale-up) 。但是,单一服务器的性能存在物理极限,且成本极为高昂。虽然部分 RDBMS 提供了集群功能,但在跨节点保持数据一致性和分布式处理方面存在技术门槛。
NoSQL 从设计初期就以 向外扩展(水平扩展,Scale-out) 为前提,即通过并列多台廉价服务器(节点)来提高处理能力和存储容量。数据自动分布(分片)到多个节点上,当数据量或流量增加时,只需添加节点即可提高整个系统的吞吐量。
CAP 定理与一致性模型
在分布式系统中,无法同时完全满足数据一致性( Consistency )、可用性( Availability )和分区容错性( Partition Tolerance )这三者的 CAP 定理 ,是 NoSQL 设计中的一个重要概念。
RDBMS 通常重视“ CA (一致性与可用性)”(前提是没有网络分区),而许多 NoSQL 数据库则选择在“ CP (一致性与分区容错性)”或“ AP (可用性与分区容错性)”之间进行权衡。特别是在大规模分布式环境中,不少 NoSQL 选择稍微牺牲严格的一致性,优先保证系统始终保持响应(可用性),只要数据最终达到一致即可,这种方法被称为 最终一致性(Eventual Consistency) 。
2. 键值型(Key-Value Store: KVS)
键值型(KVS)是 NoSQL 数据库中最简单且最快的数据模型。顾名思义,它仅通过唯一的“键(Key)”和与之对应的“值(Value)”组成的对来管理数据。
数据模型与特点
KVS 具有与关联数组或字典相同的结构。从数据库端来看,值的内容通常仅作为字节流或字符串处理(部分例外),基本上无法解析其内部结构并发送查询。对数据的访问仅限于“指定键以获取、更新、删除值”这种简单的操作。
这种极端的简单性造就了 KVS 最大的武器—— 压倒性的性能 。因为不需要进行复杂的查询解析或 JOIN 处理,能够以毫秒至微秒级的超低延迟读写数据。此外,由于数据相互独立,将数据分布到多个节点(分片)也极其容易。
代表性的 KVS 数据库
- Redis : 运行在内存中的内存 KVS 的代表。它不仅支持简单的字符串,还支持列表、集合、哈希等多种数据结构,并具备发布订阅功能,是一款功能丰富的 KVS。
- Memcached : 极其简单、高速的分布式内存缓存系统。
- Amazon DynamoDB : 全托管、具有极高扩展性的 KVS(同时具备宽列和文档的特性)。
优缺点
优点:
- 超快的处理速度 : 由于结构简单,磁盘 I/O 和内存操作的开销最小化。
- 高可扩展性 : 容易基于键来分布数据,可实现近乎无限的向外扩展。
缺点:
- 无法进行复杂查询 : 不适合根据值的内容进行搜索(例如:“寻找年龄在 20 岁以上的用户”)或数据汇总。
- 难以表达数据间的关系 : 没有关联关系功能,必须在应用程序端管理相关性。
用例
KVS 最适合能够通过键唯一获取值,且要求高速性能的场景。
- 会话管理 : 存储 Web 应用程序的用户会话信息。键为会话 ID,值为会话数据。
- 缓存层 : 临时存储对 RDBMS 的查询结果或计算成本高的处理结果,以提高响应速度。
- 实时排行榜 : (特别是使用 Redis 的有序集合功能等)实时统计并显示游戏的排名等。
- 用户设置或个人资料 : 以用户 ID 为键,将单独的设置项(如 JSON 等)作为值保存。
Redis 代码示例
下面展示了使用 Redis 进行的基本键值操作示例(CLI 命令)。
| |
3. 文档导向型数据库
文档导向型数据库在保持 KVS 灵活性的同时,提供了更复杂的数据结构和高级的查询能力。
数据模型与特点
它将数据以被称为“文档”的单位进行存储。文档的实体主要是以 JSON(JavaScript Object Notation) 、BSON(Binary JSON)或 XML 格式表示的层级数据结构。
与 KVS 不同,文档数据库能够理解值(文档)的内部结构。因此,可以为文档中嵌套的字段创建索引,并指定条件进行搜索和汇总。 另外,与将相关数据拆分到不同表中(规范化)的 RDBMS 形成对比,文档数据库倾向于将相关数据汇总到一个文档中(非规范化/嵌入)的设计。通过这种方式,可以通过一次查询获取所需的所有数据。
代表性的文档型数据库
- MongoDB : 文档导向数据库的事实标准。具备强大的查询语言和灵活的索引,可扩展性也很高。
- Firestore / Firebase Realtime Database : Google Cloud 提供的擅长实时同步的文档型数据库。
- Couchbase : 兼具 KVS 的高速性和文档数据库查询能力的分布式数据库。
- Amazon DocumentDB : 兼容 MongoDB 的全托管服务。
优缺点
优点:
- 无模式的灵活性 : 每个文档可以拥有不同的结构,便于直接保存应用程序的对象。
- 强大的查询功能 : 可以在内部字段进行搜索、汇总和排序。
- 开发效率高 : 不需要 ORM 的复杂映射,与基于 JSON 的 API 契合度极高。
缺点:
- 复杂事务的限制 : 与 RDBMS 相比,跨多个文档更新的开销较大(虽然 MongoDB 等近年来已支持多文档事务,但不建议滥用)。
- 数据大小膨胀 : 由于无模式导致的字段名重复保存以及非规范化导致的数据重复,数据大小往往容易变大。
用例
文档导向型适合数据结构频繁改变的情况,或希望原样保存复杂数据结构的情况。
- 内容管理系统(CMS) : 灵活管理文章、作者、标签、评论等结构不同的内容。
- 商品目录和库存管理 : 最适合那些不同商品类别(如家电、服装、食品)所需属性(规格信息)差异极大的数据模型。
- 用户个人资料与设置 : 将每个用户不同的任意设置项或属性信息作为一个文档进行管理。
- 日志或事件数据存储 : 将应用程序输出的各种格式的日志数据原样作为 JSON 保存,以便日后检索和分析。
MongoDB 代码示例
以下是 MongoDB 中插入文档和查询的示例(类 mongosh 或 Node.js 驱动风格)。
| |
4. 图数据库
图数据库是专注于“ 数据与数据之间的关系(连接) ”而设计的特化型数据库,而非侧重数据本身。实际上,RDBMS 的“关系型”在处理表间关系时成本很高,而图数据库则如其名,将关系作为一等公民来处理。
数据模型与特点
图数据库采用了基于数学“图论”的数据模型。构成数据的主要元素有以下 3 个:
- 节点(Node / Vertex) : 数据的实体(例如:人、公司、商品等)。相当于 RDBMS 的行。
- 边(Edge / Relationship) : 节点之间的关系(例如:是朋友、购买了、属于等)。边可以带有方向(指向)。
- 属性(Property) : 赋予节点或边的键值形式的属性信息(例如:人的“姓名”、关系的“开始日期”等)。
在 RDBMS 中追踪复杂的关系需要大量 JOIN,如果层级变深,性能会急剧恶化。但是,在图数据库中,从节点追踪边(遍历)的操作是以类似指针移动的级别超高速进行的,因此可以瞬间探索数万、数百万个关系。
使用 Mermaid 的图模型图解
以下是将 SNS 中用户间的关系及商品购买历史建模后的图数据库概念图。
  graph TD
    %% 节点的定义
    U1("User: Alice<br>(age: 28)")
    U2("User: Bob<br>(age: 32)")
    U3("User: Charlie<br>(age: 25)")
    P1("Product: Laptop<br>(price: 1500)")
    P2("Product: Mouse<br>(price: 50)")

    %% 边(关系)的定义
    U1 --|"FOLLOWS<br>{since: 2023}"| U2
    U1 --|"FOLLOWS<br>{since: 2024}"| U3
    U2 --|"FOLLOWS<br>{since: 2022}"| U1

    U1 --|"PURCHASED<br>{date: '2025-01-10'}"| P1
    U3 --|"PURCHASED<br>{date: '2025-02-15'}"| P1
    U3 --|"PURCHASED<br>{date: '2025-02-15'}"| P2

    %% 样式设置
    classDef userNode fill:#d4e157,stroke:#9e9d24,stroke-width:2px;
    classDef productNode fill:#81d4fa,stroke:#0277bd,stroke-width:2px;

    class U1,U2,U3 userNode;
    class P1,P2 productNode;
代表性的图数据库
- Neo4j : 世界上使用最广泛的图数据库。采用了独特且强大的查询语言 Cypher。
- Amazon Neptune : AWS 提供的全托管图数据库。支持 Property Graph (Gremlin) 和 RDF (SPARQL)。
- ArangoDB : 支持图、文档、KVS 的多模型数据库。
优缺点
优点:
- 深度层级的关系探索超快 : 可以以毫秒级处理诸如“朋友的朋友的朋友买的商品”这样复杂关系的查询。
- 直观的数据建模 : 可以将在白板上画出的概念图直接作为数据库模式实现。
缺点:
- 不适合单一实体的全表扫描 : 简单的统计处理(如:“计算所有用户的平均年龄”)通常使用 RDBMS 或文档型更快。
- 分布式处理的难度 : 因为图是紧密耦合的数据,如果将数据分割(分片)到多个节点,就容易发生跨节点的遍历,导致性能下降。
用例
这对于数据之间的连接本身就具有价值,并且需要深入探索和分析这些关系的系统来说是必不可少的。
- SNS(社交网络) : 管理好友关系、关注/被关注关系。
- 推荐引擎 : 实时推荐“与你购买倾向相似的用户正在买的商品”。
- 欺诈检测(Fraud Detection) : 将可疑的 IP 地址、信用卡、账户的相关性以图的形式可视化,从而识别欺诈团伙。
- 网络和 IT 基础设施管理 : 管理服务器和路由器的依赖关系,并在故障发生时瞬间锁定影响范围。
Neo4j 代码示例(Cypher 查询)
以下是使用 Cypher 查询语言在 Neo4j 中插入数据并搜索关系的示例。Cypher 的特点是可以用类似字符画的形式来表达关系。
| |
5. 宽列型(列族存储)
宽列型数据库(或列族存储)是专为将海量数据分布在多个节点上进行高速读写而设计的数据模型。它受到 Google 的 Bigtable 论文启发而诞生。
数据模型与特点
它在结构上类似于 RDBMS 中由行和列组成的表,但内部保存数据的方式却截然不同。宽列存储的数据结构主要由以下元素构成。
- Row Key(行键) : 唯一标识行的键。数据根据这个键分布在各个节点上。
- Column Family(列族) : 相关列的集合。类似于 RDBMS 中的表,但每一行可以拥有不同的列。
- Column(列) : 由“列名(Key)”、“值(Value)”和“时间戳”组成的集合。
它最大的特点是, 每一行的列数量和种类可以不同(无模式) ,以及 能够拥有几百万列这样巨大的(宽)行 。 此外,它采用了 LSM 树(Log-Structured Merge-tree)等架构,写入(Write)磁盘的操作极快且是顺序写入的,所以在不断记录海量数据的用途中具有压倒性的优势。
使用 Mermaid 的宽列模型图解
以下是记录传感器数据(IoT)的宽列存储的逻辑数据结构概念图。每行可以存储任意数量的列。
  erDiagram
    %% 宽列存储数据结构
    ROW_KEY {
        string Row_Key_Partition_Key
    }

    COLUMN_FAMILY_1 {
        string Column_1_Name_Value_Timestamp
        string Column_2_Name_Value_Timestamp
        string Column_n
    }

    COLUMN_FAMILY_2 {
        string Column_A_Name_Value_Timestamp
        string Column_B_Name_Value_Timestamp
    }

    ROW_KEY ||--o{ COLUMN_FAMILY_1 : "contains"
    ROW_KEY ||--o{ COLUMN_FAMILY_2 : "contains"

    %% 注意: 实际的每一行能够在列族内存储动态且数量庞大的列(例如将传感器的时间戳作为列名)。
代表性的宽列型数据库
- Apache Cassandra : 由 Facebook 开发,具备高可用性、可扩展性以及无主节点(Masterless)的分布式架构。
- Apache HBase : 作为 Hadoop 生态系统的一部分,构建在 HDFS 之上的巨大宽列存储。
- ScyllaDB : 兼容 Cassandra,但使用 C++ 重写,实现了数量级提升的吞吐量。
- Google Cloud Bigtable : 宽列存储鼻祖的全托管服务。
优缺点
优点:
- 写入吞吐量惊人地高 : 可以向数千至数万台服务器组成的集群中实现每秒数百万次的写入。
- 无单点故障(SPOF) : 在 Cassandra 等无主节点架构中,即使任何节点宕机,也能保持整个系统的运行。
- 地理位置分布(多数据中心) : 擅长跨多个数据中心进行实时数据复制。
缺点:
- 无法进行灵活的查询 : 由于数据是根据 Row Key(以及聚簇键)物理排列的,因此基本上无法使用非键列进行搜索或 JOIN(或者速度极慢)。必须采用根据访问模式来设计表的“查询驱动建模”。
- 学习成本 : 需要从 RDBMS 的规范化建模思维中转换过来,数据建模的难度较高。
用例
非常适合以基于特定键进行大量数据写入和精确读取为核心的超大规模系统。
- IoT 传感器数据 / 时间序列数据 : 持续记录从数百万台设备每秒发送过来的测量数据,使用设备 ID(Row Key)和时间(列名)。
- 大规模日志收集和分析 : 如网站点击流或系统访问日志等追加(Append-Only)类型的数据保存。
- 消息记录管理 : 聊天应用(如 Discord 等)的大规模历史消息存储。
- 用于个性化/推荐的特征库 : 快速读取用户过去的操作记录,将其传递给机器学习模型。
6. 多模型数据库的选项
近年来,通过单一数据库引擎集成并提供多种 NoSQL 模型或 RDBMS 功能的 多模型数据库 也备受关注。
例如,PostgreSQL 凭借其对 JSONB 类型的强大支持,具备了作为文档型数据库的功能。此外,像 Azure Cosmos DB 和 ArangoDB 等产品,也能够在同一个后端透明地处理 KVS、文档和图。这样一来,可以在抑制项目内管理多个数据库系统所带来的运维成本(混合持久化,Polyglot Persistence 的复杂性)的同时,实现符合需求的灵活数据访问。
7. 结论:基于用例的最佳选择
正如我们所看到的,NoSQL 并没有“银弹”。根据项目的需求选择合适的数据模型才是成功的关键。最后,总结一下简洁的选择指南。
- 是否需要用于会话管理或缓存等超高速的简单读写? 👉 选择 键值型(Redis, Memcached) 。
- 数据结构是否频繁变化,并希望原样保存和搜索复杂的 JSON 数据? 👉 选择 文档导向型(MongoDB, Firestore) 。
- 是否想瞬间探索和分析如“朋友的朋友”或“推荐路径”等数据间复杂的关系? 👉 选择 图数据库型(Neo4j) 。
- 是否想要写入每秒数万件级别的大量日志或 IoT 数据,并无限扩展? 👉 选择 宽列型(Cassandra, Bigtable) 。
- 是否必须严格保证数据一致性、复杂事务以及各种汇总(JOIN)? 👉 不要强行使用 NoSQL,老老实实选择 RDBMS(PostgreSQL, MySQL) 。
在现代大规模架构中,并非将所有数据保存在一个数据库中,而是为每个微服务采用最合适数据库的 混合持久化(Polyglot Persistence) 已成为主流。 各数据模型的优缺点,以及深刻理解与 RDBMS 的根本区别,便能设计出最大化发挥系统性能、可扩展性和可用性的最优数据库方案。