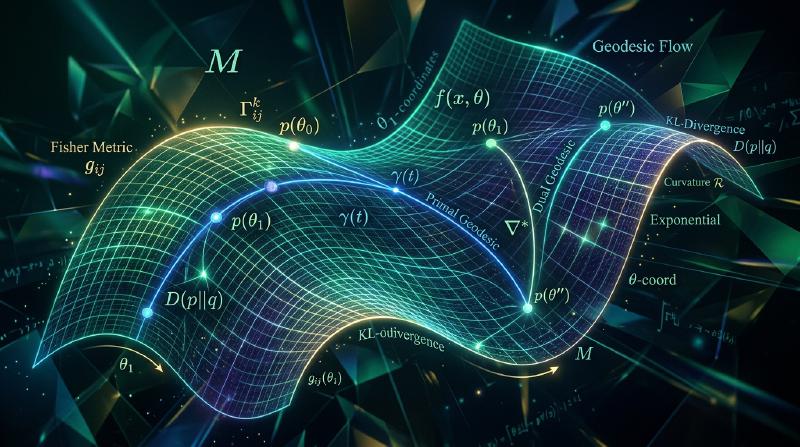
信息几何学(Information Geometry)是在概率分布形成的空间中引入微分几何学的结构,以几何学直观来揭示统计推断、机器学习和信息理论本质的源自日本的世界级理论。由甘利俊一博士等人系统化的该理论,目前已广泛应用于支撑AI和深度学习基础的自然梯度法(Natural Gradient Descent)、量子信息理论、统计物理学等广泛领域,正在确立其作为现代科学中“共通语言”的地位。
本文将结合数学的严密性、几何学的直观性以及具体的计算实例,尽可能详细且系统地解说信息几何学这个深奥的世界。我们不会仅仅停留在数学公式的罗列上,而是从“为什么概率分布的空间是弯曲的”、“为什么费舍尔信息矩阵会成为度量张量”这些根本性问题出发,涵盖对偶联络、熵的几何学,直到其在最前沿的机器学习和神经科学中的应用,描绘出信息几何学的全貌。
第1章:信息几何学的黎明与甘利俊一的直觉
从欧几里得空间的统计到概率分布的弯曲空间
在古典的统计学和数据分析中,我们在无意识中将数据作为欧几里得空间上的点来处理。例如,当考虑具有参数 $\theta = (\theta_1, \theta_2, \dots, \theta_n)$ 的统计模型时,通常会将参数空间视为平坦空间,并经常使用普通的欧几里得距离来测量参数之间的距离。最小化平方误差的最小二乘法等也是基于这种欧几里得几何学的直觉。
然而,参数化概率分布的空间,真的“平坦”吗?
让我们以正态分布 $N(\mu, \sigma^2)$ 为例。参数空间是由均值 $\mu$ 和方差 $\sigma^2 > 0$ 组成的上半平面 $\{(\mu, \sigma^2) \in \mathbb{R} \times \mathbb{R}_{>0}\}$。在这里,我们考虑两组正态分布。
- $N(0, 1)$ 和 $N(0.1, 1)$
- $N(0, 100)$ 和 $N(0.1, 100)$
如果从参数的欧几里得距离来看,两组的距离都是等同的 $0.1$。但是,从作为概率分布的“可辨识性”或“信息差异”的观点来看会怎样呢? 当方差较小为 $1$ 时,均值仅偏移 $0.1$ 就会使分布的形状发生显著变化,从数据中区分两者是相对容易的。另一方面,当方差极大为 $100$ 时,分布变得非常平坦宽广,即使均值偏移了 $0.1$,分布的重叠部分也依然非常大,从数据中区分两者极其困难。
也就是说,“分布本身的差异”与参数的欧几里得距离并不一致。在方差较大的区域,均值的微小变化对分布的形状几乎没有影响,反之,在方差较小的区域则会带来剧烈的变化。这强烈暗示了概率分布的参数空间并不是均匀的,而是根据位置不同“距离尺度不同的弯曲空间(黎曼流形)”。
为什么概率分布族是流形
信息几何学将统计模型(概率分布的族)形式化为可微流形(Differentiable Manifold)。
假设某概率空间 $\mathcal{X}$ 上的概率分布族为 $S$。当该族被 $n$ 个连续实数参数 $\theta = (\theta^1, \dots, \theta^n)$ 唯一指定,且概率密度函数 $p(x; \theta)$ 关于 $\theta$ 光滑时,我们将 $S$ 称为 $n$ 维的统计流形(Statistical Manifold)。
$$ S = \{ p(x; \theta) \mid \theta \in \Theta \subset \mathbb{R}^n \} $$在此,$\theta$ 无外乎是流形 $S$ 上的“局部坐标系(Local Coordinate System)”。在流形理论中,坐标系并非本质性的事物,仅仅是表现形式之一。例如在正态分布的情况下,我们可以选择 $(\mu, \sigma^2)$ 作为参数,也可以选择 $(\mu, \sigma)$ 或者 $(\frac{\mu}{\sigma^2}, -\frac{1}{2\sigma^2})$。
信息几何学的精髓在于阐明“不依赖于坐标系选取方式的、概率分布族自身所具有的内在几何结构”。甘利俊一在C.R. Rao提出的“以费舍尔信息矩阵为度量的黎曼流形”概念的基础上进一步深化,通过引入仿射联络(Affine Connection)的概念,在概率分布的空间中不仅发现了“弯曲程度(曲率)”,还发现了“直线的概念(测地线)”与“对偶性”这种丰富的结构。
第2章:作为黎曼流形的统计模型
要在流形上定义“距离”和“角度”,需要黎曼度量(Riemannian Metric)。那么,统计流形中自然的黎曼度量是什么呢?
评分函数与费舍尔信息矩阵
在统计学中,对数似然函数 $\log p(x; \theta)$ 关于参数的偏导数被称为“评分函数(Score Function)”,发挥着重要的作用。
$$ \partial_i \ell(x; \theta) = \frac{\partial}{\partial \theta^i} \log p(x; \theta) $$$$ E_\theta[\partial_i \ell(x; \theta)] = \int \frac{\partial p(x; \theta)}{\partial \theta^i} dx = \frac{\partial}{\partial \theta^i} \int p(x; \theta) dx = 0 $$$$ g_{ij}(\theta) = E_\theta \left[ \partial_i \ell(x; \theta) \partial_j \ell(x; \theta) \right] $$C.R. Rao (1945) 注意到该费舍尔信息矩阵是满足张量变换法则的正定对称矩阵,并提议将其采用为统计流形的黎曼度量(费舍尔度量)。
$$ ds^2 = \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$由此,统计模型便成为了黎曼流形 $(S, G)$。两个相近的概率分布 $p(x; \theta)$ 和 $p(x; \theta + d\theta)$ 之间微小的“距离平方”,即可由该费舍尔度量来衡量。
作为不变度量的切恩佐夫定理
为什么应该选择费舍尔信息矩阵作为度量呢?这并非仅仅是心血来潮,其背后有着深刻的数学必然性。
N.N. Chentsov (1972) 形式化了在统计推断框架中所要求的“不变性(Invariance)”。统计推论的结果不应因数据的表达方式或向充分统计量的转换(马尔可夫映射)而改变。 切恩佐夫定理表明了一个惊人的事实:“在由有限集合上的概率分布构成的流形中,在马尔可夫映射下满足单调性(收缩性)的黎曼度量,除了常数倍之外,仅限于费舍尔信息度量。”
也就是说,在概率分布的空间中,满足“信息不减少”这一自然的统计学要求的距离测量方式,只存在费舍尔度量。这证明了费舍尔度量是统计学特有的、内在且必然的几何结构。
正态分布族中费舍尔度量的具体计算实例
$$ p(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) $$$$ \log p = -\log(\sqrt{2\pi}) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2} $$$$ \partial_\mu \log p = \frac{x-\mu}{\sigma^2}, \quad \partial_\sigma \log p = -\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3} $$$$ g_{\mu\mu} = E\left[ \left(\frac{x-\mu}{\sigma^2}\right)^2 \right] = \frac{1}{\sigma^2} $$$$ g_{\sigma\sigma} = E\left[ \left(-\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3}\right)^2 \right] = \frac{2}{\sigma^2} $$$$ g_{\mu\sigma} = g_{\sigma\mu} = 0 $$$$ ds^2 = \frac{1}{\sigma^2} d\mu^2 + \frac{2}{\sigma^2} d\sigma^2 $$这与亨利·庞加莱(Henri Poincaré)提出的双曲几何学(一种非欧几里得几何学)模型——庞加莱上半平面的度量(除常数倍的区别外)完全一致。也就是说,我们可以得知正态分布的空间是具有负常曲率的双曲空间。 正如先前的直觉一样,在 $\sigma$ 较大(方差较大)的区域,度量张量 $1/\sigma^2$ 变小,参数的变动作为“距离”被评估得较小,这一点从数学公式上也得到了印证。
第3章:对偶联络与 $\alpha$-联络的深渊
仅仅依靠黎曼度量,无法完全描述空间的“弯曲程度”。还需要决定“哪个方向是笔直的”仿射联络(Affine Connection)。甘利俊一最大的功绩在于,他发现在统计流形中存在着无限多个自然的联络,并且这些联络构成了被称为“对偶性(Duality)”的优美结构。
$\alpha$-联络的定义
甘利使用了实数参数 $\alpha$,引入了被称为 $\alpha$-联络的仿射联络族。其联络系数 $\Gamma_{ij,k}^{(\alpha)}$ 定义如下。
$$ \Gamma_{ij,k}^{(\alpha)} = E \left[ \left( \partial_i \partial_j \ell + \frac{1 - \alpha}{2} \partial_i \ell \partial_j \ell \right) \partial_k \ell \right] $$当 $\alpha = 0$ 时的 $0$-联络,与由费舍尔度量唯一确定的列维-奇维塔联络(Levi-Civita Connection)相一致。这是普通的黎曼几何学中使用的联络。然而,在信息几何学中发挥最重要作用的是 $\alpha = 1$ 和 $\alpha = -1$ 的联络。
e-联络与 m-联络,以及对偶平坦空间
- e-联络($\alpha = 1$ 指数联络): 在处理指数型分布族(Exponential Family)时自然出现的联络。
- m-联络($\alpha = -1$ 混合联络): 在处理混合型分布族(Mixture Family)时自然出现的联络。
这两个联络关于费舍尔度量 $g_{ij}$ 处于“对偶(Dual)”关系。在黎曼流形中,当两个向量场的内积(度量)的微分可以表示为它们各自联络的协变导数之和时,它们就被称为对偶联络。
$$ X \langle Y, Z \rangle = \langle \nabla_X^{(e)} Y, Z \rangle + \langle Y, \nabla_X^{(m)} Z \rangle $$值得一提的事实是,指数型分布族(例如正态分布、泊松分布、伽马分布等)的空间,关于 e-联络是“平坦的(曲率张量为零)”,同时关于 m-联络也是“平坦的”。这样的空间被称为对偶平坦空间(Dually Flat Space)。
在对偶平坦空间中,存在关于 e-联络笔直的线(e-测地线),以及关于 m-联络笔直的线(m-测地线)。此外,在这些空间中,作为参数系,存在通过勒让德变换(Legendre Transformation)相互连接的对偶坐标系(自然参数 $\theta$ 和期望值参数 $\eta$)。
广义毕达哥拉斯定理
对偶平坦空间之美,集中体现在“广义毕达哥拉斯定理(Generalized Pythagorean Theorem)”中。
在欧几里得空间中,当3点 $P, Q, R$ 构成 $\angle PQR = 90^\circ$ 的直角三角形时,$d(P, R)^2 = d(P, Q)^2 + d(Q, R)^2$ 成立。 在信息几何学的对偶平坦空间中,当连接点 $P, Q, R$(概率分布)的曲线由 e-测地线和 m-测地线组成,并且它们在点 $Q$ 处在费舍尔度量的意义上“正交”时,关于分布之间的散度(非对称的距离概念),下式严格成立。
$$ D(P \parallel R) = D(P \parallel Q) + D(Q \parallel R) $$这一定理在几何学上完美地解释了统计学中的信息量准则、机器学习中EM算法的收敛性以及投影定理(Information Projection),可以说是信息几何学的一座金字塔般的成果。
第4章:散度与熵的几何学
黎曼几何学中的距离是对称的($d(x, y) = d(y, x)$),但在信息理论中,概率分布之间“差异”的尺度通常是非对称的。信息几何学将这种非对称的距离“散度(Divergence)”与对偶平坦空间的几何结构绝妙地结合在了一起。
库尔贝克-莱布勒信息量(KL散度)
$$ D_{KL}(P \parallel Q) = \int p(x) \log \frac{p(x)}{q(x)} dx $$KL散度不满足距离的公理(它是非对称的,也不满足三角不等式)。但是,在点 $Q$ 无限接近点 $P$ 的极限下,KL散度泰勒展开的二次项准确地与费舍尔信息矩阵相一致。
$$ D_{KL}(\theta \parallel \theta + d\theta) \approx \frac{1}{2} \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$也就是说,KL散度是宏观的非对称距离,其微观的极限(无限小距离)诱导了费舍尔度量(黎曼几何学)。
布雷格曼散度与勒让德变换
在对偶平坦空间中,散度被形式化为更一般的“布雷格曼散度(Bregman Divergence)”。 考虑凸函数 $\psi(\theta)$(对应于累积量母函数或自由能)。布雷格曼散度 $D_\psi(\theta_P \parallel \theta_Q)$ 被定义为在点 $\theta_Q$ 处的凸函数切平面,与在点 $\theta_P$ 处的凸函数值之间的“误差”。
$$ D_\psi(\theta_P \parallel \theta_Q) = \psi(\theta_P) - \psi(\theta_Q) - \sum_i (\theta_P^i - \theta_Q^i) \frac{\partial \psi(\theta_Q)}{\partial \theta^i} $$$$ \eta_i = \frac{\partial \psi(\theta)}{\partial \theta^i}, \quad \phi(\eta) = \sum_i \theta^i \eta_i - \psi(\theta) $$在信息几何学中,KL散度本身就是指数型分布族上的布雷格曼散度,并且通过使用对偶参数 $\theta$(自然参数)和 $\eta$(期望值参数),散度可以使用对偶函数 $\psi, \phi$ 写成极其对称且优美的典范形式(Canonical form)。
$$ D(P \parallel Q) = \psi(\theta_P) + \phi(\eta_Q) - \sum_i \theta_P^i \eta_Q^i $$这个数学公式如实地说明了,信息几何学并不仅仅是微分几何学的应用,而是与勒让德变换和凸分析深度结合的“信息理论固有的几何学”。
第5章:深度学习与自然梯度下降法
信息几何学不仅停留在理论上的优美,在现代的AI,尤其是深度学习(Deep Learning)中也发挥了极其具有实践意义的威力。其最典型的例子就是“自然梯度下降法(Natural Gradient Descent; NGD)”。
普通梯度下降法的局限性
$$ w_{t+1} = w_t - \eta \nabla L(w_t) $$然而,普通的梯度 $\nabla L$ 建立在参数空间是“平坦的欧几里得空间”的假设之上。正如我们在第1章中所看到的,神经网络所表达的概率模型的参数空间是由费舍尔度量弯曲了的黎曼流形。 欧几里得空间的梯度(最速下降方向)在黎曼流形上并不等于真正的最速下降方向。因此,学习轨迹会因参数的尺度或坐标变换而发生巨大变化,频繁出现导致优化效率显著降低的“平台期(学习停滞)”现象。
基于费舍尔度量的参数更新:自然梯度法
1998年,甘利俊一提出了黎曼流形上真正的最速下降方向,即“自然梯度(Natural Gradient)”。流形上的梯度 $\tilde{\nabla} L$ 是将普通梯度 $\nabla L$ 乘以费舍尔信息矩阵的逆矩阵 $F^{-1}$ 得到的。
$$ \tilde{\nabla} L(w) = F(w)^{-1} \nabla L(w) $$$$ w_{t+1} = w_t - \eta F(w_t)^{-1} \nabla L(w_t) $$自然梯度法通过考虑参数空间的曲率(费舍尔信息矩阵),实现了不依赖于参数选取方式(坐标系)的不变学习。由此,即使损失函数的等高线是像扭曲的谷底一样的地形,也能直线奔向最优解,从而使学习速度获得飞跃性的提升。这与牛顿法等二阶优化方法相似,但在使用保证了半正定性的费舍尔信息矩阵来替代海森矩阵(Hessian Matrix)这一点上,可以说是针对概率模型优化过的方法。
基于 K-FAC 的近似计算的实现与突破
虽然自然梯度法在理论上非常强大,但应用于深度学习却存在着巨大的障碍。在拥有几千万到几百亿参数的现代神经网络中,计算巨大的费舍尔信息矩阵 $F$(大小为 $N \times N$)并求其逆矩阵,从计算量的角度来看是令人绝望的($O(N^3)$)。
解决这一问题的是 James Martens 和 Roger Grosse 等人在2015年提出的名为 K-FAC (Kronecker-factored Approximate Curvature) 的方法。 他们证明了,神经网络层间参数的费舍尔信息矩阵,可以通过输入协方差矩阵和输出梯度协方差矩阵的“克罗内克积(Kronecker Product)”进行高精度的近似。
$$ F_{layer} \approx A \otimes S $$(这里 $A$ 是激活值的协方差,$S$ 是预激活梯度的协方差)
通过利用克罗内克积的性质 $(A \otimes S)^{-1} = A^{-1} \otimes S^{-1}$,成功地将巨大矩阵的求逆计算分解为了小得多矩阵的求逆计算,从而极大地削减了计算成本(从 $O(N^3)$ 降至 $O(n^3)$,$n$ 是层的宽度)。得益于 K-FAC 的实现,自然梯度法能在现实可接受的计算时间内应用于大规模深度学习模型(如 ResNet 或 Transformer 等),并在分布式学习环境中被证实表现出极其高速的收敛。这是信息几何学突破AI极限的历史性瞬间。
第6章:向统计物理学、量子信息、神经科学的扩展
信息几何学的通用性并不局限于统计学和机器学习。其底层的“概率与信息的几何学”已经波及了许多科学领域。
量子信息几何学
处理经典概率分布的信息几何学,自然地扩展到了处理量子力学中“密度矩阵(Density Matrix)”的量子信息几何学(Quantum Information Geometry)。 在量子系统中,由于观测量的不对易性(算符结果因顺序而异),相当于费舍尔度量的指标并非唯一确定。取而代之的是,存在 Bures 度量(SLD 费舍尔信息量)、Kubo-Mori-Bogoliubov 度量等多个黎曼度量,它们各自具有不同的物理和信息论意义。量子信息几何学作为量子计算机和量子通信的理论基础正在迅速发展,涉及量子状态估计精度的极限(量子克拉美-劳不等式)、量子纠缠(Entanglement)的几何学解释以及量子算法优化等领域。
自由能原理与神经科学(预测编码)
在脑神经科学领域,卡尔·弗里斯顿(Karl Friston)提出的**自由能原理(Free Energy Principle; FEP)**假设,大脑是一个以最小化“意外感(Surprise)”来推断知觉与行为的系统。 这个推论过程被形式化为变分贝叶斯推断(Variational Bayesian Inference),并归结为最小化大脑内内部模型的概率分布与外部环境真实分布之间的 KL 散度(变分自由能)的最优化问题。
从信息几何学的视角来看,大脑可以被解释为在概率分布流形上沿着散度梯度(即自然梯度)运动的动力学系统。知觉(内部状态的更新)和行动(对外部环境的作用),被优美地描述为对偶平坦空间中 e-投影和 m-投影的迭代算法。信息几何学为揭开智能的根本机制提供了数学语言。
作为现代数学的前沿
从纯粹数学的观点来看,信息几何学也提供了一种新的范式。它与仿射微分几何学、黑塞(Hesse)几何学、辛(Symplectic)几何学之间的深刻联系正在被逐渐解明。特别是,Wasserstein 几何学(最优传输理论)与信息几何学的整合,是当前数学及机器学习领域最热门的研究课题之一。KL 散度(信息几何)测量“信息”的移动,而 Wasserstein 距离则测量“质量”的移动。融合这两种几何学的尝试,直接关乎深度生成模型(扩散模型和 GAN)的理论解明。
结语:信息交织出的宇宙形状
甘利俊一从“统计模型是不是弯曲的?”这一直觉中孕育出的信息几何学,如今已超越了统计学的框架,成长为连接机器学习、量子物理学、神经科学的宏大理论体系。 通过将概率分布不仅仅看作函数,而是捕捉为几何学的“空间”,我们能够以视觉方式理解信息的运动、学习的轨迹以及智能的本质。
费舍尔信息度量所教授的“信息弯曲程度”。 对偶联络所导出的“广义毕达哥拉斯定理”。 还有,自然梯度法所开辟的“AI的高速进化”。
信息几何学,将继续成为我们从名为数据的群星中,寻找出名为真理的星座的最为洗练的“指南针”。对这个既美丽又深奥的黎曼流形的探索,才刚刚开始。