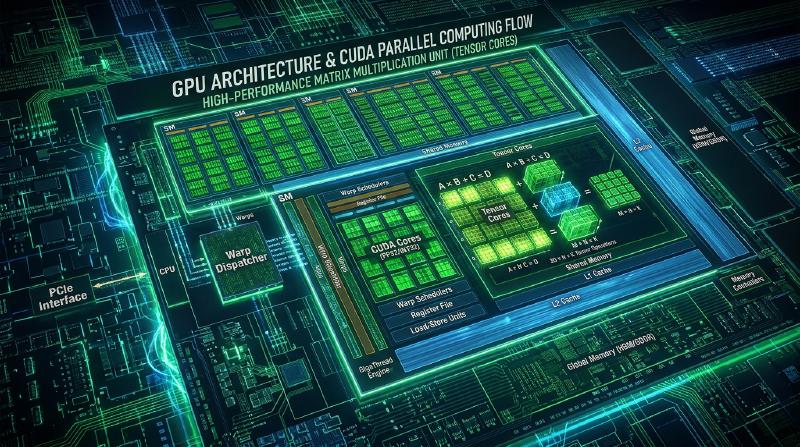
GPU的超大规模并行架构与CUDA物理学:SIMT、Warp与Tensor Core的计算原理
支撑现代高级计算科学、人工智能、深度学习(Deep Learning)以及高清晰度计算机图形学的核心技术,正是GPU(Graphics Processing Unit,图形处理器)。本文将深入剖析GPU架构以及在其上运行的并行计算基础架构CUDA(Compute Unified Device Architecture)的物理与硬件层面。这不仅仅是编程语法,我们将从流式多处理器(SM)、SIMT执行模型、Warp调度、Tensor Core以及内存层次结构的视角,彻底解剖硬件“为何如此设计”以及“如何爆发出极限的计算吞吐量”。
第1章:CPU与GPU设计理念的分水岭
1.1 追求低延迟 vs 追求高吞吐量
作为通用处理器的CPU(Central Processing Unit)与专为并行计算设计的GPU,从其诞生背景来看,设计理念就有着根本的不同。CPU的进化始终将“如何更快地完成单个任务(线程)”即“低延迟(最小化延迟)”作为首要目标。而GPU则追求“将大量任务捆绑在一起,整体上单位时间内能完成多少处理量”的“高吞吐量(处理量最大化)”。
CPU需要迅速处理操作系统的控制、带有复杂分支条件的应用程序执行、来自用户的随机中断处理等不可预测的任务。因此,它搭载了高级的分支预测电路、乱序执行(改变指令顺序执行的机制)以及庞大的L1/L2/L3缓存内存,在隐藏内存访问延迟的同时,将单线程的性能提升到极致。
相比之下,GPU最初是为了处理诸如对屏幕上数百万像素应用相同着色计算等高度可并行的任务而诞生的。它没有将芯片面积浪费在复杂的控制电路或巨大的缓存上,而是选择将简单的运算单元(ALU: Arithmetic Logic Unit)铺满到极限。
1.2 芯片面积中缓存、控制电路与ALU的分配比例
如何分配硅片(半导体芯片)有限的面积(晶体管预算),决定了两者架构的差异。
- CPU的芯片面积分配: 芯片一半以上的面积被大容量缓存内存(SRAM)和高级控制电路(分支预测、指令提取、解码、调度等)所占据。实际执行运算的ALU所占比例相对较小。
- GPU的芯片面积分配: 缓存内存和控制电路被控制在最小限度,芯片的绝大部分被数千甚至数万个ALU(CUDA核心)所占据。
GPU并不是依靠缓存来隐藏内存访问的延迟(Latency),而是通过“上下文切换”来隐藏。当某一组线程正在等待来自内存的数据到达时,立即执行另一组线程的运算,从而使运算器始终保持在工作状态(高占用率:Occupancy)。这就是GPU“追求高吞吐量”的物理实现。因为硬件级别的多线程(Hardware Multithreading)执行得极其轻量,所以它的前提是存在数千至数万个并发线程。
第2章:SIMT执行模型的本质
2.1 SIMD与SIMT的区别
作为并行处理的分类,有弗林分类法(Flynn’s taxonomy),GPU的执行模型经常被拿来与SIMD(Single Instruction, Multiple Data)进行比较。CPU的向量扩展指令(如AVX等)是纯粹的SIMD,一条指令同时处理多个数据(例如存储在256位宽寄存器中的8个32位浮点数)。在SIMD中,针对数据的每个元素执行不同的分支(if-else)是非常困难的。
另一方面,NVIDIA提出的CUDA执行模型被称为SIMT(Single Instruction, Multiple Threads)。在SIMT中,多个独立的“线程”形成一个组(后文所述的“Warp”),共享并执行相同的指令。然而,与SIMD不同,SIMT的每个线程都拥有独立的寄存器状态和指令地址计数器(在编程模型上)。这使得程序员能够像每个线程都在独立运行一样来编写代码。
2.2 以32个线程为单位的“Warp”
GPU的硬件并不单独调度线程,而是将**32个线程作为一个整体的“Warp”**单位进行管理和执行。(在AMD的GPU中被称为Wavefront,有时也采用64个线程为单位)。
流式多处理器(SM)内的指令提取和解码单元,以Warp为单位提取一条指令,并将相同的指令发射(调度)给Warp内的所有32个线程。也就是说,Warp内的32个线程,在物理上是完全同时、针对各自拥有的不同数据执行相同的指令。这就是SIMT的核心。
2.3 Warp Divergence(分支发散)的物理惩罚
尽管可以表现得如同每个线程都有独立的程序计数器,但在物理上,Warp内的所有线程必须执行相同的指令。那么,如果代码中存在像 if-else 这样的条件分支,而Warp内的线程在分支条件的真假上产生了分歧,会发生什么呢?
这种现象被称为Warp Divergence(分支发散)。
当发生Warp Divergence时,硬件会按以下步骤进行处理:
- 首先,仅对
if条件为真的线程(活跃线程)执行指令。此时,条件为假的线程会被“掩码(无效化)”,运算结果不会被写入。 - 接下来,转移到
else条件(或者条件为假时的路径),此时将刚才被掩码的线程激活,将原本为真的线程掩码并执行指令。
也就是说,当存在多个分支路径时,硬件不得不将这些路径串行(而非并行)地执行。作为一个极端的例子,如果Warp内的32个线程走向了32条不同的分支路径,执行时间将飙升至32倍。Warp Divergence是导致GPU计算吞吐量骤减的最大原因之一,也是在算法设计中最应该避免的反模式。在物理上,这意味着尽管ALU消耗了电力,但由于被掩码,并未生成有效的计算结果,产生了“无效周期”。
第3章:流式多处理器(SM)的硬件解剖
GPU是由大量**流式多处理器(SM: Streaming Multiprocessor)**集合而成的。SM才是GPU真正的计算引擎。在最新的架构(例如:Hopper H100)中,单个GPU芯片上搭载了100多个SM。
3.1 SM内部的流水线构成
SM内部进一步被划分为多个子分区(通常是4个),每个分区拥有独立的Warp调度器和调度单元。
- Warp调度器(Warp Scheduler): 选择处于可执行状态(寄存器和内存已准备就绪的状态)的Warp。GPU的调度器能够以零开销切换Warp,这是隐藏内存访问延迟的关键。
- 调度单元(Dispatch Unit): 向被调度的Warp发射指令。
- CUDA核心(INT32 / FP32 / FP64 ALU): 负责实际整数运算和浮点运算的单元。
- 加载/存储单元(LD/ST Unit): 负责对内存的读写。
- 特殊功能单元(SFU): 专用于高速计算sin、cos、exp、倒数等超越函数的硬件。
指令流水线被设计得非常深,具有提取、解码、调度、寄存器读取、执行(多个周期)、写回等各个阶段。FP32的FMA(Fused Multiply-Add)运算的延迟通常需要几个到十几个周期,但通过每个周期从不同的Warp发射指令,能够使流水线始终保持满载。
3.2 庞大的寄存器文件与寄存器压力
SM搭载了CPU无法比拟的庞大寄存器文件(例如:每个SM 64KB〜256KB的SRAM)。这是为了保存SM上并发执行的数千个线程的所有上下文。
上下文切换之所以能在零周期内完成,是因为不需要将线程的寄存器状态保存(溢出)到内存中。然而,如果每个线程使用的寄存器数量增加,SM内能够同时启动的Warp数量(占用率)就会下降。这被称为寄存器压力(Register Pressure)。一旦寄存器耗尽,数据就会溢出到低速的本地内存(物理上是全局内存的一部分)中,导致毁灭性的性能下降。
3.3 共享内存(Shared Memory)与Bank冲突
SM中存在程序员可显式控制的超高速片上内存,即共享内存(Shared Memory)。它与L1缓存共享同一块物理SRAM区域,但作为显式的数据缓存发挥作用,用于块内线程间的数据共享和同步。
共享内存的物理结构被划分为多个独立的模块(通常为32个),称为内存Bank(Memory Banks)。连续的32位地址被交错(分配)到不同的Bank中。
当Warp内的32个线程同时访问不同的Bank时,访问将被完全并行(在1个周期内)处理。这被称为无Bank冲突(Bank-conflict free)。 然而,当多个线程试图同时访问同一个Bank的不同地址时,请求将被串行化,产生惩罚(延迟)。这被称为Bank冲突(Bank Conflict)。例如,2路的Bank冲突会使访问时间变为2倍,最坏情况下32路的冲突会造成32倍的延迟。在矩阵转置等算法中,步幅访问会导致严重的Bank冲突,因此必须使用填充(Padding,插入虚拟数据以错开内存地址的技术)来进行高级优化以避免冲突。
第4章:Tensor Core的乘加运算流水线
在Volta架构中首次引入,并极大提升了后续GPU性能的革命性硬件就是Tensor Core(张量核心)。AI和深度学习的爆发式发展,离不开Tensor Core。
4.1 矩阵乘加运算(MMA)的硬件实现
深度学习计算的绝大部分是神经网络权重矩阵与输入数据的矩阵乘法(GEMM: General Matrix Multiply)。计算公式表示为 $D = A \times B + C$ ($A, B$ 为输入矩阵,$C$ 为累加器矩阵)。
在传统的CUDA核心中,这种矩阵乘法是使用FMA(Fused Multiply-Add)指令逐元素计算的。相比之下,Tensor Core是在硬件层面上只需1个(或几个)周期就能执行小型矩阵(例如:4x4或16x16)乘加运算的专用电路。
在物理上,数十到数百个乘法器与巨大的加法树通过导线直连,在不将中间结果写回寄存器的情况下,一口气完成乘加。因此,与普通的CUDA核心相比,单位面积的运算吞吐量(TFLOPS)有着数量级的提高。
4.2 混合精度(Mixed-Precision)的奥秘
Tensor Core的另一个精髓在于对**混合精度(Mixed-Precision)**运算的支持。 在深度学习的计算过程中,有很多场合不需要高精度(FP32/FP64)。Tensor Core拥有这样的流水线:以低精度(FP16, BF16,或者更低的FP8, INT8, INT4)读取输入矩阵 $A$ 和 $B$,在内部进行低精度的乘法运算后,以更高精度(FP32或INT32)执行加法(累加)过程。
- FP16 / BF16: 训练的标准。BF16(Bfloat16)的指数部分与FP32一样有8位,动态范围广,因此容易防止梯度消失。
- FP8 / INT8 / INT4: 加速推理(Inference)的王牌。由于数据传输量(内存带宽)也减少了,吞吐量得到了显著提升。
在Hopper架构中,引入了能够极大加速Transformer模型计算的“FP8 Tensor Core”,与FP32相比,理论上实现了数十倍的吞吐量。在软件端(CUDA),通过 wmma(Warp-Level Matrix Multiply and Accumulate)API或 mma.sync PTX指令直接驱动Tensor Core,Warp内的线程协同工作,将矩阵片段加载到寄存器、进行运算、然后存储,这是一种极其复杂的集体处理。
第5章:CUDA内存层次结构与优化技术
无论GPU的计算能力有多高,一旦数据供应成为瓶颈,性能就无法发挥(内存墙问题)。在CUDA编程中,90%的优化可以说是“内存访问优化”,这并不夸张。
5.1 全局内存的合并访问
作为GPU主内存(HBM或GDDR)的全局内存拥有极宽的带宽(例如几TB/s),但延迟也非常大,可达数百个周期。
最大化全局内存访问效率的绝对原则是合并(Coalescing)。 GPU的内存控制器以32字节、64字节或128字节单位的事务对内存进行访问。当Warp内的32个线程访问内存时,如果它们的内存地址都位于连续的区域内(在对齐的128字节边界内),硬件会将这些请求合并(Coalesce)为1次内存事务进行处理。
相反,如果线程访问随机的地址,或者进行跨步(间隔的)访问,则不会进行合并,会产生多个事务。这被称为“非合并访问”,它是一种致命的性能Bug,会将有效内存带宽降低至原来的十分之一以下。
5.2 CUDA C++代码示例:矩阵转置的优化与共享内存
以下是一个经过优化的矩阵转置(Matrix Transpose)内核代码示例,它避免了非合并访问,并利用共享内存显著提高了性能。
| |
这段代码有3个要点:
- 读取时的合并: 从
idata的读取在X方向上threadIdx.x是连续的,因此能够被完全合并。 - 写入时的合并: 对
odata的写入,也通过交换块坐标,设计为沿threadIdx.x方向连续,从而实现合并。 - 共享内存中的填充: 通过偏移1个元素(填充)
tile[TILE_DIM][TILE_DIM + 1],完全消除了在写入时按列方向(tile[threadIdx.x][threadIdx.y + j])访问时产生的Bank冲突。
5.3 缓存层次与特殊内存
- L1/L2缓存策略: 在较新的GPU架构中,程序员可以使用PTX指令(如
.ca,.cg,.cs等)来作为提示控制缓存的行为。例如,只访问一次的数据可以绕过L2缓存(流式访问),以防止缓存污染。 - 纹理内存 / 常量内存: 专用于图像处理的纹理内存,利用专用缓存来处理具有2D空间局部性的访问。常量内存对于所有线程读取相同常量的广播访问具有极高的效率。
第6章:深度学习时代下GPU的未来
当前计算科学的前沿不仅在于提升单个GPU的性能,更在于整个系统的扩展。
6.1 通过NVLink和NVSwitch实现的超高速互连
巨大的LLM(大语言模型)无法放入单个GPU的内存(例如80GB或144GB)中。为了进行模型并行化(张量并行或流水线并行),需要在GPU之间每秒传输太字节级的数据。 由于传统的PCIe(PCI Express)总线无法提供如此大的带宽,NVIDIA开发了名为NVLink的专有高速互连技术。此外,通过使用名为NVSwitch的交换芯片,可以将8个或256个GPU结合在一个完全无阻塞的交叉开关中,构建出一个仿佛单一巨大GPU般运行的集群。
6.2 Transformer Engine与FP8生态系统
为了优化不仅在自然语言处理,而且在图像和语音识别领域也已成为事实标准的Transformer架构,Hopper架构搭载了名为Transformer Engine的专用硬件与软件协同机制。 它动态监控张量的统计信息,自动在每一层切换FP8和FP16的计算精度(Dynamic Scaling),从而在防止精度下降的同时,实现极限的计算速度并节省内存带宽。
6.3 GPU集群的缩放定律与未来展望
正如OpenAI的“缩放定律(Scaling Laws)”所揭示的,模型的参数量和计算量增加得越多,AI的性能就持续提升。伴随这一趋势,GPU已经从单纯的处理器,进化成了由光纤连接数万个节点的“数据中心本身就是一台巨大的GPU(超级计算机)”。
未来的架构演进,将朝着引入硅光子学(光互连)、CPO(Co-Packaged Optics),以及SRAM到HBM 3D堆叠技术的进一步高级化迈进。然而,“通过并行处理最大化吞吐量”这一GPU诞生时未曾改变的DNA,将继续开拓计算科学的最前沿。
【追加论述】GPU中调度与占用率的数学分析
title: “图形运算处理器的超大规模并行架构与CUDA物理学:SIMT、Warp与Tensor Core的计算原理” description: “将高吞吐量追求到极致的图形运算处理器内部设计。SM、Warp调度、Tensor Core以及共享内存优化的精髓。” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
图形运算处理器的超大规模并行架构与CUDA物理学:SIMT、Warp与Tensor Core的计算原理
支撑现代高级计算科学、人工智能、深度学习(Deep Learning)以及高清晰度计算机图形学的核心技术,正是图形运算处理器(Graphics Processing Unit)。本文将深入剖析图形运算处理器的架构以及在其上运行的并行计算基础架构CUDA(Compute Unified Device Architecture)的物理与硬件层面。这不仅仅是编程语法,我们将从流式多处理器(SM)、SIMT执行模型、Warp调度、Tensor Core以及内存层次结构的视角,彻底解剖硬件“为何如此设计”以及“如何爆发出极限的计算吞吐量”。
补充第1章的说明:通用运算处理器与图形运算处理器设计理念的分水岭
1.1 追求低延迟 vs 追求高吞吐量
作为通用处理器的通用运算处理器(Central Processing Unit)与专为并行计算设计的图形运算处理器,从其诞生背景来看,设计理念就有着根本的不同。通用运算处理器始终将“如何更快地完成单个任务(线程)”即“低延迟(最小化延迟)”作为首要目标。而图形运算处理器则追求“将大量任务捆绑在一起,整体上单位时间内能完成多少处理量”的“高吞吐量(处理量最大化)”。
通用运算处理器需要迅速处理操作系统的控制、带有复杂分支条件的应用程序执行、来自用户的随机中断处理等不可预测的任务。因此,它搭载了高级的分支预测电路、乱序执行(改变指令顺序执行的机制)以及庞大的L1/L2/L3缓存内存,在隐藏内存访问延迟的同时,将单线程的性能提升到极致。
相比之下,图形运算处理器最初是为了处理诸如对屏幕上数百万像素应用相同着色计算等高度可并行的任务而诞生的。它没有将芯片面积浪费在复杂的控制电路或巨大的缓存上,而是选择将简单的运算单元(ALU: Arithmetic Logic Unit)铺满到极限。
1.2 芯片面积中缓存、控制电路与ALU的分配比例
如何分配硅片(半导体芯片)有限的面积(晶体管预算),决定了两者架构的差异。
- 通用运算处理器的芯片面积分配: 芯片一半以上的面积被大容量缓存内存(SRAM)和高级控制电路(分支预测、指令提取、解码、调度等)所占据。实际执行运算的ALU所占比例相对较小。
- 图形运算处理器的芯片面积分配: 缓存内存和控制电路被控制在最小限度,芯片的绝大部分被数千甚至数万个ALU(CUDA核心)所占据。
图形运算处理器并不是依靠缓存来隐藏内存访问的延迟(Latency),而是通过“上下文切换”来隐藏。当某一组线程正在等待来自内存的数据到达时,立即执行另一组线程的运算,从而使运算器始终保持在工作状态(高占用率:Occupancy)。这就是图形运算处理器“追求高吞吐量”的物理实现。因为硬件级别的多线程(Hardware Multithreading)执行得极其轻量,所以它的前提是存在数千至数万个并发线程。
补充第2章的说明:SIMT执行模型的本质
2.1 SIMD与SIMT的区别
作为并行处理的分类,有弗林分类法(Flynn’s taxonomy),图形运算处理器的执行模型经常被拿来与SIMD(Single Instruction, Multiple Data)进行比较。通用运算处理器的向量扩展指令(如AVX等)是纯粹的SIMD,一条指令同时处理多个数据(例如存储在256位宽寄存器中的8个32位浮点数)。在SIMD中,针对数据的每个元素执行不同的分支(if-else)是非常困难的。
另一方面,NVIDIA提出的CUDA执行模型被称为SIMT(Single Instruction, Multiple Threads)。在SIMT中,多个独立的“线程”形成一个组(后文所述的“Warp”),共享并执行相同的指令。然而,与SIMD不同,SIMT的每个线程都拥有独立的寄存器状态和指令地址计数器(在编程模型上)。这使得程序员能够像每个线程都在独立运行一样来编写代码。
2.2 以32个线程为单位的“Warp”
图形运算处理器的硬件并不单独调度线程,而是将**32个线程作为一个整体的“Warp”**单位进行管理和执行。(在AMD的图形运算处理器中被称为Wavefront,有时也采用64个线程为单位)。
流式多处理器(SM)内的指令提取和解码单元,以Warp为单位提取一条指令,并将相同的指令发射(调度)给Warp内的所有32个线程。也就是说,Warp内的32个线程,在物理上是完全同时、针对各自拥有的不同数据执行相同的指令。这就是SIMT的核心。
2.3 Warp Divergence(分支发散)的物理惩罚
尽管可以表现得如同每个线程都有独立的程序计数器,但在物理上,Warp内的所有线程必须执行相同的指令。那么,如果代码中存在像 if-else 这样的条件分支,而Warp内的线程在分支条件的真假上产生了分歧,会发生什么呢?
这种现象被称为Warp Divergence(分支发散)。
当发生Warp Divergence时,硬件会按以下步骤进行处理:
- 首先,仅对
if条件为真的线程(活跃线程)执行指令。此时,条件为假的线程会被“掩码(无效化)”,运算结果不会被写入。 - 接下来,转移到
else条件(或者条件为假时的路径),此时将刚才被掩码的线程激活,将原本为真的线程掩码并执行指令。
也就是说,当存在多个分支路径时,硬件不得不将这些路径串行(而非并行)地执行。作为一个极端的例子,如果Warp内的32个线程走向了32条不同的分支路径,执行时间将飙升至32倍。Warp Divergence是导致图形运算处理器计算吞吐量骤减的最大原因之一,也是在算法设计中最应该避免的反模式。在物理上,这意味着尽管ALU消耗了电力,但由于被掩码,并未生成有效的计算结果,产生了“无效周期”。
补充第3章的说明:流式多处理器(SM)的硬件解剖
图形运算处理器是由大量**流式多处理器(SM: Streaming Multiprocessor)**集合而成的。SM才是图形运算处理器真正的计算引擎。在最新的架构(例如:Hopper H100)中,单个图形运算处理器芯片上搭载了100多个SM。
3.1 SM内部的流水线构成
SM内部进一步被划分为多个子分区(通常是4个),每个分区拥有独立的Warp调度器和调度单元。
- Warp调度器(Warp Scheduler): 选择处于可执行状态(寄存器和内存已准备就绪的状态)的Warp。图形运算处理器的调度器能够以零开销切换Warp,这是隐藏内存访问延迟的关键。
- 调度单元(Dispatch Unit): 向被调度的Warp发射指令。
- CUDA核心(INT32 / FP32 / FP64 ALU): 负责实际整数运算和浮点运算的单元。
- 加载/存储单元(LD/ST Unit): 负责对内存的读写。
- 特殊功能单元(SFU): 专用于高速计算sin、cos、exp、倒数等超越函数的硬件。
指令流水线被设计得非常深,具有提取、解码、调度、寄存器读取、执行(多个周期)、写回等各个阶段。FP32的FMA(Fused Multiply-Add)运算的延迟通常需要几个到十几个周期,但通过每个周期从不同的Warp发射指令,能够使流水线始终保持满载。
3.2 庞大的寄存器文件与寄存器压力
SM搭载了通用运算处理器无法比拟的庞大寄存器文件(例如:每个SM 64KB〜256KB的SRAM)。这是为了保存SM上并发执行的数千个线程的所有上下文。
上下文切换之所以能在零周期内完成,是因为不需要将线程的寄存器状态保存(溢出)到内存中。然而,如果每个线程使用的寄存器数量增加,SM内能够同时启动的Warp数量(占用率)就会下降。这被称为寄存器压力(Register Pressure)。一旦寄存器耗尽,数据就会溢出到低速的本地内存(物理上是全局内存的一部分)中,导致毁灭性的性能下降。
3.3 共享内存(Shared Memory)与Bank冲突
SM中存在程序员可显式控制的超高速片上内存,即共享内存(Shared Memory)。它与L1缓存共享同一块物理SRAM区域,但作为显式的数据缓存发挥作用,用于块内线程间的数据共享和同步。
共享内存的物理结构被划分为多个独立的模块(通常为32个),称为内存Bank(Memory Banks)。连续的32位地址被交错(分配)到不同的Bank中。
当Warp内的32个线程同时访问不同的Bank时,访问将被完全并行(在1个周期内)处理。这被称为无Bank冲突(Bank-conflict free)。 然而,当多个线程试图同时访问同一个Bank的不同地址时,请求将被串行化,产生惩罚(延迟)。这被称为Bank冲突(Bank Conflict)。例如,2路的Bank冲突会使访问时间变为2倍,最坏情况下32路的冲突会造成32倍的延迟。在矩阵转置等算法中,步幅访问会导致严重的Bank冲突,因此必须使用填充(Padding,插入虚拟数据以错开内存地址的技术)来进行高级优化以避免冲突。
补充第4章的说明:Tensor Core的乘加运算流水线
在Volta架构中首次引入,并极大提升了后续图形运算处理器性能的革命性硬件就是Tensor Core(张量核心)。AI和深度学习的爆发式发展,离不开Tensor Core。
4.1 矩阵乘加运算(MMA)的硬件实现
深度学习计算的绝大部分是神经网络权重矩阵与输入数据的矩阵乘法(GEMM: General Matrix Multiply)。计算公式表示为 $D = A \times B + C$ ($A, B$ 为输入矩阵,$C$ 为累加器矩阵)。
在传统的CUDA核心中,这种矩阵乘法是使用FMA(Fused Multiply-Add)指令逐元素计算的。相比之下,Tensor Core是在硬件层面上只需1个(或几个)周期就能执行小型矩阵(例如:4x4或16x16)乘加运算的专用电路。
在物理上,数十到数百个乘法器与巨大的加法树通过导线直连,在不将中间结果写回寄存器的情况下,一口气完成乘加。因此,与普通的CUDA核心相比,单位面积的运算吞吐量(TFLOPS)有着数量级的提高。
4.2 混合精度(Mixed-Precision)的奥秘
Tensor Core的另一个精髓在于对**混合精度(Mixed-Precision)**运算的支持。 在深度学习的计算过程中,有很多场合不需要高精度(FP32/FP64)。Tensor Core拥有这样的流水线:以低精度(FP16, BF16,或者更低的FP8, INT8, INT4)读取输入矩阵 $A$ 和 $B$,在内部进行低精度的乘法运算后,以更高精度(FP32或INT32)执行加法(累加)过程。
- FP16 / BF16: 训练的标准。BF16(Bfloat16)的指数部分与FP32一样有8位,动态范围广,因此容易防止梯度消失。
- FP8 / INT8 / INT4: 加速推理(Inference)的王牌。由于数据传输量(内存带宽)也减少了,吞吐量得到了显著提升。
在Hopper架构中,引入了能够极大加速Transformer模型计算的“FP8 Tensor Core”,与FP32相比,理论上实现了数十倍的吞吐量。在软件端(CUDA),通过 wmma(Warp-Level Matrix Multiply and Accumulate)API或 mma.sync PTX指令直接驱动Tensor Core,Warp内的线程协同工作,将矩阵片段加载到寄存器、进行运算、然后存储,这是一种极其复杂的集体处理。
补充第5章的说明:CUDA内存层次结构与优化技术
无论图形运算处理器的计算能力有多高,一旦数据供应成为瓶颈,性能就无法发挥(内存墙问题)。在CUDA编程中,90%的优化可以说是“内存访问优化”,这并不夸张。
5.1 全局内存的合并访问
作为图形运算处理器主内存(HBM或GDDR)的全局内存拥有极宽的带宽(例如几TB/s),但延迟也非常大,可达数百个周期。
最大化全局内存访问效率的绝对原则是合并(Coalescing)。 图形运算处理器的内存控制器以32字节、64字节或128字节单位的事务对内存进行访问。当Warp内的32个线程访问内存时,如果它们的内存地址都位于连续的区域内(在对齐的128字节边界内),硬件会将这些请求合并(Coalesce)为1次内存事务进行处理。
相反,如果线程访问随机的地址,或者进行跨步(间隔的)访问,则不会进行合并,会产生多个事务。这被称为“非合并访问”,它是一种致命的性能Bug,会将有效内存带宽降低至原来的十分之一以下。
5.2 CUDA C++代码示例:矩阵转置的优化与共享内存
以下是一个经过优化的矩阵转置(Matrix Transpose)内核代码示例,它避免了非合并访问,并利用共享内存显著提高了性能。
| |
这段代码有3个要点:
- 读取时的合并: 从
idata的读取在X方向上threadIdx.x是连续的,因此能够被完全合并。 - 写入时的合并: 对
odata的写入,也通过交换块坐标,设计为沿threadIdx.x方向连续,从而实现合并。 - 共享内存中的填充: 通过偏移1个元素(填充)
tile[TILE_DIM][TILE_DIM + 1],完全消除了在写入时按列方向(tile[threadIdx.x][threadIdx.y + j])访问时产生的Bank冲突。
5.3 缓存层次与特殊内存
- L1/L2缓存策略: 在较新的图形运算处理器架构中,程序员可以使用PTX指令(如
.ca,.cg,.cs等)来作为提示控制缓存的行为。例如,只访问一次的数据可以绕过L2缓存(流式访问),以防止缓存污染。 - 纹理内存 / 常量内存: 专用于图像处理的纹理内存,利用专用缓存来处理具有2D空间局部性的访问。常量内存对于所有线程读取相同常量的广播访问具有极高的效率。
补充第6章的说明:深度学习时代下图形运算处理器的未来
当前计算科学的前沿不仅在于提升单个图形运算处理器的性能,更在于整个系统的扩展。
6.1 通过NVLink和NVSwitch实现的超高速互连
巨大的LLM(大语言模型)无法放入单个图形运算处理器的内存(例如80GB或144GB)中。为了进行模型并行化(张量并行或流水线并行),需要在图形运算处理器之间每秒传输太字节级的数据。 由于传统的PCIe(PCI Express)总线无法提供如此大的带宽,NVIDIA开发了名为NVLink的专有高速互连技术。此外,通过使用名为NVSwitch的交换芯片,可以将8个或256个图形运算处理器结合在一个完全无阻塞的交叉开关中,构建出一个仿佛单一巨大图形运算处理器般运行的集群。
6.2 Transformer Engine与FP8生态系统
为了优化不仅在自然语言处理,而且在图像和语音识别领域也已成为事实标准的Transformer架构,Hopper架构搭载了名为Transformer Engine的专用硬件与软件协同机制。 它动态监控张量的统计信息,自动在每一层切换FP8和FP16的计算精度(Dynamic Scaling),从而在防止精度下降的同时,实现极限的计算速度并节省内存带宽。
6.3 图形运算处理器集群的缩贴定律与未来展望
正如OpenAI的“缩放定律(Scaling Laws)”所揭示的,模型的参数量和计算量增加得越多,AI的性能就持续提升。伴随这一趋势,图形运算处理器已经从单纯的处理器,进化成了由光纤连接数万个节点的“数据中心本身就是一台巨大的图形运算处理器(超级计算机)”。
未来的架构演进,将朝着引入硅光子学(光互连)、CPO(Co-Packaged Optics),以及SRAM到HBM 3D堆叠技术的进一步高级化迈进。然而,“通过并行处理最大化吞吐量”这一图形运算处理器诞生时未曾改变的DNA,将继续开拓计算科学的最前沿。
结语:计算科学的极北
GPU的架构,是人类迄今为止创造出的最复杂、且最专注于吞吐量的计算引擎。如果说CPU是“一台超高性能的F1赛车”,那么GPU就可以比作“由数万辆自卸卡车以统一调度的动作同时搬运物资的巨大物流系统”。
通过SIMT以Warp为单位执行指令、能在零周期内切换数千个线程的硬件调度、将带宽压榨到极限的合并访问,以及引领深度学习突破的Tensor Core流水线。所有这一切,都是工程师们近乎疯狂的执着结晶——在“物理法则的极限(光速、热量、功耗、硅的微缩极限)内,如何将浮点运算的总量最大化”。
对于未来的软件工程师、AI研究员、HPC研究者来说,理解GPU架构不仅仅是通识教育。要直观地掌握框架(如PyTorch或TensorFlow)背后发生了什么,并将硬件的能力发挥到极致,这是一门“必修课”。 避免内存的Bank冲突,消除Warp Divergence,让Tensor Core的流水线时刻充满数据。在这些优化的尽头,曾经需要超级计算机运算数月之久的计算,现在正变成在桌面的几张GPU上只需几小时即可完成的现实。
我们正生活在人类历史上最激动人心的计算机架构黄金时代。理解CUDA的物理原理与GPU超大规模并行架构的精髓,并去创造下一代创新的人,也许正是正在阅读本文的你。
专业术语解说(Glossary)
- SM (Streaming Multiprocessor): GPU的主要运算模块。相当于CPU中的核心,但在其内部包含了大量的CUDA核心、Warp调度器、共享内存等。
- SIMT (Single Instruction, Multiple Threads): 一种GPU特有的执行模型,Warp内的所有线程共享同一条指令,同时对各自独立的数据进行运算。
- Warp (Warp): 32个线程的集合体。硬件调度和指令发射的最小单位。
- Warp Divergence (分支发散): Warp内的线程间产生分支条件分歧,导致执行路径串行化从而吞吐量下降的现象。
- Tensor Core (张量核心): 能够在硬件层面一口气处理矩阵乘加运算(MMA)的专用电路。专为加速深度学习而设计。
- Coalesced Access (合并访问): 当Warp内的线程访问连续的内存地址时,硬件将其合并为一个事务以实现高带宽的机制。
- Shared Memory (共享内存): 搭载在SM内部的、程序员可控制的超高速L1暂存器内存(Scratchpad Memory)。
- Bank Conflict (Bank冲突): 在共享内存中,当多个线程同时访问同一Bank的不同地址时,访问被串行化而产生的惩罚。
- Occupancy (占用率): SM上同时活跃的Warp数量占理论最大值的实际比例。该比例越高,越容易隐藏内存访问的延迟。
- Register Spilling (寄存器溢出): 线程使用的寄存器数量超过硬件上限,多余的数据被迫退避(溢出)到低速内存(本地内存)中的现象。
参考文献及推荐阅读列表
- NVIDIA CUDA C++ Programming Guide: 所有CUDA程序员必读的官方文档。全面涵盖了内存访问模式和优化的最佳实践。
- NVIDIA Ampere / Hopper Architecture Whitepaper: 详细描述Tensor Core流水线、异步内存传输以及Transformer Engine硬件实现的官方白皮书。
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): 计算机架构领域的经典名著。可以深入学习CPU与GPU设计理念的区别、缓存层次结构以及指令级并行性。
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): 从算法设计角度讲解CUDA编程的教科书。详细解析了共享内存的Tiling技术、Reduction、Prefix Sum等的实现。
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: 学术论文。通过微基准测试揭示了NVIDIA未公开的缓存延迟和Tensor Core精确吞吐量的杰作。
本文所解说的架构知识,部分内容可能会随着硬件的进化而过时,但是“最大化带宽、挖掘并行性、隐藏延迟”这一根本的物理原则,将作为计算机科学的普遍真理长存。