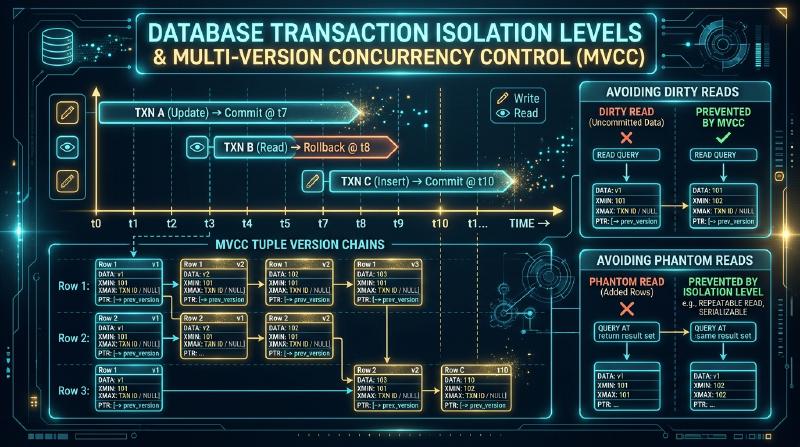
数据库事务隔离级别与MVCC:ACID的现实与多版本并发控制
在现代软件架构中,关系型数据库管理系统(RDBMS)依然是数据持久化的核心。其核心概念就是“事务”,特别是ACID特性(原子性 Atomicity,一致性 Consistency,隔离性 Isolation,持久性 Durability),作为构建健壮系统的基础理论被广泛认知。然而,在ACID特性中,“Isolation(隔离性)”是理论与实践之间存在最大鸿沟的领域。
本文将从数据库事务隔离级别的历史背景出发,深入探讨ANSI SQL-92标准的局限性,直至现代数据库引擎所采用的多版本并发控制(MVCC:Multi-Version Concurrency Control)的内部结构,从极其详细且学术性、实践性的视角进行深挖。特别解剖PostgreSQL与MySQL(InnoDB)这两大开源RDBMS在MVCC实现上的决定性差异,并涵盖分布式数据库最前沿的可序列化快照隔离(SSI),为您呈现这一总计超过12000字的鸿篇巨制。
第1章:ACID特性的神话与并发处理的困境
1.1 可序列化(Serializability)的理想
事务的Isolation(隔离性)所追求的终极理想形态是“可序列化(Serializability)”。这是指当多个事务同时并发执行时,其执行结果“与将事务按照某种顺序一个接一个地串行(Serial)执行的结果等价”的性质。
当事务 $T_1$ 和 $T_2$ 在系统上同时执行时,无论并发执行导致怎样的交错(操作交替)发生,只要最终的数据库状态与按“$T_1 \rightarrow T_2$”或“$T_2 \rightarrow T_1$”的顺序执行的结果完全一致,该调度就被定义为可序列化的。只要保证了这种可序列化,应用程序开发者就完全不需要去关注并发处理引起的数据不一致(如竞态条件或不适当的覆盖等),从而可以专注于业务逻辑的构建。
1.2 锁带来的序列化性能崩溃
在早期的数据库系统中,为了保证这种可序列化,采用了被称为“两阶段锁(2PL: Two-Phase Locking)”的严格锁机制。在2PL中,事务在读写数据前必须获取锁(共享锁或排他锁)(阶段1:Growing Phase),并在事务结束时(提交或回滚时)释放所有锁(阶段2:Shrinking Phase)。
然而,这种严格的锁机制存在着致命的缺陷。那就是“性能的极度恶化”。
- 读操作会阻塞写操作。
- 写操作会阻塞读操作。
- 锁竞争导致等待时间增加,且死锁频发。
随着流量的增加、大量用户同时访问数据库,基于2PL的完全序列化成为了系统的瓶颈,吞吐量急剧下降。系统面临着“数据一致性”与“并发处理性能(吞吐量)”之间权衡的困境。
1.3 并发控制的历史与妥协
为了解决这个困境,数据库工程的研究人员们引入了“隔离级别(Isolation Level)”的概念。这是一种“妥协的产物”:通过部分放宽完全的可序列化要求,允许特定数据不一致(异常:Anomaly)的发生,来换取并发处理性能的提升。它使得我们能够根据应用程序的需求,在一致性与性能之间进行平衡的选择。
第2章:ANSI SQL-92标准的隔离级别及其批判
2.1 ANSI SQL-92标准的隔离级别定义
在1992年制定的SQL标准“SQL-92”中,基于并发处理中可能发生的3种代表性异常(Phenomena),定义了4种隔离级别。
定义的3种异常(Phenomena)
- Dirty Read(脏读): 事务 $T_1$ 更新了数据但尚未提交的状态下,另一个事务 $T_2$ 读取了该未提交数据的现象。如果 $T_1$ 回滚,那么 $T_2$ 就等于读取了不存在的虚幻数据。
- Non-repeatable Read(不可重复读): 事务 $T_1$ 两次读取同一行的期间内,另一个事务 $T_2$ 更新并提交了该行的现象。这会导致 $T_1$ 的第一次和第二次读取结果不同。
- Phantom Read(幻读): 事务 $T_1$ 根据特定查询条件读取多行的期间内,另一个事务 $T_2$ 插入(或删除)了符合该条件的新行并提交的现象。当 $T_1$ 用相同的条件再次查询时,行数会发生增减。
SQL-92的4种隔离级别
SQL-92根据防止这些异常发生的程度,定义了隔离级别。
- Read Uncommitted(读未提交): 允许脏读。
- Read Committed(读已提交): 防止脏读,但允许不可重复读和幻读。
- Repeatable Read(可重复读): 防止脏读和不可重复读,但允许幻读。
- Serializable(可序列化): 防止所有异常,保证完全的可序列化。
2.2 Berenson等人的批判论文《A Critique of ANSI SQL Isolation Levels》
SQL-92标准的定义乍看之下非常明确且符合逻辑。然而,1995年由Hal Berenson、Jim Gray(图灵奖得主)、Phil Bernstein等数据库界泰斗发表的论文《A Critique of ANSI SQL Isolation Levels》,对该ANSI标准的定义给予了毁灭性的打击。
该论文指出的SQL-92标准的主要缺陷如下:
1. 基于锁的隐含前提
SQL-92的定义在暗中预设了“数据库是以基于锁的并发控制(2PL)来实现的”这一前提。然而在20世纪90年代,已经开始出现采用MVCC(后述)及其他乐观并发控制(OCC)的数据库,以锁为前提的异常定义正日益过时。
2. 定义的模糊性与不完整性
论文指出,仅凭SQL-92中定义的3种异常(Dirty Read, Non-repeatable Read, Phantom Read),无法涵盖并发处理中可能发生的所有异常。 例如,有一种被称为**“脏写(Dirty Write)”**的现象。这是指未提交事务写入的数据,被另一个未提交事务覆盖的现象,但在SQL-92标准中并没有提及脏写。所有的隔离级别(包括Read Uncommitted)都必须防止脏写(否则数据库的内部一致性将崩溃),但标准规范却没有触及这一点。
3. 新异常的发现
论文中定义了多个SQL-92标准中不存在的新异常。代表性的有两个:
- Lost Update(更新丢失): 两个事务同时读取相同的数据,并在分别写回计算结果时,其中一方的更新覆盖并消除了另一方更新的现象。
- Write Skew(写偏斜): 后述的快照隔离所特有的现象。
Berenson等人的论文证明了SQL-92标准未能从数学和严格意义上定义隔离级别,给数据库业界带来了巨大的冲击。在当前的数据库理论中,ANSI SQL-92的隔离级别定义被视为“应该了解的历史背景”,而作为“严格的技术定义则是不足够的”。
第3章:快照隔离(Snapshot Isolation)与写偏斜
3.1 Repeatable Read与快照隔离的区别
在Berenson等人的论文中,特别受人关注的是提倡了名为**“快照隔离(Snapshot Isolation: SI)”**的新隔离级别。
在许多采用MVCC的数据库(如PostgreSQL和Oracle)中,作为“Repeatable Read”提供的隔离级别,其真实面目其实就是这个“快照隔离”。在快照隔离下,每个事务都针对其开始时数据库一致的“快照(过去的静态状态)”进行读取。
- 事务开始之后其他事务进行的更新完全不可见(防止了不可重复读)。
- 由于将记录存在本身固定在了过去的时间点,其他事务的INSERT同样不可见(防止了幻读)。
也就是说,快照隔离不仅满足SQL-92定义的“Repeatable Read”要求,而且在很多情况下甚至防止了“幻读”。那么,快照隔离就等价于“Serializable”吗? 答案是“否”。因为快照隔离存在一种名为**“写偏斜(Write Skew)”**的致命异常,它并不是可序列化的。
3.2 医生值班问题与写偏斜(Write Skew)
理解写偏斜最著名的例子就是“医生值班(On-call)系统”。
【业务规则】 假设有一个医院的排班系统,规定“任何时候都必须至少有一名医生处于值班(待命)状态”。
现在,Alice和Bob两名医生都处于值班状态(on_call = true)。
此时,Alice和Bob偶然同时因为“感觉不舒服想取消值班”,并各自从自己的终端发起了更改排班的事务。
【事务流程(在快照隔离下)】
- [Tx1: Alice] 获取快照。确认当前值班的是Alice和Bob两人。
SELECT count(*) FROM doctors WHERE on_call = true;-> 结果: 2 - [Tx2: Bob] 获取快照。同样确认是Alice和Bob两人。
SELECT count(*) FROM doctors WHERE on_call = true;-> 结果: 2 - [Tx1: Alice] 判断满足规则(值班人数在1人以上),于是将自己从值班名单中移除。
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] 同样判断满足规则,于是将自己从值班名单中移除。
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] 提交成功。
- [Tx2: Bob] 提交成功。(由于Alice和Bob更新的是不同的记录,所以行锁不会冲突)
【结果】 在Tx1和Tx2都提交后,结果导致值班的医生变成了“0人”。业务规则崩溃了。
这就是写偏斜(Write Skew)。 如果是可序列化(Serializable),Tx1和Tx2必然有一个先串行执行,后执行的事务就会检测到值班人数只有“1人”,从而能够中止(回滚)取消自身值班的操作。但在快照隔离中,由于它们相互更新了不同的数据行(Alice行和Bob行),因此未检测到冲突,最终引发了业务规则的不一致。
3.3 ReadOnly Anomaly(只读异常)
此外,快照隔离还存在一种极其特殊的异常——由于“只读事务”的介入导致可序列化崩溃的ReadOnly Anomaly(只读异常)。 这种以银行账户存款余额与计息为例的异常,指的在更新事务之间并未发生冲突的情况下,只读事务因为看到了过去的快照,从而读取到了“逻辑上不可能存在的时间轴状态”的现象。这些异常的存在,使得快照隔离在严格意义上区别于Serializable。
第4章:MVCC(Multi-Version Concurrency Control)的工作原理
到目前为止,我们讨论了隔离级别的理论和异常,那么现代数据库是如何控制这些的呢?其核心技术便是MVCC(多版本并发控制:Multi-Version Concurrency Control)。
4.1 “读不阻塞写,写不阻塞读”
MVCC最大的设计理念,也是其与基于锁的控制(2PL)的决定性区别,在于“读操作与写操作互不阻塞”。 在更新记录时,MVCC数据库并不会直接覆盖(In-place update)现有记录。取而代之的是,它会创建一个新版本(版・元组)的记录,并同时保留旧版本的记录。
数据库内部将同时存在同一记录的多个版本(从过去到现在的历史)。 当事务读取数据时,系统会基于它自己的“事务ID(XID)”或“开始时间(时间戳)”,从系统内存在的众多版本中计算并读取“自己应该看到的正确历史版本”。
因此,即使某个事务正在改写记录,其他事务也能够读取“改写之前的旧版本”,从而避免了因锁引起的等待。
4.2 元组的版本管理链与可见性(Visibility)规则
MVCC中最关键的算法是判定“哪个事务能看到哪个版本的数据”的可见性规则(Visibility Rule)。
每个事务在开始时都会被分配一个单调递增的唯一事务ID(XID)。 保存在数据库中的各个记录版本(元组),会附加以下信息作为元数据:
- 创建XID: 通过INSERT/UPDATE创建该版本的事务ID。
- 删除XID: 通过UPDATE/DELETE在逻辑上删除(无效化)该版本的事务ID。
当事务 $T_i$ 读取数据行时,将基于以下基本规则判定可见性:
- 是否已提交: 创建XID所在的事务是否已经提交?
- 是否属于未来: 创建XID对应的事务是否发生在 $T_i$ 开始之前?
- 是否未被删除: 删除XID是否未被设置,或者删除XID对应的事务尚未提交,抑或其发生时间晚于 $T_i$ 的开始时间?
通过严格评估这些条件,系统为各个事务提供了一致的快照。
第5章:PostgreSQL vs MySQL (InnoDB) 的MVCC实现决定性差异
尽管MVCC的基本理念相同,但其内部实现在不同的数据库产品中却有着惊人的差异。在此,我们将对比解剖开源界两大巨头 PostgreSQL 和 MySQL(InnoDB)的MVCC架构。
5.1 PostgreSQL的MVCC实现:堆内追加与VACUUM的必然性
PostgreSQL的MVCC采用了一种非常独特且直观的**“追加型(Append-only)架构”**。
5.1.1 依赖xmin和xmax的位判定逻辑
在作为PostgreSQL表实体的据文件(堆 Heap)内,每一行(元组)的头部都记录了 xmin 和 xmax 这两个事务ID。
xmin(Transaction ID of Insert): 创建该元组的事务XID。xmax(Transaction ID of Delete): 删除(或通过更新使其旧版逻辑删除)该元组的事务XID。
【UPDATE操作的行为】
在PostgreSQL中,逻辑上 UPDATE 被处理为 DELETE 和 INSERT 的组合。
- 在旧元组的
xmax中写入当前事务的XID。(逻辑删除) - 在堆的空闲区域创建一个全新的元组,写入新数据,并在
xmin中设置当前事务的XID。(新增)
也就是说,新旧两种元组都会混合保存在同一个表数据文件(堆)中。
5.1.2 巨大的优势与致命的挑战:VACUUM的存在
这种架构最大的优势在于回滚速度极快。当事务中止时,只需将追加的元组视为“未提交”即可,不需要任何数据还原处理。
然而,其致命的挑战在于**“废弃元组(Dead Tuples)的膨胀”**。
随着不断的UPDATE或DELETE,那些不再被任何人引用的旧版本元组(xmax 为已提交的旧事务ID的元组)会在堆内无限制地积累。如果不加干预,表的物理体积将呈爆炸式增长,从而导致顺序扫描的性能遭受毁灭性打击。
为了在物理上删除这些废弃元组并回收空闲空间以供重用,系统提供了 VACUUM 进程(以及自动运行的 autovacuum 守护进程)。在PostgreSQL的运维中,VACUUM的调优之所以极其重要,其原因正是源于这种MVCC架构的根本设计。
5.2 MySQL InnoDB的MVCC实现:就地更新与Undo日志的动态重构
另一方面,MySQL的默认存储引擎InnoDB采用了更接近Oracle Database的**“就地更新(In-place update)与Undo日志(回滚段)”**架构。
5.2.1 聚集索引与就地更新
InnoDB的表以基于主键的B+Tree(聚集索引)构成。
在InnoDB中执行 UPDATE 时,它不会像PostgreSQL那样追加新行,而是直接覆盖B+Tree上的数据行(In-place update)。
那么,如果其他事务想要读取过去的快照该怎么办呢? 为此,InnoDB会将覆盖之前的“旧数据”退避到一个专用的区域,即**Undo日志(Undo Log Segment)**中。
5.2.2 基于回滚指针(Roll Pointer)的过去动态重构
InnoDB的每行数据的隐藏列中包含以下两个字段:
DB_TRX_ID: 最后一次插入或更新该行的事务ID。DB_ROLL_PTR(Roll Pointer): 指向Undo日志中保存该行“上一个旧版本”位置的指针。
事务读取过去快照的过程如下:
- 从B+Tree读取最新的数据行。
- 检查
DB_TRX_ID,如果是晚于自己快照的未来事务的更新,则判断不能读取这个最新行。 - 顺着
DB_ROLL_PTR,从Undo日志中获取旧版本的数据。 - 使用Undo日志上的数据,在内存中**动态重构(Rollback in memory)**出记录过去的状态。
- 如果重构出的数据依然是未来的更新,则继续追溯Undo日志的链条,直到更远的过去。
5.2.3 InnoDB的优势与挑战
这种架构的优势在于,主表区域(表空间)不易膨胀。最新数据总是位于B+Tree的适当位置,旧版本被隔离在其他区域(Undo日志)中,因此保持了很高的物理扫描效率(不需要像PostgreSQL那样进行大规模的VACUUM,Undo日志的清除进程可以在后台轻量运行)。
但缺点是,当存在需要大量读取过去快照的长运行事务(如批处理或mysqldump等)时,由于需要深入追溯Undo日志来重构数据,会产生极大的开销,从而导致读取性能下降。此外,Undo日志本身也有膨胀并挤压磁盘空间的风险。
第6章:可序列化快照隔离(SSI)与分布式数据库的最前沿
MVCC的进化并没有止步于此。正如第3章所述,快照隔离(SI)中存在着“写偏斜”等异常,并非完全的Serializable。然而,为了让应用程序开发者无需关注并发处理的复杂性,必须在维持MVCC高性能的同时,实现完全的Serializable。
6.1 可序列化快照隔离(SSI)的诞生
2008年,Michael Cahill等人发表的论文中提出了被称为**“Serializable Snapshot Isolation (SSI)”**的突破性算法。这是一种基于MVCC架构,却能保证完全可序列化(Serializable)的技术。PostgreSQL从9.1版本开始,便率先将SSI作为“Serializable”隔离级别的实现。
SSI的工作原理:冲突图与危险结构(rw-antidependency)
SSI不使用锁来进行阻塞。取而代之的是,在事务执行期间,它会精细地追踪“哪些数据被读取了(Read),哪些数据被写入了(Write)”。
SSI监控事务之间的冲突关系,寻找一种称为**“rw-antidependency(读写反依赖)”**的特定冲突模式。 具体来说,就是事务 $T_1$ 读取了旧版本的数据,而该数据随后被另一个事务 $T_2$ 覆盖提交的关系。 SSI在内部构建事务的冲突图,一旦检测到“连续出现两个rw-antidependency箭头的结构(危险结构)”,就判断有可能会破坏可序列化,从而强制中止(回滚)其中一个事务。
由此,可以在写偏斜(例:医生值班问题)等异常发生之前停止事务,最终保证了完全的Serializable。可以说这是乐观并发控制(OCC)的终极形态。
6.2 分布式数据库中的MVCC:Spanner, CockroachDB, TiDB
现代数据库技术已经超越了单台服务器的极限,向着分布部署在全世界数据中心的分布式SQL数据库(NewSQL)进化。在分布式环境中实现具备全局一致性的MVCC,曾是对物理法则的一次挑战。
Google Spanner与TrueTime API
Google的Spanner为了解决分布式系统中的事务排序问题,开发了TrueTime API。 在“各台服务器的时钟(物理时钟)必然存在偏差(时钟偏斜)”的前提下,结合GPS和原子钟,将当前时间作为一个“不确定性范围(时间窗口)”来提供。 Spanner的MVCC通过在事务提交时等待这个TrueTime的不确定性窗口过去(Commit Wait),从物理上保证了“存在因果关系的事务,其时间戳顺序必定正确(外部一致性 / External Consistency)”。
CockroachDB与HLC(混合逻辑时钟)
受到Spanner启发的开源分布式数据库CockroachDB,为了在不使用昂贵原子钟的情况下实现与之接近的一致性,采用了HLC(混合逻辑时钟)。 通过将NTP带来的物理时钟同步,与Lamport逻辑时钟(基于事件因果关系的计数器)相结合,CockroachDB可以在分布式节点间生成全局一致的MVCC快照时间戳,并在分布式环境中实现了SSI(Serializable Snapshot Isolation)。
TiDB与Percolator模型
由PingCAP公司开发的TiDB,采用了基于Google Percolator模型的分布式事务模型。 其架构准备了负责分配全局时间戳的单一组件(Placement Driver: PD),各节点的存储引擎(TiKV)利用该时间戳在本地处理MVCC。在基于2PC(两阶段提交)的同时,最小化了锁的持有时间,从而在分布式环境中同时实现了庞大事务与MVCC的支持。
结论:走向ACID的彼岸
数据库的事务隔离级别,绝不仅仅是单纯的死记硬背。它是数十年来计算机科学中,关于如何调和数据一致性与系统性能这两个背道而驰的需求的抗争史的真实写照。
从ANSI SQL-92的不完整定义开始,经历了MVCC带来的并发处理性能飞跃,到PostgreSQL与InnoDB架构的分歧,再到SSI和分布式数据库对终极一致性的挑战。 深入理解这些内部结构,必定会成为我们设计出更健壮、更高性能应用程序的强大武器。
我们现在正生活在一个ACID特性不再仅仅是“神话”,而是通过高级算法与物理时钟同步被作为“现实”来实现的时代。对于航行在数据之海的工程师们而言,探究数据库引擎的深渊,绝对是一场永无止境的充满智慧的探索之旅。