Полный разбор виртуальной памяти и механизма пейджинга: от MMU до TLB, HugePage и глубин управления памятью
В современных операционных системах (ОС) и архитектурах процессоров одной из самых сложных, но важнейших систем является механизм «виртуальной памяти» (Virtual Memory) и «пейджинга» (Paging). За кулисами адресного пространства памяти, о котором разработчики приложений обычно не задумываются, аппаратный MMU (Memory Management Unit) и ядро ОС тесно взаимодействуют, выполняя огромное количество преобразований адресов и обработок исключений в мире наносекунд.
В этой статье мы разберем глубочайшие недра системы виртуальной памяти с точки зрения внутренней структуры операционных систем и компьютерной архитектуры. От полного битового макета структуры таблиц страниц архитектуры x86-64, протокола IPI для TLB shootdown, полной трассировки страничных прерываний в ядре Linux, физического механизма Copy-on-Write (CoW), алгоритмов освобождения памяти (Reclaim) до формулы расчета баллов OOM Killer — мы подробно рассмотрим низкоуровневые механизмы на уровне исходного кода и регистров.
Глава 1: Причины существования виртуальной памяти и исторический контекст
Зачем компьютерам нужна виртуальная память? В ранних компьютерных системах программы обращались напрямую к определенным адресам физической памяти (RAM). Однако с распространением многозадачных сред этот метод прямого указания физических адресов достиг своего предела.
1.1 Защита памяти и полная изоляция адресного пространства процессов
Главная цель виртуальной памяти — обеспечение «безопасности и стабильности». Если процесс A случайно (или злонамеренно) перезапишет память процесса B, вся система может выйти из строя, или может произойти утечка конфиденциальной информации. Виртуальная память создает для каждого процесса иллюзию того, что «у него есть собственное непрерывное пространство памяти». Благодаря этому память между процессами строго изолируется на аппаратном уровне (MMU), а несанкционированный доступ к памяти немедленно перехватывается и обрабатывается как ошибка сегментации (Segmentation fault). Разделение пространства пользователя и пространства ядра также реализуется этим механизмом, а переходы между кольцами привилегий и проверка прав доступа к памяти выполняются оборудованием каждый такт.
1.2 Преодоление барьера емкости физической памяти и концепция пейджинга по требованию
Нередко объем памяти, требуемый приложениями, превышает объем установленной физической оперативной памяти. Виртуальная память предоставляет обширное адресное пространство, превышающее физическую память, за счет выгрузки (swap-out) неиспользуемых в данный момент областей памяти (страниц) на вторичное запоминающее устройство (HDD/SSD) и их загрузки (swap-in) при необходимости. Кроме того, благодаря концепции «пейджинга по требованию» (Demand Paging), при которой не весь код и данные загружаются в память при запуске программы, а только в момент обращения к ним, достигается баланс между экономией памяти и ускорением запуска.
1.3 Смена парадигмы: от сегментации к пейджингу
В ранних процессорах x86 (например, 80286) использовалась «сегментация», которая управляла памятью блоками переменной длины. Это метод вычисления логического адреса как базовый адрес + смещение с использованием таких регистров, как CS (сегмент кода) и DS (сегмент данных). Однако сегментация часто приводила к «внешней фрагментации (фрагментации памяти)», и управление ею было крайне сложным. Впоследствии, с появлением 80386, был внедрен «пейджинг», управляющий блоками фиксированной длины (обычно 4 КБ), который стал мейнстримом. Современные 64-битные ОС (Linux и Windows) фактически отключают сегментацию, используя плоскую модель памяти (базовый адрес 0, максимальный лимит), и управляют памятью только с помощью пейджинга. В настоящее время сегментация используется только в очень редких случаях, таких как ссылка на локальное хранилище потока (TLS) (регистры FS/GS).
Глава 2: Полный разбор многоуровневой структуры таблиц страниц и битового макета в x86-64
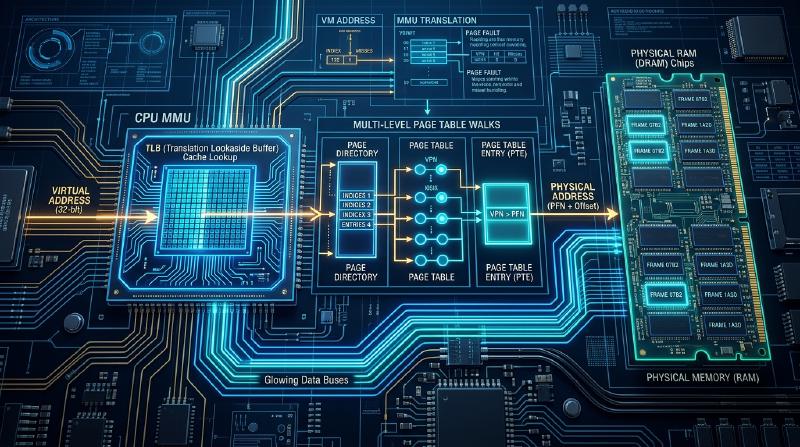
В 64-битной архитектуре (x86-64/AMD64) виртуальное адресное пространство огромно. В нынешнем мейнстримном «48-битном виртуальном адресном пространстве» аппаратный MMU сканирует 4 уровня таблиц страниц.
2.1 48-битное/57-битное виртуальное адресное пространство и ограничения канонической формы (Canonical Form)
64-битные регистры могут выражать огромное адресное пространство в 16 эксабайт, но современные аппаратные реализации не используют его полностью с точки зрения стоимости и сложности. В 48-битной реализации существует ограничение: биты с 47 по 63 виртуального адреса должны иметь одно и то же значение (расширение знака). Адреса, удовлетворяющие этому ограничению, называются «каноническими адресами» (Canonical Address).
В результате структура памяти имеет огромную неиспользуемую область (Non-canonical hole) в центре и аккуратно делится на нижнюю половину пользовательского пространства (0x0000000000000000 ~ 0x00007FFFFFFFFFFF) и верхнюю половину пространства ядра (0xFFFF800000000000 ~ 0xFFFFFFFFFFFFFFFF). При разыменовании недействительного указателя (например, указателя со встроенными метаданными в старших битах) MMU немедленно генерирует исключение общей защиты (#GP) как нарушение Canonical. В последние годы процессоры, начиная с Intel Ice Lake, также начали поддерживать расширенное 57-битное виртуальное пространство (5-уровневые таблицы страниц), что стало основой облачной инфраструктуры, работающей с петабайтами памяти.
2.2 Подробности иерархической структуры 4-уровневой таблицы страниц (PML4, PDPT, PD, PT)
Для преобразования 48-битных виртуальных адресов в физические адреса x86-64 использует 4-уровневую иерархию таблиц страниц (структура данных в виде Radix Tree). Каждая таблица имеет размер 4 КБ и содержит 512 64-битных (8-байтовых) записей (2^9 = 512). Виртуальный адрес делится следующим образом и служит индексом для каждой иерархии.
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - Верхний уровень. Регистр CR3 указывает на физический базовый адрес.
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - В случае 2MB HugePage здесь заканчивается.
- Bits 12-20 (9 bits): PT (Page Table) Index - Последняя таблица в обычных страницах по 4 КБ.
- Bits 0-11 (12 bits): Page Offset - Смещение внутри 4-килобайтной (4096 байт) страницы.
2.3 Полная таблица 64-битного макета записи таблицы страниц (PTE)
Каждая 64-битная запись в таблице страниц является не просто указателем физического адреса, а набором метаданных, отвечающих за мощный контроль доступа и управление кэшем. Ниже представлен полный битовый макет PTE архитектуры x86-64 и его подробные функции.
- Bit 0 [P] Present: Если 1, присутствует в физической памяти. Если 0, выгружено в своп или не выделено. Доступ при значении 0 вызывает исключение Page Fault (#PF).
- Bit 1 [R/W] Read/Write: Если 0, Read-Only (только для чтения), если 1, возможны Read/Write. Играет чрезвычайно важную роль в реализации CoW (Copy-on-Write).
- Bit 2 [U/S] User/Supervisor: Если 0, доступ только в привилегированном режиме (ядро). Если 1, доступ также возможен из пользовательского режима (Ring 3). Строго управляется KPTI, SMAP и др.
- Bit 3 [PWT] Page-level Write-Through: Если 1, политика записи в кэш для этой страницы устанавливается как Write-Through. Если 0, Write-Back.
- Bit 4 [PCD] Page-level Cache Disable: Если 1, отключает кэш для этой страницы (Uncacheable). Используется при прямом доступе к регистрам устройств PCIe, например в Memory-Mapped I/O (MMIO).
- Bit 5 [A] Accessed: Автоматически устанавливается в 1 оборудованием, когда MMU обращается к этой странице (Чтение или Запись). Используется в алгоритме LRU ОС (освобождение страниц) как бит ссылки.
- Bit 6 [D] Dirty: Автоматически устанавливается в 1 оборудованием, когда MMU выполняет «запись» на эту страницу. Важный бит, необходимый ОС для определения, требуется ли запись обратно на диск (выгрузка в своп).
- Bit 7 [PAT] Page Attribute Table: Индекс для указания более подробных типов кэша памяти (например, WC: Write-Combining) в сочетании с PWT/PCD. Используется для быстрой массовой передачи данных в графическую память (VRAM).
- Bit 8 [G] Global: Если 1, не сбрасывает эту запись из TLB даже при переключении регистра CR3 (при переключении контекста). В основном используется для страниц пространства ядра, предотвращая штрафы за промахи TLB при системных вызовах.
- Bits 9-11 [AVL] Available: 3 бита, свободно используемые ОС (ядром). В Linux иногда используются для метаданных записей подкачки или идентификации узлов NUMA.
- Bits 12-51 [PFN] Physical Frame Number: Базовый адрес целевой физической страницы (номер физического фрейма). Поскольку он выровнен по границе 4 КБ, младшие 12 бит всегда рассматриваются как 0.
- Bits 52-62 [AVL/PKU] Available/Ignored: Зарезервированы или доступны для использования ОС в зависимости от поколения процессора и расширений функций (Intel MPK: Memory Protection Keys и т.д.).
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: Если 1, данные на этой странице «не могут быть выполнены как инструкции». Мощный механизм безопасности (DEP: Data Execution Prevention) для предотвращения атак с внедрением кода в область данных из-за переполнения буфера и т.д.
Таким образом, каждый бит PTE тесно связан с алгоритмами управления памятью ОС (в частности, обработкой подкачки, защитой безопасности и управлением вводом-выводом) и представляет собой чрезвычайно сложный дизайн как интерфейс на границе между аппаратным и программным обеспечением.
Глава 3: Аппаратный обход таблицы страниц с помощью MMU и барьер задержки
Преобразование виртуальных адресов в физические адреса выполняется специальной аппаратной схемой, называемой MMU (Memory Management Unit), которая находится внутри ядра процессора.
3.1 Механизм обхода таблицы, начиная с регистра CR3
Управляющий регистр процессора CR3 содержит физический адрес таблицы страниц верхнего уровня (PML4) выполняющегося в данный момент процесса. Когда ОС, такая как Linux, выполняет переключение контекста, чтобы передать права на выполнение процессора другому процессу, она перезаписывает этот регистр CR3 адресом PML4 нового процесса. Это позволяет мгновенно переключать все пространство памяти процесса.
Ниже приведен концептуальный поток:
- Извлечь индекс верхнего уровня виртуального адреса и прочитать соответствующую запись таблицы PML4, на которую указывает CR3.
- Извлечь PFN из записи PML4 и вычислить физический адрес следующей таблицы PDPT.
- Прочитать соответствующую запись в таблице PDPT.
- Аналогичным образом пройти по таблицам PD и PT и получить базовый адрес итоговой физической страницы 4 КБ.
- Наконец, добавить 12-битное смещение страницы и построить полный физический адрес.
3.2 Доступ к шине памяти и задержка (Latency) как главное препятствие
Самым большим недостатком этого 4-уровневого обхода таблицы страниц является «задержка доступа к памяти». Простое преобразование одного виртуального адреса в худшем случае вызывает 4 обращения к физической памяти (чтение PML4, PDPT, PD, PT). Задержка доступа современных DRAM составляет около 50-100 наносекунд. Если все 4 обращения к памяти приведут к промахам кэша процессора (L1/L2/L3) и достигнут DRAM, только это вызовет остановку в сотни наносекунд. Учитывая, что тактовый цикл процессора составляет около 0,3 наносекунды (3 ГГц), это фатальная задержка, эквивалентная тысячам циклов, из-за которой конвейер процессора полностью истощается и останавливается. Чтобы преодолеть этот чрезвычайно серьезный барьер производительности, был разработан TLB, о котором пойдет речь далее.
Глава 4: Архитектура TLB в многоядерных средах и проблемы Shootdown
TLB (Translation Lookaside Buffer) — это «кэш результатов преобразования виртуальных адресов в физические», встроенный в MMU, который состоит из сверхбыстрой SRAM (или CAM: Content Addressable Memory).
4.1 Иерархическая структура TLB и оптимизация с помощью PCID (Process-Context Identifier)
В современных процессорах TLB также имеет иерархическую структуру L1/L2. L1 D-TLB (для данных) и L1 I-TLB (для инструкций) имеют очень маленькую емкость (несколько десятков записей), но отвечают за 1 цикл. L2 TLB имеет от нескольких сотен до нескольких тысяч записей и отвечает за несколько циклов. Если запись отсутствует в TLB (промах TLB), происходит ранее упомянутый аппаратный обход таблицы (page walk). Для поддержки этого также реализован специальный кэш обхода страниц (PWC: Page Walk Cache).
Поскольку значение виртуального адреса меняется при переключении процесса, в прошлом (ранние x86) TLB полностью очищался (Flush) при перезаписи CR3. Однако это приводило к частым промахам TLB сразу после переключения контекста и значительному снижению производительности. Технология PCID (Process-Context Identifier) (в архитектуре ARM она называется ASID) была внедрена для решения этой проблемы. Путем присвоения 12-битного идентификатора (тега), однозначно идентифицирующего процесс, записи TLB, стало возможным сохранять записи TLB предыдущего процесса даже после переключения контекста, что резко повысило производительность в многопроцессных средах, таких как веб-серверы и базы данных.
4.2 Протокол межпроцессорных прерываний (IPI) для сброса TLB (TLB Shootdown)
В многоядерных средах система виртуальной памяти сталкивается с очень сложной проблемой синхронизации. Например, предположим, что процесс, работающий на ядре 0 (CPU0), освобождает определенную область памяти с помощью munmap() и делает PTE в таблице страниц недействительным (Present = 0). Однако локальный TLB ядра 1 (CPU1) все еще может содержать «старую информацию о преобразовании (Stale TLB Entry)» из этого виртуального адреса в физический адрес в виде кэша.
В таком состоянии ядро 1 получит доступ к уже освобожденной памяти, что приведет к серьезной дыре в безопасности: повреждению данных, выделенных другим процессам, или чтению конфиденциальной информации. Чтобы предотвратить это, ОС должна принудительно удалить соответствующую запись из TLB ядра 1. Это и есть Сброс TLB (TLB Shootdown).
Сброс TLB строго выполняется на следующих этапах (протокол IPI):
- Инициатор (Ядро 0): После обновления таблицы страниц (очистки PTE) он выдает барьер памяти (например,
mfence) и отправляет IPI (Inter-Processor Interrupt: межпроцессорное прерывание) в локальный APIC (Advanced Programmable Interrupt Controller) других целевых ядер (Ядро 1). - Ожидание (Busy Wait): Ядро 0 ожидает в спин-блокировке (spinlock), пока все остальные целевые ядра не закончат обработку прерывания.
- Цель (Ядро 1): При получении IPI оно немедленно прерывает выполняющийся в данный момент пользовательский код и переходит к обработчику прерываний ядра (в Linux это переход к
flush_tlb_funcи т.д. черезsmp_call_function). - Выполнение сброса: Ядро 1 делает недействительной запись для указанного виртуального адреса из своего локального TLB (в x86 используется команда
INVLPG, для полного сброса перезагружается CR3). - Уведомление о завершении: Ядро 1 записывает завершение сброса во флаг в памяти и освобождает Ядро 0 от ожидания. После этого оно возвращается к прерванному процессу (
iret).
Узкие места производительности и ограничения масштабируемости: Сброс TLB — это чрезвычайно ресурсоемкая операция, которая потребляет от нескольких тысяч до десятков тысяч циклов, так как включает выдачу IPI оборудованием, переключение контекста прерывания, сброс конвейера и ожидание спин-блокировки между несколькими ядрами. По мере увеличения числа ядер до 16, 64, 128 стоимость этой синхронизации возрастает экспоненциально, становясь серьезным препятствием для масштабирования многопоточных приложений (особенно тех, которые часто выделяют и освобождают память) на облачных серверах и в высокопроизводительных вычислениях (HPC).
Глава 5: Полная трассировка обработки страничных прерываний (Page Fault) в ядре Linux
Когда программа обращается к области, где бит Present таблицы страниц равен 0, или к области без прав доступа (например, попытка записи в Read-Only или доступ к области ядра из пользовательского режима), MMU выдает исключение страничного прерывания (в x86 это Exception 14, #PF). С этого начинается путешествие в глубокую обработку исключений ядра Linux.
5.1 Поток управления страничного прерывания и трассировка зависимой от архитектуры части
В ядре Linux для x86-64 граф вызовов функций (трассировка вызовов) при возникновении страничного прерывания выглядит следующим образом. Управление передается от низкоуровневых обработчиков, зависящих от архитектуры, к общей подсистеме управления памятью, независимой от архитектуры.
asm_exc_page_fault(Ассемблер: arch/x86/entry/entry_64.S)- Процессор обнаруживает исключение, аппаратное обеспечение устанавливает виртуальный адрес, по которому произошел сбой, в регистр
CR2, сохраняет состояние регистров в стек прерываний и переходит к точке входа ядра.
- Процессор обнаруживает исключение, аппаратное обеспечение устанавливает виртуальный адрес, по которому произошел сбой, в регистр
exc_page_fault()(C: arch/x86/mm/fault.c)- Обработчик сбоев, зависящий от архитектуры. Анализирует код ошибки (Read/Write, User/Kernel, PF и т.д.) и проверяет контекст прерывания.
do_page_fault()/do_user_addr_fault()- Определяет, произошел ли сбой в пространстве ядра (ошибка, область vmalloc и т.д.) или в пользовательском пространстве. Если это пользовательское пространство, он ищет карту памяти (красно-черное дерево
vm_area_structи список VMA) целевого процесса и проверяет, принадлежит ли адрес допустимой области (не является ли ошибкой сегментации).
- Определяет, произошел ли сбой в пространстве ядра (ошибка, область vmalloc и т.д.) или в пользовательском пространстве. Если это пользовательское пространство, он ищет карту памяти (красно-черное дерево
handle_mm_fault()(C: mm/memory.c)- Отсюда начинаются основные функции, не зависящие от архитектуры. Он сканирует каждый уровень таблицы страниц (PGD -> P4D -> PUD -> PMD -> PTE) и, если таблица еще не выделена, выделяет новые промежуточные каталоги (например,
pmd_alloc), определяя адрес конечного PTE.
- Отсюда начинаются основные функции, не зависящие от архитектуры. Он сканирует каждый уровень таблицы страниц (PGD -> P4D -> PUD -> PMD -> PTE) и, если таблица еще не выделена, выделяет новые промежуточные каталоги (например,
5.2 Суть выделения памяти: ветвление от handle_mm_fault
handle_mm_fault() разветвляет фактический процесс выделения страницы в зависимости от состояния определенного PTE (пустой ли PTE, выгружен ли он в своп или это ошибка прав доступа).
do_anonymous_page()(Вершина пейджинга по требованию): Вызывается, когда PTE полностью пуст (ноль). Это первое обращение к анонимной странице (Anonymous Page), которая не привязана к файлу, например к куче (основанной наbrkилиmmapдляmalloc) или при расширении стека. Здесь ядро впервые выделяет физическую память (фрейм) из системы Buddy (Buddy System), очищает её нулями и отображает в PTE. Это экономит неиспользуемую память.do_fault()/__do_fault()(Файловый пейджинг): Вызывается при первом доступе к отображенному в память файлу (черезmmap). Загружает данные файла из кэша страниц или вызывает драйвер файловой системы (ext4 или xfs) для загрузки данных с диска и отображения их в таблице страниц.do_swap_page()(Боль подкачки): Вызывается, когда бит Present PTE равен 0, но в другом бите флага записана информация о смещении в области подкачки. Данные перезагружаются в физическую память с диска (раздел подкачки или файл подкачки). Из-за того, что это связано с дисковым вводом-выводом, процесс переходит в состояние длительного сна (блока) здесь.do_wp_page()(Copy-on-Write): Процесс CoW, описанный ниже. Вызывается, когда Present=1, но происходит попытка записи на страницу без прав на запись.
5.3 Физический механизм Copy-on-Write (CoW) и магия счетчика ссылок
Системный вызов fork(), являющийся основой создания процессов в Linux, работает чрезвычайно быстро благодаря механизму отложенных вычислений CoW (Copy-on-Write). Даже если родительский процесс использует несколько гигабайт памяти, мы объясним физический механизм того, почему fork() завершается в одно мгновение.
- Совместное использование таблиц страниц:
Когда вызывается
fork(), ядро копирует таблицу страниц родительского процесса дочернему как есть. Однако сама физическая память вообще не копируется. PTE родителя и потомка указывают на одну и ту же физическую память (фрейм). - Принудительная установка бита Read-Only (Write-Protect):
При этом ядро принудительно перезаписывает бит
R/WPTE всех общих страниц на0(Read-Only) (это касается даже областей данных, которые изначально были доступны для записи). - Инкремент счетчика ссылок (Reference Count):
Структура ядра (
_refcountвstruct page), управляющая целевой физической страницей, инкрементируется, переходя в состояние «ссылаются два процесса». - Запись и страничный прерывание (срабатывание do_wp_page):
Когда родитель или потомок пытается выполнить запись (Write) в общую переменную или область кучи, аппаратный MMU обнаруживает
R/W=0и немедленно генерирует страничный прерывание. - Дублирование страницы (Duplication):
Обработчик прерываний вызывает
do_wp_page(). Ядро проверяет флаги VMA и определяет: «Это не несанкционированный доступ, а законный сбой из-за CoW». Оно выделяет одну новую физическую страницу из системы Buddy и копирует данные исходной страницы целиком (copy_page). - Обновление PTE и декремент счетчика ссылок:
PTE процесса, выполнившего запись, перенаправляется на новую физическую страницу, а бит
R/Wустанавливается в1(разрешены Read/Write). Затем счетчик ссылок исходной физической страницы декрементируется. Если счетчик ссылок становится равным 1, другой процесс полностью завладевает этой страницей, поэтому, когда этот процесс в следующий раз вызовет сбой, нет необходимости копировать память, достаточно просто вернуть бит R/W обратно в 1 (повторное использование страницы).
Таким образом, CoW — это виртуозный алгоритм, в котором блестяще сочетаются аппаратная функция защиты MMU (ловушка Read-Only) и программное управление ядром, обеспечивающий резкое сокращение использования памяти и быстрый запуск процессов.
Глава 6: Глубины алгоритмов освобождения памяти (Reclaim) и суд OOM Killer
Физическая память конечна. Если система работает в течение длительного времени, а файловый кэш и кучи процессов истощают память, ОС должна освобождать (Reclaim) существующие области памяти, чтобы выделить новую память. Эта подсистема восстановления памяти — одна из самых сложных и трудных для понимания областей в ядре Linux.
6.1 Списки активных/неактивных LRU и алгоритм псевдо-LRU
Ядро Linux использует список LRU (Least Recently Used) для управления и отслеживания физических страниц. Однако управление всеми страницами с помощью строгого LRU невозможно из-за конфликтов блокировок и стоимости сканирования. Поэтому используется алгоритм псевдо-LRU (производный от алгоритма Clock), использующий две очереди (списки): «Активный список (Active list)» и «Неактивный список (Inactive list)».
- Активный список: Множество «горячих» страниц, к которым недавно часто обращались. Они не подлежат освобождению.
- Неактивный список: Множество «холодных» страниц, к которым давно не обращались. Кандидаты на освобождение в порядке с конца (tail) списка.
Как ядро узнает, что к странице было обращение? Здесь вступает в дело бит Accessed (бит A) PTE, описанный в главе 2. Ядро (kswapd) периодически сканирует таблицы страниц, считывает бит A из PTE, записывает историю доступа на программной стороне и затем сбрасывает бит A в 0. Если бит A снова устанавливается аппаратно в 1, страница остается в Активном списке или повышается из Неактивного. Если он не установлен, она постепенно понижается в конец Неактивного списка.
6.2 Демон kswapd и ужас прямого освобождения (Direct Reclaim)
Когда объем свободной памяти (Free Pages) падает ниже определенного порога (watermark: low), пробуждается фоновый поток ядра kswapd (присутствующий для каждого узла NUMA).
kswapd извлекает страницы из конца Неактивного списка.
- Если это чистый файловый кэш (неизмененные данные файла), он просто отбрасывает (Drop) их и освобождает память.
- Если это грязный (измененный) файловый кэш, он записывает его обратно на диск (Writeback) перед отбрасыванием.
- Если это анонимная страница (куча процесса или стек), она записывается в область подкачки (свопинг).
Эта фоновая работа продолжается до тех пор, пока свободная память не достигнет порога
high.
Однако, если скорость выделения памяти приложениями (давление на память) чрезвычайно высока, а скорость освобождения kswapd не успевает, и свободная память падает ниже предельного порога (watermark: min), активируется Прямое освобождение (Direct Reclaim).
Прямое освобождение — это механизм, при котором процесс восстановления памяти (отбрасывание кэша или свопинг) выполняется синхронно непосредственно в контексте процесса (самого приложения), запросившего память. При входе в прямое освобождение выполнение приложения (выполнение malloc или завершение страничного прерывания) полностью останавливается (stall), что является прямой причиной серьезного снижения производительности (всплеска задержки) продолжительностью от нескольких сотен миллисекунд до нескольких секунд. В базах данных и системах реального времени тюнинг (vm.swappiness и настройка watermark) является обязательным, чтобы избежать этого.
6.3 Формула расчета баллов OOM Killer и суд над процессами
Если после прямого освобождения область подкачки также исчерпана, кэш очищен, а память все равно не может быть выделена, ядро Linux в качестве крайней меры вызывает OOM (Out Of Memory) Killer.
OOM Killer предотвращает панику всей системы из-за нехватки памяти (сбой ядра или полное зависание) путем «принудительного завершения (SIGKILL)» процессов, потребляющих большие объемы памяти, чтобы вернуть память. Существует безжалостный алгоритм для определения жертвы.
Решение о том, какой процесс убить, основывается на оценочном значении oom_score (вычисляется функцией oom_badness() в mm/oom_kill.c ядра).
Базовая логика расчета OOM Score (концептуально):
- Базовый балл: Доля памяти, используемой процессом в данный момент (RSS: Resident Set Size + объем таблиц страниц + объем используемого свопа) от общей памяти. Максимум 1000 очков. То есть, чем больше памяти потребляет процесс (например, процесс с утечкой памяти), тем больше вероятность того, что он будет убит.
- Смягчение штрафа для прав root: Процессы, работающие с правами пользователя root (например, основные демоны системы), с высокой вероятностью необходимы для поддержания работы системы, поэтому их балл немного снижается (минус), и их сложнее убить.
- Значение корректировки пользователя (OOM Score Adj): Добавляется значение
/proc/[pid]/oom_score_adj(от -1000 до +1000). Системные администраторы могут использовать это для управления поведением OOM Killer. Процессы, для которых это значение установлено в -1000 (например: sshd, kubelet, главные процессы баз данных и т.д.), становятся «исключенными из целей OOM Killer (неуязвимыми)».
Когда срабатывает OOM Killer, в системный журнал (dmesg или /var/log/messages) выводится сообщение, такое как «Out of memory: Killed process 1234 (java)», а также подробный дамп списка процессов, каждого балла и состояния памяти на тот момент. Системные администраторы, понимая этот журнал и механизм расчета баллов, могут выяснить причину неожиданного завершения процессов и установить соответствующие ограничения ресурсов (cgroups или ulimit).
Глава 7: Новейшие методы сверхскоростной памяти и аппаратная безопасность
7.1 Мощь 2MB/1GB HugePages и плюсы/минусы THP
Мощным средством решения проблемы промахов TLB и задержек обхода таблиц, описанных в главах 3 и 4, являются «HugePage». Вместо обычных страниц размером 4 КБ используются огромные страницы размером 2 МБ (указывают на физический адрес напрямую на этапе Page Directory, т.е. пропускают уровень PT) или 1 ГБ (указывают напрямую на этапе PDPT).
Благодаря этому одна запись TLB может охватывать обширную область памяти (в 512 раз или в 260 000 раз больше 4 КБ), что радикально сокращает количество промахов TLB. В базах данных, осуществляющих случайный доступ к большим объемам памяти (Oracle, PostgreSQL), и в средах виртуализации (KVM/QEMU) использование HugePage является обязательным элементом оптимизации производительности.
THP (Transparent Huge Pages) в Linux — это механизм, при котором фоновый поток ядра (khugepaged) автоматически объединяет (дефрагментирует) непрерывные 4-килобайтные страницы в 2-мегабайтные HugePage, даже если приложение об этом не знает. Однако в средах с высокой фрагментацией памяти сам этот процесс объединения (уплотнение памяти) потребляет много ресурсов процессора и вызывает всплески задержек, поэтому в in-memory KVS, таких как Redis, рекомендуется отключать THP (never или madvise).
7.2 Изоляция таблиц страниц ядра (KPTI) и цена защиты от Meltdown
Уязвимость спекулятивного выполнения процессоров «Meltdown (CVE-2017-5754)», обнаруженная в 2018 году, была фатальным аппаратным дефектом, позволявшим несанкционированно считывать пространство памяти (кэш) ядра из пользовательских процессов.
В качестве меры противодействия на стороне ОС была внедрена KPTI (Kernel Page-Table Isolation) (изначально называлась KAISER).
Ранее, чтобы уменьшить накладные расходы на переключение контекста, вся область ядра отображалась в верхней половине таблицы страниц даже во время выполнения пользовательского пространства (предполагалось, что проверка привилегий выполняется битом U/S в PTE и доступ отклоняется). Однако спекулятивное выполнение обходило эту проверку привилегий.
После внедрения KPTI при выполнении пользовательского кода используется «минимальная теневая таблица страниц (User PGD)», которая не отображает большую часть ядра. При переходе в пространство ядра через системный вызов или прерывание необходимо переключить регистр CR3 и загрузить полную таблицу страниц ядра (Kernel PGD).
Хотя это полностью обеспечило безопасность, высокозатратное переключение CR3 (и управление PCID / сбросом TLB) происходит при каждом системном вызове и прерывании, что привело к значительным накладным расходам на производительность (от нескольких процентов до более чем десяти процентов) в приложениях с интенсивным вводом-выводом (веб-серверы и БД, интенсивно использующие системные вызовы).
7.3 Эволюция Direct I/O и технологии Zero-Copy
Для оптимизации файлового ввода-вывода ОС использует механизмы виртуальной памяти до предела.
Системный вызов mmap() отображает содержимое файла непосредственно в виртуальное адресное пространство. При доступе происходит страничный прерывание, данные файла загружаются в кэш страниц, и они становятся доступны напрямую из пользовательского пространства как указатель.
Более того, при отправке/приеме данных по сети и вводе-выводе хранилища технология Zero-Copy (нулевого копирования) используется для устранения копирования данных процессором между пространством ядра (кэшем страниц) и буферами пользовательского пространства (копирование, связанное с переключением контекста). Системные вызовы sendfile(), новейшие io_uring и AF_XDP работают во взаимодействии с контроллерами DMA (Direct Memory Access) NIC или NVMe-накопителей, манипулируя PTE таблиц страниц для прямого «переназначения (remap)» страниц ядра в пользовательское пространство, тем самым полностью устраняя накладные расходы на копирование памяти. И здесь в качестве фундаментального механизма выступает искусное манипулирование таблицами страниц.
Заключение
Виртуальная память и механизм пейджинга — это высокоуровневая симфония ядра ОС и процессора (аппаратного обеспечения). От установки однобитового флага в таблице страниц, проблем спин-блокировок при сбросе TLB, магии счетчика ссылок CoW до безжалостной эвристики OOM Killer — в их глубинах заложена мудрость информатики: «как безопасно и быстро абстрагировать ограниченные физические ресурсы и дать процессам иллюзию безграничности».
Понимание низкоуровневых механизмов необходимо не только для оптимизации на языках системного программирования, таких как C/C++ и Rust (проектирование структур данных с учетом кэш-линий, эффективное использование mmap), но и для глубокого понимания времени остановки (STW) сборки мусора (GC) и поведения распределителей памяти (jemalloc, tcmalloc) в высокоуровневых языках, таких как Go и Java. Сняв завесу «магии» систем и напрямую почувствовав пульс оборудования и ядра, вы откроете путь к тому, чтобы стать выдающимся архитектором, способным проектировать более совершенное и масштабируемое программное обеспечение.