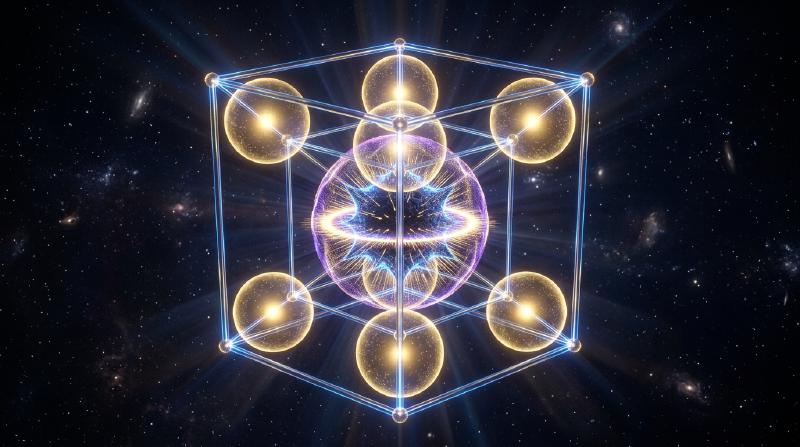
1. Исчезновение объема многомерного шара и «парадокс шипов» гиперкуба
Человеческий мозг эволюционировал для ориентации в двух- и трехмерном евклидовом пространстве ($d=2, 3$). Мы привыкли переносить трехмерную геометрическую интуицию — что вписанный шар занимает большую часть куба, что нормальное распределение сосредоточено вблизи среднего значения в начале координат, а два случайных вектора образуют самые разные углы — на пространства данных из сотен, тысяч и миллионов измерений ($\mathbb{R}^d, d \gg 100$). Однако современная математика доказывает: с ростом размерности $d$ наша интуиция не просто дает погрешность, а переворачивается на $180^\circ$ с точностью до наоборот!
Рассмотрим сначала объем $d$-мерного евклидова шара радиуса $R$: $V_d(R) = \frac{\pi^{d/2}}{\Gamma(d/2 + 1)}R^d$. Поскольку гамма-функция в знаменателе растет сверхэкспоненциально как $(d/2e)^{d/2}$, объем единичного шара ($R=1$) достигает абсолютного максимума при $d = 5$ ($V_5 \approx 5{,}2638$), а затем монотонно убывает: при $d \to \infty$ объем многомерного единичного шара строго стремится к нулю ($\lim_{d\to\infty} V_d(1) = 0$)! В то же время объем описанного гиперкуба $[-1, 1]^d$ растет как $2^d$, а расстояние от центра до каждой из его $2^d$ вершин равно $\sqrt{d}$. Почти весь объем гиперкуба сосредоточен в его $2^d$ далеких острых углах; более того, в знаменитом парадоксе упаковки шаров центральный шар, зажатый между $2^d$ угловыми шарами радиуса $1/2$ внутри $[-1,1]^d$, имеет радиус $r_c = \frac{\sqrt{d}-1}{2}$, который при $d \ge 10$ превышает $1$: запертый внутри куба центральный шар прорывает стенки гиперкуба и выходит наружу!
$$ V_d(R) = \frac{\pi^{d/2}}{\Gamma\!\left(\frac{d}{2} + 1\right)} R^d, \qquad \lim_{d \to \infty} V_d(1) = 0, \qquad \frac{V_d\big((1-\varepsilon)R\big)}{V_d(R)} = (1 - \varepsilon)^d \le e^{-\varepsilon d} \xrightarrow{d\to\infty} 0 $$2. Концентрация меры: полый апельсин и ортогональные случайные векторы
Где же сосредоточен объем внутри многомерного шара? Поскольку отношение объема внутреннего шара радиуса $(1-\varepsilon)R$ к полному объему равно $(1-\varepsilon)^d \le e^{-\varepsilon d}$, в размерности $d = 1000$ даже при $\varepsilon = 0{,}01$ внутренние $99\%$ радиуса содержат лишь $0{,}99^{1000} \approx 0{,}000043$ объема! Иными словами, более $99{,}995\%$ объема многомерного шара сжато в тончайшей поверхностной кожуре (Thin Shell) толщиной $O(1/d)$, а внутри шар практически пуст!
Аналогично, площадь поверхности сферы обнаруживает поразительную экваториальную концентрацию: при любом выбранном северном полюсе $\mathbf{p}$ почти вся площадь сферы $S^{d-1}$ лежит в узком поясе шириной $\pm O(1/\sqrt{d})$ вокруг экватора. Отсюда следует, что два независимых случайных единичных вектора $\mathbf{u}, \mathbf{v} \in S^{d-1}$ имеют скалярное произведение $\langle \mathbf{u}, \mathbf{v} \rangle$ с дисперсией $1/d$ ($\mathbb{P}(|\langle \mathbf{u}, \mathbf{v} \rangle| \ge \varepsilon) \le 2e^{-d\varepsilon^2/2}$): в пространстве высокой размерности любые два случайных вектора почти наверное ортогональны ($ heta \approx 90^\circ$)! Даже многомерное стандартное нормальное распределение $\mathbf{x} \sim \mathcal{N}(\mathbf{0}, I_d)$ покидает моду в начале координат $\mathbf{0}$ и согласно теореме о гауссовом кольце (Gaussian Annulus Theorem) концентрируется на тонкой сферической оболочке радиуса $\sqrt{d} \pm O(1)$:
$$ \mathbb{P}\!\left( \big| \langle \mathbf{u}, \mathbf{v} \rangle \big| \ge \varepsilon \right) \le 2 \exp\!\left(-\frac{d \varepsilon^2}{2}\right), \qquad \|\mathbf{x}\|_2 = \sqrt{\sum_{i=1}^d x_i^2} = \sqrt{d} \pm \mathcal{O}(1) \quad (\mathbf{x} \sim \mathcal{N}(\mathbf{0}, I_d)) $$
  flowchart TD
    A["High-Dimensional Euclidean Space R^d (d ≫ 100)"] --> B["Volume Vanishes in Center: (1-ε)^d ≈ exp(-ε d) → Thin-Shell Concentration"]
    A --> C["Surface Area Concentrates at Equator: Random Vectors Are Almost Orthogonal (θ ≈ 90°)"]
    A --> D["Distance Contrast Vanishes: (D_max - D_min)/D_min → 0 (Curse of Dimensionality)"]
    B --> E["Gaussian Annulus Theorem: N(0, I_d) Lives on Shell of Radius √d"]
    C --> F["Johnson-Lindenstrauss Lemma: Random Projection Preserves Distances in m = O(ε^-2 log N)"]
    D --> F
3. Проклятие размерности и коллапс контраста расстояний
Сформулированное Ричардом Беллманом в 1957 году проклятие размерности (Curse of Dimensionality) отражает экспоненциальный взрыв выборки: равномерная сетка с шагом $\varepsilon = 0{,}1$ в $[0,1]^d$ требует $N = 10^d$ точек ($10^{100}$ при $d=100$). Еще опаснее доказанное Байером и др. (Beyer et al., 1999) исчезновение контраста расстояний: при $d \to \infty$ относительная разница между расстоянием до ближайшего соседа $D_{\min}$ и до самого далекого соседа $D_{\max}$ стремится к нулю ($\lim_{d\to\infty} \frac{D_{\max} - D_{\min}}{D_{\min}} = 0$). Все точки оказываются почти равноудаленными друг от друга, что разрушает наивный поиск $k$ ближайших соседей ($k$-NN) и порождает феномен хабов (Hubness).
4. Спасение: гипотеза о многообразии и лемма Джонсона — Линденштрауса (JL)
Почему же глубокое обучение, большие языковые модели (LLM) и векторные базы данных успешно работают в пространствах тысяч измерений? Во-первых, благодаря гипотезе о многообразии (Manifold Hypothesis), согласно которой реальные данные сосредоточены вблизи маломерного подмногообразия внутренней размерности $d_{\text{int}} \ll d$; во-вторых, благодаря чуду самой концентрации меры — лемме Джонсона — Линденштрауса (1984)!
Лемма JL доказывает, что линейная случайная проекция $N$ точек из $\mathbb{R}^d$ с помощью случайной гауссовой матрицы в подпространство размерности $m = O(\varepsilon^{-2} \log N)$ сохраняет все попарные расстояния с точностью до $(1 \pm \varepsilon)$, причем целевая размерность $m$ совершенно не зависит от исходной размерности $d$!
| Геометрическое и вероятностное свойство | Интуиция в малой размерности ($d = 2, 3$) | Математическая реальность при $d \gg 100$ |
|---|---|---|
| Распределение объема внутри шара | Распределен между центром и поверхностью | $>99{,}99\%$ сжато в тонкой корке толщиной $O(1/d)$ у поверхности |
| Угол между двумя случайными векторами | Широко распределен от $0^\circ$ до $180^\circ$ | С вероятностью $1 - 2e^{-d\varepsilon^2/2}$ равен $90^\circ \pm O(1/\sqrt{d})$ (ортогональность) |
| Стандартный гауссиан $\mathcal{N}(\mathbf{0}, I_d)$ | Сгущается вокруг среднего $\mathbf{0}$ | Вблизи нуля пусто; масса лежит на сфере радиуса $\sqrt{d} \pm O(1)$ |
| Контраст $(D_{\max}-D_{\min})/D_{\min}$ | Ближний и дальний соседи четко различимы | Стремится к $0$ (все точки становятся почти равноудаленными) |