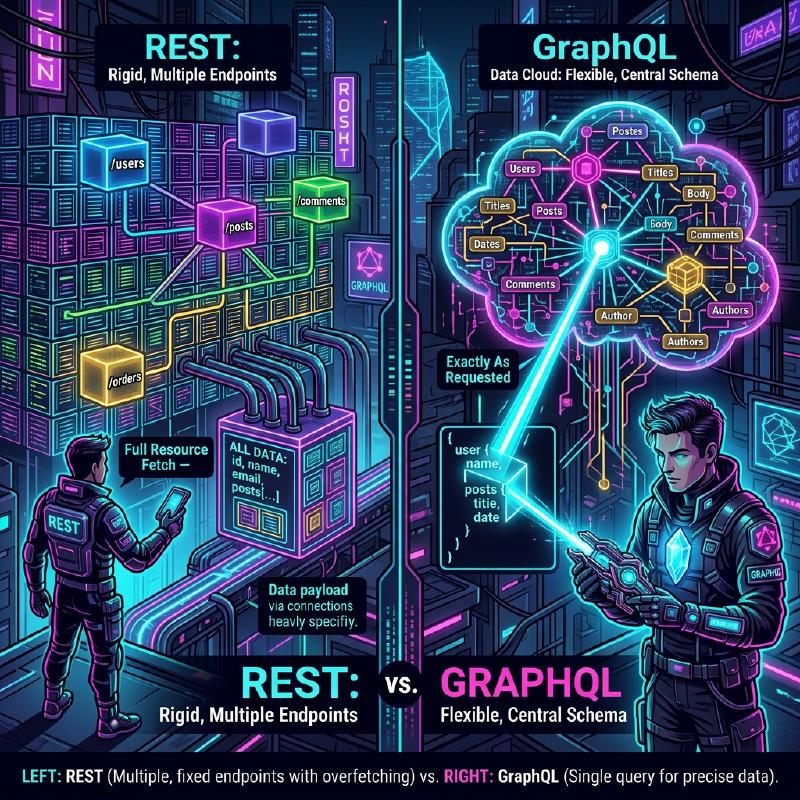
В современной веб-разработке выбор архитектуры API, связывающей бэкенд и фронтенд, оказывает колоссальное влияние на производительность приложения, эффективность разработки и поддерживаемость. Исторически принятый в качестве стандарта REST API получил широкое распространение благодаря своим простым и интуитивно понятным принципам проектирования, однако с усложнением фронтенда начали проявляться различные проблемы. В этой статье мы подробно и исчерпывающе рассмотрим ограничения REST API и инновационный подход GraphQL, появившегося для их решения, с точки зрения архитектуры, выборки данных (data fetching) и типобезопасности.
1. Принципы архитектурного стиля REST API и их ограничения
REST (Representational State Transfer) — это архитектурный стиль, предложенный Роем Филдингом в 2000 году. Он максимально использует базовые возможности протокола HTTP и ориентирован на ресурсы.
Основные принципы проектирования REST
При проектировании REST API в идеале должны соблюдаться следующие ограничения (RESTful API):
- Разделение клиента и сервера (Client-Server): Разделение задач, связанных с пользовательским интерфейсом, и задач, связанных с хранением данных, что позволяет им развиваться независимо друг от друга.
- Отсутствие состояния (Stateless): Сервер не сохраняет состояние сессии клиента, и каждый запрос должен содержать всю информацию, необходимую для его независимой обработки.
- Кэшируемость (Cacheable): Для повышения эффективности сети ответы от сервера должны явно указывать, могут ли они быть кэшированы.
- Единый интерфейс (Uniform Interface): Обеспечение согласованного интерфейса на основе таких принципов, как идентификация ресурсов (URI), манипулирование ресурсами через их представления, самоописываемые сообщения и HATEOAS (Hypermedia as the Engine of Application State).
- Многоуровневая система (Layered System): Клиент может взаимодействовать, не зная, подключен ли он к серверу напрямую или через промежуточные прокси-серверы и балансировщики нагрузки.
Благодаря этим принципам REST создал очень прочную основу для масштабирования в Интернете. Однако в контексте современных разнообразных устройств и сложных требований к UI, REST сталкивается с описанными ниже проблемами.
2. Проблема Overfetching и Underfetching
Наиболее заметной проблемой REST API является overfetching (избыточная выборка) и underfetching (недостаточная выборка). Это связано с тем, что REST возвращает фиксированную структуру данных для каждого “ресурса”.
Избыточная выборка (Overfetching)
Overfetching — это явление, при котором сервер отправляет больше данных, чем требуется клиенту.
Например, представьте экран, на котором отображается только список пользователей с их “именем” и “аватаркой”. При обращении к эндпоинту /users в REST API часто возвращается JSON, содержащий огромный объем данных, таких как адрес электронной почты, дата регистрации, подробная информация профиля, которые вообще не используются на этом экране. В условиях ограниченной пропускной способности, таких как мобильные сети, эта передача ненужных данных становится прямой причиной снижения производительности.
Недостаточная выборка (Underfetching) и проблема N+1 запросов
С другой стороны, underfetching — это ситуация, когда ответа от одного эндпоинта недостаточно для построения UI, и требуются дополнительные запросы.
Например, на странице с подробным описанием статьи в блоге нужно отобразить “текст статьи”, “информацию об авторе” и “список комментариев к статье”. В REST API часто приходится отправлять запросы к нескольким эндпоинтам:
- Запрос к
/posts/1для получения данных статьи. - Использование полученного
author_idдля получения информации об авторе через/users/{author_id}. - Запрос к
/posts/1/commentsдля получения комментариев к статье.
В результате сетевая задержка накапливается, и первоначальное отображение замедляется. Это приводит к проблеме N+1 запросов при построении UI.
3. Что такое GraphQL? Его инновационный подход
GraphQL — это язык запросов для API и серверная среда выполнения для их обработки, разработанная Facebook (ныне Meta) в 2012 году и открытая в 2015 году.
Основные концепции GraphQL
- Единая конечная точка (Single Endpoint): В отличие от REST, где для каждого ресурса предоставляется свой URL, GraphQL обычно использует только одну конечную точку —
/graphql. - Декларативная выборка данных: Клиент точно описывает в запросе, какая структура данных ему нужна, и запрашивает ее у сервера. Сервер возвращает JSON, полностью соответствующий запрошенной структуре.
- Строгая типизация (Schema-driven): Спецификация API строго типизируется и определяется с помощью языка определения схемы GraphQL (SDL).
Это позволяет клиентам получать “только нужные данные в нужном объеме”, что радикально решает проблемы overfetching и underfetching.
4. Сравнение архитектур (REST против GraphQL)
Следующая диаграмма иллюстрирует разницу в потоках запросов между REST и GraphQL при получении “статьи”, “автора” и “комментариев”, описанных ранее.
  sequenceDiagram
    participant C as "Клиент"
    participant R as "REST API (Множество конечных точек)"
    participant G as "GraphQL API (Единая конечная точка)"
    participant DB as "База данных"

    Note over C, R: "В случае REST API"
    C->>R: "GET /posts/1"
    R->>DB: "Получить пост"
    DB-->>R: "Данные поста"
    R-->>C: "Ответ (Пост)"
    C->>R: "GET /users/123 (Автор)"
    R->>DB: "Получить пользователя"
    DB-->>R: "Данные пользователя"
    R-->>C: "Ответ (Автор)"
    C->>R: "GET /posts/1/comments"
    R->>DB: "Получить комментарии"
    DB-->>R: "Данные комментариев"
    R-->>C: "Ответ (Комментарии)"

    Note over C, G: "В случае GraphQL"
    C->>G: "POST /graphql (Запрос на Пост, Автора, Комментарии)"
    G->>DB: "Разрешить Пост"
    G->>DB: "Разрешить Автора"
    G->>DB: "Разрешить Комментарии"
    DB-->>G: "Все данные агрегированы"
    G-->>C: "Ответ (Только запрошенные данные)"
Как видно, в REST происходит несколько циклов приема-передачи между клиентом и сервером, тогда как в GraphQL вся необходимая структура данных разрешается и возвращается за один запрос.
5. Разработка на основе схемы (Schema-Driven Development) и сравнение структур данных
Одной из важнейших особенностей GraphQL является разработка на основе схемы (Schema-Driven Development). Frontend- и backend-инженеры сначала согласовывают и определяют схему GraphQL (SDL). Эта схема становится “контрактом”, позволяя обеим сторонам вести разработку параллельно.
Пример определения схемы GraphQL (SDL)
| |
( ! означает, что поле обязательно и не может быть null)
Сравнение запросов и ответов
В случае REST API (необходимость объединения нескольких JSON)
Ответ на /posts/1:
| |
В этом случае, если нам нужно узнать только имя author, в REST мы получаем только author_id. Приходится либо делать отдельный запрос за деталями пользователя, либо создавать на бэкенде специальный эндпоинт, который принудительно объединяет данные (например, /posts/1?include=author).
В случае GraphQL
Запрос, отправляемый клиентом:
| |
Ответ от сервера:
| |
Таким образом, за один запрос возвращается JSON, который полностью соответствует запрошенной структуре. Ненужные поля (например, email) вообще не включаются.
6. Реализация резолверов и роль бэкенда
Сервер GraphQL анализирует запрос от клиента и собирает данные, выполняя функции, называемые резолверами (Resolver), которые соответствуют каждому полю в схеме.
Давайте рассмотрим пример реализации резолверов на Node.js (например, Apollo Server).
| |
Таким образом, резолверы вызываются цепочкой, следуя графу данных. Разработчик бэкенда может сосредоточиться не на том, “что возвращать по какому URL”, а на том, “как получить данные для этого поля этого типа”.
7. Проблема N+1 на бэкенде и её решение (DataLoader)
В приведенной выше реализации резолверов скрыт серьезный недостаток производительности. Это проблема N+1 на стороне сервера.
Например, предположим, что мы выполняем запрос на получение списка из 10 статей и получение author для каждой из них.
- Выполняется один запрос для получения 10 статей (
SELECT * FROM posts LIMIT 10) - Для каждой статьи вызывается резолвер
Post.author. - В результате выполняется 10 запросов для поиска автора (
SELECT * FROM users WHERE id = ?× 10 )
Если статей будет 100 или 1000, на базу данных ляжет огромная нагрузка. Эта проблема решается с помощью паттерна (и библиотеки) под названием DataLoader, разработанной Facebook.
Пакетная обработка и кэширование с помощью DataLoader
DataLoader использует цикл событий JavaScript (очередь микрозадач) для группировки запросов по ключам, возникших в рамках одного тика (tick), и объединяет их в один пакетный запрос к базе данных.
| |
В результате, даже в предыдущем примере, запрос на поиск авторов будет оптимизирован до одного запроса: SELECT * FROM users WHERE id IN (?, ?, ...) . Внедрение DataLoader фактически является обязательным для масштабирования GraphQL в рабочей среде.
8. Абсолютная типобезопасность с помощью GraphQL Code Generator
Система типов (схема) GraphQL приносит огромную пользу фронтенд-разработке. Используя такие инструменты, как GraphQL Code Generator, вы можете автоматически генерировать определения типов TypeScript и пользовательские хуки (для React) для выборки данных непосредственно из схемы.
В REST API также возможно генерировать типы из Swagger (OpenAPI), но в случае с GraphQL преимущество заключается в том, что можно генерировать типы, точно соответствующие “форме, указанной клиентом в запросе”.
- Загружаются файл схемы и строка запроса, написанная клиентом (.graphql файл).
- GraphQL Code Gen генерирует типы TypeScript (Interface), которые полностью соответствуют ответу на этот запрос.
| |
Это позволяет практически полностью предотвратить ошибки типа “сбой во время выполнения из-за того, что свойство равно undefined” еще на этапе статического анализа (во время компиляции), что кардинально улучшает опыт разработчика (DX) на фронтенде.
9. Продвинутые стратегии кэширования: Apollo Client и Relay
Одним из преимуществ REST API было то, что он легко использовал стандартное кэширование HTTP (ETag, Cache-Control и т.д.). В GraphQL, как правило, все запросы отправляются методом POST на единственную конечную точку, поэтому кэширование на уровне HTTP затруднено (хотя существуют такие методы, как Persisted Queries).
Вместо этого в экосистеме GraphQL получили развитие клиентские библиотеки с мощным клиентским кэшированием (нормализованным кэшем). Наиболее известными из них являются Apollo Client и Relay.
Что такое нормализованный кэш (Normalized Cache)
Умные GraphQL-клиенты, такие как Apollo Client, не сохраняют полученный JSON в виде исходной древовидной структуры. Они сохраняют его в виде плоского хранилища записей (records).
Каждый объект кэшируется (нормализуется) с ключом, представляющим собой комбинацию __typename (имя типа) и id (уникальный идентификатор) (например, Post:1).
Этот механизм предоставляет удивительные преимущества. Например, предположим, что у нас есть запрос “Список постов” и запрос “Детали поста”.
- Пользователь открывает экран “Детали поста” и редактирует заголовок поста (Mutation).
- Сервер возвращает ответ с новым заголовком (содержащий
idиtitle). - Apollo Client автоматически обновляет данные для
Post:1в хранилище. - В результате информация о том же
Post:1, отображаемая на экране “Список постов”, автоматически перерисовывается и синхронизируется с последним состоянием.
Разработчикам больше не нужно писать код для ручного обновления управления состоянием (например, Redux) — библиотека гарантирует согласованность данных во всем UI. Это является решающим преимуществом GraphQL перед REST при создании сложных одностраничных приложений (SPA).
Relay - бескомпромиссный GraphQL-клиент от Facebook
Relay, созданный компанией Facebook, разработчиком React, применяет еще более строгий и ориентированный на производительность подход, чем Apollo. Необходимые для каждого компонента данные определяются в виде Фрагментов (Fragment), а родительский компонент агрегирует их и отправляет на сервер в виде одного огромного запроса. Поскольку зависимости данных инкапсулируются на уровне компонентов, можно реализовать чрезвычайно продвинутую архитектуру, которая полностью исключает такие проблемы, как “компонент удален, но ненужные поля остаются в запросе”.
10. Стоит ли внедрять GraphQL? (Компромиссы и выводы)
До сих пор мы говорили о мощных преимуществах GraphQL, но это ни в коем случае не “серебряная пуля, которая всегда превосходит REST”.
Недостатки GraphQL / Барьеры для внедрения
- Стоимость обучения: Требуется смена парадигмы как для backend-, так и для frontend-разработчиков, что создает кривую обучения.
- Сложность бэкенд-реализации: Обязательна защитная реализация на стороне сервера, такая как проектирование DataLoader для предотвращения проблемы N+1, настройка производительности для сложных запросов (рекурсивных и глубоких) и ограничение скорости (rate limit) в зависимости от сложности запроса (Complexity).
- Избыточность для простых API: Если требования к получению и обновлению данных просты, а сложность UI низкая, то в небольших приложениях предпочтительнее будет простота REST.
Заключение
REST API остается отличной архитектурой и будет продолжать быть сильным выбором для публичных API и межсервисного взаимодействия (микросервисов).
С другой стороны, в высокоинтерактивных современных веб- и мобильных приложениях со сложными требованиями к данным, GraphQL предлагает подавляющее преимущество в DX и UX за счет “устранения overfetching/underfetching”, “безопасной frontend-разработки благодаря мощному выводу типов” и “автоматизации управления состоянием через нормализованное кэширование”.
Тщательная оценка навыков команды разработчиков, сложности продукта и масштабирования в будущем, а также выбор оптимальной архитектуры API станет одним из важнейших решений в современной разработке программного обеспечения.