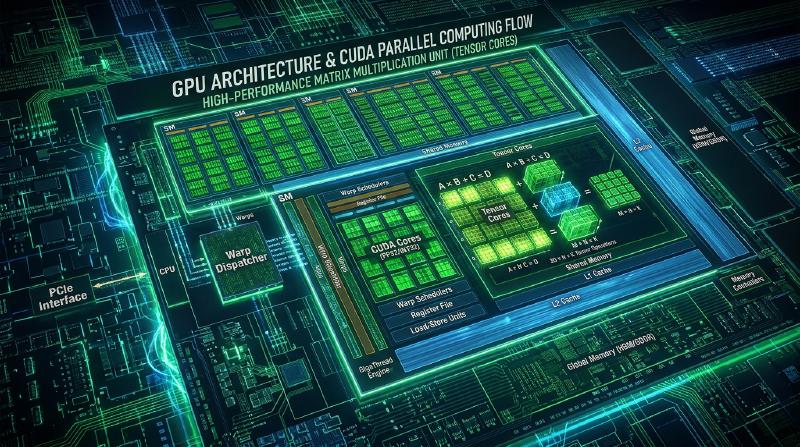
Архитектура массового параллелизма GPU и физика CUDA: принципы вычислений SIMT, варпов и тензорных ядер
Фундаментальной технологией, лежащей в основе современных передовых вычислительных наук, искусственного интеллекта, глубокого обучения и графики высокого разрешения, является GPU (Graphics Processing Unit). В этой статье мы глубоко проанализируем архитектуру GPU и физические/аппаратные аспекты платформы параллельных вычислений CUDA (Compute Unified Device Architecture), работающей на ней. Это не просто синтаксис программирования, а тщательное рассмотрение с точки зрения потоковых мультипроцессоров (SM), модели исполнения SIMT, планирования варпов, тензорных ядер и иерархии памяти, чтобы понять “почему аппаратное обеспечение спроектировано именно так” и “как оно достигает предельной вычислительной пропускной способности”.
Глава 1: Развилка в философии проектирования CPU и GPU
1.1 Стремление к низкой задержке против высокой пропускной способности
Процессоры общего назначения (CPU) и специализированные для параллельных вычислений GPU принципиально отличаются по своей философии проектирования, исходя из истории их создания. CPU развивался с приоритетом на “низкую задержку” (минимизацию задержки) — как максимально быстро завершить одну задачу (поток). В свою очередь, GPU стремится к “высокой пропускной способности” (максимизации объема обработки) — как собрать вместе огромное количество задач и максимизировать объем работы, выполняемой за единицу времени в целом.
CPU должен быстро справляться с непредсказуемыми процессами, такими как управление операционной системой, выполнение приложений со сложными ветвлениями и обработка случайных прерываний от пользователя. По этой причине он оснащен сложными схемами предсказания ветвлений, механизмом внеочередного исполнения (out-of-order execution) и огромными кэшами L1/L2/L3, скрывающими задержки доступа к памяти, максимизируя производительность одного потока.
Напротив, GPU изначально был создан для обработки высокопараллельных задач, таких как применение одних и тех же операций шейдинга к миллионам пикселей на экране. Вместо того чтобы тратить площадь кристалла на сложные схемы управления и огромные кэши, был выбран путь размещения максимально возможного количества простых арифметико-логических устройств (ALU: Arithmetic Logic Unit).
1.2 Распределение площади кристалла между кэшем, схемами управления и ALU
То, как распределяется ограниченная площадь кремниевого кристалла (бюджет транзисторов), определяет архитектурные различия между ними.
- Распределение площади CPU: Более половины кристалла занимают большие кэши (SRAM) и сложные схемы управления (предсказание ветвлений, выборка инструкций, декодирование, планирование и т.д.). Доля ALU, выполняющих фактические вычисления, относительно мала.
- Распределение площади GPU: Кэш-память и схемы управления сведены к абсолютному минимуму, а большая часть кристалла занята от нескольких тысяч до десятков тысяч ALU (ядер CUDA).
GPU скрывает задержку (latency) доступа к памяти не с помощью кэшей, а путем “переключения контекста”. Пока одна группа потоков ждет поступления данных из памяти, он немедленно выполняет вычисления для другой группы потоков, поддерживая вычислительные блоки в постоянно рабочем состоянии (высокая занятость: occupancy). Это физическая реализация “стремления к высокой пропускной способности” в GPU. Поскольку аппаратная многопоточность (Hardware Multithreading) выполняется с чрезвычайно низкими затратами, предполагается наличие от нескольких тысяч до десятков тысяч параллельных потоков.
Глава 2: Суть модели исполнения SIMT
2.1 Разница между SIMD и SIMT
Хотя в таксономии Флинна (Flynn’s taxonomy) классификации параллельной обработки модель выполнения GPU часто сравнивают с SIMD (Single Instruction, Multiple Data), векторные расширения CPU (такие как AVX) — это чистый SIMD, где одна инструкция одновременно обрабатывает несколько данных (например, 8 32-битных чисел с плавающей запятой в 256-битном регистре). В SIMD очень сложно выполнять разные ветвления (if-else) для каждого элемента данных.
С другой стороны, модель выполнения CUDA, предложенная NVIDIA, называется SIMT (Single Instruction, Multiple Threads). В SIMT несколько независимых “потоков” образуют группы (называемые “варпами”, см. ниже), и выполняют общую инструкцию. Однако в отличие от SIMD, каждый поток SIMT имеет независимое состояние регистров и счетчик адреса инструкций (с точки зрения модели программирования). Это позволяет программистам писать код так, как будто каждый поток работает независимо.
2.2 “Варп (Warp)” — единица из 32 потоков
Аппаратное обеспечение GPU не планирует каждый поток индивидуально, а управляет и выполняет их группами по 32 потока, называемыми “варпом (Warp)”. (В GPU AMD это называется Wavefront, и часто используются единицы по 64 потока).
Блок выборки и декодирования инструкций внутри потокового мультипроцессора (SM) извлекает одну инструкцию для варпа и отправляет (dispatch) ее всем 32 потокам внутри варпа. Иными словами, 32 потока в варпе физически абсолютно одновременно выполняют одну и ту же инструкцию над своими разными данными. В этом заключается суть SIMT.
2.3 Физический штраф за дивергенцию варпа (Warp Divergence)
Хотя каждый поток может вести себя так, будто имеет независимый программный счетчик, физически все потоки в варпе должны выполнять одну и ту же инструкцию. Что же происходит, если в коде есть условное ветвление типа if-else, и значения условия для потоков внутри варпа оказываются разными?
Это явление называется дивергенцией варпа (Warp Divergence: расхождение ветвления).
При возникновении дивергенции варпа аппаратура выполняет обработку в следующие этапы:
- Сначала она выполняет инструкцию только для тех потоков, где условие
ifоказалось истинным (активные потоки). В это время потоки, где условие оказалось ложным, “маскируются” (отключаются), и результаты их вычислений не записываются. - Затем она переходит к ветке
else(или пути, когда условие ложно), на этот раз активируя ранее замаскированные потоки и маскируя те, для которых условие было истинным, и выполняет инструкцию.
То есть, при наличии нескольких путей ветвления аппаратура вынуждена выполнять их не параллельно, а последовательно (серийно). Как крайний пример, если 32 потока в варпе пойдут по 32 разным путям, время выполнения возрастет в 32 раза. Дивергенция варпа является одним из главных факторов резкого падения вычислительной пропускной способности GPU, и это антипаттерн, которого следует всеми силами избегать при проектировании алгоритмов. Физически это означает появление “пустых циклов”, когда ALU потребляют энергию, но из-за маскировки не создают полезных результатов вычислений.
Глава 3: Аппаратный разбор потокового мультипроцессора (SM)
GPU состоит из множества потоковых мультипроцессоров (SM: Streaming Multiprocessor). SM — это настоящий вычислительный двигатель GPU. В новейших архитектурах (например, Hopper H100) на одном кристалле GPU размещается более 100 SM.
3.1 Структура конвейера внутри SM
Внутри SM дополнительно разделен на несколько подгрупп (обычно четыре), каждая из которых имеет независимый планировщик варпов и блок диспетчеризации.
- Планировщик варпов (Warp Scheduler): Выбирает варп, находящийся в состоянии готовности к выполнению (когда регистры и память готовы). Планировщик GPU может переключать варпы с нулевыми накладными расходами, что является ключом к сокрытию задержек доступа к памяти.
- Блок диспетчеризации (Dispatch Unit): Выдает инструкции запланированному варпу.
- Ядра CUDA (INT32 / FP32 / FP64 ALU): Блоки, выполняющие фактические вычисления с целыми числами или числами с плавающей запятой.
- Блок загрузки/сохранения (LD/ST Unit): Отвечает за чтение и запись в память.
- Специальные функциональные блоки (SFU): Выделенное аппаратное обеспечение для быстрого вычисления трансцендентных функций, таких как sin, cos, exp, обратная величина и т.д.
Конвейер инструкций спроектирован очень глубоким и включает стадии выборки, декодирования, планирования, чтения регистров, выполнения (многоцикловое) и обратной записи. Задержка операции FMA (Fused Multiply-Add) для FP32 обычно составляет от нескольких до более десятка тактов, но выдавая инструкции из разных варпов на каждом такте, конвейер всегда поддерживается полным.
3.2 Огромный регистровый файл и регистровое давление
SM оснащен регистровым файлом, который несравним по размеру с CPU (например, 64-256 КБ SRAM на один SM). Это необходимо для сохранения контекста всех тысяч потоков, выполняющихся одновременно на SM.
Переключение контекста выполняется за ноль тактов именно потому, что нет необходимости вытеснять (spill) состояние регистров потока в память. Однако если количество регистров, используемых одним потоком, увеличивается, количество варпов, которые могут быть запущены одновременно на SM (occupancy), снижается. Это называется регистровым давлением. При истощении регистров данные вытесняются в медленную локальную память (физически это часть глобальной памяти), что приводит к катастрофическому падению производительности.
3.3 Разделяемая память (Shared Memory) и конфликты банков
В SM существует сверхбыстрая внутричиповая память под названием разделяемая память (Shared Memory), которой программист может явно управлять. Она делит одну и ту же физическую область SRAM с кэшем L1, но работает как явный кэш данных и используется для совместного доступа к данным и синхронизации между потоками в блоке.
Физическая структура разделяемой памяти разделена на несколько независимых модулей (обычно 32), называемых банками памяти (Memory Banks). Последовательные 32-битные адреса чередуются (распределяются) по разным банкам.
Если 32 потока в варпе одновременно обращаются к разным банкам, доступ обрабатывается полностью параллельно (за 1 такт). Это называется доступом без конфликтов банков. Однако если несколько потоков пытаются одновременно обратиться к разным адресам одного и того же банка, запросы сериализуются, что приводит к штрафу (задержке). Это называется конфликтом банков (Bank Conflict). Например, при 2-канальном конфликте время доступа удваивается, а в худшем случае, при 32-канальном конфликте, оно увеличивается в 32 раза. В алгоритмах вроде транспонирования матриц доступ с шагом вызывает серьезные конфликты банков, поэтому необходимо применять сложные оптимизации, такие как дополнение (падинг - вставка фиктивных данных для смещения адресов), чтобы избежать конфликтов.
Глава 4: Конвейер вычислений суммы произведений тензорных ядер (Tensor Core)
Революционное аппаратное обеспечение, впервые представленное в архитектуре Volta, которое резко повысило производительность последующих GPU, — это тензорные ядра (Tensor Core). Взрывное развитие ИИ и глубокого обучения невозможно без тензорных ядер.
4.1 Аппаратная реализация операций суммы произведений матриц (MMA)
Большая часть вычислений в глубоком обучении — это перемножение матриц (GEMM: General Matrix Multiply) весов нейронной сети и входных данных. Уравнение можно представить как $D = A \times B + C$ (где $A, B$ - входные матрицы, $C$ - матрица аккумулятора).
В традиционных ядрах CUDA это перемножение матриц вычислялось поэлементно с использованием инструкций FMA (Fused Multiply-Add). В отличие от них, тензорное ядро — это специализированная схема, которая выполняет операции суммы произведений небольших матриц (например, 4x4 или 16x16) на аппаратном уровне за 1 такт (или несколько тактов).
Физически от десятков до сотен умножителей и огромное дерево сумматоров соединены проводами напрямую, завершая всю операцию за один проход без возврата промежуточных результатов в регистры. Благодаря этому пропускная способность вычислений на единицу площади (TFLOPS) на порядки выше, чем у обычных ядер CUDA.
4.2 Секреты смешанной точности (Mixed-Precision)
Еще одной сутью тензорных ядер является поддержка вычислений со смешанной точностью (Mixed-Precision). В глубоком обучении часто встречаются ситуации, когда высокая точность (FP32/FP64) не требуется в процессе вычислений. Тензорное ядро имеет конвейер, который загружает входные матрицы $A$ и $B$ с низкой точностью (FP16, BF16 или даже FP8, INT8, INT4), выполняет внутренние умножения с низкой точностью, а затем выполняет процесс сложения (аккумуляции) с более высокой точностью (FP32 или INT32).
- FP16 / BF16: Стандарт для обучения. У BF16 (Bfloat16) экспонента состоит из 8 бит, как и у FP32, поэтому широкий динамический диапазон помогает предотвратить исчезновение градиента.
- FP8 / INT8 / INT4: Козырь для ускорения вывода (Inference). Объем передачи данных (пропускная способность памяти) также сокращается, что резко увеличивает пропускную способность.
В архитектуре Hopper были внедрены “FP8 Tensor Core”, которые радикально ускоряют вычисления моделей Transformer, обеспечивая теоретическую пропускную способность в десятки раз выше, чем FP32. Со стороны программного обеспечения (CUDA), тензорные ядра управляются напрямую через API wmma (Warp-Level Matrix Multiply and Accumulate) или инструкции PTX mma.sync, а потоки внутри варпа кооперируются для загрузки, вычисления и сохранения фрагментов матриц в регистры, выполняя чрезвычайно сложные коллективные операции.
Глава 5: Иерархия памяти CUDA и методы оптимизации
Какой бы высокой ни была вычислительная мощность GPU, производительность не будет достигнута, если узким местом станет подача данных (проблема стены памяти). Не будет преувеличением сказать, что 90% оптимизации в программировании на CUDA — это “оптимизация доступа к памяти”.
5.1 Объединенный (Coalescing) доступ к глобальной памяти
Главная память GPU (HBM или GDDR) — глобальная память — обладает огромной пропускной способностью (например, несколько ТБ/с), но и задержка очень велика (сотни тактов).
Абсолютное правило для максимизации эффективности доступа к глобальной памяти — это объединение (Coalescing). Контроллер памяти GPU обращается к памяти транзакциями по 32, 64 или 128 байт. Когда 32 потока в варпе обращаются к памяти, и их адреса находятся в непрерывной области (выровненные по границе 128 байт), аппаратура объединяет (coalesce) эти запросы в одну транзакцию памяти.
Напротив, если потоки обращаются к случайным адресам или выполняют доступ с шагом (stride), объединение не происходит, и генерируются множественные транзакции. Это называется “необъединенным доступом”, что является фатальным багом производительности, снижающим эффективную пропускную способность памяти до менее чем одной десятой.
5.2 Пример кода CUDA C++: оптимизация транспонирования матриц и разделяемая память
Ниже приведен пример оптимизированного кода ядра для транспонирования матрицы (Matrix Transpose), который избегает необъединенного доступа и радикально улучшает производительность за счет использования разделяемой памяти.
| |
В этом коде есть 3 ключевых момента:
- Объединение при чтении: Чтение из
idataпроисходит по направлению X, гдеthreadIdx.xнепрерывны, поэтому оно полностью объединяется. - Объединение при записи: Запись в
odataтакже спроектирована так, чтобы идти последовательно в направленииthreadIdx.xпутем обмена координат блока, что позволяет объединить транзакции. - Падинг в разделяемой памяти: Смещая на 1 элемент (падинг) как
tile[TILE_DIM][TILE_DIM + 1], мы полностью исключаем конфликты банков при доступе по направлению столбца (tile[threadIdx.x][threadIdx.y + j]) во время записи.
5.3 Иерархия кэшей и специальная память
- Политика кэширования L1/L2: В современных архитектурах GPU программист может управлять поведением кэша с помощью инструкций PTX (например,
.ca,.cg,.cs) как подсказками. Например, данные, к которым происходит однократный доступ, могут обходить кэш L2 (потоковый доступ), что предотвращает загрязнение кэша. - Текстурная память / Константная память: Текстурная память, специализированная для обработки изображений, использует специальный кэш для доступа с двумерной пространственной локальностью. Константная память обеспечивает невероятную эффективность для широковещательного доступа, когда все потоки читают одну и ту же константу.
Глава 6: Будущее GPU в эпоху глубокого обучения
Сегодняшний фронтир вычислительной науки — это не только повышение производительности отдельного GPU, но и масштабирование всей системы в целом.
6.1 Сверхбыстрые межсоединения NVLink и NVSwitch
Огромные LLM (большие языковые модели) не помещаются в память одного GPU (например, 80 ГБ или 144 ГБ). Чтобы выполнить распараллеливание моделей (тензорный или конвейерный параллелизм), необходимо ежесекундно обмениваться терабайтами данных между GPU. Поскольку традиционные шины PCIe (PCI Express) не могут обеспечить такую пропускную способность, NVIDIA разработала собственный высокоскоростной интерконнект под названием NVLink. Кроме того, через коммутаторные чипы NVSwitch, кластеры из 8 или 256 GPU соединяются полностью неблокирующим матричным коммутатором, создавая кластер, который ведет себя как один огромный GPU.
6.2 Экосистема Transformer Engine и FP8
Чтобы оптимизировать архитектуру Transformer, ставшую фактическим стандартом не только в обработке естественного языка, но и в распознавании изображений и речи, архитектура Hopper включает специализированный аппаратно-программный механизм согласования, называемый Transformer Engine. Он динамически отслеживает статистику тензоров и автоматически переключает точность вычислений между FP8 и FP16 для каждого слоя (Dynamic Scaling), предотвращая деградацию точности и обеспечивая предельную скорость вычислений с экономией пропускной способности памяти.
6.3 Законы масштабирования кластеров GPU и перспективы
Как показывают “Законы масштабирования” (Scaling Laws) OpenAI, чем больше параметров модели и объем вычислений, тем выше производительность ИИ. В связи с этим GPU эволюционировал от простого процессора к “центру обработки данных, как единому гигантскому GPU (суперкомпьютеру)”, где десятки тысяч устройств соединены оптоволокном.
Будущая эволюция архитектур, вероятно, будет двигаться в сторону внедрения кремниевой фотоники (оптических интерконнектов), CPO (Co-Packaged Optics) и дальнейшего развития технологий 3D-упаковки от SRAM к HBM. Тем не менее, “максимизация пропускной способности за счет параллельной обработки”, ДНК GPU с момента его создания, продолжит прокладывать путь на передовых рубежах вычислительной науки.
【Дополнительное исследование】 Математический анализ планирования и занятости (occupancy) в GPU
title: “Архитектура массового параллелизма графических процессоров и физика CUDA: принципы вычислений SIMT, варпов и тензорных ядер” description: “Внутреннее устройство графических процессоров, стремящееся к максимальной пропускной способности. Суть SM, планирования варпов, тензорных ядер и оптимизации разделяемой памяти.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
Архитектура массового параллелизма графических процессоров и физика CUDA: принципы вычислений SIMT, варпов и тензорных ядер
Фундаментальной технологией, лежащей в основе современных передовых вычислительных наук, искусственного интеллекта, глубокого обучения и графики высокого разрешения, является графический процессор (Graphics Processing Unit). В этой статье мы глубоко проанализируем архитектуру графического процессора и физические/аппаратные аспекты платформы параллельных вычислений CUDA (Compute Unified Device Architecture), работающей на ней. Это не просто синтаксис программирования, а тщательное рассмотрение с точки зрения потоковых мультипроцессоров (SM), модели исполнения SIMT, планирования варпов, тензорных ядер и иерархии памяти, чтобы понять “почему аппаратное обеспечение спроектировано именно так” и “как оно достигает предельной вычислительной пропускной способности”.
Дополнение к главе 1: Развилка в философии проектирования процессоров общего назначения и графических процессоров
1.1 Стремление к низкой задержке против высокой пропускной способности
Процессоры общего назначения (Central Processing Unit) и специализированные для параллельных вычислений графические процессоры принципиально отличаются по своей философии проектирования, исходя из истории их создания. Процессор общего назначения развивался с приоритетом на “низкую задержку” (минимизацию задержки) — как максимально быстро завершить одну задачу (поток). В свою очередь, графический процессор стремится к “высокой пропускной способности” (максимизации объема обработки) — как собрать вместе огромное количество задач и максимизировать объем работы, выполняемой за единицу времени в целом.
Процессор общего назначения должен быстро справляться с непредсказуемыми процессами, такими как управление операционной системой, выполнение приложений со сложными ветвлениями и обработка случайных прерываний от пользователя. По этой причине он оснащен сложными схемами предсказания ветвлений, механизмом внеочередного исполнения (out-of-order execution) и огромными кэшами L1/L2/L3, скрывающими задержки доступа к памяти, максимизируя производительность одного потока.
Напротив, графический процессор изначально был создан для обработки высокопараллельных задач, таких как применение одних и тех же операций шейдинга к миллионам пикселей на экране. Вместо того чтобы тратить площадь кристалла на сложные схемы управления и огромные кэши, был выбран путь размещения максимально возможного количества простых арифметико-логических устройств (ALU).
1.2 Распределение площади кристалла между кэшем, схемами управления и ALU
То, как распределяется ограниченная площадь кремниевого кристалла (бюджет транзисторов), определяет архитектурные различия между ними.
- Распределение площади процессора общего назначения: Более половины кристалла занимают большие кэши (SRAM) и сложные схемы управления (предсказание ветвлений, выборка инструкций, декодирование, планирование и т.д.). Доля ALU, выполняющих фактические вычисления, относительно мала.
- Распределение площади графического процессора: Кэш-память и схемы управления сведены к абсолютному минимуму, а большая часть кристалла занята от нескольких тысяч до десятков тысяч ALU (ядер CUDA).
Графический процессор скрывает задержку (latency) доступа к памяти не с помощью кэшей, а путем “переключения контекста”. Пока одна группа потоков ждет поступления данных из памяти, он немедленно выполняет вычисления для другой группы потоков, поддерживая вычислительные блоки в постоянно рабочем состоянии (высокая занятость: occupancy). Это физическая реализация “стремления к высокой пропускной способности” в графическом процессоре. Поскольку аппаратная многопоточность (Hardware Multithreading) выполняется с чрезвычайно низкими затратами, предполагается наличие от нескольких тысяч до десятков тысяч параллельных потоков.
Дополнение к главе 2: Суть модели исполнения SIMT
2.1 Разница между SIMD и SIMT
Хотя в таксономии Флинна (Flynn’s taxonomy) классификации параллельной обработки модель выполнения графических процессоров часто сравнивают с SIMD (Single Instruction, Multiple Data), векторные расширения процессора общего назначения (такие как AVX) — это чистый SIMD, где одна инструкция одновременно обрабатывает несколько данных (например, 8 32-битных чисел с плавающей запятой в 256-битном регистре). В SIMD очень сложно выполнять разные ветвления (if-else) для каждого элемента данных.
С другой стороны, модель выполнения CUDA, предложенная NVIDIA, называется SIMT (Single Instruction, Multiple Threads). В SIMT несколько независимых “потоков” образуют группы (называемые “варпами”, см. ниже), и выполняют общую инструкцию. Однако в отличие от SIMD, каждый поток SIMT имеет независимое состояние регистров и счетчик адреса инструкций (с точки зрения модели программирования). Это позволяет программистам писать код так, как будто каждый поток работает независимо.
2.2 “Варп (Warp)” — единица из 32 потоков
Аппаратное обеспечение графического процессора не планирует каждый поток индивидуально, а управляет и выполняет их группами по 32 потока, называемыми “варпом (Warp)”. (В графических процессорах AMD это называется Wavefront, и часто используются единицы по 64 потока).
Блок выборки и декодирования инструкций внутри потокового мультипроцессора (SM) извлекает одну инструкцию для варпа и отправляет (dispatch) ее всем 32 потокам внутри варпа. Иными словами, 32 потока в варпе физически абсолютно одновременно выполняют одну и ту же инструкцию над своими разными данными. В этом заключается суть SIMT.
2.3 Физический штраф за дивергенцию варпа (Warp Divergence)
Хотя каждый поток может вести себя так, будто имеет независимый программный счетчик, физически все потоки в варпе должны выполнять одну и ту же инструкцию. Что же происходит, если в коде есть условное ветвление типа if-else, и значения условия для потоков внутри варпа оказываются разными?
Это явление называется дивергенцией варпа (Warp Divergence: расхождение ветвления).
При возникновении дивергенции варпа аппаратура выполняет обработку в следующие этапы:
- Сначала она выполняет инструкцию только для тех потоков, где условие
ifоказалось истинным (активные потоки). В это время потоки, где условие оказалось ложным, “маскируются” (отключаются), и результаты их вычислений не записываются. - Затем она переходит к ветке
else(или пути, когда условие ложно), на этот раз активируя ранее замаскированные потоки и маскируя те, для которых условие было истинным, и выполняет инструкцию.
То есть, при наличии нескольких путей ветвления аппаратура вынуждена выполнять их не параллельно, а последовательно (серийно). Как крайний пример, если 32 потока в варпе пойдут по 32 разным путям, время выполнения возрастет в 32 раза. Дивергенция варпа является одним из главных факторов резкого падения вычислительной пропускной способности графического процессора, и это антипаттерн, которого следует всеми силами избегать при проектировании алгоритмов. Физически это означает появление “пустых циклов”, когда ALU потребляют энергию, но из-за маскировки не создают полезных результатов вычислений.
Дополнение к главе 3: Аппаратный разбор потокового мультипроцессора (SM)
Графический процессор состоит из множества потоковых мультипроцессоров (SM: Streaming Multiprocessor). SM — это настоящий вычислительный двигатель графического процессора. В новейших архитектурах (например, Hopper H100) на одном кристалле графического процессора размещается более 100 SM.
3.1 Структура конвейера внутри SM
Внутри SM дополнительно разделен на несколько подгрупп (обычно четыре), каждая из которых имеет независимый планировщик варпов и блок диспетчеризации.
- Планировщик варпов (Warp Scheduler): Выбирает варп, находящийся в состоянии готовности к выполнению (когда регистры и память готовы). Планировщик графического процессора может переключать варпы с нулевыми накладными расходами, что является ключом к сокрытию задержек доступа к памяти.
- Блок диспетчеризации (Dispatch Unit): Выдает инструкции запланированному варпу.
- Ядра CUDA (INT32 / FP32 / FP64 ALU): Блоки, выполняющие фактические вычисления с целыми числами или числами с плавающей запятой.
- Блок загрузки/сохранения (LD/ST Unit): Отвечает за чтение и запись в память.
- Специальные функциональные блоки (SFU): Выделенное аппаратное обеспечение для быстрого вычисления трансцендентных функций, таких как sin, cos, exp, обратная величина и т.д.
Конвейер инструкций спроектирован очень глубоким и включает стадии выборки, декодирования, планирования, чтения регистров, выполнения (многоцикловое) и обратной записи. Задержка операции FMA (Fused Multiply-Add) для FP32 обычно составляет от нескольких до более десятка тактов, но выдавая инструкции из разных варпов на каждом такте, конвейер всегда поддерживается полным.
3.2 Огромный регистровый файл и регистровое давление
SM оснащен регистровым файлом, который несравним по размеру с процессором общего назначения (например, 64-256 КБ SRAM на один SM). Это необходимо для сохранения контекста всех тысяч потоков, выполняющихся одновременно на SM.
Переключение контекста выполняется за ноль тактов именно потому, что нет необходимости вытеснять (spill) состояние регистров потока в память. Однако если количество регистров, используемых одним потоком, увеличивается, количество варпов, которые могут быть запущены одновременно на SM (occupancy), снижается. Это называется регистровым давлением (Register Pressure). При истощении регистров данные вытесняются в медленную локальную память (физически это часть глобальной памяти), что приводит к катастрофическому падению производительности.
3.3 Разделяемая память (Shared Memory) и конфликты банков
В SM существует сверхбыстрая внутричиповая память под названием разделяемая память (Shared Memory), которой программист может явно управлять. Она делит одну и ту же физическую область SRAM с кэшем L1, но работает как явный кэш данных и используется для совместного доступа к данным и синхронизации между потоками в блоке.
Физическая структура разделяемой памяти разделена на несколько независимых модулей (обычно 32), называемых банками памяти (Memory Banks). Последовательные 32-битные адреса чередуются (распределяются) по разным банкам.
Если 32 потока в варпе одновременно обращаются к разным банкам, доступ обрабатывается полностью параллельно (за 1 такт). Это называется доступом без конфликтов банков. Однако если несколько потоков пытаются одновременно обратиться к разным адресам одного и того же банка, запросы сериализуются, что приводит к штрафу (задержке). Это называется конфликтом банков (Bank Conflict). Например, при 2-канальном конфликте время доступа удваивается, а в худшем случае, при 32-канальном конфликте, оно увеличивается в 32 раза. В алгоритмах вроде транспонирования матриц доступ с шагом вызывает серьезные конфликты банков, поэтому необходимо применять сложные оптимизации, такие как дополнение (padding - вставка фиктивных данных для смещения адресов), чтобы избежать конфликтов.
Дополнение к главе 4: Конвейер вычислений суммы произведений тензорных ядер (Tensor Core)
Революционное аппаратное обеспечение, впервые представленное в архитектуре Volta, которое резко повысило производительность последующих графических процессоров, — это тензорные ядра (Tensor Core). Взрывное развитие ИИ и глубокого обучения невозможно без тензорных ядер.
4.1 Аппаратная реализация операций суммы произведений матриц (MMA)
Большая часть вычислений в глубоком обучении — это перемножение матриц (GEMM: General Matrix Multiply) весов нейронной сети и входных данных. Уравнение можно представить как $D = A \times B + C$ (где $A, B$ - входные матрицы, $C$ - матрица аккумулятора).
В традиционных ядрах CUDA это перемножение матриц вычислялось поэлементно с использованием инструкций FMA (Fused Multiply-Add). В отличие от них, тензорное ядро — это специализированная схема, которая выполняет операции суммы произведений небольших матриц (например, 4x4 или 16x16) на аппаратном уровне за 1 такт (или несколько тактов).
Физически от десятков до сотен умножителей и огромное дерево сумматоров соединены проводами напрямую, завершая всю операцию за один проход без возврата промежуточных результатов в регистры. Благодаря этому пропускная способность вычислений на единицу площади (TFLOPS) на порядки выше, чем у обычных ядер CUDA.
4.2 Секреты смешанной точности (Mixed-Precision)
Еще одной сутью тензорных ядер является поддержка вычислений со смешанной точностью (Mixed-Precision). В глубоком обучении часто встречаются ситуации, когда высокая точность (FP32/FP64) не требуется в процессе вычислений. Тензорное ядро имеет конвейер, который загружает входные матрицы $A$ и $B$ с низкой точностью (FP16, BF16 или даже FP8, INT8, INT4), выполняет внутренние умножения с низкой точностью, а затем выполняет процесс сложения (аккумуляции) с более высокой точностью (FP32 или INT32).
- FP16 / BF16: Стандарт для обучения. У BF16 (Bfloat16) экспонента состоит из 8 бит, как и у FP32, поэтому широкий динамический диапазон помогает предотвратить исчезновение градиента.
- FP8 / INT8 / INT4: Козырь для ускорения вывода (Inference). Объем передачи данных (пропускная способность памяти) также сокращается, что резко увеличивает пропускную способность.
В архитектуре Hopper были внедрены “FP8 Tensor Core”, которые радикально ускоряют вычисления моделей Transformer, обеспечивая теоретическую пропускную способность в десятки раз выше, чем FP32. Со стороны программного обеспечения (CUDA), тензорные ядра управляются напрямую через API wmma (Warp-Level Matrix Multiply and Accumulate) или инструкции PTX mma.sync, а потоки внутри варпа кооперируются для загрузки, вычисления и сохранения фрагментов матриц в регистры, выполняя чрезвычайно сложные коллективные операции.
Дополнение к главе 5: Иерархия памяти CUDA и методы оптимизации
Какой бы высокой ни была вычислительная мощность графического процессора, производительность не будет достигнута, если узким местом станет подача данных (проблема стены памяти). Не будет преувеличением сказать, что 90% оптимизации в программировании на CUDA — это “оптимизация доступа к памяти”.
5.1 Объединенный (Coalescing) доступ к глобальной памяти
Главная память графического процессора (HBM или GDDR) — глобальная память — обладает огромной пропускной способностью (например, несколько ТБ/с), но и задержка очень велика (сотни тактов).
Абсолютное правило для максимизации эффективности доступа к глобальной памяти — это объединение (Coalescing). Контроллер памяти графического процессора обращается к памяти транзакциями по 32, 64 или 128 байт. Когда 32 потока в варпе обращаются к памяти, и их адреса находятся в непрерывной области (выровненные по границе 128 байт), аппаратура объединяет (coalesce) эти запросы в одну транзакцию памяти.
Напротив, если потоки обращаются к случайным адресам или выполняют доступ с шагом (stride), объединение не происходит, и генерируются множественные транзакции. Это называется “необъединенным доступом” (uncoalesced access) и является критическим багом производительности, снижающим эффективную пропускную способность памяти в десятки раз.
5.2 Пример кода CUDA C++: оптимизация транспонирования матриц и разделяемая память
Ниже приведен пример оптимизированного кода ядра для транспонирования матрицы, который избегает необъединенного доступа и радикально улучшает производительность за счет использования разделяемой памяти.
| |
В этом коде есть 3 ключевых момента:
- Объединение при чтении: Чтение из
idataпроисходит по направлению X, гдеthreadIdx.xидут последовательно, поэтому оно полностью объединяется. - Объединение при записи: Запись в
odataтакже спроектирована так, чтобы идти последовательно в направленииthreadIdx.xпутем обмена координат блока, что позволяет объединить транзакции. - Заполнение (Padding) в разделяемой памяти: Смещая на 1 элемент (padding) как
tile[TILE_DIM][TILE_DIM + 1], мы полностью исключаем конфликты банков при доступе по направлению столбца (tile[threadIdx.x][threadIdx.y + j]) во время записи.
5.3 Иерархия кэшей и специальная память
- Политика кэширования L1/L2: В современных архитектурах графических процессоров программист может управлять поведением кэша с помощью инструкций PTX (например,
.ca,.cg,.cs) как подсказками. Например, данные, к которым происходит однократный доступ, могут обходить кэш L2 (потоковый доступ), что предотвращает загрязнение кэша. - Текстурная память / Константная память: Текстурная память, специализированная для обработки изображений, использует специальный кэш для доступа с двумерной пространственной локальностью. Константная память обеспечивает невероятную эффективность для широковещательного доступа, когда все потоки читают одну и ту же константу.
Дополнение к главе 6: Будущее графических процессоров в эпоху глубокого обучения
Сегодняшний фронтир вычислительной науки — это не только повышение производительности отдельного графического процессора, но и масштабирование всей системы в целом.
6.1 Сверхбыстрые межсоединения NVLink и NVSwitch
Огромные LLM (большие языковые модели) не помещаются в память одного графического процессора (например, 80 ГБ или 144 ГБ). Чтобы выполнить распараллеливание моделей (тензорный или конвейерный параллелизм), необходимо ежесекундно обмениваться терабайтами данных между графическими процессорами. Поскольку традиционные шины PCIe (PCI Express) не могут обеспечить такую пропускную способность, NVIDIA разработала собственный высокоскоростной интерконнект под названием NVLink. Кроме того, через коммутаторные чипы NVSwitch, кластеры из 8 или 256 графических процессоров соединяются полностью неблокирующим матричным коммутатором, создавая кластер, который ведет себя как один огромный графический процессор.
6.2 Экосистема Transformer Engine и FP8
Чтобы оптимизировать архитектуру Transformer, ставшую фактическим стандартом не только в обработке естественного языка, но и в распознавании изображений и речи, архитектура Hopper включает специализированный аппаратно-программный механизм согласования, называемый Transformer Engine. Он динамически отслеживает статистику тензоров и автоматически переключает точность вычислений между FP8 и FP16 для каждого слоя (Dynamic Scaling), предотвращая деградацию точности и обеспечивая предельную скорость вычислений с экономией пропускной способности памяти.
6.3 Законы масштабирования кластеров графических процессоров и перспективы
Как показывают “Законы масштабирования” (Scaling Laws) OpenAI, чем больше параметров модели и объем вычислений, тем выше производительность ИИ. В связи с этим графический процессор эволюционировал от простого процессора к “центру обработки данных, как единому гигантскому графическому процессору (суперкомпьютеру)”, где десятки тысяч устройств соединены оптоволокном.
Будущая эволюция архитектур, вероятно, будет двигаться в сторону внедрения кремниевой фотоники (оптических интерконнектов), CPO (Co-Packaged Optics) и дальнейшего развития технологий 3D-упаковки от SRAM к HBM. Тем не менее, “максимизация пропускной способности за счет параллельной обработки”, ДНК графического процессора с момента его создания, продолжит прокладывать путь на передовых рубежах вычислительной науки.
Заключение: К крайнему северу вычислительной науки
Архитектура GPU — это самый сложный и в то же время наиболее специализированный на пропускной способности вычислительный движок, когда-либо созданный человечеством. Если CPU — это “одна сверхвысокопроизводительная машина Формулы-1”, то GPU можно сравнить с “гигантской логистической системой, где десятки тысяч самосвалов одновременно перевозят грузы согласованными движениями”.
Выполнение инструкций варпами через SIMT, аппаратное планирование, переключающее тысячи потоков за ноль тактов, объединенный доступ (coalescing), выжимающий максимальную пропускную способность, и конвейер тензорных ядер, ставший локомотивом прорыва в глубоком обучении. Все это — кристаллизация одержимости инженеров, граничащей с безумием, вопросом “как максимизировать общий объем вычислений с плавающей запятой в пределах физических законов (скорость света, тепло, мощность, пределы миниатюризации кремния)”.
Для будущих инженеров-программистов, исследователей ИИ и специалистов по высокопроизводительным вычислениям (HPC) понимание архитектуры GPU — это не просто эрудиция. Это “обязательный предмет” для интуитивного понимания того, что происходит “под капотом” фреймворков (PyTorch или TensorFlow), и для использования возможностей аппаратного обеспечения до предела. Избежать конфликтов банков памяти, устранить дивергенцию варпов, постоянно заполнять данными конвейеры тензорных ядер. В конце концов, благодаря этой оптимизации будущее, в котором вычисления, занимавшие месяцы на суперкомпьютерах, завершаются за несколько часов на паре GPU на столе, становится реальностью прямо сейчас.
Мы живем в золотой век самой захватывающей компьютерной архитектуры в истории человечества. И, возможно, именно вы, читающие эту статью, поймете суть физики CUDA и архитектуры массового параллелизма GPU и создадите инновации следующего поколения.
Словарь терминов (Glossary)
- SM (Streaming Multiprocessor): Основной вычислительный блок GPU. Эквивалентен ядру в CPU, но содержит внутри себя множество ядер CUDA, планировщики варпов, разделяемую память и т.д.
- SIMT (Single Instruction, Multiple Threads): Уникальная модель исполнения GPU, где все потоки в варпе разделяют одну и ту же инструкцию, но выполняют операции с независимыми данными.
- Warp (Варп): Группа из 32 потоков. Минимальная единица для аппаратного планирования и выдачи инструкций.
- Warp Divergence (Дивергенция варпа): Явление, при котором условия ветвления для потоков внутри варпа расходятся, пути выполнения сериализуются, и пропускная способность снижается.
- Tensor Core (Тензорное ядро): Выделенная схема, которая выполняет операции суммы произведений матриц (MMA) за один проход на аппаратном уровне. Специализируется на ускорении глубокого обучения.
- Coalesced Access (Объединенный доступ): Механизм, при котором аппаратное обеспечение объединяет запросы в одну транзакцию, если потоки в варпе обращаются к последовательным адресам памяти, обеспечивая широкую пропускную способность.
- Shared Memory (Разделяемая память): Управляемая программистом сверхбыстрая память L1 (scratchpad), встроенная в SM.
- Bank Conflict (Конфликт банков): Штраф в разделяемой памяти, когда несколько потоков одновременно обращаются к разным адресам в одном банке, и доступ сериализуется.
- Occupancy (Занятость / Оккупанси): Фактическое соотношение количества активных варпов на SM к теоретическому максимуму. Чем выше, тем легче скрыть задержку доступа к памяти.
- Register Spilling (Вытеснение регистров): Явление, при котором количество регистров, используемых потоком, превышает аппаратный предел, и переполненные данные сохраняются в медленную память (локальную память).
Литература и список рекомендуемых источников для чтения
- NVIDIA CUDA C++ Programming Guide: Официальная документация, которую должен прочитать каждый программист CUDA. Охватывает шаблоны доступа к памяти и лучшие практики оптимизации.
- NVIDIA Ampere / Hopper Architecture Whitepaper: Официальные белые книги с подробным описанием конвейера тензорных ядер, асинхронной передачи памяти и аппаратной реализации Transformer Engine.
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): Классический шедевр по архитектуре компьютеров. Позволяет глубоко изучить разницу в философии проектирования CPU и GPU, иерархию кэшей и параллелизм на уровне инструкций.
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): Учебник, объясняющий программирование на CUDA с точки зрения проектирования алгоритмов. Подробно описываются методы тайлинга разделяемой памяти, редукция, префиксная сумма и их реализация.
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: Академическая статья. Шедевр, раскрывающий неопубликованные NVIDIA задержки кэшей и точную пропускную способность тензорных ядер с помощью микробенчмарков.
Хотя знания архитектуры, описанные в этой статье, могут частично устареть с развитием аппаратного обеспечения, фундаментальные физические принципы “максимизации пропускной способности, извлечения параллелизма и сокрытия задержек” останутся универсальными истинами компьютерной науки.