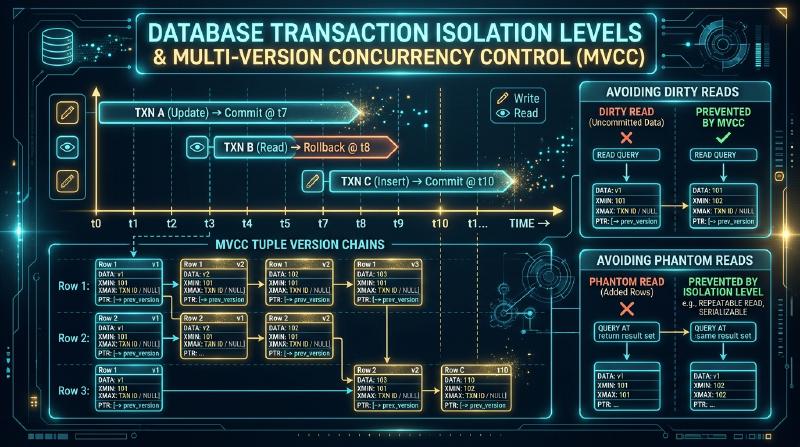
Уровни изоляции транзакций баз данных и MVCC: Реальность ACID и многоверсионное управление конкурентным доступом
В современной архитектуре программного обеспечения системы управления реляционными базами данных (СУБД) продолжают оставаться краеугольным камнем сохранения данных. В их основе лежит концепция «транзакций», и в частности, свойства ACID (Atomicity, Consistency, Isolation, Durability) широко признаны в качестве фундаментальной теории для создания надежных систем. Однако среди свойств ACID именно «Isolation (Изоляция)» является областью, где существует наибольший разрыв между теорией и практикой.
В этой статье мы глубоко погрузимся в исторический контекст уровней изоляции транзакций баз данных, ограничения стандарта ANSI SQL-92 и внутреннее устройство Multi-Version Concurrency Control (MVCC: многоверсионное управление конкурентным доступом), применяемое в современных ядрах баз данных, с предельно детальной, академической и практической точек зрения. В частности, мы разберем решающие различия в реализации MVCC двух крупнейших open-source СУБД — PostgreSQL и MySQL (InnoDB), и охватим передовой рубеж распределенных баз данных — сериализуемую изоляцию снимков (SSI). Представляем вам этот монументальный труд объемом более 12 000 символов.
Глава 1: Миф о свойствах ACID и дилемма параллельной обработки
1.1 Идеал сериализуемости (Serializability)
Конечным идеалом, к которому стремится Isolation (Изоляция) транзакций, является «Сериализуемость (Serializability)». Это свойство означает, что даже когда несколько транзакций выполняются параллельно и одновременно, результат их выполнения «эквивалентен результату, если бы транзакции выполнялись последовательно (серийно) одна за другой в некотором порядке».
Когда транзакции $T_1$ и $T_2$ выполняются в системе одновременно, независимо от того, как происходит чередование (пересечение операций) из-за параллельного выполнения, если конечное состояние базы данных полностью совпадает с результатом последовательного выполнения «$T_1 \rightarrow T_2$» или «$T_2 \rightarrow T_1$», такое расписание определяется как сериализуемое. Если эта сериализуемость гарантирована, разработчики приложений могут полностью сосредоточиться на создании бизнес-логики, не заботясь о несогласованности данных (состоянии гонки, некорректной перезаписи и т.д.), вызванной параллельной обработкой.
1.2 Крах производительности из-за сериализации на основе блокировок
В ранних системах баз данных для обеспечения этой сериализуемости использовался строгий механизм блокировок, называемый «Двухфазная блокировка (2PL: Two-Phase Locking)». В 2PL транзакция должна получить блокировку (разделяемую или эксклюзивную) перед чтением или записью данных (Фаза 1: Growing Phase) и освобождает все блокировки в конце транзакции (при фиксации или откате) (Фаза 2: Shrinking Phase).
Однако у этого строгого механизма блокировок был фатальный недостаток. Это «экстремальное снижение производительности».
- Операции чтения блокируют операции записи.
- Операции записи блокируют операции чтения.
- Увеличение времени ожидания из-за конфликтов блокировок и частое возникновение взаимоблокировок (deadlocks).
Когда трафик увеличился и множество пользователей начали одновременно получать доступ к базе данных, полная сериализация с помощью 2PL стала узким местом системы, и пропускная способность резко упала. Системы столкнулись с дилеммой компромисса между «согласованностью данных» и «производительностью параллельной обработки (пропускной способностью)».
1.3 История управления конкурентным доступом и компромиссы
Чтобы решить эту дилемму, исследователи в области инженерии баз данных ввели понятие «Уровни изоляции (Isolation Level)». Это «продукт компромисса», который частично ослабляет полную сериализуемость и допускает возникновение определенных несогласованностей данных (аномалий) в обмен на повышение производительности параллельной обработки. Это позволило выбирать баланс между согласованностью и производительностью в зависимости от требований приложения.
Глава 2: Уровни изоляции стандарта ANSI SQL-92 и их критика
2.1 Определение уровней изоляции по стандарту ANSI SQL-92
В стандарте SQL «SQL-92», принятом в 1992 году, были определены 4 уровня изоляции, основанные на 3 типичных аномалиях (Phenomena), которые могут возникнуть при параллельной обработке.
3 определенные аномалии (Phenomena)
- Dirty Read (Грязное чтение): Явление, при котором транзакция $T_1$ обновляет данные, и до того, как она зафиксируется, другая транзакция $T_2$ считывает эти незафиксированные данные. Если $T_1$ откатывается, $T_2$ оказывается прочитавшей фантомные данные, которых не существует.
- Non-repeatable Read (Неповторяющееся чтение): Явление, при котором транзакция $T_1$ считывает одну и ту же строку дважды, а между этими чтениями другая транзакция $T_2$ обновляет и фиксирует эту строку. В результате первое и второе чтение $T_1$ возвращают разные результаты.
- Phantom Read (Фантомное чтение): Явление, при котором транзакция $T_1$ считывает несколько строк по определенному условию поиска, а в это время другая транзакция $T_2$ вставляет (или удаляет) новые строки, соответствующие этому условию, и фиксирует их. Если $T_1$ повторяет поиск с тем же условием, количество строк изменяется.
4 уровня изоляции по стандарту SQL-92
SQL-92 определил уровни изоляции в соответствии со степенью предотвращения этих аномалий.
- Read Uncommitted: Допускает грязное чтение.
- Read Committed: Предотвращает грязное чтение, но допускает неповторяющееся и фантомное чтение.
- Repeatable Read: Предотвращает грязное и неповторяющееся чтение, но допускает фантомное чтение.
- Serializable: Предотвращает все аномалии и гарантирует полную сериализуемость.
2.2 Критическая статья Беренсона и соавторов «A Critique of ANSI SQL Isolation Levels»
На первый взгляд определение стандарта SQL-92 кажется очень четким и логичным. Однако статья «A Critique of ANSI SQL Isolation Levels», опубликованная в 1995 году гигантами баз данных Хэлом Беренсоном (Hal Berenson), Джимом Греем (Jim Gray, лауреат премии Тьюринга), Филом Бернштейном (Phil Bernstein) и другими, нанесла сокрушительный удар по этому стандарту ANSI.
Основные недостатки стандарта SQL-92, отмеченные в этой статье:
1. Неявное предположение об использовании блокировок
Определение SQL-92 неявно предполагало, что «база данных реализована с управлением конкурентным доступом на основе блокировок (2PL)». Однако в 1990-х годах уже начали появляться базы данных, использующие MVCC (описано ниже) и другие механизмы оптимистичного управления конкурентным доступом (OCC), и определение аномалий на основе блокировок становилось устаревшим.
2. Неоднозначность и неполнота определения
Было указано, что 3 аномалий, определенных в SQL-92 (Dirty Read, Non-repeatable Read, Phantom Read), недостаточно, чтобы охватить все возможные аномалии при параллельной обработке. Например, существует явление «Dirty Write (Грязная запись)». Это когда незафиксированная транзакция перезаписывает данные, записанные другой незафиксированной транзакцией. Но в стандарте SQL-92 нет упоминания о грязной записи. Хотя все уровни изоляции (включая Read Uncommitted) должны предотвращать грязную запись (иначе внутренняя целостность базы данных рухнет), стандарт об этом умалчивал.
3. Обнаружение новых аномалий
В статье было определено несколько новых аномалий, отсутствующих в стандарте SQL-92. Вот 2 самых типичных:
- Lost Update (Потерянное обновление): Явление, при котором две транзакции одновременно считывают одни и те же данные, и когда каждая из них записывает результат вычислений обратно, одно обновление перезаписывает и стирает другое.
- Write Skew (Перекос записи): Специфическое явление для изоляции снимков, описанной ниже.
Статья Беренсона и его коллег доказала, что стандарт SQL-92 не смог математически и строго определить уровни изоляции, и произвела огромный эффект в индустрии баз данных. В современной теории баз данных определения уровней изоляции ANSI SQL-92 рассматриваются как «вещи, которые следует изучать в историческом контексте», а не как «строгие технические определения».
Глава 3: Изоляция снимков (Snapshot Isolation) и перекос записи (Write Skew)
3.1 Разница между Repeatable Read и изоляцией снимков
Особое внимание в статье Беренсона было уделено предложению нового уровня изоляции — «Изоляция снимков (Snapshot Isolation: SI)».
Во многих базах данных, использующих MVCC (например, PostgreSQL и Oracle), уровень изоляции, предоставляемый как «Repeatable Read», на самом деле является этой «изоляцией снимков». При изоляции снимков каждая транзакция выполняет чтение на согласованном «снимке (предыдущем статичном состоянии)» базы данных на момент начала транзакции.
- Обновления, сделанные другими транзакциями после начала текущей транзакции, совершенно невидимы (предотвращение неповторяющегося чтения).
- Поскольку само существование записей фиксируется на момент в прошлом, INSERT от других транзакций также невидимы (предотвращение фантомного чтения).
То есть изоляция снимков не только удовлетворяет требованиям «Repeatable Read», определенным в SQL-92, но и во многих случаях предотвращает «фантомное чтение». Значит ли это, что изоляция снимков эквивалентна «Serializable»? Ответ «нет». Потому что в изоляции снимков существует фатальная аномалия, которая не является сериализуемой — «Перекос записи (Write Skew)».
3.2 Проблема дежурных врачей по вызову и перекос записи (Write Skew)
Самый известный пример для понимания перекоса записи — «система дежурств врачей по вызову (онколл)».
【Бизнес-правило】 Допустим, в системе управления сменами больницы есть правило: «Как минимум один врач всегда должен быть на дежурстве (on-call)».
В данный момент Алиса и Боб находятся на дежурстве (on_call = true).
В это время Алиса и Боб случайно одновременно решают «Я плохо себя чувствую, хочу сняться с дежурства» и начинают транзакцию изменения смены со своих терминалов.
【Ход транзакции (в условиях изоляции снимков)】
- [Tx1: Алиса] Получает снимок. Видит, что сейчас дежурят двое: Алиса и Боб.
SELECT count(*) FROM doctors WHERE on_call = true;-> Результат: 2 - [Tx2: Боб] Получает снимок. Также видит, что дежурят двое: Алиса и Боб.
SELECT count(*) FROM doctors WHERE on_call = true;-> Результат: 2 - [Tx1: Алиса] Решает, что правило (1 или более дежурных) выполняется, и снимает себя с дежурства.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Боб] Также решает, что правило выполняется, и снимает себя с дежурства.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Алиса] Успешная фиксация (commit).
- [Tx2: Боб] Успешная фиксация. (Поскольку Алиса и Боб обновляют разные записи, конфликта блокировок строк не происходит)
【Результат】 В результате того, что обе Tx1 и Tx2 были зафиксированы, количество дежурных врачей стало «0». Бизнес-правило нарушено.
Это и есть Перекос записи (Write Skew). Если бы это было Serializable, либо Tx1, либо Tx2 выполнилась бы сериализованно первой, поэтому транзакция, выполняемая второй, обнаружила бы, что количество дежурных стало «1», и могла бы отменить (откатить) свою операцию снятия. Однако при изоляции снимков, поскольку обновляются разные строки данных (строка Алисы и строка Боба), конфликт не обнаруживается, что приводит к нарушению бизнес-правила.
3.3 ReadOnly Anomaly (Аномалия только для чтения)
Кроме того, в изоляции снимков существует крайне специфическая аномалия, называемая ReadOnly Anomaly, при которой сериализуемость нарушается из-за вмешательства «транзакции только для чтения». Эта аномалия, часто иллюстрируемая на примере остатков на банковских счетах и начисления процентов, представляет собой явление, при котором транзакция только для чтения, просматривая прошлый снимок, считывает «логически невозможное состояние на временной шкале», несмотря на то, что между транзакциями обновления нет конфликтов. Из-за существования этих аномалий изоляция снимков отличается от Serializable в строгом смысле.
Глава 4: Принцип работы MVCC (Multi-Version Concurrency Control)
До сих пор мы обсуждали теорию уровней изоляции и аномалии, но как современные базы данных их контролируют? Ключевой технологией для этого является MVCC (Multi-Version Concurrency Control: многоверсионное управление конкурентным доступом).
4.1 «Чтение не блокирует запись, а запись не блокирует чтение»
Главная философия дизайна MVCC и решающее отличие от управления на основе блокировок (2PL) заключается в том, что «чтение и запись не блокируют друг друга». При обновлении записи базы данных с MVCC не перезаписывают существующую запись напрямую (In-place update). Вместо этого они создают новую версию записи (версию / кортеж), сохраняя при этом старую версию.
В базе данных одновременно существуют несколько версий одной и той же записи (история от прошлого до настоящего). Когда транзакция читает данные, она вычисляет и читает «правильную прошлую версию, которую ей следует читать» из множества версий, существующих в системе, на основе своего собственного «ID транзакции (XID)» или «времени начала (метки времени)».
Благодаря этому, даже когда какая-то транзакция переписывает запись, другие транзакции могут считывать «прошлую версию до переписывания», избегая ожидания из-за блокировок.
4.2 Цепочка управления версиями кортежей и правила видимости (Visibility)
Самым важным алгоритмом в MVCC является Правило видимости (Visibility Rule), определяющее, «какая транзакция может видеть какую версию данных».
При запуске каждой транзакции назначается монотонно возрастающий уникальный ID транзакции (XID). Каждой версии записи (кортежу), сохраняемой в базе данных, в качестве метаданных добавляется следующая информация:
- XID создания: ID транзакции, которая создала эту версию посредством INSERT/UPDATE.
- XID удаления: ID транзакции, которая логически удалила (аннулировала) эту версию посредством UPDATE/DELETE.
Когда транзакция $T_i$ читает строку данных, она определяет видимость на основе следующих основных правил:
- Зафиксировано ли?: Зафиксирована ли уже транзакция с XID создания?
- Не в будущем ли?: Является ли XID создания транзакцией из прошлого относительно момента начала $T_i$?
- Не удалено ли?: XID удаления не установлен, или транзакция с XID удаления еще не зафиксирована, или это транзакция из будущего относительно начала $T_i$?
Строго оценивая эти условия, каждой транзакции предоставляется согласованный снимок.
Глава 5: Решающие различия в реализации MVCC между PostgreSQL и MySQL (InnoDB)
Даже при одинаковой базовой концепции MVCC внутренние реализации удивительно различаются в зависимости от продукта базы данных. Здесь мы проведем сравнительный анализ архитектуры MVCC двух столпов мира open-source: PostgreSQL и MySQL (InnoDB).
5.1 Реализация MVCC в PostgreSQL: Добавление в кучу и необходимость VACUUM
MVCC в PostgreSQL использует очень уникальную и интуитивно понятную «Архитектуру только для добавления (Append-only)».
5.1.1 Логика оценки битов с помощью xmin и xmax
Внутри файла данных (кучи - heap), который является сущностью таблицы PostgreSQL, в заголовке каждой строки (кортежа) записываются два ID транзакции: xmin и xmax.
xmin(Transaction ID of Insert): XID транзакции, создавшей этот кортеж.xmax(Transaction ID of Delete): XID транзакции, удалившей этот кортеж (или логически удалившей старую версию при обновлении).
【Поведение операции UPDATE】
В PostgreSQL UPDATE логически обрабатывается как комбинация DELETE и INSERT.
- Записать текущий XID транзакции в
xmaxстарого кортежа. (Логическое удаление) - Создать совершенно новый кортеж в свободном пространстве кучи, записать новые данные и установить текущий XID транзакции в
xmin. (Новое добавление)
Другими словами, в одном и том же файле данных таблицы (куче) вперемешку хранятся как старые, так и новые кортежи.
5.1.2 Огромное преимущество и фатальная проблема: Существование VACUUM
Самым большим преимуществом этой архитектуры является чрезвычайно быстрый откат (rollback). При прерывании (abort) транзакции добавленные кортежи можно просто рассматривать как «незафиксированные», без необходимости обратной перезаписи данных.
Однако фатальной проблемой является «разрастание мертвых кортежей (Dead Tuples)».
При повторении UPDATE и DELETE старые версии кортежей (где xmax стал ID старой зафиксированной транзакции), на которые никто больше не ссылается, бесконечно накапливаются в куче. Если оставить это без внимания, физический размер таблицы взрывообразно увеличится, а производительность последовательного сканирования (sequential scan) катастрофически упадет.
Системным процессом для физического удаления этих мертвых кортежей и освобождения места для повторного использования является VACUUM (и автоматически запускаемый демон autovacuum). Причина, по которой настройка VACUUM считается критически важной при эксплуатации PostgreSQL, кроется в самой основе этой архитектуры MVCC.
5.2 Реализация MVCC в MySQL InnoDB: Обновление на месте и динамическая реконструкция Undo-логов
С другой стороны, InnoDB, механизм хранения данных по умолчанию в MySQL, использует архитектуру, близкую к Oracle Database: «Обновление на месте (In-place update) и Undo-логи (сегмент отката)».
5.2.1 Кластерный индекс и обновление на месте
Таблицы InnoDB организованы как B+Tree (кластерный индекс) на основе первичного ключа.
Когда в InnoDB выполняется UPDATE, вместо добавления новой строки, как в PostgreSQL, он напрямую перезаписывает строку данных в B+Tree (In-place update).
Так что же делать, если другие транзакции хотят прочитать прошлый снимок? Для этого InnoDB сохраняет «старые данные» до перезаписи в специальную область — Undo-лог (Undo Log Segment).
5.2.2 Динамическая реконструкция прошлого с помощью указателя отката (Roll Pointer)
В скрытых столбцах каждой строки данных InnoDB содержатся следующие два поля:
DB_TRX_ID: ID транзакции, которая последней вставила или обновила эту строку.DB_ROLL_PTR(Roll Pointer): Указатель на местоположение в Undo-логе, где сохранена «предыдущая старая версия» этой строки.
Процесс чтения прошлого снимка транзакцией выглядит следующим образом:
- Прочитать самую новую строку данных из B+Tree.
- Проверить
DB_TRX_ID. Если обновление было выполнено транзакцией, которая старше (из будущего), чем снимок читающего, решить, что эту новейшую строку читать нельзя. - Пройти по
DB_ROLL_PTRи извлечь предыдущую версию данных из Undo-лога. - Используя данные из Undo-лога, динамически реконструировать (Rollback in memory) состояние прошлой записи в оперативной памяти.
- Если это всё еще будущее обновление, продолжить движение назад в прошлое по цепочке Undo-лога.
5.2.3 Преимущества и недостатки InnoDB
Преимущество этой архитектуры в том, что основная область таблицы (табличное пространство) не так легко разрастается. Самые новые данные всегда находятся в правильном месте B+Tree, а прошлые версии изолированы в другой области (Undo-логе), что обеспечивает высокую эффективность физического сканирования (нет необходимости в масштабном VACUUM, как в PostgreSQL, а процесс очистки Undo-лога (purge) работает в фоновом режиме легко).
Недостатком является то, что при наличии долго выполняющихся транзакций (например, пакетной обработки или mysqldump), которые считывают множество прошлых снимков, возникают накладные расходы на глубокий проход по Undo-логам и реконструкцию данных, что снижает производительность чтения. Также существует риск того, что сам Undo-лог разрастется и съест дисковое пространство.
Глава 6: Сериализуемая изоляция снимков (SSI) и передовой рубеж распределенных баз данных
Эволюция MVCC на этом не заканчивается. Как пояснялось в Главе 3, изоляция снимков (SI) имеет аномалии, такие как «перекос записи», и не является полностью Serializable. Однако, чтобы избавить разработчиков приложений от необходимости учитывать сложности параллельной обработки, необходимо реализовать полную сериализуемость, сохраняя при этом высокую производительность MVCC.
6.1 Рождение сериализуемой изоляции снимков (SSI)
В 2008 году в статье Майкла Кэхилла (Michael Cahill) и соавторов был представлен революционный алгоритм — «Serializable Snapshot Isolation (SSI)». Это технология, которая гарантирует полную сериализуемость (Serializable), основываясь на архитектуре MVCC. PostgreSQL с версии 9.1 одним из первых внедрил SSI в качестве реализации уровня изоляции «Serializable».
Принцип работы SSI: Граф конфликтов и опасные структуры (rw-antidependency)
SSI не использует блокировки для ожидания. Вместо этого он тщательно отслеживает, «какие данные были прочитаны (Read), а какие — записаны (Write)» во время выполнения транзакции.
SSI отслеживает конфликтные отношения между транзакциями и ищет специфические паттерны конфликтов, называемые «rw-antidependency (антизависимость чтение-запись)». В частности, это отношение, когда транзакция $T_1$ читает прошлую версию данных, а позже другая транзакция $T_2$ перезаписывает и фиксирует эти же данные. SSI внутренне строит граф конфликтов транзакций, и как только обнаруживает «структуру, где стрелки rw-antidependency идут подряд две штуки (опасная структура)», он решает, что существует риск разрушения сериализуемости, и принудительно прерывает (откатывает) одну из транзакций.
Благодаря этому транзакция останавливается еще до того, как произойдет аномалия вроде перекоса записи (например, проблема с дежурным врачом), что в итоге гарантирует полный Serializable. Это можно назвать высшей формой оптимистичного управления параллелизмом (OCC).
6.2 MVCC в распределенных базах данных: Spanner, CockroachDB, TiDB
Современные технологии баз данных вышли за пределы одного сервера и эволюционировали в распределенные SQL-базы данных (NewSQL), распределенные по дата-центрам по всему миру. Реализация MVCC с глобальной согласованностью в распределенной среде стала вызовом законам физики.
Google Spanner и API TrueTime
Spanner от Google разработал API TrueTime, чтобы решить проблему упорядочивания транзакций в распределенных системах. Исходя из предпосылки, что часы каждого сервера (физические часы) обязательно расходятся (перекос часов), объединяя GPS и атомные часы, они предоставляют текущее время как «диапазон неопределенности (временное окно)». MVCC в Spanner, ожидая истечения окна неопределенности TrueTime при фиксации транзакции (Commit Wait), физически гарантировал, что «транзакции, имеющие причинно-следственную связь, всегда будут иметь правильный порядок временных меток (Внешняя согласованность / External Consistency)».
CockroachDB и HLC (Hybrid Logical Clock)
CockroachDB, распределенная база данных с открытым исходным кодом, вдохновленная Spanner, использует HLC (гибридные логические часы) для достижения аналогичной согласованности без использования дорогостоящих атомных часов. Объединяя синхронизацию физических часов через NTP и логические часы Лэмпорта (счетчики на основе причинно-следственных связей между событиями), он генерирует глобально согласованные временные метки снимков MVCC между распределенными узлами и реализует SSI (Serializable Snapshot Isolation) в распределенной среде.
TiDB и модель Percolator
TiDB, разрабатываемая компанией PingCAP, использует распределенную транзакционную модель, основанную на модели Google Percolator. Эта архитектура предполагает наличие единого компонента (Placement Driver: PD), который выдает глобальные временные метки, и механизм хранения (TiKV) на каждом узле использует эту метку для локальной обработки MVCC. Основываясь на 2PC (Two-Phase Commit), он минимизирует время удержания блокировок и совмещает огромные транзакции и MVCC в распределенной среде.
Заключение: За пределы ACID
Уровни изоляции транзакций баз данных — это не просто то, что нужно зазубрить. Это сама история десятилетий борьбы компьютерных наук за то, как гармонизировать противоречивые требования согласованности данных и производительности системы.
Начиная с неполного определения ANSI SQL-92, резкого улучшения параллельной обработки за счет MVCC, разделения архитектур PostgreSQL и InnoDB, и заканчивая вызовом абсолютной согласованности с помощью SSI и распределенных баз данных. Глубокое понимание этих внутренних структур должно стать мощным оружием для проектирования более надежных и высокопроизводительных приложений.
Сейчас мы живем в эпоху, когда свойства ACID — это не просто «миф», а нечто, реализуемое как «реальность» с помощью продвинутых алгоритмов и синхронизации физических часов. Для инженера, плавающего в море данных, познание глубин ядра базы данных — это интеллектуальное путешествие, которое никогда не закончится.