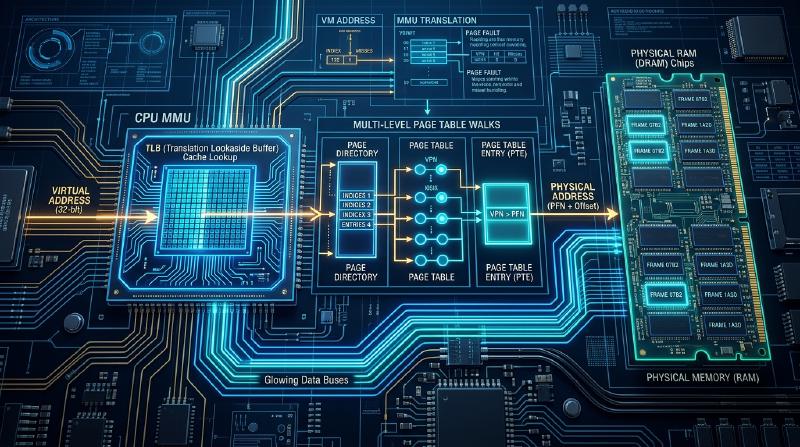
Análise Completa de Memória Virtual e Mecanismo de Paginação: Da MMU ao TLB, HugePage e os Abismos do Gerenciamento de Memória
Nos sistemas operacionais (SO) modernos e na arquitetura de CPUs, um dos sistemas mais complexos e fundamentais é o mecanismo de “Memória Virtual” (Virtual Memory) e “Paginação” (Paging). Por trás do espaço de memória, que geralmente passa despercebido pelos desenvolvedores de aplicações, a MMU (Memory Management Unit) do hardware e o kernel do SO trabalham em estreita colaboração, realizando enormes quantidades de conversões de endereços e tratamento de exceções no mundo dos nanossegundos.
Neste artigo, dissecaremos as profundezas do sistema de memória virtual a partir das perspectivas da estrutura interna do sistema operacional e da arquitetura de computadores. Explicaremos detalhadamente, em nível de código-fonte e registradores, desde o layout completo de bits da estrutura da tabela de páginas da arquitetura x86-64, passando pelo protocolo IPI de TLB shootdown, o rastreamento completo de page faults no kernel do Linux, o mecanismo físico de Copy-on-Write (CoW), até os algoritmos de recuperação (Reclaim) de memória e a fórmula de cálculo de pontuação do OOM Killer.
Capítulo 1: O Motivo da Existência da Memória Virtual e seu Contexto Histórico
Por que os computadores precisam de memória virtual? Nos sistemas de computadores iniciais, os programas acessavam diretamente endereços específicos da memória física (RAM). No entanto, com a popularização de ambientes multitarefa, esse “método de especificação direta de endereço físico” atingiu seu limite.
1.1 Proteção de Memória e Separação Completa do Espaço de Processos
O maior objetivo da memória virtual é “garantir a segurança e estabilidade”. Se o processo A acidentalmente (ou maliciosamente) reescrever a memória do processo B, todo o sistema pode travar ou informações confidenciais podem vazar. A memória virtual dá a cada processo a ilusão de que “possui um espaço de memória contíguo e exclusivo”. Dessa forma, a memória entre os processos é rigorosamente separada em nível de hardware (MMU), e qualquer acesso não autorizado à memória é imediatamente interceptado (trapped) e tratado como um segmentation fault. A separação entre o espaço do usuário (user space) e o espaço do kernel (kernel space) também é realizada por esse mecanismo, sendo a transição de anéis de privilégio (privilege rings) e a verificação de permissões de acesso à memória feitas pelo hardware a cada ciclo.
1.2 Quebrando a Barreira da Capacidade da Memória Física e o Conceito de Demand Paging
Não é incomum que a quantidade de memória solicitada pelas aplicações exceda a capacidade da RAM física instalada. A memória virtual fornece um vasto espaço de endereçamento, maior que a memória física, salvando (swap out) áreas de memória (páginas) que não estão sendo usadas no momento em dispositivos de armazenamento secundário (HDD/SSD) e lendo-as novamente (swap in) quando necessário. Além disso, através da filosofia de “Demand Paging” (paginação sob demanda), em que códigos ou dados não são totalmente carregados na memória no início da execução do programa, mas apenas quando um acesso ocorre pela primeira vez, consegue-se economizar memória e acelerar o tempo de inicialização.
1.3 A Mudança de Paradigma da Segmentação para a Paginação
Nas primeiras arquiteturas x86 (como o 80286), era utilizada a “Segmentação”, que gerenciava a memória em blocos de tamanho variável. Era um método onde o endereço lógico era calculado por um endereço base + offset usando registradores como CS (Code Segment), DS (Data Segment), etc. No entanto, a segmentação era propensa a causar “fragmentação externa” (fragmentação da memória), e o gerenciamento era extremamente complexo. Posteriormente, com o surgimento do 80386, foi introduzida a “Paginação”, que gerencia a memória em blocos de tamanho fixo (geralmente 4KB), tornando-se o método dominante. Os SOs de 64 bits modernos (Linux e Windows) invalidaram virtualmente a segmentação, adotando o modelo de memória plana (flat memory model, com endereço base 0 e limite máximo) e usando apenas paginação para o gerenciamento de memória. Atualmente, a segmentação é usada apenas em casos muito limitados, como referência ao Thread Local Storage (TLS) (através dos registradores FS/GS).
Capítulo 2: Análise Completa da Estrutura Multinível da Tabela de Páginas e do Layout de Bits no x86-64
Na arquitetura de 64 bits (x86-64/AMD64), o espaço de endereçamento virtual é vasto. No “espaço de endereçamento virtual de 48 bits” predominante atualmente, a MMU do hardware percorre (walk) uma tabela de páginas de 4 níveis.
2.1 Espaço de Endereço Virtual de 48bit/57bit e a Restrição de Forma Canônica (Canonical Form)
Embora registradores de 64 bits possam expressar um enorme espaço de endereçamento de 16 exabytes, as implementações de hardware atuais não usam tudo isso devido a custos e complexidade. Na implementação de 48 bits, há a restrição de que todos os bits de 47 a 63 do endereço virtual devem ter o mesmo valor (extensão de sinal). Endereços que satisfazem essa restrição são chamados de “Endereços Canônicos” (Canonical Address).
Como resultado, o espaço de memória ganha uma estrutura com um buraco gigante não utilizado no meio (Non-canonical hole), dividindo-se perfeitamente em duas metades: o espaço de usuário na metade inferior (0x0000000000000000 a 0x00007FFFFFFFFFFF) e o espaço do kernel na metade superior (0xFFFF800000000000 a 0xFFFFFFFFFFFFFFFF). Se você desreferenciar um ponteiro inválido (por exemplo, um ponteiro com metadados embutidos no bit mais significativo), a MMU gera instantaneamente uma exceção de proteção geral (#GP) como uma violação Canonical. Recentemente, a partir dos processadores Intel Ice Lake, um espaço virtual estendido de 57 bits (tabela de páginas de 5 níveis) também começou a ser suportado, tornando-se a base da infraestrutura de nuvem que lida com memória em escala de petabytes.
2.2 Detalhes da Estrutura Hierárquica da Tabela de Páginas de 4 Níveis (PML4, PDPT, PD, PT)
Para converter um endereço virtual de 48 bits em um endereço físico, o x86-64 usa uma tabela de páginas de 4 níveis (estrutura de dados em formato de Radix Tree). Cada tabela tem um tamanho de 4KB e armazena 512 entradas de 64 bits (8 bytes) (2^9 = 512). O endereço virtual é dividido da seguinte forma, atuando como um índice para cada hierarquia.
- Bits 39-47 (9 bits): Índice PML4 (Page Map Level 4) - O nível mais alto. O registrador CR3 aponta para o endereço base físico.
- Bits 30-38 (9 bits): Índice PDPT (Page Directory Pointer Table)
- Bits 21-29 (9 bits): Índice PD (Page Directory) - No caso de um HugePage de 2MB, este é o nível final.
- Bits 12-20 (9 bits): Índice PT (Page Table) - A tabela final em uma página normal de 4KB.
- Bits 0-11 (12 bits): Page Offset - O deslocamento dentro da página de 4KB (4096 bytes).
2.3 Tabela Completa do Layout de 64 bits das Entradas da Tabela de Páginas (PTE)
Cada entrada de 64 bits (PTE) da tabela de páginas não é apenas um ponteiro para um endereço físico, mas uma coleção de metadados que controla a acesso poderoso e o cache. Abaixo está o layout de bits completo do PTE do x86-64 e suas funções detalhadas.
- Bit 0 [P] Present: 1 se estiver presente na memória física. 0 se tiver sido feito swap out ou não estiver alocado. O acesso com valor 0 causa uma exceção de page fault (#PF).
- Bit 1 [R/W] Read/Write: 0 para Somente-Leitura (Read-Only, não gravável), 1 para Leitura/Gravação (Read/Write). Desempenha um papel crucial na implementação do CoW (Copy-on-Write).
- Bit 2 [U/S] User/Supervisor: 0 se for acessível apenas no modo de privilégio (kernel). 1 se puder ser acessado a partir do modo de usuário (Ring 3). Gerenciado estritamente pelo KPTI e SMAP.
- Bit 3 [PWT] Page-level Write-Through: 1 define a política de gravação em cache para esta página como Write-Through. 0 significa Write-Back.
- Bit 4 [PCD] Page-level Cache Disable: 1 desabilita o cache para esta página (Uncacheable). Usado para acesso direto aos registradores de dispositivos PCIe em I/O mapeado em memória (MMIO), etc.
- Bit 5 [A] Accessed: Definido automaticamente para 1 pelo hardware quando a MMU acessa esta página (Read ou Write). Usado como o bit de referência no algoritmo LRU do SO (recuperação de páginas).
- Bit 6 [D] Dirty: Definido automaticamente para 1 pelo hardware quando a MMU “escreve” (Write) nesta página. Bit essencial para o SO determinar se é necessário gravar (writeback) de volta no disco (swap out).
- Bit 7 [PAT] Page Attribute Table: Um índice para especificar os tipos de cache de memória mais detalhados (WC: Write-Combining, etc.) em combination com PWT/PCD. Usado em transferências bulk em alta velocidade para memória gráfica (VRAM), etc.
- Bit 8 [G] Global: Se for 1, não elimina (flush) essa entrada da TLB mesmo se o registrador CR3 for alternado (ocorre troca de contexto). Usado principalmente em páginas no espaço do kernel para evitar a penalidade de TLB misses durante as chamadas do sistema.
- Bits 9-11 [AVL] Available: 3 bits disponíveis livremente para o SO (kernel). No Linux, às vezes é usado para metadados de entrada de swap ou para identificar nós NUMA.
- Bits 12-51 [PFN] Physical Frame Number: O endereço base (número do quadro físico) da página física de destino. Como há alinhamento em 4KB, os 12 bits inferiores são sempre tratados como 0.
- Bits 52-62 [AVL/PKU] Available/Ignored: Reservado ou área utilizável pelo SO, dependendo da geração e extensões de hardware da CPU (ex: Intel MPK: Memory Protection Keys).
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: Se for 1, os dados nesta página não podem ser “executados como instrução”. É um poderoso mecanismo de segurança para prevenir ataques de injeção de código em áreas de dados causados por buffer overflow (DEP: Data Execution Prevention).
Dessa forma, cada bit da PTE está intimamente associado aos algoritmos de gerenciamento de memória do SO (especialmente processamento de swap e proteção de segurança, controle de E/S), tornando-o um design extremamente sofisticado como uma interface no limite entre hardware e software.
Capítulo 3: Hardware Page Table Walk pela MMU e a Barreira da Latência
A conversão de um endereço virtual em um endereço físico é realizada por um circuito de hardware dedicado chamado MMU (Memory Management Unit) localizado no núcleo da CPU.
3.1 Mecanismo de Table Walk Iniciado pelo Registrador CR3
O registrador de controle CR3 do processador contém o endereço físico da tabela de páginas de nível superior (PML4) do processo em execução no momento. Quando o SO, como o Linux, realiza uma troca de contexto (context switch) e transfere os direitos de execução da CPU para outro processo, ele reescreve esse registrador CR3 com o endereço PML4 do novo processo. Assim, todo o espaço de memória do processo é alterado instantaneamente.
O fluxo conceitual é o seguinte:
- Extrai o índice mais alto do endereço virtual e lê a entrada correspondente na tabela PML4 apontada por CR3.
- Extrai o PFN da entrada PML4 e calcula o endereço físico da próxima tabela, PDPT.
- Lê a entrada correspondente na tabela PDPT.
- Da mesma forma, segue as tabelas PD e PT e obtém o endereço base da página física de 4KB final.
- Por fim, adiciona o page offset de 12 bits e constrói o endereço físico completo.
3.2 Acesso ao Barramento de Memória e a Grande Barreira da Latência (Latency)
A maior fraqueza do page table walk de 4 níveis é a “Latência de Acesso à Memória” (Memory Access Latency). Apenas para converter um único endereço virtual, na pior das hipóteses, ocorrem quatro acessos à memória física (leitura de PML4, PDPT, PD, PT). A latência de acesso das DRAMs modernas é de cerca de 50 a 100 nanossegundos. Se todos os quatro acessos à memória errarem (miss) nos caches da CPU (L1/L2/L3) e atingirem a DRAM, apenas isso causará um “stall” (paralisação) de centenas de nanossegundos. Considerando que o ciclo de clock da CPU é de cerca de 0,3 nanossegundos (3 GHz), isso equivale a milhares de ciclos de um atraso fatal e os pipelines da CPU ficariam completamente drenados e interrompidos. O componente projetado para quebrar essa barreira gravíssima de desempenho é a TLB, que explicaremos a seguir.
Capítulo 4: Arquitetura da TLB e a Dor do Shootdown em Ambientes Multi-Core
O TLB (Translation Lookaside Buffer) é um “cache de resultados de conversão de endereços virtuais para endereços físicos” integrado na MMU, consistindo de uma SRAM ultra rápida (ou CAM: Content Addressable Memory).
4.1 Estrutura Hierárquica do TLB e a Otimização através do PCID (Process-Context Identifier)
Nas CPUs modernas, o TLB também tem uma estrutura hierárquica L1/L2. L1 D-TLB (para dados) e L1 I-TLB (para instruções) têm uma capacidade muito pequena (dezenas de entradas), mas respondem em 1 ciclo. O TLB L2 tem centenas a milhares de entradas e responde em vários ciclos. Quando uma entrada não existe no TLB (TLB miss), ocorre o supracitado hardware table walk (page walk). Para auxiliar nisso, um cache dedicado ao page walk (PWC: Page Walk Cache) também é implementado.
Como o significado de um endereço virtual muda quando ocorre troca de contexto de processos, tradicionalmente (nos primórdios do x86), o TLB inteiro era apagado (Flush) quando o CR3 era reescrito. No entanto, isso causaria miss em série de TLBs logo após o switch de contexto, reduzindo significativamente o desempenho. A tecnologia que foi introduzida para resolver esse problema foi o PCID (Process-Context Identifier) (conhecido como ASID na arquitetura ARM). Anexando um ID (Tag) de 12 bits que identifica o processo de forma exclusiva para a entrada do TLB, tornou-se possível manter as entradas do TLB do processo anterior, mesmo após uma troca de contexto, e isso melhorou drasticamente a performance em ambientes multi-processos como servidores Web e bancos de dados.
4.2 O Protocolo de Interrupção Inter-Processador (IPI) para o TLB Shootdown
Em ambientes de múltiplos núcleos (multi-core), o sistema de memória virtual enfrenta um problema de sincronização muito problemático. Por exemplo, suponha que um processo executando no núcleo 0 (CPU0) libere uma região de memória específica com munmap() e invalide o PTE na tabela de páginas (Present = 0). No entanto, o TLB local do núcleo 1 (CPU1) ainda pode ter as “informações de conversão antigas” (Stale TLB Entry) como um cache.
Se as coisas ficarem assim, o núcleo 1 acabará acessando a memória que já foi liberada, levando a sérias falhas de segurança onde os dados pertencentes a outros processos são destruídos, ou informações sigilosas são lidas. Para impedir isso, o SO deve forçar as entradas relevantes a serem apagadas do TLB do núcleo 1. Este é o TLB Shootdown.
O TLB Shootdown é executado rigorosamente nas seguintes etapas (Protocolo IPI):
- Iniciador (Núcleo 0): Após a atualização da tabela de páginas (limpando o PTE), ele emite uma barreira de memória (
mfence, etc.) e envia uma IPI (Inter-Processor Interrupt: Interrupção Entre Processadores) para os controladores APIC locais dos outros núcleos-alvo (Núcleo 1). - Espera (Busy Wait): O núcleo 0 espera usando um spinlock até que todos os outros núcleos de destino terminem de lidar com a interrupção.
- Alvo (Núcleo 1): Ao receber um IPI, interrompe imediatamente o código de usuário atualmente em execução e faz a transição para o tratador de interrupções do kernel (No Linux, algo como
flush_tlb_funcatravés desmp_call_function). - Execução do Flush: O núcleo 1 invalida as entradas de endereço virtual especificadas de seu próprio TLB local (No x86, usando a instrução
INVLPG; no caso do full flush, recarrega o CR3). - Notificação de Conclusão: O núcleo 1 grava a confirmação do flush para um sinalizador (flag) na memória, liberando o núcleo 0 da espera. Em seguida, ele retorna ao processo que foi interrompido (
iret).
Gargalo de Desempenho e Limite de Escalabilidade: Como o TLB Shootdown envolve emissão de hardware de IPI, trocas de contexto para as interrupções, limpeza dos pipelines e esperas spinlock entre múltiplos núcleos, é uma operação de alto custo, consumindo milhares a dezenas de milhares de ciclos. Quanto mais o número de núcleos cresce, como 16, 64, 128, mais esse custo de sincronização aumenta exponencialmente. Esse se tornou um fator inibidor de escala muito grave em servidores na nuvem e HPC, no caso de aplicações com processamento intensivo de várias threads (especialmente as que realizam alocação e liberação de memória de forma contínua e repetitiva).
Capítulo 5: Rastreamento Completo do Tratamento de Page Faults no Kernel do Linux
Quando um programa acessa uma região onde o bit Present da tabela de páginas é 0, ou uma região sem os privilégios apropriados (tentar gravar numa região Somente Leitura (Read-Only), acesso ao espaço do kernel feito a partir do modo de usuário, etc.), a MMU emite a exceção Page Fault (No x86, é a Exception 14, #PF). A partir daqui se inicia a jornada para o profundo tratamento de exceções no kernel do Linux.
5.1 O Fluxo de Controle e Rastreamento da Parte Dependente de Arquitetura em Page Faults
No kernel do Linux x86-64, o gráfico de chamada de funções (call trace) quando ocorre uma falha de página é o seguinte. O controle flui do tratador (handler) de baixo nível que depende da arquitetura para os subsistemas genéricos de memória, que são independentes de arquitetura.
asm_exc_page_fault(Assembly: arch/x86/entry/entry_64.S)- A CPU detecta a exceção e o hardware define o registrador
CR2para o endereço virtual onde a falha ocorreu, salva o estado dos registradores na pilha de interrupções, e pula (jumps) ao ponto de entrada do kernel.
- A CPU detecta a exceção e o hardware define o registrador
exc_page_fault()(C: arch/x86/mm/fault.c)- Este é um handler de falhas que depende de arquitetura. Ele analisa o código de erro (Read/Write, User/Kernel, PF, etc.) e verifica o contexto das interrupções.
do_page_fault()/do_user_addr_fault()- Determina se a falha ocorreu no espaço do kernel (bugs ou região vmalloc, etc.) ou no espaço de usuário. Caso seja do espaço do usuário, ele procura no mapa de memória do processo alvo (A árvore Red-Black, a lista de VMA no
vm_area_struct), e verifica se o endereço pertence a uma região válida (Se não é segmentation fault).
- Determina se a falha ocorreu no espaço do kernel (bugs ou região vmalloc, etc.) ou no espaço de usuário. Caso seja do espaço do usuário, ele procura no mapa de memória do processo alvo (A árvore Red-Black, a lista de VMA no
handle_mm_fault()(C: mm/memory.c)- A partir daqui é a função principal independente da arquitetura. Ele caminha (walks) por cada nível da tabela de páginas (PGD -> P4D -> PUD -> PMD -> PTE) e aloca novos diretórios intermediários (
pmd_alloc, etc.) se as tabelas não tiverem sido alocadas ainda e, afinal, identifica o endereço da PTE definitiva.
- A partir daqui é a função principal independente da arquitetura. Ele caminha (walks) por cada nível da tabela de páginas (PGD -> P4D -> PUD -> PMD -> PTE) e aloca novos diretórios intermediários (
5.2 A Essência da Alocação de Memória: Ramificações de handle_mm_fault
handle_mm_fault() executa diferentes tipos de ramificação (branches) para processamento da alocação de página, com base no estado do PTE selecionado (PTE nulo/zerado, feito em estado de swap-out ou sendo uma falha de permissão).
do_anonymous_page()(Extremo do Demand Paging): É chamada quando o PTE está totalmente nulo (zero). É o acesso primário para páginas anônimas (Anonymous Page) sem vínculo a arquivo, como a área Heap (Obrkoummapque operam atrás domalloc) ou extensão de Pilhas (stack). O kernel, aqui pela primeira vez, aloca a memória física (Frame) usando o Buddy System (Sistema de Pares), preenche com zeros (zero-clear) e mapeia para a PTE. A memória é poupada devido a este processo de evitar a alocação de memória sem uso.do_fault()/__do_fault()(File-Backed Paging): Chamada primária durante acesso ao arquivo configurado pormmap. Lê e carrega o arquivo a partir da página de cache ou do driver do sistema de arquivos correspondente (ext4 ou xfs) diretamente para a tabela da página.do_swap_page()(Agonia do Swap-In): Chamada quando a sinalização do present bit no PTE está como 0, mas algum dos outros sinalizadores contém o recuo (offset) da região swap. A tarefa envolve carregar os dados contidos em unidades de armazenamento (Partições ou Arquivos do swap) para a memória do sistema, portanto as I/Os de disco serão engajadas e o processo ficará travado aguardando liberação na fase dormência de sistema (Sleep / Block).do_wp_page()(Copy-on-Write): O processo relacionado às tratativas do conceito de CoW (A ser detalhado mais tarde). Chamada ativada se houver a tentativa para gravações em locais sem permissão Write (Present = 1, mas Write não está permitido).
5.3 O Mecanismo Físico de Copy-on-Write (CoW) e a Mágica da Contagem de Referência
A essência da formação (fork) do kernel no processo do Linux (A system call fork()), possui comportamento rápido em função da avaliação sob atrasos impulsionados pelo conceito CoW (Copy-on-Write). Esta seção ilustra a capacidade invisível das regras contidas em um comando de rápida inicialização sob consumos exorbitantes da matriz operada.
- Compartilhamento de Tabela de Páginas:
Quando a função
fork()é chamada, a tabela da página operada sob domínio principal de hierarquia é duplicada (sem clonar ou reproduzir espaço de endereçamento / Frame de memória base). O sistema cria um roteamento semelhante onde as entradas do processo duplicado na PTE redirecionam-se exatamente aos processos correspondentes (Frames físicos). - Definição Oobrigatória do Bit de Somente-Leitura (Write-Protect):
Por outro lado, o kernel sobrescreve o sinal
R/Wde todas as PTE compartilhadas de maneira mandante alterando seus valores por 0 (Somente Leitura), ignorando as originais permissões de gravação. - Incrementação (Acréscimo) à Contagem de Referências (Reference Count):
Modifica os acúmulos para registros gerenciais relacionados às alocações (Como contidos nas hierarquias representadas através da
_refcountpara as variáveis sob estrutura física da classe kernel chamadastruct page) sinalizando assim uma correlação dupla (Processo sob uso para finalidade simultânea do espaço virtual entre dois locais). - Gravação e Falhas por Page-Fault (Disparadores do do_wp_page):
Ao perceber a requisição relacionada sob atividades de Write (alteração) geradas entre o escopo principal, variáveis distribuídas em áreas Heap correspondentes sofrem restrições na MMU onde o código
R/W=0alerta com precisão os acionamentos direcionados contra falhas nas paginações (Page-Fault). - Replicação de Páginas (Duplication):
Quando isso ocorre, a
do_wp_page()ativada pelos Handler da Page-Fault validará o problema analisando o sinalizador VMA sob aprovação positiva onde a avaliação descarta irregularidades sobre autorizações de operação de permissões. Obtida tal análise positiva, adquire uma porção equivalente nos processos a partir das operações originárias ligadas através da interface (Buddy System), criando uma duplicação fiel onde as instruções alinhadas repassarão a transferência ao original via processo correspondentecopy_page. - Atualização da PTE e Redução da Referência (Decrementação):
O kernel atualiza a entrada do processo que disparou (requerente originário da gravação) para apontar ao endereço físico recém construído e restaurar o parâmetro do bit
R/Wao limite equivalente de 1. O contador no quadro físico original vai ser rebaixado (Decrementação) garantindo a volta contínua (exclusão de partilha entre componentes paralelos) num eventual disparo das rotinas a frente. Na falta desse tipo de acúmulo, será feita re-avaliação do limitador retornando a 1 sem requerer nenhum processo complementar à alteração e duplicação da via por CoW.
O CoW se demonstra brilhante (devido ao entrelaçamento primário entre funções por intermédio das proteções de Read-Only em hardware na MMU contra manutenções ligadas pela infraestrutura do controle via software kernel), alavancando extrema redução (conservação) das vias operacionais entre processos e acelerando inícios em cadeia por componentes ligados aos sistemas da plataforma.
Capítulo 6: O Abismo do Algoritmo de Recuperação (Reclaim) de Memória e o Julgamento do OOM Killer
A memória física tem volume restrito. Nos casos de ambientes sistêmicos sob estresse de capacidade, causados a longo prazo pelos esgotamentos impulsionados via processos Heap ou de arquivamentos de cache da plataforma, torna-se necessário apagar/reapropriar a liberação correspondente por componentes do tipo Reclaim, para alocar os processos novos que precisam da memória extra. Este componente integrado no kernel do Linux corresponde à seção com o maior desafio para decodificação pela área operacional.
6.1 Listas LRU Ativas/Inativas e os Pseudo-Algoritmos LRU
A operação responsável pela pesquisa atrelada de página de controle físico baseia-se na implementação da lista LRU (Least Recently Used). Mesmo assim, usar as estritas restrições sobre a totalidade do processo na matriz do modelo original (Devido aos fatores ligados por concorrência para uso (Lock) das vias do sistema em processo com avaliação do custo de leitura na operação principal), os registros adaptam a função sob modelo de divisão (“Lista Ativa” com “Lista Inativa” – uma variação adaptada por algoritmos tipo “Clock”).
- Lista Ativa: As páginas do acervo representam a coleção recente onde ocorrem interações e são avaliadas através de chamadas em alta constância “quentes”. Estas unidades recusam reaver perdas (Reclaim) nas chamadas a longo prazo.
- Lista Inativa: Arquiva o registro “Frio” não visualizados ao longo período. Nas etapas extremas do fim (Tail), eles convertem a coleção por ordem na tentativa relacionada aos alvos em processos com foco da recuperação (Candidatos ao Reclaim).
Como pode então, a validação identificar tal acesso dentro desse registro interno no kernel? Aqui entra em ação o Bit na PTE mencionado do Capítulo 2 chamado Accessed Bit (Bit A). Através do daemon (kswapd) pertencente ao serviço da tabela do processo na plataforma kernel, as PTEs são inspecionadas continuamente visando coletar avaliações oriundas sobre históricos contidos e arquivar pela base lógica contida nos softwares até sua desconsideração final via retorno pela exclusão (limpeza a 0 para bit A). Logo se uma conversão for readaptada pelo bit correspondente (configurada pela estrutura a fim de regressar o indicador A de volta para 1) será promovida pela validação contínua voltando o item inativo na área de Lista Ativa original. Ou, será movida de vez, indo rebaixar em estágios contínuos para área do fim para lista Inativa se tal retorno do hardware falhar de atestar as mudanças requeridas no processo.
6.2 O Daemon kswapd e o Terror da Recuperação Direta (Direct Reclaim)
Ao rebaixar sob marcas ligadas (watermarks via indicação de patamar por parâmetros no estado “baixo” - low), a contagem representativa da página física em margem operante despenca ativando o funcionamento na seção adormecida de um servidor background focado ao processo de NUMA (“kswapd”).
A ação foca remoção desde final correspondente às sessões em margens da Lista Inativa:
- Como registros no cache que representam informações de dados “limpos”, simplesmente serão dropadas/destruídas de suas partes ativas deixando espaço contido liberado por completo em função a essas partes no sistema (Drop).
- Casos classificados como cache “sujo” (que ainda encontram registros ativos não confirmados - Dirty Files), antes são registrados no disco via funcionalidade por modo retorno de escritas ativas (Writeback).
- Como registros das funções Heap de processamento em modo páginas-anônimas correspondente das partições originárias nas operações em andamento do serviço principal, esses deverão se relocalizar em disco por meio na transferência ligada do swap para fora pelo swap out.
Este processo invisível executado pelas dependências secundárias de serviço de plano de fundo persistirá sobre funcionamento contínuo a atingir níveis para avaliações “superiores” de volta até sua zona em watermarks
high.
Se no processo originário existir altíssimas margens ativas que solicitem memória correspondente (“Pressão Constante da Memória”), excedendo o nível suportável de limpeza, em decorrência ligada pelas ações sob o registro kswapd na recuperação operacional onde o cenário passe pelo limitador do threshold (“limites no parâmetro final sob contagem do min watermark” ) o limite do gatilho ativa a Recuperação (Direct Reclaim) do espaço ativado de maneira Direta no sistema e atende assim à referida chamada extrema para recuperar recursos vitais.
Recuperação de Ação Direta no Direct Reclaim requer exclusividade. A liberação deve entrar de maneira síncrona diretamente ligada aos acessos das transações em execução com processamento (onde as execuções contidas pela cache original ou operações pela requisição do sistema sofrerão finalizações em troca pela coleta original que necessita liberar seus devidos parâmetros de liberação via processos ativos do Swap e Drop). O impacto na funcionalidade (picos altos no atraso via processamentos de interrupções - Latency Spikes) que atrasam o preenchimento de ações geradas via requisição (malloc bem com conclusões ligadas na atividade da Page-Fault), será interrompida (Stall) em processos na via operacional em andamento por vários milissegundos e às vezes por escalas no valor do processo durando até níveis na medição de segundo correspondente por interrupção. Como efeito mitigatório em Banco de Dados das bases de sistema focado à velocidade (real-time ou transacionais baseadas sobre precisões nas respostas por sistemas críticos do ambiente de produção) precisará alinhar a parametrização do kernel ajustada pela plataforma (vm.swappiness junto a referida revisão sob watermark), o qual se transforma num passo impeditivo pela exclusão desse limitador na performance.
6.3 O Cálculo de Pontuação (Score) do OOM Killer e o Julgamento de Processos
Mesmo operando atividades pela Direct Reclaim sem obtenção pelas margens do alinhamento ao acúmulo esvaziado no registro via limites das partes no Swap ou na falha por cache sem fim (e sob condições impeditivas irremediáveis devido às reduções não gerarem liberações ao montante requerente que viabilizasse continuar funcionando com os parâmetros adequados do seu acesso de recurso local ao hardware); restaria portanto, somente ao kernel acessar de forma sumária uma solução ativando na referida falência a intervenção definitiva com poder destrutivo: OOM (Out Of Memory) Killer.
Pelo risco contínuo em se tornar letal gerando pânico ao componente em níveis do seu núcleo geral, causando panes sistêmicas das bases do serviço no servidor host e travamentos plenos operacionais, na visão do Killer; O OOM realiza abates de processos pelo uso excessivo usando forças para terminação do status com ativação da SIGKILL para recuperar os recursos ligados ao estado de crise, agindo com impiedosos critérios a serem avaliados onde o alvo em questão não seria recuperável por vias normais.
Para quem destinar tal execução forçosa nas eliminações para sacrifícios no serviço e como decide sob tal condenação? É efetuado sobre os pontos atribuídos num sistema conhecido por pontuações pelo cálculo chamado: oom_score (operando uma via gerada a partir da base encontrada sob as avaliações no oom_badness() contido nos arquivos no kernel via caminho mm/oom_kill.c).
A Lógica e Metodologia Conceituada sobre Cálculos OOM Score:
- Pontuação Base (Padrões do uso na área ativa): As fatias relativas baseiam uso via cálculo sobre volumes consumidos equivalentes nas tabelas pela execução referenciada ao cálculo no limite da memória RSS (Resident Set Size). As proporções entre o Volume de referências via total pelas matrizes nas páginas para swap somada sobre alocação que atinge patamar do tamanho via uso final por montante em um peso limite (de 1000). A via principal relata; Se você demanda alto em consumo total - principalmente em fugas onde se aloca além pelas áreas originárias das falhas com perdas continuadas no alinhamento sobre descarte do cache (“Memory Leaks”); fatalmente suas vias sofrem sentenças ligadas à alta do escore.
- Isenção às penalidades no Usuário raiz (root): Caso de sistemas em root operando instâncias nucleares ligadas (como daemons), o cálculo adquire pesos deduzidos no fator gerador sobre mitigação do risco. Em vias no sistema ao qual as paralisações se reverterem de certa falha geral contida ao escopo principal a exclusão é descartada.
- O Fator do Ajustador no Escopo Ativo (OOM Score Adj): Usando ajuste contido pela pasta correspondente em via final do kernel como (
/proc/[pid]/oom_score_adj), existe margem que estende de valor entre (-1000 e +1000). Se os administradores indicarem em alocações equivalentes o valor “-1000”, tais instâncias referenciadas no ambiente operacional serão colocadas além das penalidades com as regras originárias contidas sobre o extermínio, definindo aos serviços (sshd, agentes como os nodes na referência pelo uso em Kubelet/Clusters, e componentes do processo “Mestre” nos DBs do banco ativo), como Imunes e/ou Totalmente Protegidos pelas garras na finalização correspondente em condutas por falhas do alvo geradas do OOM.
Durante as interrupções correspondentes sobre eliminações pelo modo OOM, os alertas referentes a condenações saem impressos nos canais referentes aos relatórios ativados (Como dmesg além dos repasses nos arquivos var/log/messages). Nos formatos para avisos: “Out of memory: Killed process 1234 (java)”, emitindo as avaliações da referida tabela ligadas aos despejos originários das operações contidas entre componentes que operavam antes pelas bases no serviço contínuo ativado (Dumping memory state com lista de pids / oom_scores). Ao interpretar as medições das lógicas correspondentes, o administrador vai encontrar subsídios na exclusão sob possíveis instabilidades resultantes em falha via finalizações repentinas aplicáveis (definindo limites mais estritos pelo serviço - Cgroups com definições e controles alocados).
Capítulo 7: Técnicas Modernas de Memória de Alta Velocidade e Segurança de Hardware
7.1 O Poder das HugePages de 2MB/1GB e os Prós e Contras da THP
Um método poderoso para resolver os atrasos nos falhas TLB e table walks detalhadas nos Capítulos 3 e 4 é através da implementação chamada HugePage. No lugar das páginas normais correspondente de 4KB, são usadas as instâncias em “Páginas Enormes”, podendo chegar a níveis na marca de 2MB (Diretório correspondente nas bases de diretrizes que mapeiam alinhamentos em etapas de Page Directory - portanto anulando a parte operante da função na via via saltos com exclusão pela PT original), correspondendo instâncias equivalentes atingindo níveis maiores correspondente de 1GB diretamente (Direcionando aos espaços PDPT diretamente aos parâmetros operantes referenciados da raiz).
Tendo uma entrada de resposta unificada abrangendo cobertura a áreas exorbitantes no acesso da estrutura, o número equivalente de erros ligados aos escapes do cachê do TLB se reduzem ao montante equivalente de “miss”, viabilizando a enorme performance (Cobrir 512, ou mesmo 260.000 vezes de espaço em uma chamada com a cobertura maior de memória original correspondente). Em banco de dados de alta intensidade em acessibilidade em via aleatória operando enormes proporções na base do registro do servidor operante local (PostgreSQL, e afins como banco de servidor base no modelo Oracle), bem com arquiteturas referentes aos Hypervisor para ambientes (Na área virtual sobre infra do QEMU aliada as execuções de kernel na infra base em KVM).
No Kernel via via no próprio Linux as correspondências da THP (Transparent Huge Pages) executam-se sobre serviços adormecidos vinculadas aos níveis invisíveis via processo de via daemon khugepaged. Sincronizam e defragmentam via unificação referenciadas sobre fragmentos ligados originais com partes equivalentes às suas 4KB transformando páginas maiores nas de marca referenciada de 2MB automaticamente em execuções secundárias invisíveis via kernel. Todavia sob severas situações de uso correspondente à infra do processamento no andamento na fragmentação geradora das bases com consumo exacerbado à via do alinhamento equivalente no espaço principal ativo na via “memory compaction” ligadas sobre latências, causa em bases na referência ao uso intensivo “In Memory / RAM Key Value” tipo (Redis), ser mandatório o impedimento do modo automático ativado com desativação mandante nas definições no parâmetro final original (madvise ou uso por desativações referidas ao padrão com opção never).
7.2 Isolamento da Tabela de Páginas do Kernel (KPTI) e o Custo das Contra-medidas ao Meltdown
No ano correspondente da ocorrência que identificou falhas oriundas da falha em acessibilidade referente de 2018 atrelada nas áreas ligadas sob processos da execução especulativa referente em vulnerabilidade por nível ao processador principal, identificada ("Meltdown CVE-2017-5754"), havia instabilidade gerada por anomalias que atingiam pontos do armazenamento (Cache na CPU), comprometendo com letal fragilidade os setores originários à proteção no componente operacional da segurança geral baseada na construção física de chips.
Tal ameaça foi mitigada originária com ações que implementaram readequações de sistema (via S.O) pela integração referenciada do mecanismo KPTI (Kernel Page-Table Isolation). Na versão correspondente do acesso principal anterior referenciado na arquitetura pela construção antiga do mecanismo de redução na troca correspondente ligada pela infra a redução originárias de trocas nos serviços via uso (“Context Switch”), os controles para áreas das bases referentes ao usuário eram atreladas à metade da base em PTE ao kernel operante e limitadas pelas análises à exclusões restritivas de parâmetros da via principal com bloqueios referenciados na bit de U/S - sem acessibilidade equivalente aos acessos do kernel na parte operacional em execução. Contudo as ações operadas na “Execução Especulativa” originárias transpunha toda base referente às funções com tais barreiras, sem ativar tais gatilhos operantes sob limites equivalentes à aprovação das chaves do acesso restritivo e ignorava verificação do S.O com desvio referente em processamento à áreas do cache original na execução contínua original. As contramedidas de adoção (Inicialmente em base de via de protótipos conhecidas KAISER), ativam exclusões e restringem o sombreamento referente às alocações com um reduzido conjunto (“Minúsculo” em PGD via User Space referenciada com alocações User PGD). Nos momentos para retornos que solicitam entradas via interrupções via transições equivalentes no (kernel space - ex: chamadas via uso syscall), exige as retificações e as recomposições via reescrita nas rotas de CR3 em alocações ligadas na árvore total da (Kernel PGD). Esta restrição mitigante restabeleceu total proteção; Entretanto cada reinicio nas requisições da exclusão requer altas recargas oriundas sobre processos nas reconstruções em chaves nas áreas PCID em tabelas com CR3 via reestrutura de rotas de (Flushing de estruturas), sobrecarga do andamento de processo de (I/O) nas operações e execuções em servidores da WEB em uso de chamadas syscall e banco referidos aos “DB’s”, com custos mensurados com proporções significativas pela marca superior nos “dois” dígitos equivalentes aos percentuais na base (em níveis contidos na proporção chegando a perda de desempenho ao índice equivalente entre dezenas originárias pela base percentual gerada - Performance Overhead).
7.3 Evolução do Direct I/O e Tecnologias de Zero-Copy
O SO aplica engenharia máxima nos preceitos para melhor otimização do acesso na leitura e no retorno equivalente sobre dados no processo originário para otimizar os caminhos gerados sobre a infra da (I/O).
Usando o mmap(), ele converte dados no repositório final num parâmetro original em mapeamento sob áreas ao limite com a base do espaço nos caminhos em limites do endereçamento pela conversão direta na infra do caminho via espaço virtual, ao invés das velhas vias da API em gravação e no envio (write/read). Ao entrar para leitura pela via em andamento o acúmulo no processo da Page Fault é chamado, convertendo acesso aos dados em transferências que acessam informações vinculadas às fatias pela Cache nas bases para uso contido da memória via manipulação por ponteiros operantes ao usuário.
Sobre tráfegos operantes (Rede - Networking, no Envio por base (Storage I/O)), o modelo elimina a conversão referente do kernel do processo entre as operações que transitam com duplicações nas camadas e envios (em espaço Kernel ao User buffer). Esse método anula cópias e diminui trocas baseadas à dependências no escalonador da arquitetura via processador (Overhead por troca nos status). Com mecanismos aplicados do (Zero Copy), ferramentas oriundas da infra com ativações base em chamadas via interfaces com “API Syscall” de funções via processos " sendfile() e a infra moderna base ao tipo originárias de acessos via io_uring, ou o AF_XDP" operam processos paralelos ativando a sincronização conjunta às interfaces equivalentes controladoras do tráfego ativas das funções base ao armazenamento (DMA) da NIC na NVMe. Eles operam modificando o mapeamento correspondente das regras originais na raiz PTE alterando limites das atribuições do parâmetro no kernel para (Trocar / reatribuir remap), e ceder aos espaços e caminhos de usos diretamente na porta do usuário. Esses métodos extinguem o processamento consumido na infra gerada na raiz eliminando as latências criadas (eliminando as amarras com anulação equivalente da sobrecarga da taxa 0 base - Overhead total zero na “copy operation”). Tudo isso é sustentado mais uma vez ao nível básico de base por meio da pura maestria engenhosa aplicada nas implementações sobre gerenciamentos ativados pela função mestre do componente: A base em Tabela de Páginas da operação central em processo da conversão de espaço lógico no hardware local ativada pelas matrizes originárias via manipulação ao serviço PTE.
Conclusão
A arquitetura do uso para conversão em mapeamento no mecanismo local do modelo focado nas chamadas na conversão pelas páginas de processos ao espaço sobre memória física no estado de uso referenciado de hardware sob bases por limites do componente virtual (Mecanismos para paginadores/Memória Virtual) traduz o requinte em pura sinfonia correspondente em engenhosa harmonia entre SO Kernel contra as atuações contidas com processador e componentes hardwares base nas vias geradas da base de CPU. Dentro das vias nas funções ativadas pelas diretrizes equivalentes da marcação no flag via ajuste ativado no limite equivalentes com a marcação em 1 bit; nos contínuos debates do shootdown operantes no controle com base sobre bloqueios ativos aos núcleos correspondentes do Lock do hardware; passando pelo uso com contagens pela regra CoW para contabilidade aprimoradas vinculando base e duplicações (A pura mágica ativa ao uso nas otimizações); terminando na atuação fria do controle a extermínio ativadas pelas exclusões implacáveis da fria regra OOM (Base do Killer ativando o cálculo em limiares); Na profundidade de suas ramificações escondem conhecimentos inestimáveis focados à engenhosidade computacional (“Ciência Operacional”) em aplicar segurança eficiente de uso máximo (“Escalar o Máximo Possível”), com performance no modelo contínuo com abstrações ativadas aos recursos via limitação ao fornecimento contido dando origem ao modelo que oferta limite referenciado pelo poder com a infinita “Ilusão Operacional” ofertando fôlego às vias com aplicações de serviço local via consumo irrestrito nas necessidades operantes requeridas do software base.
As compreensões nas regras vinculadas em baixos níveis (Sistemas base de infra local / low level system base) serve além da atuação e otimização por base à adequação com linguagens focado com alto desempenho em referidas regras nas construções estruturais (Como modelagem contida de dados em C/C++ ao Rust – focadas com base ao cache, atrelado no alinhamento contido nas ativações equivalentes no alinhamento do mmap com extrema efetividade de adequação referenciadas da via) é obrigatório compreender e possuir o uso para bases nas aplicações contínuas com adequações equivalentes a Java ou à linguagens na categoria moderna (ex: Go / Garbage Collection - baseadas com pausas contínuas em GC nas interrupções Stop The World (STW)), em conjunto com atuações referenciadas pelo consumo nas engenharias do Allocators / (como o allocator jemalloc e na via do uso tipo tcmalloc), nas compreensões às avaliações da referenciada conduta local original sob seus fundamentos originais da avaliação geral pelas matrizes originárias ao núcleo operacional na máquina local correspondente (“Arquitetura principal do servidor” no hardware). Rasgar o véu desta “magia” sistêmica e sentir de perto as pulsações do kernel operando o hardware local, sem dúvida traçará e pavimentará seu caminho na direção da conversão a um especialista na área – garantindo com eficácia máxima o potencial aplicável capaz à implementação na maestria pela concepção para projetar os limites correspondentes de bases e sistemas com escalabilidade plena (“arquiteturas robustas ativas no software em base ao longo termo”), tornando você um grande e renomado Arquiteto base de Sistemas e da excelência no mundo da alta engenharia de software contínua focadas.