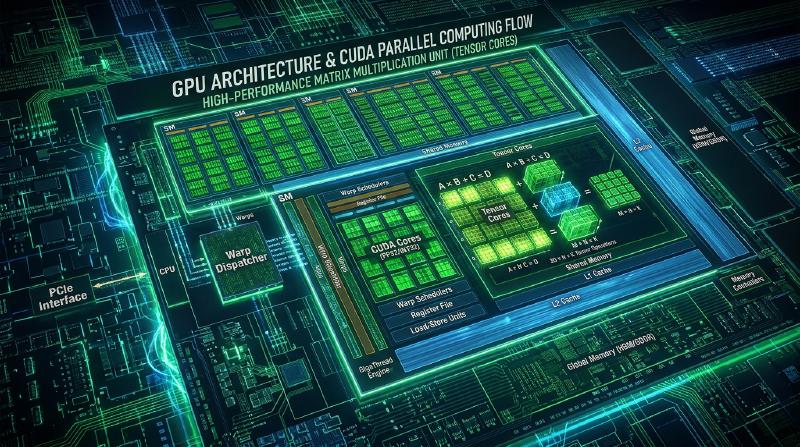
Arquitetura Extremamente Paralela de GPU e a Física do CUDA: O Princípio de Cálculo de SIMT, Warp e Tensor Core
A tecnologia fundamental que sustenta a ciência computacional avançada, a inteligência artificial, o aprendizado profundo (deep learning) e os gráficos de computador de alta definição da atualidade é a GPU (Graphics Processing Unit). Neste artigo, vamos nos aprofundar na arquitetura da GPU e nos aspectos físicos e de hardware da CUDA (Compute Unified Device Architecture), que é a infraestrutura de computação paralela executada sobre ela. Mais do que a simples sintaxe de programação, faremos uma dissecação detalhada, do ponto de vista do multiprocessador de streaming (SM), modelo de execução SIMT, agendamento de warp, Tensor Core e hierarquia de memória, para entender o hardware sob a ótica de “por que foi projetado assim” e “como alcança um throughput computacional extremo”.
Capítulo 1: O Ponto de Bifurcação na Filosofia de Design da CPU e GPU
1.1 A Busca por Baixa Latência vs. A Busca por Alto Throughput
A CPU (Central Processing Unit), um processador de propósito geral, e a GPU, especializada em computação paralela, têm filosofias de design fundamentalmente diferentes devido à sua origem. A CPU evoluiu com o imperativo supremo de “baixa latência (minimização do atraso)”, focado em “como terminar rapidamente uma tarefa (thread)”. Por outro lado, a GPU busca um “alto throughput (maximização da quantidade de processamento)”, focado em “quantas tarefas agrupadas podem ser concluídas por unidade de tempo no total”.
A CPU deve lidar rapidamente com processamentos imprevisíveis, como controle de sistema operacional, execução de aplicativos com complexas condições de ramificação e tratamento aleatório de interrupções de usuários. Para isso, ela é equipada com circuitos avançados de previsão de desvios, execução fora de ordem (mecanismo que reordena e executa instruções) e enormes memórias cache L1/L2/L3, elevando o desempenho de uma única thread ao máximo enquanto oculta os atrasos no acesso à memória.
Em contraste, a GPU foi criada originalmente para processar tarefas altamente paralelizáveis, como aplicar a mesma operação de sombreamento (shading) a milhões de pixels na tela de uma só vez. Em vez de dedicar área do chip para circuitos de controle complexos ou enormes caches, ela optou por empacotar o máximo possível de unidades lógicas e aritméticas (ALU: Arithmetic Logic Unit) simples.
1.2 Proporção de Distribuição de Cache, Circuitos de Controle e ALU na Área do Die
A forma como a área limitada (orçamento de transistores) do die de silício (chip semicondutor) é distribuída é o que define a diferença entre essas duas arquiteturas.
- Distribuição da área do die na CPU: Mais da metade do die é ocupado por memórias cache de grande capacidade (SRAM) e circuitos de controle avançados (previsão de desvio, busca de instrução, decodificação, agendamento, etc.). A proporção ocupada pela ALU que realiza as operações reais é relativamente pequena.
- Distribuição da área do die na GPU: Memória cache e circuitos de controle são mantidos no mínimo absoluto necessário, e a maior parte do die é ocupada por milhares ou dezenas de milhares de ALUs (CUDA cores).
A GPU não oculta o atraso (latência) de acesso à memória com caches, mas através da “troca de contexto (context switching)”. Enquanto um grupo de threads aguarda a chegada de dados da memória, ela imediatamente executa as operações de outro grupo de threads, mantendo as unidades operacionais constantemente em atividade (alta taxa de ocupação: occupancy). Esta é a implementação física da “busca por alto throughput” da GPU. Como o multithreading em nível de hardware (Hardware Multithreading) é executado de forma extremamente leve, presume-se a existência de milhares a dezenas de milhares de threads paralelas simultâneas.
Capítulo 2: A Essência do Modelo de Execução SIMT
2.1 A Diferença entre SIMD e SIMT
Embora exista a taxonomia de Flynn para classificar o processamento paralelo, o modelo de execução da GPU costuma ser comparado ao SIMD (Single Instruction, Multiple Data). Instruções estendidas vetoriais das CPUs (como AVX) são puramente SIMD, onde uma instrução processa simultaneamente múltiplos dados (por exemplo, oito números de ponto flutuante de 32 bits armazenados num registrador de 256 bits). No SIMD, é muito difícil ter desvios diferentes (if-else) para cada elemento de dado.
Por outro lado, o modelo de execução do CUDA proposto pela NVIDIA é chamado de SIMT (Single Instruction, Multiple Threads). No SIMT, múltiplas “threads” independentes formam grupos (os chamados “warps”, discutidos mais adiante) e compartilham a mesma instrução para executar. No entanto, diferente do SIMD, cada thread no SIMT tem o seu próprio estado de registrador e contador de endereço de instrução independentes (no modelo de programação). Isso permite que os programadores escrevam código como se cada thread estivesse operando independentemente.
2.2 O “Warp” em Unidades de 32 Threads
O hardware da GPU não agenda as threads individualmente, mas as gerencia e executa em uma unidade chamada “warp”, que é um grupo de 32 threads juntas. (Nas GPUs AMD, costuma-se usar o termo Wavefront, com unidades que podem ter 64 threads).
A unidade de busca e decodificação de instruções dentro de um multiprocessador de streaming (SM) busca uma instrução por warp e emite (despacha) a mesma instrução para todas as 32 threads dentro do warp. Em suma, as 32 threads dentro de um warp executam fisicamente, e absolutamente ao mesmo tempo, a mesma instrução sobre seus diferentes dados. Esta é a essência do SIMT.
2.3 A Penalidade Física da Divergência de Warp (Warp Divergence)
Mesmo que cada thread se comporte como se tivesse um contador de programa independente, fisicamente todas as threads no warp devem executar a mesma instrução. Então, o que acontece quando o código contém uma ramificação condicional como if-else e as threads no warp divergem nos resultados de verdadeiro e falso?
Esse fenômeno é chamado de divergência de warp (Warp Divergence).
Quando ocorre uma divergência de warp, o hardware executa nas seguintes etapas:
- Primeiro, ele executa a instrução apenas para as threads em que a condição do
ifé verdadeira (threads ativas). Neste momento, as threads cuja condição foi falsa são “mascaradas” (desativadas) e seus resultados não são escritos. - Em seguida, transita para o ramo
else(ou o caminho quando a condição é falsa), agora ativando as threads que antes estavam mascaradas e mascarando as threads que foram verdadeiras para executar a instrução.
Isto significa que, se houver múltiplos caminhos de ramificação, o hardware é forçado a executar esses caminhos de forma serial (em sequência), e não em paralelo. Num exemplo extremo, se as 32 threads no warp seguirem 32 caminhos de ramificação diferentes, o tempo de execução saltará para 32 vezes o normal. A divergência de warp é uma das maiores causas de reduções drásticas do throughput computacional de uma GPU, sendo um dos anti-padrões que mais devem ser evitados no design de algoritmos. Fisicamente, isso significa a ocorrência de “ciclos inúteis”, nos quais a ALU consome energia, mas não gera resultados válidos, por estar mascarada.
Capítulo 3: Dissecação do Hardware do Multiprocessador de Streaming (SM)
Uma GPU é composta por um vasto agrupamento de multiprocessadores de streaming (SM: Streaming Multiprocessor). O SM é o verdadeiro motor de computação da GPU. Em arquiteturas mais recentes (ex: Hopper H100), mais de 100 SMs são instalados em um único die de GPU.
3.1 A Estrutura do Pipeline Interno do SM
O SM é ainda dividido em várias sub-partições internas (geralmente quatro), cada uma possuindo seu próprio agendador de warps e unidade de despacho.
- Agendador de Warp (Warp Scheduler): Seleciona warps que estão prontos para execução (com registradores e memória prontos). O agendador da GPU pode alternar warps com zero overhead (sem tempo adicional perdido), sendo essa a chave para ocultar a latência de acesso à memória.
- Unidade de Despacho (Dispatch Unit): Emite instruções para os warps agendados.
- Núcleos CUDA (ALU INT32 / FP32 / FP64): Unidades que realizam os cálculos reais de números inteiros ou ponto flutuante.
- Unidade de Carga/Armazenamento (LD/ST Unit): Lida com leitura e escrita da memória.
- Unidade de Função Especial (SFU): Hardware dedicado a calcular em alta velocidade funções transcendentais, como sen, cos, exp e inversos.
O pipeline de instrução é projetado de forma bastante profunda, possuindo estágios de busca, decodificação, agendamento, leitura de registradores, execução (vários ciclos) e escrita (write-back). A latência de uma operação FMA (Fused Multiply-Add) FP32 costuma levar de alguns até mais de dez ciclos, mas, emitindo instruções de warps diferentes a cada ciclo, o pipeline é mantido sempre cheio.
3.2 O Imensurável Arquivo de Registradores e a Pressão de Registradores
Os SMs possuem arquivos de registradores cujo tamanho é incomparavelmente maior que o das CPUs (ex: 64KB a 256KB de SRAM por SM). Isso serve para armazenar integralmente o contexto das milhares de threads executadas simultaneamente no SM.
A alternância de contextos (context switch) é concluída em zero ciclos porque não há necessidade de descarregar (spill) os estados dos registradores das threads para a memória. No entanto, se o número de registradores usados por thread aumentar, o número de warps que podem ser ativados simultaneamente no SM (ocupação ou occupancy) diminui. Isso é chamado de pressão de registradores. Quando os registradores se esgotam, os dados transbordam para a lenta memória local (fisicamente parte da memória global), causando uma queda devastadora no desempenho.
3.3 Memória Compartilhada (Shared Memory) e Conflito de Bancos
O SM possui a memória compartilhada (Shared Memory), uma memória on-chip ultra rápida que pode ser explicitamente controlada pelo programador. Compartilha a mesma área física de SRAM que a cache L1, mas funciona como um cache explícito de dados, sendo usada para o compartilhamento de dados e sincronização entre threads dentro de um bloco.
A estrutura física da memória compartilhada é dividida em múltiplos módulos independentes (geralmente 32) chamados de bancos de memória (Memory Banks). Endereços contíguos de 32 bits são intercalados (interleaved) em bancos diferentes.
Quando as 32 threads de um warp acessam simultaneamente bancos diferentes, o acesso é processado em paralelo total (em 1 ciclo). Isso é chamado de acesso livre de conflito de banco (bank conflict-free). No entanto, quando múltiplas threads tentam acessar simultaneamente endereços diferentes do mesmo banco, os pedidos são enfileirados, o que gera uma penalidade (atraso). Isso é chamado de conflito de banco (Bank Conflict). Por exemplo, um conflito de duas vias dobrará o tempo de acesso, enquanto um conflito de 32 vias – o pior caso possível – resultará em um atraso 32 vezes maior. Em algoritmos como transposição de matrizes, ocorrem graves conflitos de banco devido ao acesso com saltos (stride access), exigindo o uso de técnicas avançadas de otimização como “padding” (inserção de dados falsos para deslocar endereços de memória) para evitar esses problemas.
Capítulo 4: O Pipeline de Operação Multiplicar e Somar dos Tensor Cores
Introduzido pela primeira vez na arquitetura Volta e responsável por elevar dramaticamente o desempenho das GPUs seguintes, o hardware revolucionário é o Tensor Core. A explosiva evolução da IA e do aprendizado profundo é impensável sem a presença dele.
4.1 A Implementação em Hardware da Multiplicação e Soma de Matrizes (MMA)
A maior parte do processamento em deep learning envolve multiplicações de matrizes (GEMM: General Matrix Multiply) entre matrizes de peso das redes neurais e dados de entrada. A equação é formulada como $D = A \times B + C$ (onde $A, B$ são matrizes de entrada e $C$ é a matriz de acumulação).
Anteriormente, nos núcleos CUDA normais, essa multiplicação era computada utilizando instruções FMA (Fused Multiply-Add) de elemento a elemento. Em contrapartida, os Tensor Cores são circuitos dedicados que executam a multiplicação e adição em pequenas matrizes (ex: 4x4 ou 16x16) por hardware em 1 ciclo (ou poucos ciclos).
Fisicamente, dezenas a centenas de multiplicadores estão conectados por fios a uma enorme árvore de somadores, e concluem a operação de multiplicação-adição inteiramente em uma tacada, sem escrever resultados intermediários em registradores. Isto torna o throughput de processamento (TFLOPS) por área de longe mais elevado que o de um núcleo CUDA comum.
4.2 O Segredo da Precisão Mista (Mixed-Precision)
O outro trunfo do Tensor Core é o suporte ao cálculo de Precisão Mista (Mixed-Precision). Durante o aprendizado profundo, ocorrem inúmeras situações em que alta precisão (FP32/FP64) não é necessária. O Tensor Core possui um pipeline em que lê as matrizes de entrada $A$ e $B$ com baixa precisão (FP16, BF16 ou até mais baixos como FP8, INT8, INT4), faz a multiplicação internamente com essa precisão menor, mas realiza o processo de soma (acumulação) numa precisão mais elevada (FP32 ou INT32).
- FP16 / BF16: Padrões em treinamentos. O BF16 (Bfloat16) tem uma parte de expoente de 8 bits igual ao FP32 e ampla faixa dinâmica, ajudando a evitar o desaparecimento do gradiente.
- FP8 / INT8 / INT4: Cartões vencedores para acelerar as inferências (Inference). Como o volume de transferência de dados (largura de banda da memória) também é reduzido, o throughput melhora dramaticamente.
A arquitetura Hopper introduziu os “FP8 Tensor Cores”, que aceleram incrivelmente o cálculo de modelos de Transformer, alcançando um throughput teoricamente dezenas de vezes maior do que com FP32. Do lado de software (CUDA), os Tensor Cores são acionados diretamente pelas APIs wmma (Warp-Level Matrix Multiply and Accumulate) ou instruções mma.sync do PTX. As threads no warp cooperam em operações coletivas extremamente complexas que englobam a leitura de trechos da matriz aos registradores, o cálculo e o armazenamento.
Capítulo 5: A Hierarquia de Memória do CUDA e Técnicas de Otimização
Por maior que seja o poder de processamento da GPU, se o fornecimento de dados se tornar o gargalo, não será possível alcançar performance (o problema da barreira de memória, ou “memory wall”). Não é exagero dizer que 90% das otimizações na programação CUDA consistem na “otimização do acesso à memória”.
5.1 O Acesso Aglutinado (Coalescing) à Memória Global
A memória global, que é a memória principal da GPU (HBM ou GDDR), oferece uma enorme largura de banda (por exemplo, vários TB/s), mas também possui uma latência extremamente elevada de centenas de ciclos.
A regra absoluta para maximizar a eficiência do acesso à memória global é o aglutinamento (Coalescing). Os controladores de memória da GPU acessam a memória através de transações divididas em 32 bytes, 64 bytes ou 128 bytes. Se os endereços de memória que as 32 threads de um warp desejam acessar se localizam em uma área contígua (alinhados nos limites de 128 bytes), o hardware as reúne e atende essas requisições como uma única transação de memória agrupada (coalesced).
Em contrapartida, se as threads acessam endereços de forma aleatória ou dando passos com espaços (strided), a coalescência não ocorre, produzindo múltiplas transações separadas. Isso é chamado de “acesso não aglutinado” (uncoalesced access) e se torna um bug de performance crítico que pode reduzir a banda efetiva da memória para menos de 10% de sua capacidade.
5.2 Exemplo de Código CUDA C++: Otimização da Transposição de Matriz e Memória Compartilhada
Abaixo está um exemplo de código kernel otimizado para a transposição de matrizes (Matrix Transpose), que usa a memória compartilhada e evita os acessos não coalescidos, melhorando tremendamente o desempenho.
| |
O código tem três pontos cruciais:
- Coalescência na Leitura: Como a leitura do
idataacontece na direção do X consecutiva, sendo regida pelothreadIdx.x, ela é integralmente agrupada (coalesced). - Coalescência na Escrita: Do mesmo modo, a escrita no
odataestá desenhada para continuar sequencialmente na direção dethreadIdx.x, permutando as coordenadas do bloco para assegurar a coalescência. - Padding na Memória Compartilhada: A adição intencional de 1 elemento
tile[TILE_DIM][TILE_DIM + 1](padding) elimina sumariamente o conflito de banco quando se lê do tile para escrita pelas colunas (tile[threadIdx.x][threadIdx.y + j]).
5.3 Hierarquia de Caches e Memórias Especiais
- Políticas de Cache L1/L2: Nas recentes arquiteturas de GPU, o programador tem a capacidade de sugerir comportamentos de cache usando as instruções PTX (como
.ca,.cg,.cs). Por exemplo, dados acessados apenas uma vez podem driblar o cache L2 (streaming access), evitando poluir os caches. - Memória de Textura / Memória Constante: Focada no processamento de imagens, a memória de textura emprega um cache otimizado para lidar com requisições com alta localização espacial 2D. A memória constante é estupendamente eficiente em acessos do tipo “broadcast”, quando a totalidade das threads lê a mesma constante.
Capítulo 6: O Futuro da GPU na Era do Aprendizado Profundo
Hoje a fronteira da ciência de computação não se trata apenas do desempenho de uma única GPU, mas sim o dimensionamento geral (scaling) do sistema todo.
6.1 Interconexões Ultra-rápidas por Meio de NVLink e NVSwitch
Gigantes LLM (Modelos de Linguagem Grandes) não cabem dentro da memória de uma GPU singular (que poderia ser, por exemplo, de 80GB ou 144GB). Para paralelizarmos o modelo (seja tensor parallel ou pipeline parallel), os GPUs precisam transmitir quantidades da escala de Terabytes de dados a cada segundo entre si. Em função da banda do antigo barramento PCIe (PCI Express) falhar na entrega dessa capacidade, a NVIDIA inventou o NVLink, uma exclusiva ponte de interconexão altíssima. Indo além, via intermédio dos chips designados como NVSwitch, tornou-se exequível congregar 8 a 256 GPUs acopladas sob uma malha non-blocking de arquitetura crossbar para criarmos aglomerados que portam-se exatamente como uma portentosa GPU gigantesca.
6.2 O Transformer Engine e o Ecossistema do FP8
Tendo se convertido num formato inconteste nos moldes de processamentos naturais das linguagens bem como nas predições de imagens e fala, o sistema arquitetônico Transformer necessitava de atenções específicas. Na família Hopper, foi agregado um sistema hardware-software chamado de Transformer Engine. Esta invenção consiste num mecanismo dinâmico que rastreia propriedades estatísticas dos tensores, mudando com automatismo os cálculos precisos entre o FP16 e FP8 nos níveis da camada de rede (Dynamic Scaling). Graças a esse feito, foi possibilitado salvaguardar a eficácia perante as desvalorizações de precisão e simultaneamente assegurar uma tremenda rapidez no cálculo de operações em harmonia à economia da largura de banda.
6.3 Leis de Dimensionamento e Visão do Futuro dos Clusters de GPU
Tal qual as “Leis de Escalamento (Scaling Laws)” da OpenAI denotam, as aptidões intelectuais das IA continuam a acentuar-se vertiginosamente proporcional ao aumento da numerologia nos parâmetros dos moldes associada ao poder de cálculo implementado. Frente à este quadro, as GPUs vêm mutando a face de meros chips a infraestruturas conectivas via fibra ótica nas quais se alojam milhares e transformando os “Centros de Dados, integrais em si mesmos, numa majestosa GPU colossal e inigualável (Supercomputador)”.
A arquitetura vindoura inclinará progressivamente às instaurações baseadas por “Fotonica em silício (Silicone Photonics)” atuando nas comunicações entre dispositivos ópticos integrados por blocos (CPO - Co-Packaged Optics), além de acentuado esmero no ramo dos empilhamentos 3D para evoluções nas transições da SRAM em torno da HBM. De toda forma, essa constituição enraizada em que se alicerçam desde as eras nativas – a de que se deve “aumentar o throughput de modo sublime a partir do fracionamento de atividades paralelas” – ditará o porvir dos horizontes destrinchando o vanguarda que a esfera computacional irá explorar.
title: “Arquitetura Extremamente Paralela de Processadores de Computação Gráfica e a Física do CUDA: O Princípio de Cálculo de SIMT, Warp e Tensor Core” description: “Design interno de processadores de computação gráfica que busca o máximo de throughput extremo. A essência do SM, agendamento de warp, Tensor Core e otimização de memória compartilhada.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
Arquitetura Extremamente Paralela de Processadores de Computação Gráfica e a Física do CUDA: O Princípio de Cálculo de SIMT, Warp e Tensor Core
A tecnologia fundamental que sustenta a ciência computacional avançada, a inteligência artificial, o aprendizado profundo (deep learning) e os gráficos de computador de alta definição da atualidade é o processador de computação gráfica (Graphics Processing Unit). Neste artigo, vamos nos aprofundar na arquitetura do processador de computação gráfica e nos aspectos físicos e de hardware da CUDA (Compute Unified Device Architecture), que é a infraestrutura de computação paralela executada sobre ele. Mais do que a simples sintaxe de programação, faremos uma dissecação detalhada, do ponto de vista do multiprocessador de streaming (SM), modelo de execução SIMT, agendamento de warp, Tensor Core e hierarquia de memória, para entender o hardware sob a ótica de “por que foi projetado assim” e “como alcança um throughput computacional extremo”.
Apêndice Complementar ao Capítulo 1: O Ponto de Bifurcação na Filosofia de Design de Processadores de Computação de Propósito Geral e Processadores de Computação Gráfica
1.1 A Busca por Baixa Latência vs. A Busca por Alto Throughput
Os processadores de computação de propósito geral (Central Processing Unit), que são as CPUs comuns, e os processadores de computação gráfica, especializados em computação paralela, têm filosofias de design fundamentalmente diferentes devido à sua origem. O processador de computação de propósito geral evoluiu com o imperativo supremo de “baixa latência (minimização do atraso)”, focado em “como terminar rapidamente uma tarefa (thread)”. Por outro lado, o processador de computação gráfica busca um “alto throughput (maximização da quantidade de processamento)”, focado em “quantas tarefas agrupadas podem ser concluídas por unidade de tempo no total”.
O processador de computação de propósito geral deve lidar rapidamente com processamentos imprevisíveis, como controle de sistema operacional, execução de aplicativos com complexas condições de ramificação e tratamento aleatório de interrupções de usuários. Para isso, é equipado com circuitos avançados de previsão de desvios, execução fora de ordem (mecanismo que reordena e executa instruções) e enormes memórias cache L1/L2/L3, elevando o desempenho de uma única thread ao máximo enquanto oculta os atrasos no acesso à memória.
Em contraste, o processador de computação gráfica foi criado originalmente para processar tarefas altamente paralelizáveis, como aplicar a mesma operação de sombreamento (shading) a milhões de pixels na tela de uma só vez. Em vez de dedicar área do chip para circuitos de controle complexos ou enormes caches, ele optou por empacotar o máximo possível de unidades lógicas e aritméticas (ALU: Arithmetic Logic Unit) simples.
1.2 Proporção de Distribuição de Cache, Circuitos de Controle e ALU na Área do Die
A forma como a área limitada (orçamento de transistores) do die de silício (chip semicondutor) é distribuída é o que define a diferença entre essas duas arquiteturas.
- Distribuição da área do die no processador de computação de propósito geral: Mais da metade do die é ocupada por memórias cache de grande capacidade (SRAM) e circuitos de controle avançados (previsão de desvio, busca de instrução, decodificação, agendamento, etc.). A proporção ocupada pela ALU que realiza as operações reais é relativamente pequena.
- Distribuição da área do die no processador de computação gráfica: Memória cache e circuitos de controle são mantidos no mínimo absoluto necessário, e a maior parte do die é ocupada por milhares a dezenas de milhares de ALUs (CUDA cores).
O processador de computação gráfica não oculta o atraso (latência) de acesso à memória com caches, mas através da “troca de contexto (context switching)”. Enquanto um grupo de threads aguarda a chegada de dados da memória, ele imediatamente executa as operações de outro grupo de threads, mantendo as unidades operacionais constantemente em atividade (alta taxa de ocupação: occupancy). Esta é a implementação física da “busca por alto throughput” no processador de computação gráfica. Como o multithreading em nível de hardware (Hardware Multithreading) é executado de forma extremamente leve, presume-se a existência de milhares a dezenas de milhares de threads paralelas simultâneas.
Apêndice Complementar ao Capítulo 2: A Essência do Modelo de Execução SIMT
2.1 A Diferença entre SIMD e SIMT
Embora exista a taxonomia de Flynn para classificar o processamento paralelo, o modelo de execução do processador de computação gráfica costuma ser comparado ao SIMD (Single Instruction, Multiple Data). Instruções estendidas vetoriais dos processadores de computação de propósito geral (como AVX) são puramente SIMD, onde uma instrução processa simultaneamente múltiplos dados (por exemplo, oito números de ponto flutuante de 32 bits armazenados num registrador de 256 bits). No SIMD, é muito difícil ter desvios diferentes (if-else) para cada elemento de dado.
Por outro lado, o modelo de execução do CUDA proposto pela NVIDIA é chamado de SIMT (Single Instruction, Multiple Threads). No SIMT, múltiplas “threads” independentes formam grupos (os chamados “warps”, discutidos mais adiante) e compartilham a mesma instrução para executar. No entanto, diferente do SIMD, cada thread no SIMT tem o seu próprio estado de registrador e contador de endereço de instrução independentes (no modelo de programação). Isso permite que os programadores escrevam código como se cada thread estivesse operando independentemente.
2.2 O “Warp” em Unidades de 32 Threads
O hardware do processador de computação gráfica não agenda as threads individualmente, mas as gerencia e executa em uma unidade chamada “warp”, que é um grupo de 32 threads juntas. (Nos processadores de computação gráfica AMD, costuma-se usar o termo Wavefront, com unidades que podem ter 64 threads).
A unidade de busca e decodificação de instruções dentro de um multiprocessador de streaming (SM) busca uma instrução por warp e emite (despacha) a mesma instrução para todas as 32 threads dentro do warp. Em suma, as 32 threads dentro de um warp executam fisicamente, e absolutamente ao mesmo tempo, a mesma instrução sobre seus diferentes dados. Esta é a essência do SIMT.
2.3 A Penalidade Física da Divergência de Warp (Warp Divergence)
Mesmo que cada thread se comporte como se tivesse um contador de programa independente, fisicamente todas as threads no warp devem executar a mesma instrução. Então, o que acontece quando o código contém uma ramificação condicional como if-else e as threads no warp divergem nos resultados de verdadeiro e falso?
Esse fenômeno é chamado de divergência de warp (Warp Divergence).
Quando ocorre uma divergência de warp, o hardware executa nas seguintes etapas:
- Primeiro, ele executa a instrução apenas para as threads em que a condição do
ifé verdadeira (threads ativas). Neste momento, as threads cuja condição foi falsa são “mascaradas” (desativadas) e seus resultados não são escritos. - Em seguida, transita para o ramo
else(ou o caminho quando a condição é falsa), agora ativando as threads que antes estavam mascaradas e mascarando as threads que foram verdadeiras para executar a instrução.
Isto significa que, se houver múltiplos caminhos de ramificação, o hardware é forçado a executar esses caminhos de forma serial (em sequência), e não em paralelo. Num exemplo extremo, se as 32 threads no warp seguirem 32 caminhos de ramificação diferentes, o tempo de execução saltará para 32 vezes o normal. A divergência de warp é uma das maiores causas de reduções drásticas do throughput computacional de um processador de computação gráfica, sendo um dos anti-padrões que mais devem ser evitados no design de algoritmos. Fisicamente, isso significa a ocorrência de “ciclos inúteis”, nos quais a ALU consome energia, mas não gera resultados válidos, por estar mascarada.
Apêndice Complementar ao Capítulo 3: Dissecação do Hardware do Multiprocessador de Streaming (SM)
Um processador de computação gráfica é composto por um vasto agrupamento de multiprocessadores de streaming (SM: Streaming Multiprocessor). O SM é o verdadeiro motor de computação do processador de computação gráfica. Em arquiteturas mais recentes (ex: Hopper H100), mais de 100 SMs são instalados em um único die de processador de computação gráfica.
3.1 A Estrutura do Pipeline Interno do SM
O SM é ainda dividido em várias sub-partições internas (geralmente quatro), cada uma possuindo seu próprio agendador de warps e unidade de despacho.
- Agendador de Warp (Warp Scheduler): Seleciona warps que estão prontos para execução (com registradores e memória prontos). O agendador do processador de computação gráfica pode alternar warps com zero overhead, sendo essa a chave para ocultar a latência de acesso à memória.
- Unidade de Despacho (Dispatch Unit): Emite instruções para os warps agendados.
- Núcleos CUDA (ALU INT32 / FP32 / FP64): Unidades que realizam os cálculos reais de números inteiros ou ponto flutuante.
- Unidade de Carga/Armazenamento (LD/ST Unit): Lida com leitura e escrita da memória.
- Unidade de Função Especial (SFU): Hardware dedicado a calcular em alta velocidade funções transcendentais, como sen, cos, exp e inversos.
O pipeline de instrução é projetado de forma bastante profunda, possuindo estágios de busca, decodificação, agendamento, leitura de registradores, execução (vários ciclos) e escrita (write-back). A latência de uma operação FMA (Fused Multiply-Add) FP32 costuma levar de alguns até mais de dez ciclos, mas, emitindo instruções de warps diferentes a cada ciclo, o pipeline é mantido sempre cheio.
3.2 O Imensurável Arquivo de Registradores e a Pressão de Registradores
Os SMs possuem arquivos de registradores cujo tamanho é incomparavelmente maior que o dos processadores de computação de propósito geral (ex: 64KB a 256KB de SRAM por SM). Isso serve para armazenar integralmente o contexto das milhares de threads executadas simultaneamente no SM.
A alternância de contextos é concluída em zero ciclos porque não há necessidade de descarregar (spill) os estados dos registradores das threads para a memória. No entanto, se o número de registradores usados por thread aumentar, o número de warps que podem ser ativados simultaneamente no SM (ocupação ou occupancy) diminui. Isso é chamado de pressão de registradores. Quando os registradores se esgotam, os dados transbordam para a lenta memória local (fisicamente parte da memória global), causando uma queda devastadora no desempenho.
3.3 Memória Compartilhada (Shared Memory) e Conflito de Bancos
O SM possui a memória compartilhada (Shared Memory), uma memória on-chip ultra rápida que pode ser explicitamente controlada pelo programador. Compartilha a mesma área física de SRAM que a cache L1, mas funciona como um cache explícito de dados, sendo usada para o compartilhamento de dados e sincronização entre threads dentro de um bloco.
A estrutura física da memória compartilhada é dividida em múltiplos módulos independentes (geralmente 32) chamados de bancos de memória (Memory Banks). Endereços contíguos de 32 bits são intercalados (interleaved) em bancos diferentes.
Quando as 32 threads de um warp acessam simultaneamente bancos diferentes, o acesso é processado em paralelo total (em 1 ciclo). Isso é chamado de acesso livre de conflito de banco (bank conflict-free). No entanto, quando múltiplas threads tentam acessar simultaneamente endereços diferentes do mesmo banco, os pedidos são enfileirados, o que gera uma penalidade (atraso). Isso é chamado de conflito de banco (Bank Conflict). Por exemplo, um conflito de duas vias dobrará o tempo de acesso, enquanto um conflito de 32 vias – o pior caso possível – resultará em um atraso 32 vezes maior. Em algoritmos como transposição de matrizes, ocorrem graves conflitos de banco devido ao acesso com saltos (stride access), exigindo o uso de técnicas avançadas de otimização como “padding” (inserção de dados falsos para deslocar endereços de memória) para evitar esses problemas.
Apêndice Complementar ao Capítulo 4: O Pipeline de Operação Multiplicar e Somar dos Tensor Cores
Introduzido pela primeira vez na arquitetura Volta e responsável por elevar dramaticamente o desempenho posterior dos processadores de computação gráfica, o hardware revolucionário é o Tensor Core. A explosiva evolução da IA e do aprendizado profundo é impensável sem a presença dele.
4.1 A Implementação em Hardware da Multiplicação e Soma de Matrizes (MMA)
A maior parte do processamento em deep learning envolve multiplicações de matrizes (GEMM: General Matrix Multiply) entre matrizes de peso das redes neurais e dados de entrada. A equação é formulada como $D = A \times B + C$ (onde $A, B$ são matrizes de entrada e $C$ é a matriz de acumulação).
Anteriormente, nos núcleos CUDA normais, essa multiplicação era computada utilizando instruções FMA (Fused Multiply-Add) de elemento a elemento. Em contrapartida, os Tensor Cores são circuitos dedicados que executam a multiplicação e adição em pequenas matrizes (ex: 4x4 ou 16x16) por hardware em 1 ciclo (ou poucos ciclos).
Fisicamente, dezenas a centenas de multiplicadores estão conectados por fios a uma enorme árvore de somadores, e concluem a operação de multiplicação-adição inteiramente em uma tacada, sem escrever resultados intermediários em registradores. Isto torna o throughput de processamento (TFLOPS) por área de longe mais elevado que o de um núcleo CUDA comum.
4.2 O Segredo da Precisão Mista (Mixed-Precision)
O outro trunfo do Tensor Core é o suporte ao cálculo de Precisão Mista (Mixed-Precision). Durante o aprendizado profundo, ocorrem inúmeras situações em que alta precisão (FP32/FP64) não é necessária. O Tensor Core possui um pipeline em que lê as matrizes de entrada $A$ e $B$ com baixa precisão (FP16, BF16 ou até mais baixos como FP8, INT8, INT4), faz a multiplicação internamente com essa precisão menor, mas realiza o processo de soma (acumulação) numa precisão mais elevada (FP32 ou INT32).
- FP16 / BF16: Padrões em treinamentos. O BF16 (Bfloat16) tem uma parte de expoente de 8 bits igual ao FP32 e ampla faixa dinâmica, ajudando a evitar o desaparecimento do gradiente.
- FP8 / INT8 / INT4: Cartões vencedores para acelerar as inferências (Inference). Como o volume de transferência de dados (largura de banda da memória) também é reduzido, o throughput melhora dramaticamente.
A arquitetura Hopper introduziu os “FP8 Tensor Cores”, que aceleram incrivelmente o cálculo de modelos de Transformer, alcançando um throughput teoricamente dezenas de vezes maior do que com FP32. Do lado de software (CUDA), os Tensor Cores são acionados diretamente pelas APIs wmma (Warp-Level Matrix Multiply and Accumulate) ou instruções mma.sync do PTX. As threads no warp cooperam em operações coletivas extremamente complexas que englobam a leitura de trechos da matriz aos registradores, o cálculo e o armazenamento.
Apêndice Complementar ao Capítulo 5: A Hierarquia de Memória do CUDA e Técnicas de Otimização
Por maior que seja o poder de processamento do processador de computação gráfica, se o fornecimento de dados se tornar o gargalo, não será possível alcançar performance (o problema da barreira de memória). Não é exagero dizer que 90% das otimizações na programação CUDA consistem na “otimização do acesso à memória”.
5.1 O Acesso Aglutinado (Coalescing) à Memória Global
A memória global, que é a memória principal do processador de computação gráfica (HBM ou GDDR), oferece uma enorme largura de banda (por exemplo, vários TB/s), mas também possui uma latência extremamente elevada de centenas de ciclos.
A regra absoluta para maximizar a eficiência do acesso à memória global é o aglutinamento (Coalescing). Os controladores de memória do processador de computação gráfica acessam a memória através de transações divididas em 32 bytes, 64 bytes ou 128 bytes. Se os endereços de memória que as 32 threads de um warp desejam acessar se localizam em uma área contígua (alinhados nos limites de 128 bytes), o hardware as reúne e atende essas requisições como uma única transação de memória agrupada (coalesced).
Em contrapartida, se as threads acessam endereços de forma aleatória ou dando passos com espaços (strided), a coalescência não ocorre, produzindo múltiplas transações separadas. Isso é chamado de “acesso não aglutinado” e se torna um bug de performance crítico que pode reduzir a banda efetiva da memória para menos de 10% de sua capacidade.
5.2 Exemplo de Código CUDA C++: Otimização da Transposição de Matriz e Memória Compartilhada
Abaixo está um exemplo de código kernel otimizado para a transposição de matrizes (Matrix Transpose), que usa a memória compartilhada e evita os acessos não coalescidos, melhorando tremendamente o desempenho.
| |
O código tem três pontos cruciais:
- Coalescência na Leitura: Como a leitura do
idataacontece na direção do X consecutiva, sendo regida pelothreadIdx.x, ela é integralmente agrupada (coalesced). - Coalescência na Escrita: Do mesmo modo, a escrita no
odataestá desenhada para continuar sequencialmente na direção dethreadIdx.x, permutando as coordenadas do bloco para assegurar a coalescência. - Padding na Memória Compartilhada: A adição intencional de 1 elemento
tile[TILE_DIM][TILE_DIM + 1](padding) elimina sumariamente o conflito de banco quando se lê do tile para escrita pelas colunas (tile[threadIdx.x][threadIdx.y + j]).
5.3 Hierarquia de Caches e Memórias Especiais
- Políticas de Cache L1/L2: Nas recentes arquiteturas de processadores de computação gráfica, o programador tem a capacidade de sugerir comportamentos de cache usando as instruções PTX (como
.ca,.cg,.cs). Por exemplo, dados acessados apenas uma vez podem driblar o cache L2 (streaming access), evitando poluir os caches. - Memória de Textura / Memória Constante: Focada no processamento de imagens, a memória de textura emprega um cache otimizado para lidar com requisições com alta localização espacial 2D. A memória constante é estupendamente eficiente em acessos do tipo “broadcast”, quando a totalidade das threads lê a mesma constante.
Apêndice Complementar ao Capítulo 6: O Futuro do Processador de Computação Gráfica na Era do Aprendizado Profundo
Hoje a fronteira da ciência de computação não se trata apenas do desempenho de um único processador de computação gráfica, mas sim o dimensionamento geral (scaling) do sistema todo.
6.1 Interconexões Ultra-rápidas por Meio de NVLink e NVSwitch
Gigantes LLM (Modelos de Linguagem Grandes) não cabem dentro da memória de um processador de computação gráfica singular (que poderia ser, por exemplo, de 80GB ou 144GB). Para paralelizarmos o modelo (seja tensor parallel ou pipeline parallel), os processadores de computação gráfica precisam transmitir quantidades da escala de Terabytes de dados a cada segundo entre si. Em função da banda do antigo barramento PCIe (PCI Express) falhar na entrega dessa capacidade, a NVIDIA inventou o NVLink, uma exclusiva ponte de interconexão altíssima. Indo além, via intermédio dos chips designados como NVSwitch, tornou-se exequível congregar 8 a 256 processadores de computação gráfica acoplados sob uma malha non-blocking de arquitetura crossbar para criarmos aglomerados que portam-se exatamente como um portentoso processador de computação gráfica gigantesco.
6.2 O Transformer Engine e o Ecossistema do FP8
Tendo se convertido num formato inconteste nos moldes de processamentos naturais das linguagens bem como nas predições de imagens e fala, o sistema arquitetônico Transformer necessitava de atenções específicas. Na família Hopper, foi agregado um sistema hardware-software chamado de Transformer Engine. Esta invenção consiste num mecanismo dinâmico que rastreia propriedades estatísticas dos tensores, mudando com automatismo os cálculos precisos entre o FP16 e FP8 nos níveis da camada de rede (Dynamic Scaling). Graças a esse feito, foi possibilitado salvaguardar a eficácia perante as desvalorizações de precisão e simultaneamente assegurar uma tremenda rapidez no cálculo de operações em harmonia à economia da largura de banda.
6.3 Leis de Dimensionamento e Visão do Futuro dos Clusters de Processadores de Computação Gráfica
Tal qual as “Leis de Escalamento (Scaling Laws)” da OpenAI denotam, as aptidões intelectuais das IA continuam a acentuar-se vertiginosamente proporcional ao aumento da numerologia nos parâmetros dos moldes associada ao poder de cálculo implementado. Frente à este quadro, o processador de computação gráfica vem mutando a face de mero chip a infraestruturas conectivas via fibra ótica nas quais se alojam milhares e transformando os “Centros de Dados, integrais em si mesmos, num majestoso processador de computação gráfica colossal e inigualável (Supercomputador)”.
A arquitetura vindoura inclinará progressivamente às instaurações baseadas por “Fotonica em silício (Silicone Photonics)” atuando nas comunicações entre dispositivos ópticos integrados por blocos (CPO - Co-Packaged Optics), além de acentuado esmero no ramo dos empilhamentos 3D para evoluções nas transições da SRAM em torno da HBM. De toda forma, essa constituição enraizada em que se alicerçam desde as eras nativas – a de que se deve “aumentar o throughput de modo sublime a partir do fracionamento de atividades paralelas” – ditará o porvir dos horizontes destrinchando o vanguarda que a esfera computacional irá explorar.
Conclusão: Rumo ao Extremo da Ciência Computacional
A arquitetura da GPU é o mecanismo computacional mais complexo e mais direcionado ao throughput que a humanidade já concebeu. Se a CPU for comparada a “um hiper carro de Fórmula 1 ultraveloz”, a GPU pode ser descrita como “um gigantesco sistema logístico no qual dezenas de milhares de caminhões basculantes transportam materiais num movimento simultâneo e coordenado”.
A execução de instruções baseadas na unidade warp da SIMT, o hardware de escalonamento que promove rodízios contínuos de milhares de threads a zero ciclos de interrupções, os acessos coalescidos engajados em esgarçar totalmente os limites das capacidades, assim como o robusto pipeline de Tensor Cores que ditou os estrondosos avanços no campo da Deep Learning. Tudo isso é fruto de um fanatismo febril dos engenheiros, devotados a descobrir “como alavancar a quantificação dos cálculos matemáticos de pontos flutuantes no seio dos rigorosos tetos regidos por limitações puramente físicas (a velocidade da luz, condutividade térmica, picos de consumo elétrico ou a extrema precisão na fabricação microscópica do silício)”.
Para os vindouros engenheiros no desenvolvimento dos softwares, pesquisadores atuantes nos ramos das IA, assim como aos peritos aplicados nas metodologias do HPC, o apoderamento intelectivo com respeito à arquitetura das GPUs deixa de consistir em mero ornamento acadêmico. Transfigura-se sim numa competência “imprescindível” orientada em visualizar mentalmente os mecanismos inerentes das potências abstratas encrustadas no núcleo dos frameworks computacionais (tais como no caso do PyTorch e TensorFlow), tirando disto os máximos triunfos práticos que o sistema pode auferir. Contornar conflitos nos bancos de memória, extinguir ao extremo as ocorrências de divergência nos warp (warp divergence), assim como alimentar a imensidão contínua de dados no rastro do encadeamento dos Tensor Cores, constitui a senda vitoriosa de otimizações formidáveis. Esse triunfo engendra o alvorecer moderno sobre aquilo outrora avaliado a gastar longos e árduos meses por gigantescos centros supercomputacionais; agora se concretizando espantosamente ante curtas e triviais horas em poucos painéis com GPU espalhados no topo das mesas, moldando ativamente as atuais feições das reais evidências concretas no presente dia-a-dia.
Nós habitamos nos limiares fascinantes desta, talvez a fase mais deslumbrante inerente nos compêndios narrativos dedicados às arquiteturas para modeladores mecânicos da computação através da história dos seres humanos. Apreender em plenas minúcias as realidades relativas à estrutura maciça embasada nas dimensões do CUDA em convergência às concepções da infraestrutura maciçamente e super paralela orquestrada pela GPU que desata amanhãs imensamente radiantes e povoados por profusas faculdades criativas inumeráveis, está literalmente aos cargos de suas incansáveis jornadas em transpor este mesmíssimo artigo literário.
Glossário (Glossary)
- SM (Streaming Multiprocessor): Principal bloco operacional da GPU. Equivalente a um núcleo (core) em uma CPU, mas abrigando internamente uma vasta quantidade de CUDA cores, agendadores de warps, memórias compartilhadas, entre outros.
- SIMT (Single Instruction, Multiple Threads): Modelo de execução característico de GPUs, onde todas as threads de um warp executam exatamente e unissonamente as mesmas codificações processadas aos seus alvos independentemente separados.
- Warp (Warp): Congregação maciça compreendendo 32 threads. Configura-se na unidade basilar das ordens escalonadas sob a jurisdição do Hardware no deferimento dos lançamentos funcionais.
- Warp Divergence (Divergência de Warp): Cenário impeditivo decorrente diante as condições divisórias espalhadas entre os comandos nas instâncias intrínsecas aos domínios nos warps, provocando sequenciamento serial atenuando consequentemente o throughput computacional.
- Tensor Core (Tensor Core): Uma peça singular no mosaico estrutural eletrônico especificamente idealizado na tramitação fulgurante do conjunto das multiplicações atreladas as somatórias matriciais em um lapso concentrado nos âmbitos físicos da base (MMA). Extraordinariamente direcionado com máxima eficácia aos aprendizados profundos.
- Coalesced Access (Acesso Coalescido): Dispositivo estrutural de quando se sucede a tentativa no arranjo espacial pelas threads situadas no mesmo warp para uma sequencial contígua dos rastros dos dados nos canais de arquivamentos e com isso unificar as ações conjuntas nas transmissões originando as formidáveis magnitudes correspondentes às larguras na fluidez condutora de acessos.
- Shared Memory (Memória Compartilhada): Veloz receptáculo condicionado fisicamente no pátio adjacente na estrutura das unidades autônomas dos SMs (Nível 1 de scratchpad) passível e inteiramente comandado pelo usuário-criador de programações (programador).
- Bank Conflict (Conflito de Banco): Atrasos penais acarretados pelas interpolações nos cenários da memória compartilhada toda vez em quando de forma co-ocorrente surgem solicitações distintas oriundas desde plurais instâncias de threads miradas e convergidas diretamente sobre compartimentos e locações idênticos de forma transversal aos desiguais postos dos endereçamentos pertencentes a igual repartição do banco.
- Occupancy (Ocupação / Taxa de ocupação): A dimensão relativa à quantia na equivalência dos warps capazes nos mantimentos contíguos do andamento sob o cômputo limitante totalizador suportado num único SM. Medidas exultantes favorecem intensamente na ofuscação dos distanciamentos temporais nos transcursos (ocultação de latência na memória).
- Register Spilling (Derramamento de Registradores): A anomalia perniciosa gerada face ao consumo dos acumuladores internos destinados em proveito das instâncias das threads no percurso extrapolarem as marcações absolutas tangíveis pela delimitação do hardware, relegando portanto por vias marginais as sobras excessivas nos abismos defasados rumo aos armazéns mais distantes no processo da computação (a memória local).
Lista de Leitura Recomendada e Referências Bibliográficas
- NVIDIA CUDA C++ Programming Guide: A documentação oficial incontornável a todo aspirante ao universo na área e a todo programador praticante em abordagens do CUDA. Este artefato se recheia pelas melhores diretrizes recomendadas bem como decifrações analíticas condizentes à vasta exploração nos moldes ideais operacionais aos acertos performáticos.
- NVIDIA Ampere / Hopper Architecture Whitepaper: Um acervo minucioso na literatura pública explanatória (Whitepaper oficial) sobre o mecanismo canalizado encarregado pela estruturação dos Tensor Cores atrelados as elucidações concernentes no intercâmbio autônomo (não sincrônico) de referências bem como os fundamentos palpáveis nos moldes de manufatura (implementação de hardware) dos denominados Transformer Engines.
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): A grande obra clássica universal e imortal. O meio ideal para o aprendizado aprofundado perante as bifurcações na matriz da concepção mental baseada no modelo das GPUs em contraste com as dos processadores CPU, sem subtrair os encadeamentos inerentes ao sistema escalonado nas memórias temporárias (caches) associados às grandezas do paralelismo situados no alicerce atrelado aos níveis nas execuções.
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): Tratado explicativo concebido pela via metódica nas idealizações lógicas focadas e destinadas na confecção matemática orientada ao encadeamento na dimensão computacional via modelos e estruturas elaboradas sob as plataformas derivadas do CUDA. Fornece elucidações analíticas nos parâmetros correspondentes em alicerçar agrupamentos fracionários nas divisões do espaço temporário da memória (Tiling em Shared Memory), sem excluir os intrincados preceitos da condensação algorítmica (reduction) juntamente nos desdobramentos lógicos acumulados (prefix sums), elucidando minuciosamente suas instâncias aplicadas na rotina de códigos.
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: Dissertação de natureza acadêmica. Notável epopéia pautada nas destrincheiras avaliações pontuais (micro benchmarks) operada no desígnio e em face à extração precisa sobre as medidas do tempo efetivo decorrente nas transições da base estanque de arquivos e nas verdadeiras avaliações das produções computacionais fáticas oriundas no cerne e domínios dos enigmáticos Tensor Cores; desnudando, perante os panos, as diretrizes e mecanismos jamais externalizadas de maneira proativa e de caráter público pelos condutores natos atrelados à corporação da NVIDIA.
O repertório do entendimento absorvido perante as esferas do âmbito das infraestruturas descritas e avaliadas a longo alcance nesta literatura e documentário poderão certamente, em conjunção à escalada incessante do aparato físico inovador do hardware, acabar caindo porventura numa efemeridade obsolescente tangencial n’algumas searas ou pormenores, ressalva a máxima verossímil a pautar na universal premissa elementar e física baseada em “aumentar ao infinito as taxas da capacidade transmissora dos barramentos (Banda Larga), impulsionar desmedidamente os níveis das simultaneidades na produção conjunta (Paralelismo), e encobrir as vacâncias defasadas dos retardamentos estruturais (ocultação de Latência)” sempre perseverará enraizada qual imutável verdade transcendental e inexpugnável reinante à eternidade nos pilares soberanos pertencentes no âmago supremo e glorioso na Ciência Matemática Computacional de nosso mundo.