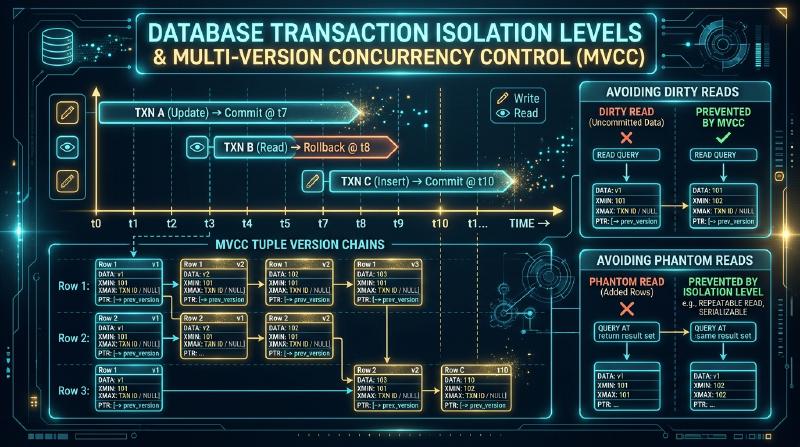
Níveis de Isolamento de Transações de Banco de Dados e MVCC: A Realidade do ACID e o Controle de Concorrência Multiversão
Na arquitetura de software moderna, os sistemas de gerenciamento de banco de dados relacionais (RDBMS) continuam sendo o pilar da persistência de dados. O núcleo deles é o conceito de “transação”, e as propriedades ACID (Atomicidade, Consistência, Isolamento, Durabilidade) em particular, são amplamente reconhecidas como a teoria fundamental para a construção de sistemas robustos. No entanto, entre as propriedades ACID, o “Isolamento” (Isolation) é a área onde existe a maior divergência entre a teoria e a prática.
Neste artigo, vamos nos aprofundar de uma perspectiva extremamente detalhada, acadêmica e prática, desde o contexto histórico dos níveis de isolamento de transações de banco de dados, passando pelas limitações do padrão ANSI SQL-92, até a estrutura interna do Multi-Version Concurrency Control (MVCC: Controle de Concorrência Multiversão) adotado pelos motores de banco de dados modernos. Em particular, vamos analisar as diferenças decisivas nas implementações de MVCC do PostgreSQL e do MySQL (InnoDB), os dois maiores RDBMS de código aberto, e abranger até o Isolamento de Snapshot Serializável (SSI), a vanguarda dos bancos de dados distribuídos, entregando um épico que ultrapassa os 12.000 caracteres.
Capítulo 1: O Mito das Propriedades ACID e o Dilema do Processamento Concorrente
1.1 O Ideal da Serialização (Serializability)
O ideal definitivo visado pelo Isolamento (Isolation) de transações é a “Serialização” (Serializability). Esta é a propriedade que diz que, mesmo quando várias transações são executadas paralelamente ao mesmo tempo, o resultado da execução “será equivalente ao resultado se as transações tivessem sido executadas serialmente (uma a uma) em alguma ordem”.
Quando as transações $T_1$ e $T_2$ são executadas simultaneamente no sistema, não importa como o intercalamento (cruzamento de operações) ocorra devido à execução concorrente, se o estado final do banco de dados for exatamente igual ao resultado da execução na ordem “$T_1 \rightarrow T_2$” ou “$T_2 \rightarrow T_1$”, essa programação é definida como serializável. Se essa serialização for garantida, os desenvolvedores de aplicações podem se concentrar na construção da lógica de negócios sem se preocupar em momento algum com inconsistências de dados (condições de corrida, sobrescritas inadequadas, etc.) devido ao processamento concorrente.
1.2 O Colapso de Desempenho da Serialização por Locks
Nos sistemas de banco de dados iniciais, para garantir essa serialização, adotou-se um mecanismo de bloqueio (lock) estrito chamado “Two-Phase Locking” (2PL: Bloqueio em Duas Fases). No 2PL, a transação sempre adquire um bloqueio (bloqueio compartilhado ou exclusivo) antes de ler ou escrever dados (Fase 1: Growing Phase - Fase de Crescimento) e libera todos os bloqueios no término da transação (no commit ou rollback) (Fase 2: Shrinking Phase - Fase de Encolhimento).
Porém, este mecanismo de bloqueio estrito tinha uma falha fatal. Essa falha era a “degradação extrema de desempenho”.
- Operações de leitura bloqueiam operações de gravação.
- Operações de gravação bloqueiam operações de leitura.
- Aumento do tempo de espera devido a conflitos de bloqueio e ocorrências frequentes de deadlocks.
Quando o tráfego aumentou e um grande número de usuários começou a acessar o banco de dados simultaneamente, a serialização completa via 2PL tornou-se o gargalo do sistema e o throughput caiu drasticamente. O sistema enfrentou o dilema do trade-off entre “integridade dos dados” e “desempenho de processamento concorrente (throughput)”.
1.3 Histórico de Controle de Concorrência e Concessões
Para resolver este dilema, os pesquisadores de engenharia de banco de dados introduziram o conceito de “Nível de Isolamento” (Isolation Level). Este é o “produto de uma concessão” onde a serialização completa é parcialmente relaxada, permitindo a ocorrência de certas inconsistências de dados (anomalias: Anomaly) em troca da melhoria no desempenho do processamento concorrente. Ele permitiu escolher o equilíbrio entre integridade e desempenho de acordo com os requisitos da aplicação.
Capítulo 2: Os Níveis de Isolamento do Padrão ANSI SQL-92 e Suas Críticas
2.1 Definição dos Níveis de Isolamento pelo Padrão ANSI SQL-92
O padrão SQL “SQL-92”, estabelecido em 1992, definiu quatro níveis de isolamento com base em três fenômenos anômalos (Phenomena) representativos que poderiam ocorrer devido ao processamento concorrente.
Os 3 Fenômenos Anômalos (Phenomena) Definidos
- Dirty Read (Leitura Suja): Fenômeno em que a transação $T_1$ atualiza os dados, e enquanto ainda não comitou, outra transação $T_2$ lê esses dados não comitados. Se $T_1$ sofrer um rollback, $T_2$ terá lido dados fantasmas que não existem.
- Non-repeatable Read (Leitura Não Repetível): Fenômeno em que, entre o momento em que a transação $T_1$ lê a mesma linha duas vezes, outra transação $T_2$ atualiza e comita essa linha. O resultado da primeira e da segunda leitura de $T_1$ será diferente.
- Phantom Read (Leitura Fantasma): Fenômeno em que, enquanto a transação $T_1$ lê várias linhas sob uma determinada condição de pesquisa, outra transação $T_2$ insere (ou deleta) novas linhas que atendem a essa condição e comita. Se $T_1$ pesquisar novamente com a mesma condição, o número de linhas terá aumentado ou diminuído.
Os 4 Níveis de Isolamento do SQL-92
O SQL-92 definiu os níveis de isolamento de acordo com o grau em que evitam a ocorrência dessas anomalias.
- Read Uncommitted: Permite o Dirty Read.
- Read Committed: Evita o Dirty Read, mas permite o Non-repeatable Read e o Phantom Read.
- Repeatable Read: Evita o Dirty Read e o Non-repeatable Read, mas permite o Phantom Read.
- Serializable: Evita todas as anomalias e garante a serialização completa.
2.2 O Artigo Crítico de Berenson e Outros “A Critique of ANSI SQL Isolation Levels”
A definição do padrão SQL-92 parece, à primeira vista, muito clara e lógica. No entanto, o artigo “A Critique of ANSI SQL Isolation Levels”, publicado em 1995 por mestres do mundo dos bancos de dados, incluindo Hal Berenson, Jim Gray (vencedor do Prêmio Turing) e Phil Bernstein, desferiu um golpe devastador na definição desse padrão ANSI.
As principais falhas do padrão SQL-92 apontadas neste artigo são as seguintes.
1. A Premissa Implícita Baseada em Bloqueios (Locks)
A definição do SQL-92 tinha como premissa implícita “que o banco de dados estava sendo implementado com controle de concorrência baseado em locks (2PL)”. Porém, na década de 1990, bancos de dados que adotavam MVCC (discutido posteriormente) e outros controles de concorrência otimistas (OCC) já haviam começado a surgir, e a definição de anomalias com base em bloqueios estava se tornando obsoleta.
2. Ambiguidade e Incompletude da Definição
Foi apontado que apenas as três anomalias definidas no SQL-92 (Dirty Read, Non-repeatable Read, Phantom Read) não eram capazes de cobrir todas as anomalias que poderiam ocorrer no processamento concorrente. Por exemplo, existe um fenômeno chamado “Dirty Write” (Gravação Suja). Este é um fenômeno onde os dados escritos por uma transação não comitada são sobrescritos por outra transação não comitada, mas não há menção a dirty writes no padrão SQL-92. Embora todos os níveis de isolamento (incluindo o Read Uncommitted) devam prevenir dirty writes (caso contrário, a consistência interna do banco de dados desmorona), o padrão não abordou esse ponto.
3. Descoberta de Novas Anomalias
O artigo definiu diversas anomalias novas que não existem no padrão SQL-92. As duas principais são as seguintes:
- Lost Update (Atualização Perdida): Fenômeno em que duas transações leem os mesmos dados ao mesmo tempo e, quando cada uma grava seu resultado calculado de volta, uma atualização sobrescreve a outra, apagando-a.
- Write Skew (Distorção de Gravação): Um fenômeno peculiar ao isolamento de snapshot, que será discutido posteriormente.
O artigo de Berenson e outros provou que o padrão SQL-92 não conseguia definir matemática e rigorosamente os níveis de isolamento, e causou um grande choque na indústria de bancos de dados. Na teoria atual de banco de dados, a definição do nível de isolamento ANSI SQL-92 é tratada como “algo a ser aprendido como contexto histórico” e “insuficiente como uma definição técnica rigorosa”.
Capítulo 3: Isolamento de Snapshot (Snapshot Isolation) e Write Skew
3.1 A Diferença entre Repeatable Read e Isolamento de Snapshot
O que chamou atenção especial no artigo de Berenson e outros foi a proposta de um novo nível de isolamento chamado “Snapshot Isolation” (SI: Isolamento de Snapshot).
Em muitos bancos de dados que adotam o MVCC (como PostgreSQL e Oracle), a verdadeira natureza do nível de isolamento fornecido como “Repeatable Read” é, na verdade, esse “Isolamento de Snapshot”. No Isolamento de Snapshot, cada transação lê de um “snapshot” consistente (um estado passado e estático) do banco de dados no momento em que a transação começou.
- Atualizações feitas por outras transações após o momento de início da transação são completamente invisíveis (evitando o Non-repeatable Read).
- Como a própria existência dos registros é fixada num ponto no passado, INSERTs de outras transações também são invisíveis (evitando o Phantom Read).
Em outras palavras, o Isolamento de Snapshot não apenas satisfaz os requisitos do “Repeatable Read” definido pelo SQL-92, mas em muitos casos também evita o “Phantom Read”. Então, o Isolamento de Snapshot é equivalente ao “Serializable”? A resposta é “Não”. Porque o Isolamento de Snapshot possui uma anomalia fatal que não é serializável, chamada “Write Skew” (Distorção de Gravação).
3.2 O Problema do Plantão Médico e o Write Skew
O exemplo mais famoso para entender o write skew é o “Sistema de Plantão (On-Call) Médico”.
[Regra de Negócios] Suponha que exista um sistema de gerenciamento de turnos num hospital com a regra: “Pelo menos um médico deve estar sempre em plantão (on-call)”.
Atualmente, dois médicos, Alice e Bob, estão de plantão (on_call = true).
Nesse momento, Alice e Bob, por coincidência e ao mesmo tempo, pensam “Estou me sentindo mal, então quero sair do plantão” e iniciam uma transação de mudança de turno a partir dos seus respectivos terminais.
[Fluxo da Transação (Sob Isolamento de Snapshot)]
- [Tx1: Alice] Obtém o snapshot. Confirma que atualmente existem duas pessoas de plantão, Alice e Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Resultado: 2 - [Tx2: Bob] Obtém o snapshot. Confirma igualmente que há duas pessoas, Alice e Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Resultado: 2 - [Tx1: Alice] Decide que a regra (pelo menos 1 de plantão) foi cumprida e retira a si mesma do plantão.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] Decide igualmente que a regra foi cumprida e retira a si mesmo do plantão.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] Commit realizado com sucesso.
- [Tx2: Bob] Commit realizado com sucesso. (Como Alice e Bob estão atualizando registros diferentes, não há conflito nos bloqueios de linha)
[Resultado] Como resultado do commit tanto da Tx1 quanto da Tx2, o número de médicos de plantão tornou-se “0”. A regra de negócio entrou em colapso.
Isso é o Write Skew. Se fosse Serializável (Serializable), a Tx1 ou a Tx2 teria sido executada em série primeiro, então a transação executada depois teria detectado que o número de pessoas de plantão era “1” e poderia ter abortado (dado rollback) na sua operação de remoção. No entanto, no Isolamento de Snapshot, como eles atualizam linhas de dados diferentes uma da outra (a linha de Alice e a linha de Bob), o conflito não é detectado, o que acaba causando a inconsistência na regra de negócio.
3.3 ReadOnly Anomaly (Anomalia Somente de Leitura)
Além disso, o isolamento de snapshot tem uma anomalia extremamente particular, a ReadOnly Anomaly, em que a serialização desmorona devido à intervenção de “transações somente leitura” (read-only transactions). Esta anomalia, que é mostrada no exemplo do saldo de depósito de uma conta bancária e adição de juros, é um fenômeno onde, mesmo não havendo conflito entre as transações de atualização, uma transação somente leitura, olhando para o snapshot do passado, acaba lendo um “estado numa linha do tempo que é logicamente impossível”. Devido à existência dessas anomalias, o isolamento de snapshot distingue-se do Serializable no seu sentido estrito.
Capítulo 4: Princípio de Funcionamento do MVCC (Multi-Version Concurrency Control)
Discutimos até agora a teoria e as anomalias dos níveis de isolamento, mas como os bancos de dados modernos controlam tudo isso? A tecnologia central para isso é o MVCC (Multi-Version Concurrency Control: Controle de Concorrência Multiversão).
4.1 “A leitura não bloqueia a gravação e a gravação não bloqueia a leitura”
A maior filosofia de design do MVCC e a sua diferença crucial para o controle baseado em bloqueios (2PL) é que “a leitura e a gravação não se bloqueiam mutuamente”. Ao atualizar um registro, o banco de dados MVCC não sobrescreve diretamente o registro existente (In-place update). Em vez disso, ele cria uma nova versão do registro (versão / tupla) e, ao mesmo tempo, retém a versão antiga do registro.
Várias versões do mesmo registro (histórico do passado ao presente) existirão simultaneamente no banco de dados. Quando uma transação lê os dados, baseando-se em seu próprio “ID de Transação (XID)” e “hora de início (timestamp)”, ela calcula e lê a “versão passada correta que ela deve ler” dentre o grande número de versões presentes no sistema.
Desta forma, mesmo se uma transação estiver reescrevendo um registro, outras transações podem ler a “versão passada anterior a ser reescrita”, evitando as esperas geradas pelos bloqueios.
4.2 Cadeia de Gerenciamento de Versão de Tupla e Regra de Visibilidade (Visibility)
O algoritmo mais importante do MVCC é a Regra de Visibilidade (Visibility Rule), que determina “qual transação pode ver qual versão dos dados”.
No início, a cada transação é atribuído um ID de Transação (XID) exclusivo e monotonicamente crescente. Cada versão do registro (tupla) salva no banco de dados recebe as seguintes informações como metadados:
- Criador XID: O XID da transação que criou esta versão via INSERT/UPDATE.
- Deletor XID: O XID da transação que excluiu logicamente (invalidou) esta versão via UPDATE/DELETE.
Quando a transação $T_i$ lê uma linha de dados, ela determina a visibilidade baseando-se nestas regras fundamentais:
- Foi comitada?: A transação do XID criador já foi comitada?
- Não é no futuro?: O XID criador é de uma transação passada em relação ao momento em que $T_i$ começou?
- Não foi deletada?: O XID deletor não está definido, ou a transação do XID deletor ainda não foi comitada, ou a transação é do futuro em relação ao momento em que $T_i$ começou?
Ao avaliar estritamente estas condições, é providenciado a cada transação um snapshot consistente.
Capítulo 5: As Diferenças Decisivas de Implementação do MVCC do PostgreSQL vs MySQL (InnoDB)
Mesmo que o princípio básico do MVCC seja o mesmo, a sua implementação interna varia incrivelmente entre os produtos de banco de dados. Aqui vamos analisar e comparar as arquiteturas de MVCC do PostgreSQL e do MySQL (InnoDB), que se destacam como as pedras angulares do mundo open-source.
5.1 Implementação do MVCC do PostgreSQL: Anexação no Heap e a Necessidade do VACUUM
O MVCC do PostgreSQL adota uma “Arquitetura baseada em Anexos” (Append-only) altamente única e intuitiva.
5.1.1 Lógica de Decisão de Bits por xmin e xmax
Dentro do arquivo de dados (heap), que é a entidade física da tabela do PostgreSQL, o cabeçalho de cada linha (tupla) grava dois IDs de transação chamados xmin e xmax.
xmin(ID de Transação de Inserção): O XID da transação que criou esta tupla.xmax(ID de Transação de Exclusão): O XID da transação que excluiu (ou excluiu logicamente a versão antiga por meio de atualização) esta tupla.
[Comportamento da operação UPDATE]
No PostgreSQL, o UPDATE é logicamente processado como uma combinação de DELETE e INSERT.
- Grava-se o XID da transação atual no
xmaxda tupla antiga. (Exclusão Lógica) - Cria-se uma tupla completamente nova no espaço livre do heap, gravam-se os novos dados nela e define-se o
xmincom o XID da transação atual. (Nova adição)
Ou seja, ambas as tuplas, antiga e nova, são mantidas misturadas no mesmo arquivo de dados (heap) da tabela.
5.1.2 Vantagem Enorme e Desafio Fatal: A Existência do VACUUM
A maior vantagem desta arquitetura é que o rollback (reversão) é extremamente rápido. Se a transação abortar, a tupla adicionada pode ser simplesmente tratada como “não comitada”, eliminando a necessidade de processamento para reverter dados.
No entanto, há um desafio fatal: “O Inchaço das Tuplas Mortas (Dead Tuples)”.
Ao repetir UPDATEs ou DELETEs, as tuplas de versões antigas que ninguém mais referencia (tuplas cujo xmax se tornou o ID de uma transação antiga comitada) irão se acumular infinitamente no heap. Se isso não for verificado, o tamanho físico da tabela inchará explosivamente, e a performance do sequential scan degradará de forma devastadora.
O processo do sistema para excluir fisicamente essas tuplas desnecessárias e permitir a reutilização do espaço livre é o VACUUM (e o daemon autovacuum executado automaticamente). A razão pela qual o ajuste (tuning) do VACUUM é considerado extremamente importante na operação do PostgreSQL tem suas raízes nos fundamentos desta arquitetura MVCC.
5.2 Implementação do MVCC do MySQL InnoDB: Atualização In-place e Reconstrução Dinâmica do Undo Log
Por outro lado, o InnoDB, motor de armazenamento padrão do MySQL, adota uma arquitetura próxima a do Oracle Database: “Atualização In-place (In-place update) e Log de Desfazer (Undo Log / Rollback Segment)”.
5.2.1 Índice Clusterizado e Atualização In-place
As tabelas do InnoDB são organizadas como B+Trees baseadas numa chave primária (Índice Clusterizado).
Quando um UPDATE é executado no InnoDB, ele não anexa uma nova linha como o PostgreSQL faz, mas sim sobrescreve diretamente a linha de dados na B+Tree (In-place update).
Então, o que acontece se outra transação quiser ler um snapshot passado? Para isso, o InnoDB move os “dados antigos” (antes de serem sobrescritos) para uma área dedicada: o Log de Desfazer (Undo Log Segment).
5.2.2 Reconstrução Dinâmica do Passado através do Roll Pointer
As colunas ocultas em cada linha de dados do InnoDB incluem estas duas:
DB_TRX_ID: O ID da transação que inseriu ou atualizou esta linha pela última vez.DB_ROLL_PTR(Roll Pointer): Um ponteiro indicando a localização no log de desfazer (Undo log) onde a “versão uma vez mais antiga” dessa linha está salva.
O processo onde uma transação lê um snapshot do passado é como a seguir:
- Lê-se a linha de dados mais recente na B+Tree.
- Verifica-se o
DB_TRX_ID; se for uma atualização de uma transação no futuro relativa ao seu próprio snapshot, decide-se que esta linha recente não deve ser lida. - Segue-se o
DB_ROLL_PTRe obtém-se os dados da versão passada a partir do log de desfazer. - Usando os dados do log de desfazer, reconstrói-se dinamicamente (Rollback na memória) o estado passado do registro, em memória.
- Se ainda for uma atualização no futuro, rastreia-se ainda mais no passado na cadeia do log de desfazer.
5.2.3 Vantagens e Desafios do InnoDB
A vantagem dessa arquitetura é que a área principal da tabela (tablespace) tem menos propensão a inchar. Os dados mais recentes estão sempre numa posição adequada da B+Tree, e versões passadas são isoladas em uma área separada (Undo log), mantendo alta a eficiência do rastreamento físico (não há necessidade de VACUUM massivo como no PostgreSQL, e o processo de purga do log de desfazer funciona levemente em segundo plano).
A desvantagem, por outro lado, é que quando existem transações de longa execução (processamento de lote, mysqldump, etc.) que leem uma quantidade imensa de snapshots passados, há um overhead para reconstruir os dados rastreando profundamente no log de desfazer, diminuindo a performance de leitura. Além disso, existe o risco do próprio log de desfazer inchar, pressionando o espaço no disco.
Capítulo 6: Isolamento de Snapshot Serializável (SSI) e a Vanguarda dos Bancos de Dados Distribuídos
A evolução do MVCC não acaba por aqui. Conforme explicado no Capítulo 3, o Isolamento de Snapshot (SI) tinha anomalias como o “write skew” e não era um Serializable perfeito. Contudo, para não fazer os desenvolvedores de aplicações estarem conscientes da complexidade do processamento paralelo, era necessário alcançar um Serializable completo, mantendo a alta performance do MVCC.
6.1 O Nascimento do Isolamento de Snapshot Serializável (SSI)
Em 2008, um artigo por Michael Cahill e outros publicou um algoritmo revolucionário chamado “Serializable Snapshot Isolation (SSI)”. Trata-se de uma tecnologia baseada na arquitetura MVCC que garante serialização completa (Serializable). O PostgreSQL rapidamente adotou o SSI a partir de sua versão 9.1 como a implementação do nível de isolamento “Serializable”.
Princípio de Funcionamento do SSI: Gráfico de Conflito e Estrutura Perigosa (rw-antidependency)
O SSI não realiza bloqueios (blocks) via locks. Em vez disso, durante a execução de uma transação, ele rastreia (tracking) minuciosamente “quais dados foram lidos (Read) e quais dados foram gravados (Write)”.
O SSI monitora a relação de conflito entre as transações, buscando por um padrão de conflito específico chamado “rw-antidependency (anti-dependência de leitura-gravação)”. Especificamente, é uma relação em que a transação $T_1$ lê uma versão passada dos dados, e esses mesmos dados são posteriormente sobrescritos (update e commit) por outra transação $T_2$. O SSI constrói internamente um gráfico de conflitos de transações e, no exato momento em que detecta uma “estrutura em que duas setas rw-antidependency se seguem consecutivamente (uma estrutura perigosa)”, julga que há uma possibilidade do colapso da serialização e força o aborto (rollback) de uma das transações.
Assim, a transação é parada antes de ocorrer uma anomalia como o write skew (ex: o problema de plantão dos médicos), e acaba por garantir o Serializable perfeito. Poderia ser considerado a forma final do controle de concorrência otimista (OCC).
6.2 MVCC em Bancos de Dados Distribuídos: Spanner, CockroachDB, TiDB
A tecnologia moderna de banco de dados evoluiu para além dos limites de um único servidor para bancos de dados SQL distribuídos (NewSQL) implementados ao longo de data centers ao redor do mundo. Em um ambiente distribuído, alcançar o MVCC com consistência global era também um desafio à lei da física.
Google Spanner e TrueTime API
O Spanner, da Google, desenvolveu a TrueTime API para resolver o problema de ordenação de transações em sistemas distribuídos. Sob a premissa de que os relógios (relógios físicos) de cada servidor estão fadados a desviar (clock skew), o GPS e os relógios atômicos são combinados para providenciar a hora atual como um “alcance de incerteza (intervalo de tempo / time window)”. O MVCC do Spanner, ao esperar a janela de incerteza do TrueTime passar no commit da transação (Commit Wait), garante fisicamente que “transações com relações causais sempre terão a ordem dos timestamps correta (Consistência Externa / External Consistency)”.
CockroachDB e HLC (Hybrid Logical Clock)
CockroachDB, um banco de dados open source distribuído inspirado pelo Spanner, adota o HLC (Relógio Lógico Híbrido) para alcançar uma consistência quase igual sem usar caros relógios atômicos. Através da combinação da sincronização de relógios físicos via NTP com os relógios lógicos de Lamport (um contador baseado em relações causais entre eventos), gera-se timestamps de snapshot do MVCC consistentes globalmente através de nós distribuídos, alcançando o SSI (Serializable Snapshot Isolation) em um ambiente distribuído.
TiDB e o Modelo Percolator
O TiDB, desenvolvido pela PingCAP, adota um modelo de transação distribuída baseado no modelo Google Percolator. É uma arquitetura em que um único componente que emite os timestamps globais (Placement Driver: PD) é preparado, e o motor de armazenamento de cada nó (TiKV) usa esse timestamp para processar o MVCC localmente. Estando também alicerçado no 2PC (Commit em Duas Fases), ele minimiza a duração para o qual os locks são mantidos e compatibiliza transações gigantes com MVCC num ambiente distribuído.
Conclusão: Além do ACID
Os níveis de isolamento de transação de banco de dados nunca são meros tópicos para memorização. É a própria história de uma luta de décadas na ciência da computação sobre como harmonizar duas requisições contraditórias: a consistência de dados e o desempenho do sistema.
Começando pelas definições falhas no ANSI SQL-92, até o salto de avanço nos processamentos paralelos com o MVCC, as bifurcações arquiteturais entre o PostgreSQL e o InnoDB, e o desafio à derradeira consistência através do SSI e os bancos de dados distribuídos. A compreensão profunda dessas estruturas internas deve ser uma arma poderosa para projetar aplicações mais robustas e de alta performance.
Vivemos agora numa era em que as propriedades ACID não são meros “mitos”, mas sim implementadas como “realidade”, graças à algoritmos sofisticados e a sincronização física dos relógios. Para o engenheiro que navega o oceano de dados, conhecer os abismos da engine do banco de dados não é nada menos do que uma insaciável jornada de exploração intelectual.