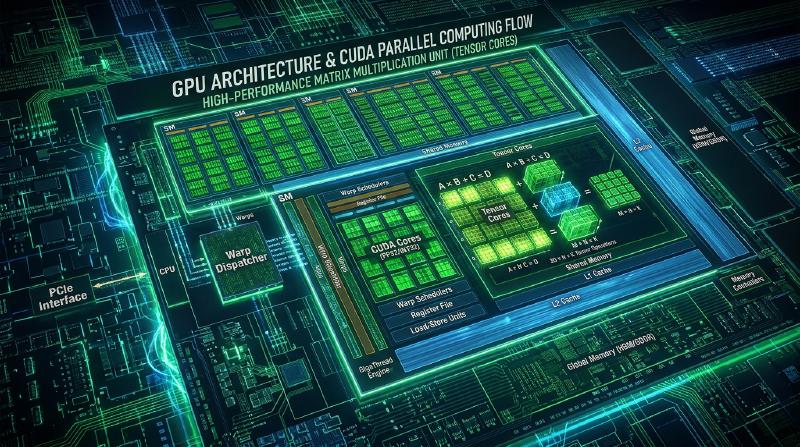
GPUの超並列アーキテクチャとCUDAの物理:SIMT・ワープ・テンソルコアの計算原理
現代の高度な計算科学、人工知能、深層学習(ディープラーニング)、そして高精細なコンピュータグラフィックスを支える根幹の技術、それがGPU(Graphics Processing Unit)です。本稿では、GPUのアーキテクチャとその上で動作する並列計算基盤であるCUDA(Compute Unified Device Architecture)の物理的、ハードウェア的な側面に深くメスを入れます。単なるプログラミングの文法ではなく、ハードウェアが「なぜそのように設計されているのか」「どのようにして極限の計算スループットを叩き出しているのか」を、ストリーミング・マルチプロセッサ(SM)、SIMT実行モデル、ワープスケジューリング、テンソルコア、そしてメモリ階層の観点から徹底的に解剖します。
第1章:CPUとGPUの設計思想の分岐点
1.1 低レイテンシ追求 vs 高スループット追求
汎用プロセッサであるCPU(Central Processing Unit)と、並列計算に特化したGPUは、その誕生の経緯から設計思想が根本的に異なります。CPUは「いかに一つのタスク(スレッド)を速く終わらせるか」という「低レイテンシ(遅延の最小化)」を至上命題として進化してきました。一方のGPUは、「大量のタスクを束ねて、全体として単位時間あたりにどれだけの処理を完了できるか」という「高スループット(処理量の最大化)」を追求しています。
CPUは、オペレーティングシステムの制御、複雑な分岐条件を伴うアプリケーションの実行、ユーザーからのランダムな割り込み処理など、予測不可能な処理を迅速にこなす必要があります。このため、高度な分岐予測回路、アウトオブオーダー実行(命令の順序を入れ替えて実行する機構)、巨大なL1/L2/L3キャッシュメモリを搭載し、メモリアクセスの遅延を隠蔽しながら単一スレッドの性能を極限まで高めています。
これに対してGPUは、元々画面上の数百万ピクセルに対して同一のシェーディング演算を適用するといった、高度に並列化可能なタスクを処理するために生まれました。複雑な制御回路や巨大なキャッシュにダイ面積を割くのではなく、単純な演算器(ALU: Arithmetic Logic Unit)を限界まで敷き詰めるという選択をしました。
1.2 ダイ面積におけるキャッシュ・制御回路・ALUの配分比率
シリコンダイ(半導体チップ)の限られた面積(トランジスタ・バジェット)をどのように配分するかが、両者のアーキテクチャの違いを決定づけています。
- CPUのダイ面積配分: ダイの半分以上が、大容量キャッシュメモリ(SRAM)と高度な制御回路(分岐予測、命令フェッチ、デコード、スケジューリングなど)によって占められています。実際の演算を行うALUの占める割合は相対的に小さくなります。
- GPUのダイ面積配分: キャッシュメモリや制御回路は必要最小限に抑えられ、ダイの大部分が数千から数万にも及ぶALU(CUDAコア)によって占められています。
GPUはメモリアクセスの遅延(レイテンシ)をキャッシュで隠蔽するのではなく、「コンテキストスイッチング」によって隠蔽します。あるスレッド群がメモリからのデータ到着を待っている間、即座に別のスレッド群の演算を実行することで、演算器を常に稼働状態(高い占有率:オキュパンシー)に保ちます。これがGPUにおける「高スループット追求」の物理的な実装です。ハードウェアレベルでのマルチスレッディング(Hardware Multithreading)が極めて軽量に行われるため、数千〜数万の並行スレッドが存在することが前提となっています。
第2章:SIMT実行モデルの本質
2.1 SIMDとSIMTの違い
並列処理の分類としてFlynnのタクソノミー(Flynn’s taxonomy)がありますが、GPUの実行モデルはしばしばSIMD(Single Instruction, Multiple Data)と比較されます。CPUのベクタ拡張命令(AVXなど)は純粋なSIMDであり、1つの命令で複数のデータ(例えば256ビット幅のレジスタに格納された8個の32ビット浮動小数点数)を同時に処理します。SIMDでは、データの要素ごとに異なる分岐(if-else)を行うことは非常に困難です。
一方、NVIDIAが提唱したCUDAの実行モデルは**SIMT(Single Instruction, Multiple Threads)と呼ばれます。SIMTでは、複数の独立した「スレッド」がグループ(後述の「ワープ」)を形成し、同じ命令を共有して実行します。しかし、SIMDとは異なり、SIMTの各スレッドは独立したレジスタ状態と命令アドレスカウンタ(プログラミングモデル上)**を持っています。これにより、プログラマはあたかも各スレッドが独立して動作しているかのようにコードを書くことができます。
2.2 32スレッド単位の「ワープ(Warp)」
GPUのハードウェアは、スレッドを個別にスケジュールするのではなく、**32個のスレッドをひとまとめにした「ワープ(Warp)」**という単位で管理・実行します。(AMDのGPUではWavefrontと呼ばれ、64スレッド単位などが採用されることもあります)。
ストリーミング・マルチプロセッサ(SM)内の命令フェッチ・デコードユニットは、ワープ単位で1つの命令をフェッチし、ワープ内の32スレッドすべてに同じ命令を発行(ディスパッチ)します。つまり、ワープ内の32スレッドは、物理的には全く同時に、同じ命令を、それぞれの持つ異なるデータに対して実行します。これがSIMTの核心です。
2.3 ワープダイバージェンス(分岐不一致)の物理的ペナルティ
各スレッドが独立したプログラムカウンタを持つかのように振る舞えるとはいえ、物理的にはワープ内の全スレッドが同一の命令を実行しなければなりません。では、コード内に if-else のような条件分岐があり、ワープ内のスレッド間で分岐条件の真偽が分かれた場合はどうなるのでしょうか?
この現象を**ワープダイバージェンス(Warp Divergence: 分岐不一致)**と呼びます。
ワープダイバージェンスが発生すると、ハードウェアは以下のステップで処理を行います。
- まず、
if条件が真となったスレッド(アクティブスレッド)のみに対して命令を実行します。このとき、条件が偽となったスレッドは「マスク(無効化)」され、演算結果は書き込まれません。 - 次に、
else条件(あるいは条件が偽の場合のパス)に遷移し、今度は先ほどマスクされていたスレッドをアクティブにし、真だったスレッドをマスクして命令を実行します。
つまり、分岐パスが複数ある場合、ハードウェアはそれらのパスを並列ではなくシリアル(直列)に実行せざるを得なくなります。極端な例として、ワープ内の32スレッドが32通りの異なる分岐パスを辿った場合、実行時間は32倍に跳ね上がります。ワープダイバージェンスは、GPUの計算スループットを激減させる最大の要因の一つであり、アルゴリズム設計において最も回避すべきアンチパターンです。物理的には、ALUが電力を消費しているにもかかわらず、マスクされているために有効な計算結果を生成していない「無駄なサイクル」が発生していることを意味します。
第3章:ストリーミング・マルチプロセッサ(SM)のハードウェア解剖
GPUは、多数の**ストリーミング・マルチプロセッサ(SM: Streaming Multiprocessor)**の集合体として構成されています。SMこそが、GPUの真の計算エンジンです。最新のアーキテクチャ(例:Hopper H100)では、1つのGPUダイに100個以上のSMが搭載されています。
3.1 SM内部のパイプライン構成
SMは内部にさらに複数のサブパーティション(通常は4つ)に分割されており、それぞれが独立したワープスケジューラとディスパッチユニットを持っています。
- ワープスケジューラ(Warp Scheduler): 実行可能な状態(レジスタやメモリの準備ができている状態)にあるワープを選択します。GPUのスケジューラはゼロオーバーヘッドでワープを切り替えることができ、これがメモリアクセスレイテンシを隠蔽する鍵となります。
- ディスパッチユニット(Dispatch Unit): スケジュールされたワープに対して命令を発行します。
- CUDAコア(INT32 / FP32 / FP64 ALU): 実際の整数演算や浮動小数点演算を行うユニットです。
- ロード/ストアユニット(LD/ST Unit): メモリへの読み書きを担当します。
- スペシャルファンクションユニット(SFU): sin, cos, exp, 逆数などの超越関数を高速に計算する専用ハードウェアです。
命令パイプラインは非常に深く設計されており、フェッチ、デコード、スケジューリング、レジスタ読み出し、実行(複数サイクル)、ライトバックの各ステージを持ちます。FP32のFMA(Fused Multiply-Add)演算のレイテンシは通常数サイクル〜十数サイクルかかりますが、毎サイクル異なるワープから命令を発行することで、パイプラインを常に満杯に保ちます。
3.2 巨大なレジスタファイルとレジスタプレッシャー
SMには、CPUとは比較にならないほど巨大なレジスタファイルが搭載されています(例: 1SMあたり64KB〜256KBのSRAM)。これは、SM上で同時実行される何千ものスレッドのコンテキストをすべて保持するためです。
コンテキストスイッチがゼロサイクルで完了するのは、スレッドのレジスタ状態をメモリに退避(スピル)させる必要がないからです。しかし、1スレッドあたりに使用するレジスタ数が増加すると、SM内で同時に起動できるワープの数(オキュパンシー)が低下します。これをレジスタプレッシャーと呼びます。レジスタが枯渇すると、データは低速なローカルメモリ(物理的にはグローバルメモリの一部)へスピルされ、壊滅的なパフォーマンス低下を引き起こします。
3.3 共有メモリ(Shared Memory)とバンク衝突
SMには、プログラマが明示的に制御可能な超高速なオンチップメモリである**共有メモリ(Shared Memory)**が存在します。L1キャッシュと同じ物理SRAM領域を共有していますが、明示的なデータキャッシュとして機能し、ブロック内のスレッド間でのデータ共有や同期に使用されます。
共有メモリの物理的構造は**メモリバンク(Memory Banks)**と呼ばれる複数の独立したモジュール(通常32個)に分割されています。連続する32ビットのアドレスは、異なるバンクにインターリーブ(割り当て)されます。
ワープ内の32スレッドが、異なるバンクに同時にアクセスした場合、アクセスは完全に並列に(1サイクルで)処理されます。これをバンクコンフリクトフリーと呼びます。 しかし、複数のスレッドが同じバンクの異なるアドレスに同時にアクセスしようとすると、リクエストは直列化され、ペナルティ(遅延)が発生します。これを**バンク衝突(Bank Conflict)**と呼びます。例えば、2ウェイのバンク衝突ならアクセス時間は2倍になり、最悪の場合32ウェイの衝突では32倍に遅延します。行列の転置などのアルゴリズムでは、ストライドアクセスによって深刻なバンク衝突が発生するため、パディング(ダミーのデータを挿入してメモリアドレスをずらす技法)を用いて衝突を回避する高度な最適化が必須となります。
第4章:テンソルコア(Tensor Core)の積和演算パイプライン
Voltaアーキテクチャで初めて導入され、その後のGPUの性能を飛躍的に押し上げた革命的なハードウェアが**テンソルコア(Tensor Core)**です。AIとディープラーニングの爆発的な発展は、テンソルコアなしには語れません。
4.1 行列積和演算(MMA)のハードウェア実装
ディープラーニングの計算の大部分は、ニューラルネットワークの重み行列と入力データの行列積(GEMM: General Matrix Multiply)です。計算式としては $D = A \times B + C$ ($A, B$ は入力行列、$C$ はアキュムレータ行列)で表されます。
従来のCUDAコアでは、この行列積を1要素ずつFMA(Fused Multiply-Add)命令を使って計算していました。これに対し、テンソルコアは小さな行列(例:4x4や16x16)の積和演算をハードウェアレベルで1サイクル(または数サイクル)で実行する専用回路です。
物理的には、数十個から数百個の乗算器と巨大な加算ツリーをワイヤで直結し、中間結果をレジスタに書き戻すことなく一気に積和を完了させます。これにより、通常のCUDAコアに比べて、面積あたりの演算スループット(TFLOPS)が桁違いに高くなります。
4.2 Mixed-Precision(混合精度)の極意
テンソルコアのもう一つの真髄は、**Mixed-Precision(混合精度)**演算のサポートです。 深層学習では、計算の過程で高い精度(FP32/FP64)を必要としない場面が多々あります。テンソルコアは、入力行列 $A$ と $B$ を低精度(FP16, BF16, またはさらに低い FP8, INT8, INT4)で読み込み、内部の乗算を低精度で行った後、加算(アキュムレート)プロセスをより高い精度(FP32やINT32)で行うというパイプラインを持っています。
- FP16 / BF16: 学習の標準。BF16(Bfloat16)は指数部がFP32と同じ8ビットあり、ダイナミックレンジが広いため勾配消失を防ぎやすい。
- FP8 / INT8 / INT4: 推論(Inference)の高速化の切り札。データ転送量(メモリ帯域)も削減されるため、スループットが劇的に向上します。
Hopperアーキテクチャでは、Transformerモデルの計算を劇的に加速する「FP8 Tensor Core」が導入され、FP32と比較して理論上数十倍のスループットを実現しています。ソフトウェア側(CUDA)からは wmma(Warp-Level Matrix Multiply and Accumulate)APIや mma.sync PTX命令を通じてテンソルコアを直接駆動し、ワープ内のスレッドが協調して行列の断片をレジスタにロード・演算・ストアする極めて複雑なコレクティブ処理を行います。
第5章:CUDAメモリ階層と最適化技法
GPUの計算能力がどれほど高くても、データ供給がボトルネックになれば性能は出ません(メモリウォール問題)。CUDAプログラミングにおける最適化の9割は「メモリアクセスの最適化」と言っても過言ではありません。
5.1 グローバルメモリのコアレッシングアクセス
GPUのメインメモリ(HBMやGDDR)であるグローバルメモリは、非常に広い帯域幅(例えば数TB/s)を持ちますが、レイテンシも数百サイクルと非常に大きいです。
グローバルメモリへのアクセス効率を最大化する絶対原則が**コアレッシング(Coalescing: 結合)です。 GPUのメモリコントローラは、メモリに対して32バイト、64バイト、または128バイト単位のトランザクションでアクセスを行います。ワープ内の32スレッドがメモリにアクセスする際、それらのメモリアドレスが連続した領域(アライメントされた128バイト境界内)に収まっている場合、ハードウェアはこれらのリクエストを1回のメモリトランザクションに結合(コアレス)**して処理します。
逆に、スレッドがランダムなアドレスにアクセスしたり、ストライド(間隔の空いた)アクセスを行ったりすると、結合が行われず、複数のトランザクションが発生します。これを「非コアレスド・アクセス」と呼び、有効なメモリ帯域幅を10分の1以下に低下させる致命的なパフォーマンスバグとなります。
5.2 CUDA C++コード例:行列転置の最適化と共有メモリ
以下は、非コアレスド・アクセスを回避し、共有メモリを活用してパフォーマンスを劇的に改善する行列転置(Matrix Transpose)の最適化されたカーネルコードの例です。
| |
このコードのポイントは3つです。
- 読み込み時のコアレッシング:
idataからの読み込みはthreadIdx.xが連続するX方向に行われるため、完全にコアレスされます。 - 書き込み時のコアレッシング:
odataへの書き込みも、ブロックの座標を入れ替えることでthreadIdx.x方向に連続するように設計され、コアレスされます。 - 共有メモリでのパディング:
tile[TILE_DIM][TILE_DIM + 1]と1要素分ずらす(パディング)ことで、書き込み時に列方向(tile[threadIdx.x][threadIdx.y + j])にアクセスする際のバンク衝突を完全に排除しています。
5.3 キャッシュ階層と特殊なメモリ
- L1/L2キャッシュポリシー: 最近のGPUアーキテクチャでは、プログラマがPTX命令(
.ca,.cg,.csなど)を用いてキャッシュの挙動をヒントとして制御できます。例えば、一度しかアクセスしないデータはL2キャッシュをバイパスし(ストリーミングアクセス)、キャッシュの汚染を防ぐことができます。 - テクスチャメモリ / コンスタントメモリ: 画像処理に特化したテクスチャメモリは、2Dの空間局所性を持つアクセスに対して専用のキャッシュを活用します。コンスタントメモリは、全スレッドが同一の定数を読み込むブロードキャストアクセスに対して極めて高い効率を誇ります。
第6章:ディープラーニング時代におけるGPUの未来
単一のGPUの性能向上だけでなく、システム全体としてのスケーリングが現在の計算科学のフロンティアです。
6.1 NVLinkとNVSwitchによる超高速相互接続
巨大なLLM(大規模言語モデル)は、単一のGPUのメモリ(例えば80GBや144GB)には収まりきりません。モデル並列化(テンソルパラレルやパイプラインパラレル)を行うためには、GPU間でテラバイト級のデータを毎秒やり取りする必要があります。 従来のPCIe(PCI Express)バスではこの帯域幅を賄えないため、NVIDIAはNVLinkと呼ばれる独自の高速インターコネクトを開発しました。さらに、NVSwitchと呼ばれるスイッチチップを介することで、8基や256基といったGPUが完全なノンブロッキングのクロスバースイッチで結合され、あたかも1つの巨大なGPUであるかのように振る舞うクラスタを構築することが可能になりました。
6.2 Transformer EngineとFP8のエコシステム
自然言語処理のみならず、画像や音声認識でも事実上の標準となったTransformerアーキテクチャに最適化するため、HopperアーキテクチャではTransformer Engineと呼ばれる専用ハードウェアとソフトウェアの協調機構が搭載されました。 これは、テンソルの統計情報を動的に監視し、FP8とFP16の計算精度をレイヤーごとに自動的に切り替える(Dynamic Scaling)ことで、精度劣化を防ぎながら極限の計算速度とメモリ帯域の節約を実現する仕組みです。
6.3 GPUクラスタのスケーリング法則と将来展望
OpenAIの「Scaling Laws(スケーリング則)」が示す通り、モデルのパラメータ数と計算量を増やせば増やすほどAIの性能は向上し続けています。これに伴い、GPUは単なるプロセッサから、数万基を光ファイバーで接続した「データセンターそのものが1台の巨大なGPU(スーパーコンピュータ)」へと進化しています。
今後のアーキテクチャの進化は、シリコンフォトニクス(光インターコネクト)の導入、CPO(Co-Packaged Optics)、そしてSRAMからHBMへの3D積層技術のさらなる高度化へ向かうでしょう。しかし、「並列処理によるスループットの極大化」という、GPUが誕生した時から変わらぬDNAは、これからも計算科学の最前線を切り拓き続けるのです。
【追加論考】GPUにおけるスケジューリングとオキュパンシーの数理的分析
title: “グラフィックス演算プロセッサの超並列アーキテクチャとCUDAの物理:SIMT・ワープ・テンソルコアの計算原理” description: “高スループットを極限まで追求するグラフィックス演算プロセッサの内部設計。SM、ワープスケジューリング、テンソルコア、共有メモリ最適化の神髄。” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
グラフィックス演算プロセッサの超並列アーキテクチャとCUDAの物理:SIMT・ワープ・テンソルコアの計算原理
現代の高度な計算科学、人工知能、深層学習(ディープラーニング)、そして高精細なコンピュータグラフィックスを支える根幹の技術、それがグラフィックス演算プロセッサ(Graphics Processing Unit)です。本稿では、グラフィックス演算プロセッサのアーキテクチャとその上で動作する並列計算基盤であるCUDA(Compute Unified Device Architecture)の物理的、ハードウェア的な側面に深くメスを入れます。単なるプログラミングの文法ではなく、ハードウェアが「なぜそのように設計されているのか」「どのようにして極限の計算スループットを叩き出しているのか」を、ストリーミング・マルチプロセッサ(SM)、SIMT実行モデル、ワープスケジューリング、テンソルコア、そしてメモリ階層の観点から徹底的に解剖します。
追補第1章の補足:汎用演算プロセッサとグラフィックス演算プロセッサの設計思想の分岐点
1.1 低レイテンシ追求 vs 高スループット追求
汎用プロセッサである汎用演算プロセッサ(Central Processing Unit)と、並列計算に特化したグラフィックス演算プロセッサは、その誕生の経緯から設計思想が根本的に異なります。汎用演算プロセッサは「いかに一つのタスク(スレッド)を速く終わらせるか」という「低レイテンシ(遅延の最小化)」を至上命題として進化してきました。一方のグラフィックス演算プロセッサは、「大量のタスクを束ねて、全体として単位時間あたりにどれだけの処理を完了できるか」という「高スループット(処理量の最大化)」を追求しています。
汎用演算プロセッサは、オペレーティングシステムの制御、複雑な分岐条件を伴うアプリケーションの実行、ユーザーからのランダムな割り込み処理など、予測不可能な処理を迅速にこなす必要があります。このため、高度な分岐予測回路、アウトオブオーダー実行(命令の順序を入れ替えて実行する機構)、巨大なL1/L2/L3キャッシュメモリを搭載し、メモリアクセスの遅延を隠蔽しながら単一スレッドの性能を極限まで高めています。
これに対してグラフィックス演算プロセッサは、元々画面上の数百万ピクセルに対して同一のシェーディング演算を適用するといった、高度に並列化可能なタスクを処理するために生まれました。複雑な制御回路や巨大なキャッシュにダイ面積を割くのではなく、単純な演算器(ALU: Arithmetic Logic Unit)を限界まで敷き詰めるという選択をしました。
1.2 ダイ面積におけるキャッシュ・制御回路・ALUの配分比率
シリコンダイ(半導体チップ)の限られた面積(トランジスタ・バジェット)をどのように配分するかが、両者のアーキテクチャの違いを決定づけています。
- 汎用演算プロセッサのダイ面積配分: ダイの半分以上が、大容量キャッシュメモリ(SRAM)と高度な制御回路(分岐予測、命令フェッチ、デコード、スケジューリングなど)によって占められています。実際の演算を行うALUの占める割合は相対的に小さくなります。
- グラフィックス演算プロセッサのダイ面積配分: キャッシュメモリや制御回路は必要最小限に抑えられ、ダイの大部分が数千から数万にも及ぶALU(CUDAコア)によって占められています。
グラフィックス演算プロセッサはメモリアクセスの遅延(レイテンシ)をキャッシュで隠蔽するのではなく、「コンテキストスイッチング」によって隠蔽します。あるスレッド群がメモリからのデータ到着を待っている間、即座に別のスレッド群の演算を実行することで、演算器を常に稼働状態(高い占有率:オキュパンシー)に保ちます。これがグラフィックス演算プロセッサにおける「高スループット追求」の物理的な実装です。ハードウェアレベルでのマルチスレッディング(Hardware Multithreading)が極めて軽量に行われるため、数千〜数万の並行スレッドが存在することが前提となっています。
追補第2章の補足:SIMT実行モデルの本質
2.1 SIMDとSIMTの違い
並列処理の分類としてFlynnのタクソノミー(Flynn’s taxonomy)がありますが、グラフィックス演算プロセッサの実行モデルはしばしばSIMD(Single Instruction, Multiple Data)と比較されます。汎用演算プロセッサのベクタ拡張命令(AVXなど)は純粋なSIMDであり、1つの命令で複数のデータ(例えば256ビット幅のレジスタに格納された8個の32ビット浮動小数点数)を同時に処理します。SIMDでは、データの要素ごとに異なる分岐(if-else)を行うことは非常に困難です。
一方、NVIDIAが提唱したCUDAの実行モデルは**SIMT(Single Instruction, Multiple Threads)と呼ばれます。SIMTでは、複数の独立した「スレッド」がグループ(後述の「ワープ」)を形成し、同じ命令を共有して実行します。しかし、SIMDとは異なり、SIMTの各スレッドは独立したレジスタ状態と命令アドレスカウンタ(プログラミングモデル上)**を持っています。これにより、プログラマはあたかも各スレッドが独立して動作しているかのようにコードを書くことができます。
2.2 32スレッド単位の「ワープ(Warp)」
グラフィックス演算プロセッサのハードウェアは、スレッドを個別にスケジュールするのではなく、**32個のスレッドをひとまとめにした「ワープ(Warp)」**という単位で管理・実行します。(AMDのグラフィックス演算プロセッサではWavefrontと呼ばれ、64スレッド単位などが採用されることもあります)。
ストリーミング・マルチプロセッサ(SM)内の命令フェッチ・デコードユニットは、ワープ単位で1つの命令をフェッチし、ワープ内の32スレッドすべてに同じ命令を発行(ディスパッチ)します。つまり、ワープ内の32スレッドは、物理的には全く同時に、同じ命令を、それぞれの持つ異なるデータに対して実行します。これがSIMTの核心です。
2.3 ワープダイバージェンス(分岐不一致)の物理的ペナルティ
各スレッドが独立したプログラムカウンタを持つかのように振る舞えるとはいえ、物理的にはワープ内の全スレッドが同一の命令を実行しなければなりません。では、コード内に if-else のような条件分岐があり、ワープ内のスレッド間で分岐条件の真偽が分かれた場合はどうなるのでしょうか?
この現象を**ワープダイバージェンス(Warp Divergence: 分岐不一致)**と呼びます。
ワープダイバージェンスが発生すると、ハードウェアは以下のステップで処理を行います。
- まず、
if条件が真となったスレッド(アクティブスレッド)のみに対して命令を実行します。このとき、条件が偽となったスレッドは「マスク(無効化)」され、演算結果は書き込まれません。 - 次に、
else条件(あるいは条件が偽の場合のパス)に遷移し、今度は先ほどマスクされていたスレッドをアクティブにし、真だったスレッドをマスクして命令を実行します。
つまり、分岐パスが複数ある場合、ハードウェアはそれらのパスを並列ではなくシリアル(直列)に実行せざるを得なくなります。極端な例として、ワープ内の32スレッドが32通りの異なる分岐パスを辿った場合、実行時間は32倍に跳ね上がります。ワープダイバージェンスは、グラフィックス演算プロセッサの計算スループットを激減させる最大の要因の一つであり、アルゴリズム設計において最も回避すべきアンチパターンです。物理的には、ALUが電力を消費しているにもかかわらず、マスクされているために有効な計算結果を生成していない「無駄なサイクル」が発生していることを意味します。
追補第3章の補足:ストリーミング・マルチプロセッサ(SM)のハードウェア解剖
グラフィックス演算プロセッサは、多数の**ストリーミング・マルチプロセッサ(SM: Streaming Multiprocessor)**の集合体として構成されています。SMこそが、グラフィックス演算プロセッサの真の計算エンジンです。最新のアーキテクチャ(例:Hopper H100)では、1つのグラフィックス演算プロセッサダイに100個以上のSMが搭載されています。
3.1 SM内部のパイプライン構成
SMは内部にさらに複数のサブパーティション(通常は4つ)に分割されており、それぞれが独立したワープスケジューラとディスパッチユニットを持っています。
- ワープスケジューラ(Warp Scheduler): 実行可能な状態(レジスタやメモリの準備ができている状態)にあるワープを選択します。グラフィックス演算プロセッサのスケジューラはゼロオーバーヘッドでワープを切り替えることができ、これがメモリアクセスレイテンシを隠蔽する鍵となります。
- ディスパッチユニット(Dispatch Unit): スケジュールされたワープに対して命令を発行します。
- CUDAコア(INT32 / FP32 / FP64 ALU): 実際の整数演算や浮動小数点演算を行うユニットです。
- ロード/ストアユニット(LD/ST Unit): メモリへの読み書きを担当します。
- スペシャルファンクションユニット(SFU): sin, cos, exp, 逆数などの超越関数を高速に計算する専用ハードウェアです。
命令パイプラインは非常に深く設計されており、フェッチ、デコード、スケジューリング、レジスタ読み出し、実行(複数サイクル)、ライトバックの各ステージを持ちます。FP32のFMA(Fused Multiply-Add)演算のレイテンシは通常数サイクル〜十数サイクルかかりますが、毎サイクル異なるワープから命令を発行することで、パイプラインを常に満杯に保ちます。
3.2 巨大なレジスタファイルとレジスタプレッシャー
SMには、汎用演算プロセッサとは比較にならないほど巨大なレジスタファイルが搭載されています(例: 1SMあたり64KB〜256KBのSRAM)。これは、SM上で同時実行される何千ものスレッドのコンテキストをすべて保持するためです。
コンテキストスイッチがゼロサイクルで完了するのは、スレッドのレジスタ状態をメモリに退避(スピル)させる必要がないからです。しかし、1スレッドあたりに使用するレジスタ数が増加すると、SM内で同時に起動できるワープの数(オキュパンシー)が低下します。これをレジスタプレッシャーと呼びます。レジスタが枯渇すると、データは低速なローカルメモリ(物理的にはグローバルメモリの一部)へスピルされ、壊滅的なパフォーマンス低下を引き起こします。
3.3 共有メモリ(Shared Memory)とバンク衝突
SMには、プログラマが明示的に制御可能な超高速なオンチップメモリである**共有メモリ(Shared Memory)**が存在します。L1キャッシュと同じ物理SRAM領域を共有していますが、明示的なデータキャッシュとして機能し、ブロック内のスレッド間でのデータ共有や同期に使用されます。
共有メモリの物理的構造は**メモリバンク(Memory Banks)**と呼ばれる複数の独立したモジュール(通常32個)に分割されています。連続する32ビットのアドレスは、異なるバンクにインターリーブ(割り当て)されます。
ワープ内の32スレッドが、異なるバンクに同時にアクセスした場合、アクセスは完全に並列に(1サイクルで)処理されます。これをバンクコンフリクトフリーと呼びます。 しかし、複数のスレッドが同じバンクの異なるアドレスに同時にアクセスしようとすると、リクエストは直列化され、ペナルティ(遅延)が発生します。これを**バンク衝突(Bank Conflict)**と呼びます。例えば、2ウェイのバンク衝突ならアクセス時間は2倍になり、最悪の場合32ウェイの衝突では32倍に遅延します。行列の転置などのアルゴリズムでは、ストライドアクセスによって深刻なバンク衝突が発生するため、パディング(ダミーのデータを挿入してメモリアドレスをずらす技法)を用いて衝突を回避する高度な最適化が必須となります。
追補第4章の補足:テンソルコア(Tensor Core)の積和演算パイプライン
Voltaアーキテクチャで初めて導入され、その後のグラフィックス演算プロセッサの性能を飛躍的に押し上げた革命的なハードウェアが**テンソルコア(Tensor Core)**です。AIとディープラーニングの爆発的な発展は、テンソルコアなしには語れません。
4.1 行列積和演算(MMA)のハードウェア実装
ディープラーニングの計算の大部分は、ニューラルネットワークの重み行列と入力データの行列積(GEMM: General Matrix Multiply)です。計算式としては $D = A \times B + C$ ($A, B$ は入力行列、$C$ はアキュムレータ行列)で表されます。
従来のCUDAコアでは、この行列積を1要素ずつFMA(Fused Multiply-Add)命令を使って計算していました。これに対し、テンソルコアは小さな行列(例:4x4や16x16)の積和演算をハードウェアレベルで1サイクル(または数サイクル)で実行する専用回路です。
物理的には、数十個から数百個の乗算器と巨大な加算ツリーをワイヤで直結し、中間結果をレジスタに書き戻すことなく一気に積和を完了させます。これにより、通常のCUDAコアに比べて、面積あたりの演算スループット(TFLOPS)が桁違いに高くなります。
4.2 Mixed-Precision(混合精度)の極意
テンソルコアのもう一つの真髄は、**Mixed-Precision(混合精度)**演算のサポートです。 深層学習では、計算の過程で高い精度(FP32/FP64)を必要としない場面が多々あります。テンソルコアは、入力行列 $A$ と $B$ を低精度(FP16, BF16, またはさらに低い FP8, INT8, INT4)で読み込み、内部の乗算を低精度で行った後、加算(アキュムレート)プロセスをより高い精度(FP32やINT32)で行うというパイプラインを持っています。
- FP16 / BF16: 学習の標準。BF16(Bfloat16)は指数部がFP32と同じ8ビットあり、ダイナミックレンジが広いため勾配消失を防ぎやすい。
- FP8 / INT8 / INT4: 推論(Inference)の高速化の切り札。データ転送量(メモリ帯域)も削減されるため、スループットが劇的に向上します。
Hopperアーキテクチャでは、Transformerモデルの計算を劇的に加速する「FP8 Tensor Core」が導入され、FP32と比較して理論上数十倍のスループットを実現しています。ソフトウェア側(CUDA)からは wmma(Warp-Level Matrix Multiply and Accumulate)APIや mma.sync PTX命令を通じてテンソルコアを直接駆動し、ワープ内のスレッドが協調して行列の断片をレジスタにロード・演算・ストアする極めて複雑なコレクティブ処理を行います。
追補第5章の補足:CUDAメモリ階層と最適化技法
グラフィックス演算プロセッサの計算能力がどれほど高くても、データ供給がボトルネックになれば性能は出ません(メモリウォール問題)。CUDAプログラミングにおける最適化の9割は「メモリアクセスの最適化」と言っても過言ではありません。
5.1 グローバルメモリのコアレッシングアクセス
グラフィックス演算プロセッサのメインメモリ(HBMやGDDR)であるグローバルメモリは、非常に広い帯域幅(例えば数TB/s)を持ちますが、レイテンシも数百サイクルと非常に大きいです。
グローバルメモリへのアクセス効率を最大化する絶対原則が**コアレッシング(Coalescing: 結合)です。 グラフィックス演算プロセッサのメモリコントローラは、メモリに対して32バイト、64バイト、または128バイト単位のトランザクションでアクセスを行います。ワープ内の32スレッドがメモリにアクセスする際、それらのメモリアドレスが連続した領域(アライメントされた128バイト境界内)に収まっている場合、ハードウェアはこれらのリクエストを1回のメモリトランザクションに結合(コアレス)**して処理します。
逆に、スレッドがランダムなアドレスにアクセスしたり、ストライド(間隔の空いた)アクセスを行ったりすると、結合が行われず、複数のトランザクションが発生します。これを「非コアレスド・アクセス」と呼び、有効なメモリ帯域幅を10分の1以下に低下させる致命的なパフォーマンスバグとなります。
5.2 CUDA C++コード例:行列転置の最適化と共有メモリ
以下は、非コアレスド・アクセスを回避し、共有メモリを活用してパフォーマンスを劇的に改善する行列転置(Matrix Transpose)の最適化されたカーネルコードの例です。
| |
このコードのポイントは3つです。
- 読み込み時のコアレッシング:
idataからの読み込みはthreadIdx.xが連続するX方向に行われるため、完全にコアレスされます。 - 書き込み時のコアレッシング:
odataへの書き込みも、ブロックの座標を入れ替えることでthreadIdx.x方向に連続するように設計され、コアレスされます。 - 共有メモリでのパディング:
tile[TILE_DIM][TILE_DIM + 1]と1要素分ずらす(パディング)ことで、書き込み時に列方向(tile[threadIdx.x][threadIdx.y + j])にアクセスする際のバンク衝突を完全に排除しています。
5.3 キャッシュ階層と特殊なメモリ
- L1/L2キャッシュポリシー: 最近のグラフィックス演算プロセッサアーキテクチャでは、プログラマがPTX命令(
.ca,.cg,.csなど)を用いてキャッシュの挙動をヒントとして制御できます。例えば、一度しかアクセスしないデータはL2キャッシュをバイパスし(ストリーミングアクセス)、キャッシュの汚染を防ぐことができます。 - テクスチャメモリ / コンスタントメモリ: 画像処理に特化したテクスチャメモリは、2Dの空間局所性を持つアクセスに対して専用のキャッシュを活用します。コンスタントメモリは、全スレッドが同一の定数を読み込むブロードキャストアクセスに対して極めて高い効率を誇ります。
追補第6章の補足:ディープラーニング時代におけるグラフィックス演算プロセッサの未来
単一のグラフィックス演算プロセッサの性能向上だけでなく、システム全体としてのスケーリングが現在の計算科学のフロンティアです。
6.1 NVLinkとNVSwitchによる超高速相互接続
巨大なLLM(大規模言語モデル)は、単一のグラフィックス演算プロセッサのメモリ(例えば80GBや144GB)には収まりきりません。モデル並列化(テンソルパラレルやパイプラインパラレル)を行うためには、グラフィックス演算プロセッサ間でテラバイト級のデータを毎秒やり取りする必要があります。 従来のPCIe(PCI Express)バスではこの帯域幅を賄えないため、NVIDIAはNVLinkと呼ばれる独自の高速インターコネクトを開発しました。さらに、NVSwitchと呼ばれるスイッチチップを介することで、8基や256基といったグラフィックス演算プロセッサが完全なノンブロッキングのクロスバースイッチで結合され、あたかも1つの巨大なグラフィックス演算プロセッサであるかのように振る舞うクラスタを構築することが可能になりました。
6.2 Transformer EngineとFP8のエコシステム
自然言語処理のみならず、画像や音声認識でも事実上の標準となったTransformerアーキテクチャに最適化するため、HopperアーキテクチャではTransformer Engineと呼ばれる専用ハードウェアとソフトウェアの協調機構が搭載されました。 これは、テンソルの統計情報を動的に監視し、FP8とFP16の計算精度をレイヤーごとに自動的に切り替える(Dynamic Scaling)ことで、精度劣化を防ぎながら極限の計算速度とメモリ帯域の節約を実現する仕組みです。
6.3 グラフィックス演算プロセッサクラスタのスケーリング法則と将来展望
OpenAIの「Scaling Laws(スケーリング則)」が示す通り、モデルのパラメータ数と計算量を増やせば増やすほどAIの性能は向上し続けています。これに伴い、グラフィックス演算プロセッサは単なるプロセッサから、数万基を光ファイバーで接続した「データセンターそのものが1台の巨大なグラフィックス演算プロセッサ(スーパーコンピュータ)」へと進化しています。
今後のアーキテクチャの進化は、シリコンフォトニクス(光インターコネクト)の導入、CPO(Co-Packaged Optics)、そしてSRAMからHBMへの3D積層技術のさらなる高度化へ向かうでしょう。しかし、「並列処理によるスループットの極大化」という、グラフィックス演算プロセッサが誕生した時から変わらぬDNAは、これからも計算科学の最前線を切り拓き続けるのです。
結語:計算科学の極北へ
GPUのアーキテクチャは、人類がこれまでに生み出した最も複雑で、かつ最もスループットに特化した計算エンジンです。CPUが「一台の超高性能なF1マシン」であるならば、GPUは「数万台のダンプカーが統制された動きで同時に物資を運ぶ巨大な物流システム」に例えられます。
SIMTによるワープ単位の命令実行、数千のスレッドをゼロサイクルで切り替えるハードウェアスケジューリング、限界まで帯域幅を引き出すコアレッシングアクセス、そしてディープラーニングのブレイクスルーを牽引したテンソルコアのパイプライン。これらすべては、「物理法則の限界(光速、熱、電力、シリコンの微細化限界)の中で、いかにして浮動小数点演算の総量を最大化するか」というエンジニアたちの狂気とも言える執念の結晶です。
これからのソフトウェアエンジニア、AIリサーチャー、HPC研究者にとって、GPUのアーキテクチャを理解することは、単なる教養ではありません。フレームワーク(PyTorchやTensorFlow)の背後で何が起きているのかを直感的に把握し、ハードウェアの能力を極限まで引き出すための「必修科目」なのです。 メモリのバンク衝突を避け、ワープダイバージェンスを排除し、テンソルコアのパイプラインをデータで満たし続けること。その最適化の果てに、かつてはスーパーコンピュータで何ヶ月もかかっていた計算が、机の上の数枚のGPUで数時間で完了する未来が、今まさに現実のものとなっています。
我々は今、人類史上最もエキサイティングな計算機アーキテクチャの黄金時代を生きています。CUDAの物理とGPUの超並列アーキテクチャの真髄を理解し、次世代のイノベーションを生み出すのは、この記事を読んでいるあなた自身かもしれません。
専門用語解説(Glossary)
- SM (Streaming Multiprocessor): GPUの主要な演算ブロック。CPUにおけるコアに相当するが、その内部に多数のCUDAコア、ワープスケジューラ、共有メモリ等を内包する。
- SIMT (Single Instruction, Multiple Threads): ワープ内の全スレッドが同一の命令を共有しながら、独立したデータに対して演算を行うGPU特有の実行モデル。
- Warp (ワープ): 32個のスレッドの集合体。ハードウェアによるスケジューリングと命令発行の最小単位。
- Warp Divergence (ワープダイバージェンス): ワープ内のスレッド間で分岐条件が分かれ、実行パスが直列化してスループットが低下する現象。
- Tensor Core (テンソルコア): 行列積和演算(MMA)をハードウェアレベルで一気に処理する専用回路。深層学習の高速化に特化。
- Coalesced Access (コアレスド・アクセス): ワープ内のスレッドが連続したメモリアドレスにアクセスした際、ハードウェアがそれを1つのトランザクションに結合して広帯域を実現する仕組み。
- Shared Memory (共有メモリ): SM内部に搭載されたプログラマ制御可能な超高速L1スクラッチパッドメモリ。
- Bank Conflict (バンク衝突): 共有メモリにおいて、複数のスレッドが同一バンクの異なるアドレスに同時にアクセスし、アクセスが直列化するペナルティ。
- Occupancy (オキュパンシー / 占有率): SM上で同時にアクティブにできるワープ数の理論的最大値に対する実際の割合。高いほどメモリアクセスレイテンシを隠蔽しやすい。
- Register Spilling (レジスタスピリング): スレッドが使用するレジスタ数がハードウェアの上限を超え、あふれたデータが低速なメモリ(ローカルメモリ)に待避される現象。
参考文献および推奨リーディングリスト
- NVIDIA CUDA C++ Programming Guide: すべてのCUDAプログラマが必ず読むべき公式ドキュメント。メモリアクセスパターンや最適化のベストプラクティスが網羅されている。
- NVIDIA Ampere / Hopper Architecture Whitepaper: テンソルコアのパイプラインや非同期メモリ転送、Transformer Engineのハードウェア実装の詳細が記載された公式ホワイトペーパー。
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): コンピュータアーキテクチャの古典的名著。CPUとGPUの設計思想の違い、キャッシュ階層、命令レベル並列性について深く学べる。
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): CUDAプログラミングをアルゴリズム設計の観点から解説した教科書。共有メモリのタイリング技法やリダクション、プレフィックスサムなどの実装が詳解されている。
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: 学術論文。NVIDIAが公開していないキャッシュのレイテンシやテンソルコアの正確なスループットをマイクロベンチマークで解き明かした傑作。
本稿で解説したアーキテクチャの知識は、ハードウェアの進化とともに陳腐化する部分もあるかもしれませんが、「帯域幅を最大化し、並列性を引き出し、レイテンシを隠蔽する」という根本的な物理原則は、計算機科学の普遍の真理として残り続けるでしょう。