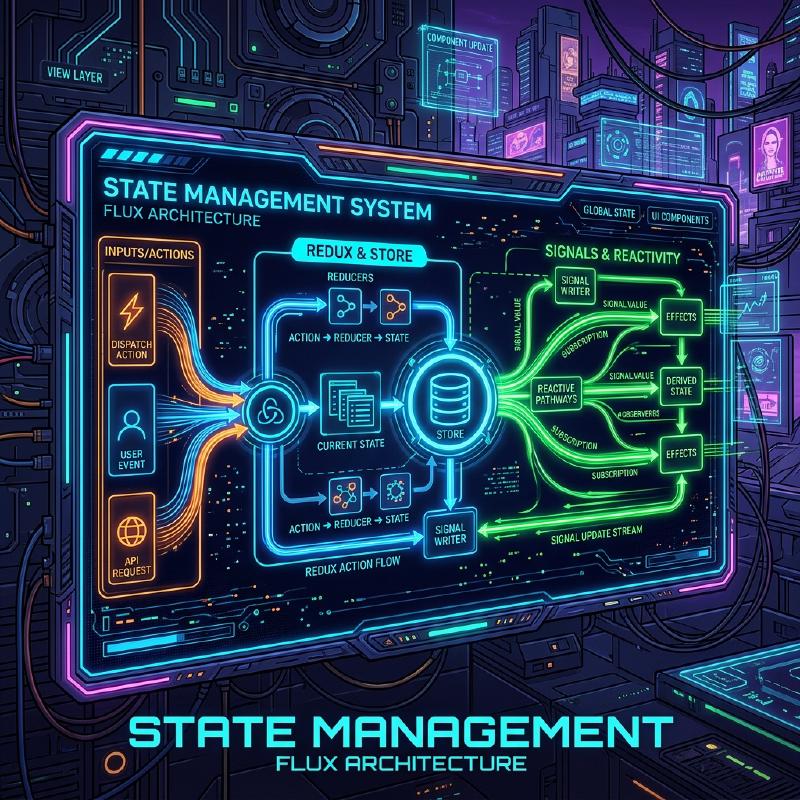
프론트엔드 개발의 역사에서 가장 큰 과제인 '상태 관리'. MVC부터 Flux, Redux, Context API, 그리고 Signals와 세립도 리액티비티(Fine-grained Reactivity)에 이르기까지의 변천과 미래를 깊이 파헤치는 완전한 가이드.
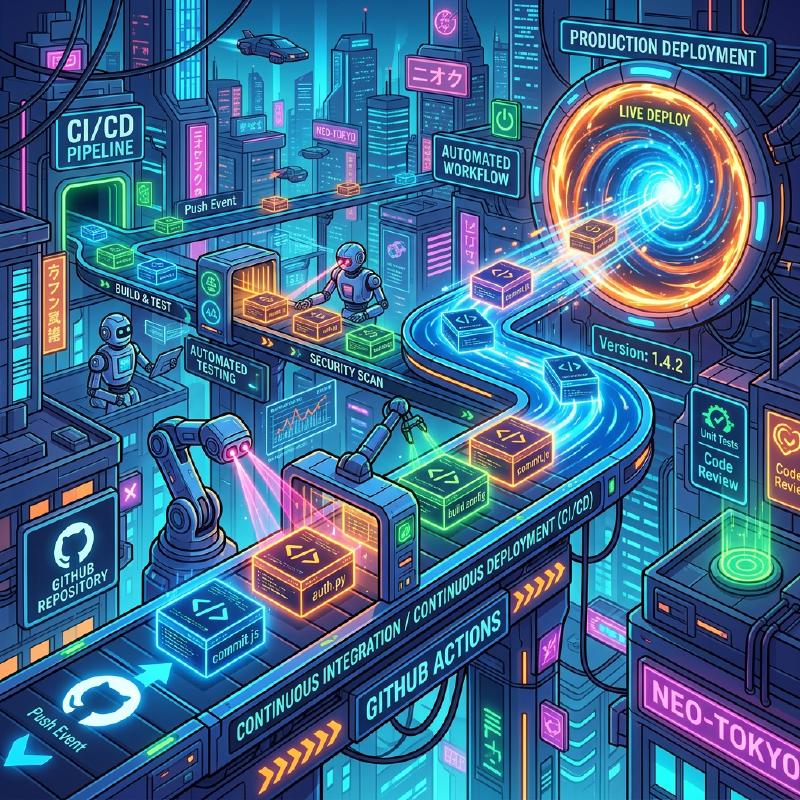
소프트웨어 개발 수명 주기를 가속화하는 CI/CD 원칙과 GitHub Actions를 사용한 실용적인 파이프라인 구축 노하우를 망라합니다.
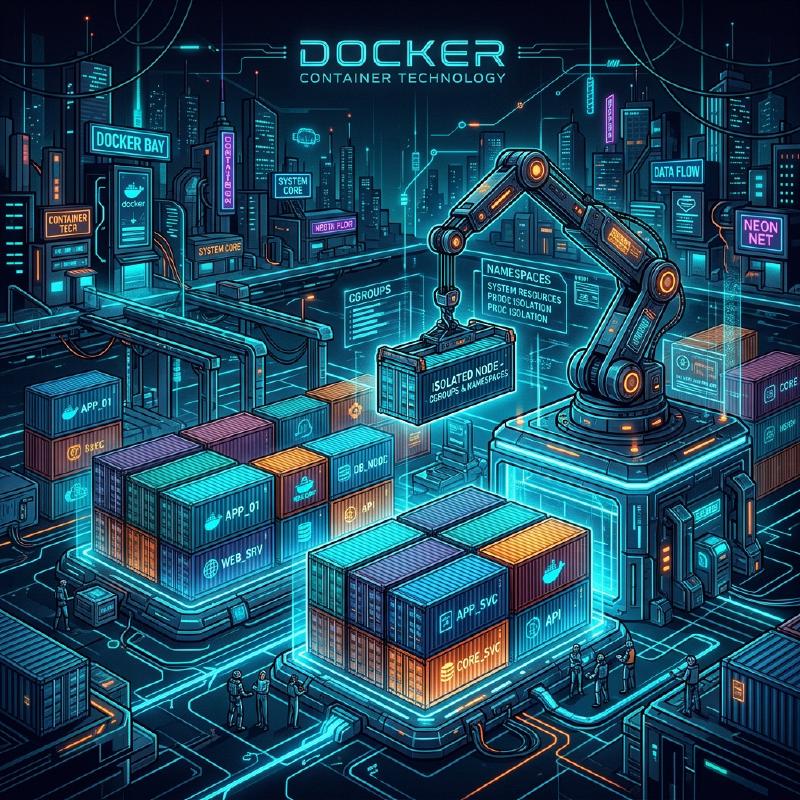
단순한 도구 사용법을 넘어, Linux 커널의 기능(Namespace, cgroups, OverlayFS)을 이용한 컨테이너 이면의 메커니즘을 철저히 해부합니다.
인프라를 코드로 관리하는 IaC의 중요성과 Terraform이 채택하는 선언적 접근 방식의 이점. 상태 관리(State)의 구조와 모범 사례를 해설합니다.
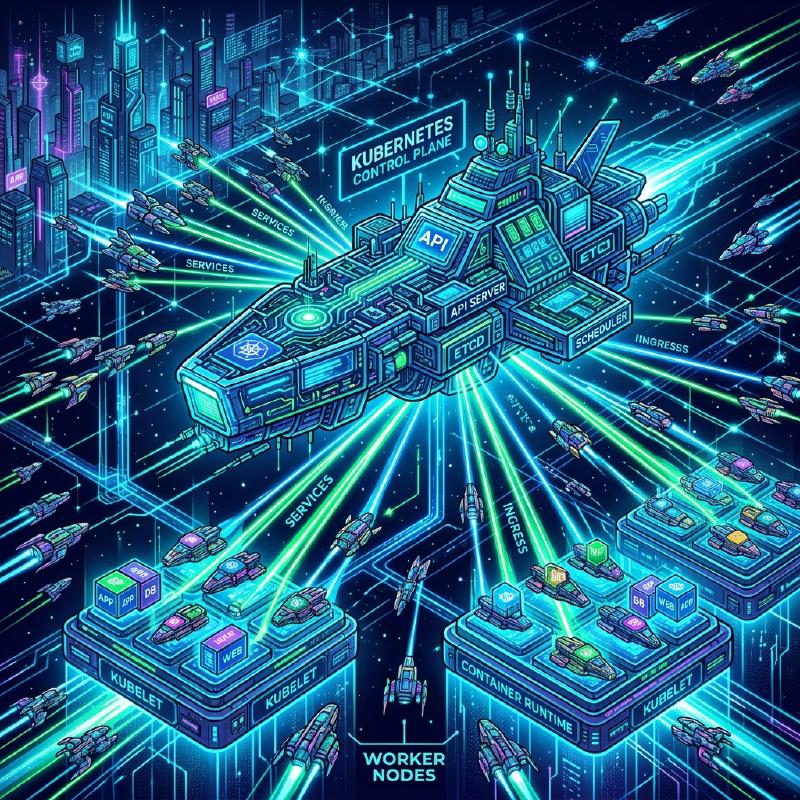
컨테이너 오케스트레이션의 사실상 표준인 Kubernetes의 전체적인 모습. 컨트롤 플레인의 구조부터 다양한 리소스의 역할까지 상세히 해설합니다.
서버리스의 장점뿐만 아니라, 배후에서 움직이는 컨테이너의 원리, 콜드 스타트 문제와 그 대책(SnapStart 등)을 깊이 파헤칩니다.
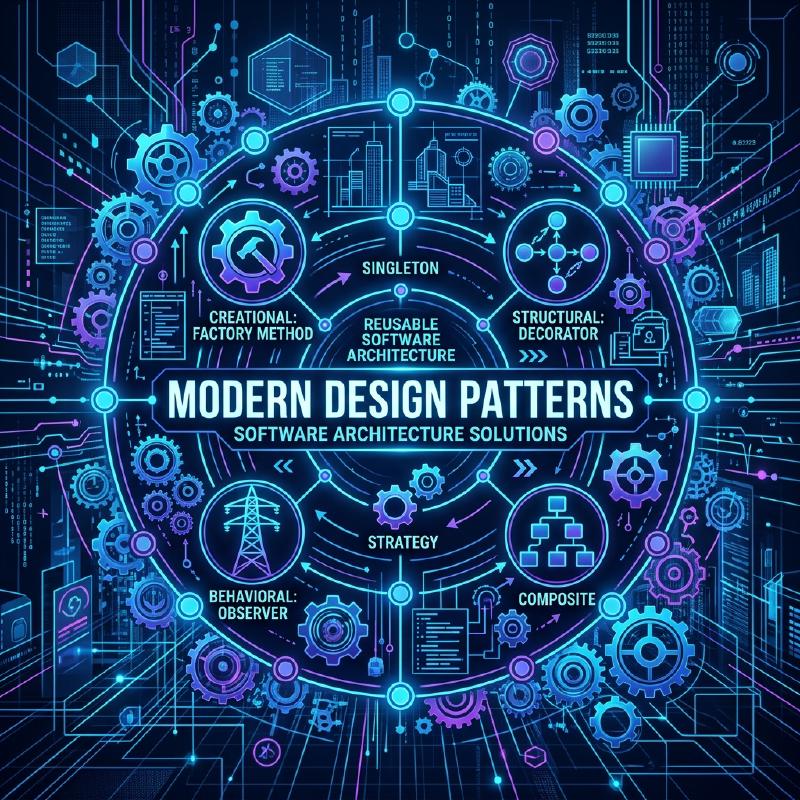
1994년에 제창된 GoF 디자인 패턴. 현대의 모던 프로그래밍 언어에서 그것들은 아직 유효한가? 함수형 프로그래밍의 영향이나 새로운 패러다임을 교차하여 현대 설계의 베스트 프랙티스를 깊게 고찰합니다.
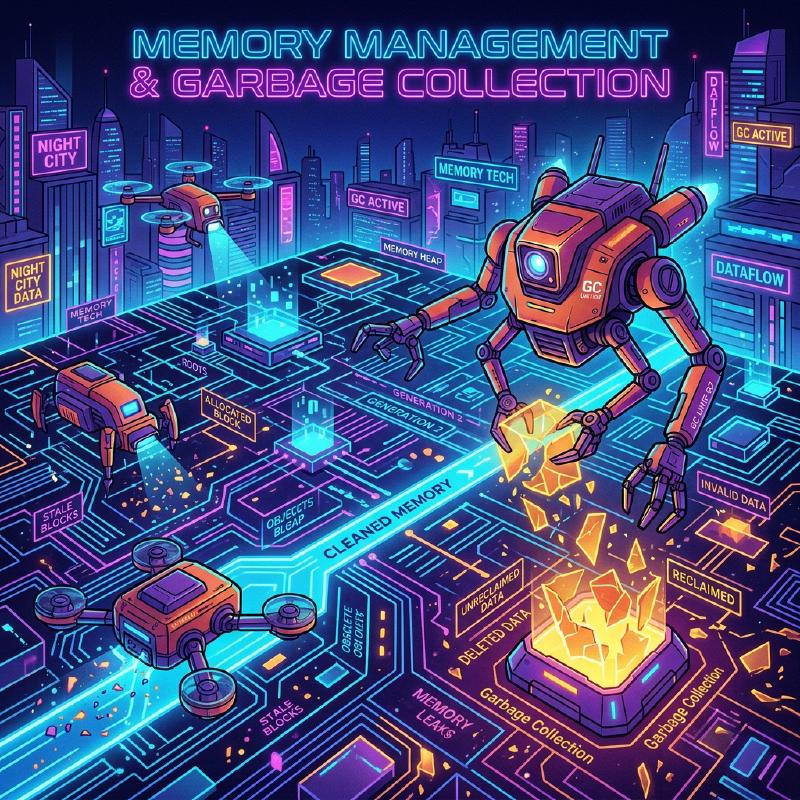
프로그래밍의 메모리 관리 기초부터 C언어의 수동 관리, Java의 가비지 컬렉션, Rust의 소유권 모델까지 깊이 있게 비교하고 해설합니다.
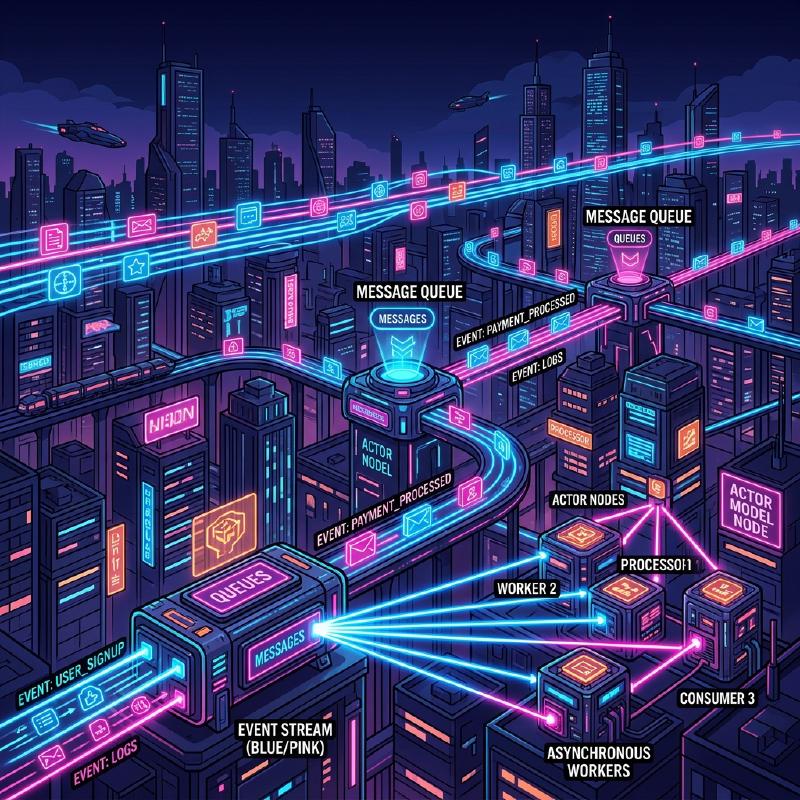
현대 분산 시스템에서 필수적인 이벤트 기반 아키텍처와 비동기 처리에 대해 Event Loop, Actor 모델, CQRS의 관점에서 깊이 파헤쳐 봅니다.
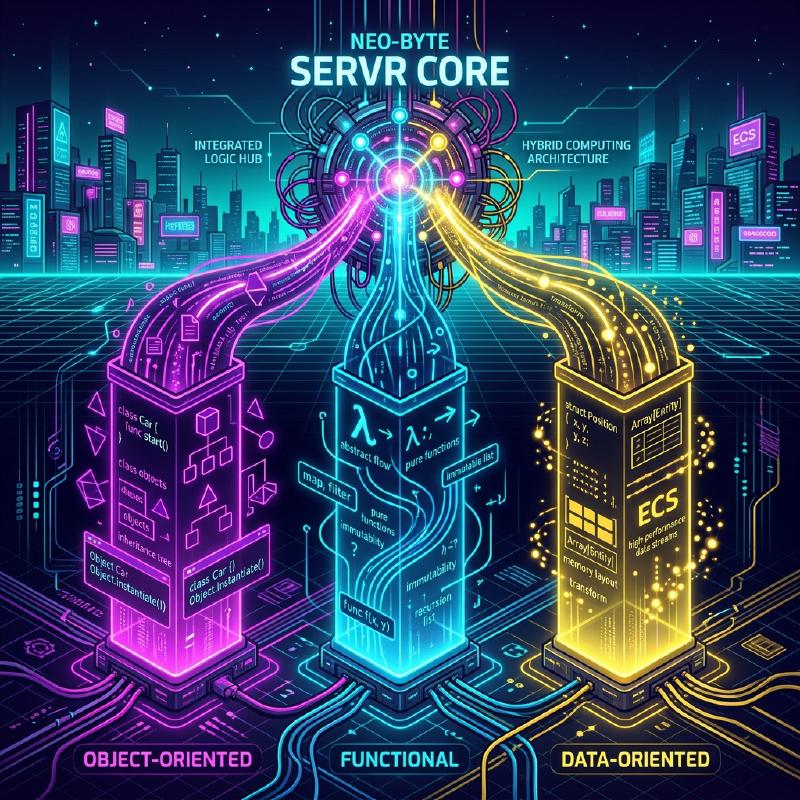
프로그래밍 패러다임의 역사와 진화, OOP, FP, DOP의 각각의 강점과 한계를 깊이 파고들어, 현대 개발에 있어서의 최적의 해답인 '패러다임의 융합'에 대해 철저하게 고찰합니다.
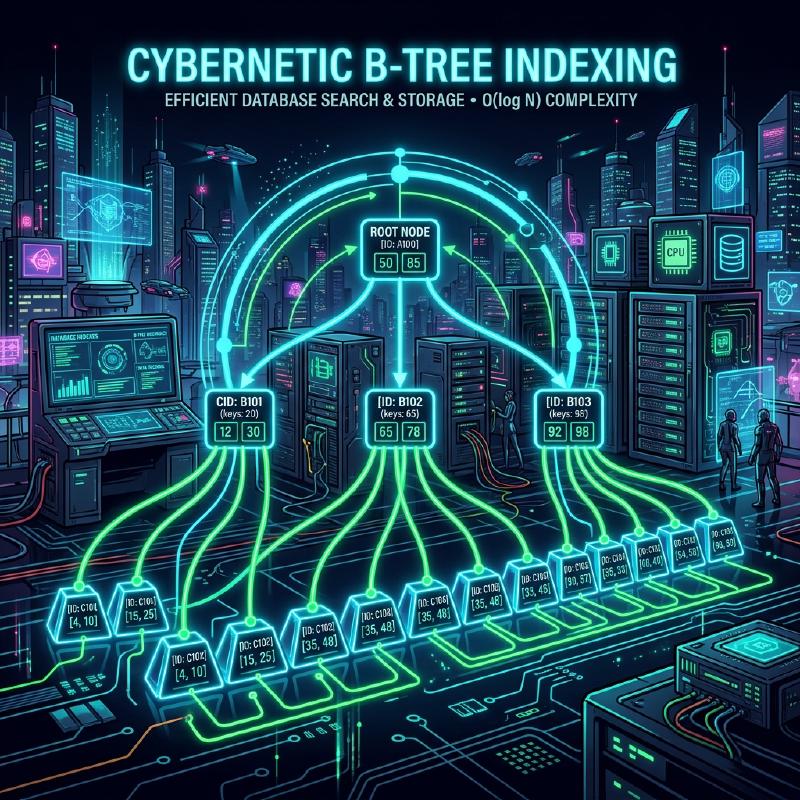
데이터베이스 인덱스의 근간을 이루는 B-트리(B-Tree)와 B+트리(B+Tree)의 이론, 데이터 구조, 디스크 I/O와의 관계성, 그리고 왜 RDBMS가 B-트리를 인덱스의 표준으로 계속 채택하고 있는지 수학적 분석과 구현 예시를 통해 깊이 파헤쳐 봅니다.
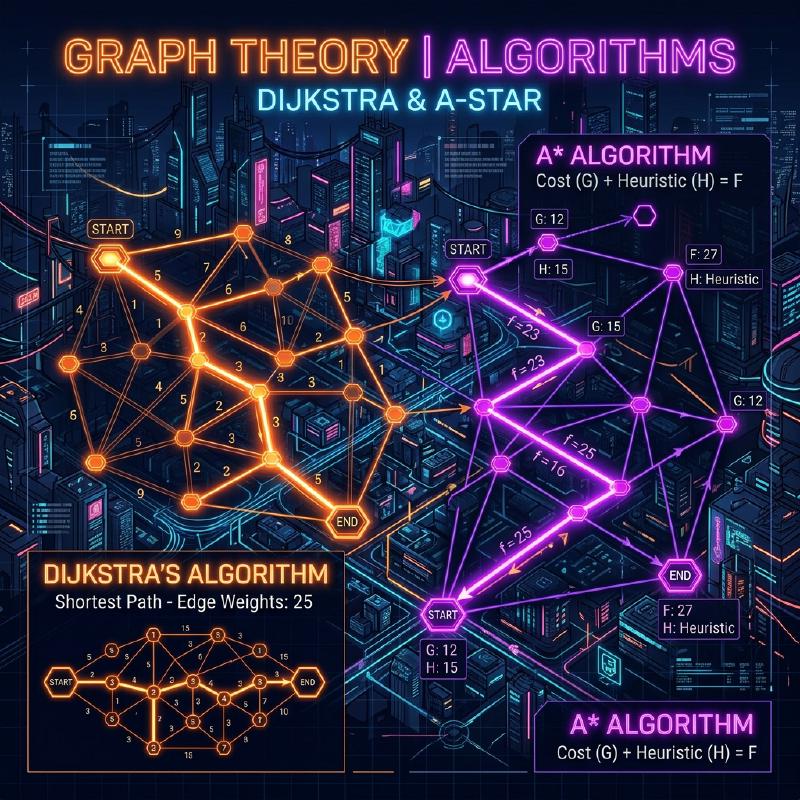
그래프 이론의 기초부터 시작하여 최단 경로 문제에서의 다익스트라법과 A* 알고리즘의 수학적 배경, 데이터 구조, Python 구현까지 철저히 해설합니다.
분산 시스템의 근간을 이루는 합의 알고리즘에 대해 비잔틴 장군 문제의 기원부터 Paxos, Raft, 그리고 악의적인 노드에 내성을 가지는 BFT까지 이론, 수식, 코드 구현을 섞어 철저하게 깊이 파고듭니다.
클로드 섀넌이 제창한 정보 이론의 기초부터 엔트로피의 개념, 데이터 압축의 한계, 그리고 현대 통신에의 응용까지 상세히 해설합니다.
밀레니엄 현상 문제 중 하나인 'P vs NP 문제'에 대해 계산 복잡도 클래스(P, NP, NP-완전, NP-난해)의 기초부터 최신 연구 동향, 프로그래밍과 암호 이론에 미치는 영향까지 철저하게 깊이 파헤쳐 해설합니다.
계산의 기초 이론인 람다 대수가 어떻게 현대의 함수형 프로그래밍 언어로 발전했는지. 알론조 처치의 이론에서 Lisp, Haskell의 탄생에 이르기까지의 역사와 수학적 기반을 철저히 해설합니다.
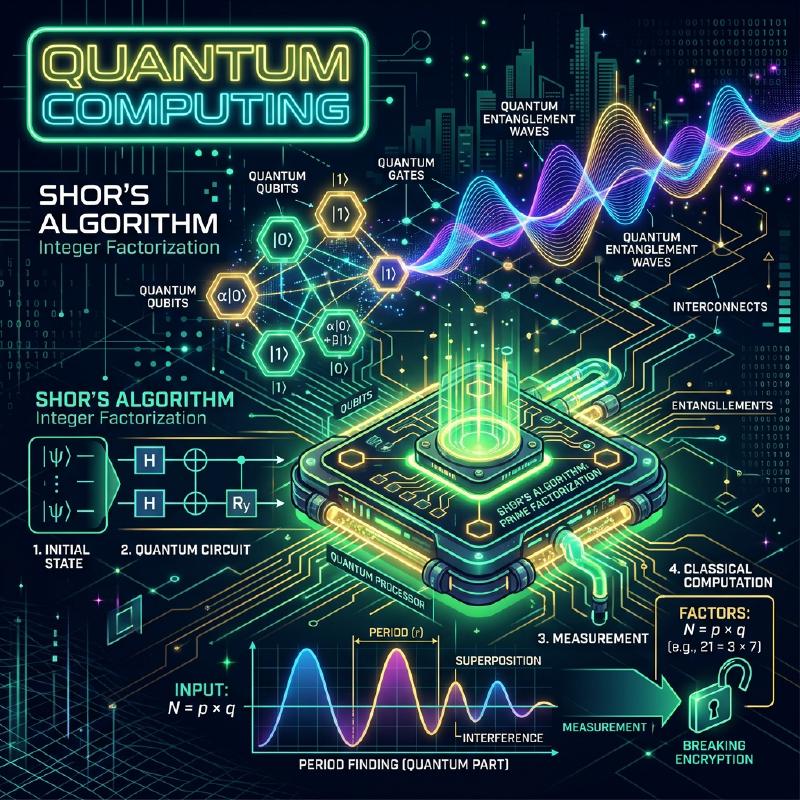
양자 컴퓨터의 기초부터, RSA 암호의 위협이 되는 쇼어의 알고리즘(Shor's Algorithm)의 수학적・양자 역학적 원리까지 깊이 있게 해설. Qiskit을 이용한 구현 예제와 향후 포스트 양자 암호의 전망도 포함하여 압도적인 정보량으로 상세히 설명합니다.
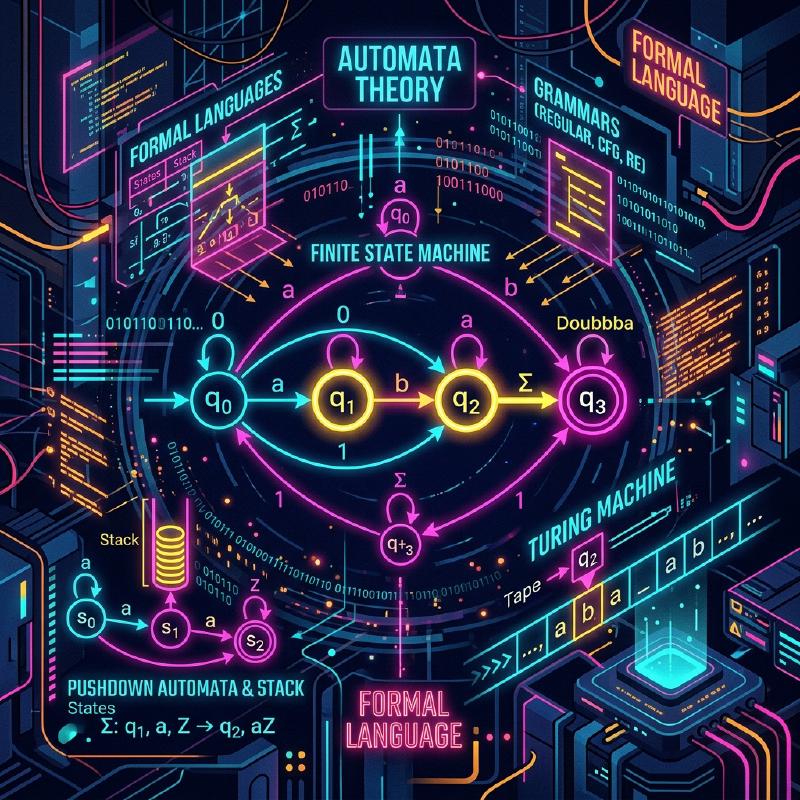
정규 표현식이나 프로그래밍 언어의 컴파일러 이면에 있는 '오토마타'와 '형식 언어 이론'에 대해 촘스키 계층을 곁들여 깊이 파헤쳐 봅니다.
계산의 한계란 무엇인가? 앨런 튜링이 제창한 튜링 머신의 개념과 계산 가능성 이론의 금자탑인 '정지 문제'에 대해 수학적, 프로그램적 관점에서 깊이 파헤쳐 봅니다.
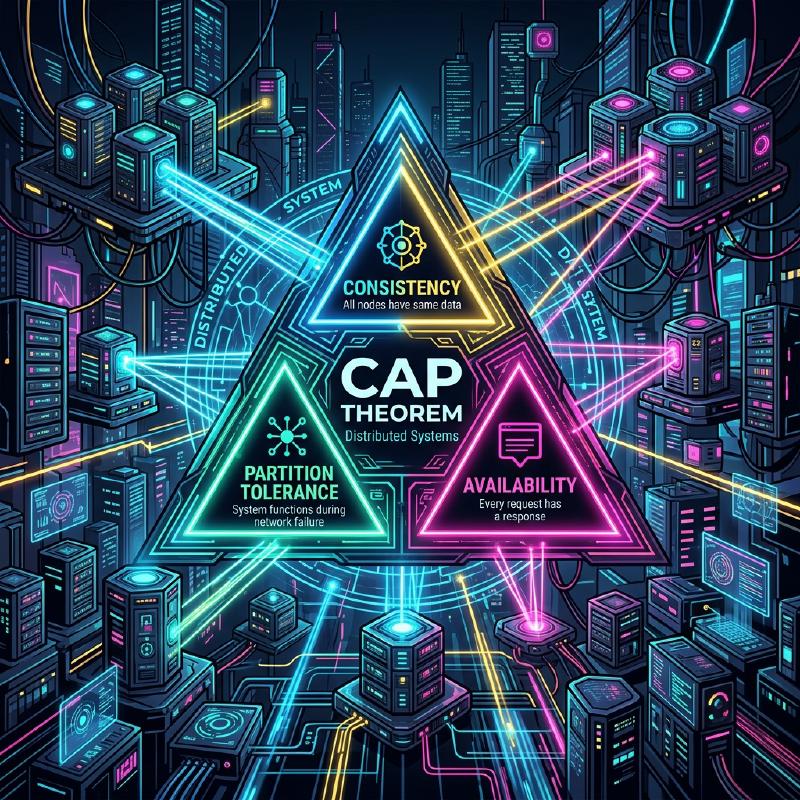
분산 시스템에서 가장 중요한 원칙인 CAP 정리에 대해, 그 정의부터 증명, PACELC 정리로의 확장, 그리고 실제 분산 데이터베이스에서의 구현까지 깊이 파헤칩니다.