가상 메모리와 페이징 메커니즘의 완전 해부: MMU부터 TLB, HugePage, 그리고 메모리 관리의 심연까지
현대의 운영체제(OS)와 CPU 아키텍처에서 가장 복잡하면서도 가장 중요한 시스템 중 하나가 바로 ‘가상 메모리(Virtual Memory)‘와 ‘페이징(Paging)’ 메커니즘입니다. 애플리케이션 개발자가 평소 의식하지 못하는 메모리 공간의 이면에서는, 하드웨어인 MMU(Memory Management Unit)와 OS 커널이 긴밀하게 협력하여 나노초의 세계에서 방대한 주소 변환과 예외 처리를 수행하고 있습니다.
이 글에서는 운영체제 내부 구조와 컴퓨터 아키텍처의 관점에서 가상 메모리 시스템의 가장 깊은 곳을 해부합니다. x86-64 아키텍처의 페이지 테이블 구조의 완전한 비트 레이아웃부터, TLB 슛다운(Shootdown)의 IPI 프로토콜, Linux 커널에서의 페이지 폴트의 완벽한 추적, Copy-on-Write(CoW)의 물리적 메커니즘, 메모리 회수(Reclaim) 알고리즘, OOM Killer의 점수 계산식에 이르기까지, 저수준(Low-level) 메커니즘을 소스 코드 수준 및 레지스터 수준에서 철저하게 해설합니다.
제1장: 가상 메모리의 존재 이유와 역사적 배경
왜 컴퓨터에는 가상 메모리가 필요할까요? 초기의 컴퓨터 시스템에서는 프로그램이 물리 메모리(RAM)의 특정 주소에 직접 접근했습니다. 하지만 멀티태스킹 환경이 보급됨에 따라 이 ‘물리 주소 직접 지정 방식’은 한계에 부딪혔습니다.
1.1 메모리 보호와 프로세스 공간의 완벽한 분리
가상 메모리의 가장 큰 목적은 ‘보안과 안정성 보장’입니다. 프로세스 A가 프로세스 B의 메모리를 실수로(혹은 악의적으로) 덮어써 버리면 시스템 전체가 크래시되거나 기밀 정보가 유출될 수 있습니다. 가상 메모리는 각 프로세스에게 ‘자신만의 연속된 메모리 공간을 가지고 있다’는 환상을 심어줍니다. 이를 통해 프로세스 간의 메모리는 하드웨어 수준(MMU)에서 엄격하게 분리되며, 잘못된 메모리 접근은 즉시 트랩되어 세그멘테이션 폴트(Segmentation Fault)로 처리됩니다. 사용자 공간(User Space)과 커널 공간(Kernel Space)의 분리도 이 메커니즘에 의해 구현되어 있으며, 특권 링(Privilege Ring)의 전환과 메모리 접근 권한 검사는 하드웨어에 의해 매 사이클마다 이루어집니다.
1.2 물리 메모리 용량의 장벽 타파와 요구 페이징 사상
애플리케이션이 요구하는 메모리 양이 탑재된 물리 RAM의 용량을 초과하는 것은 드문 일이 아닙니다. 가상 메모리는 현재 사용되지 않는 메모리 영역(페이지)을 보조 기억 장치(HDD/SSD)로 대피(스왑 아웃)시키고, 필요해지면 다시 읽어 들이는(스왑 인) 방식으로 물리 메모리 이상의 광활한 주소 공간을 제공합니다. 또한 프로그램 실행 시작 시에 모든 코드나 데이터를 메모리에 읽어 들이는 것이 아니라, 접근이 발생한 시점에 비로소 메모리에 로드하는 ‘디맨드 페이징(요구 페이징)’ 사상을 통해 메모리 절약과 실행 속도 향상을 동시에 달성합니다.
1.3 세그먼테이션에서 페이징으로의 패러다임 전환
초기의 x86(80286 등)에서는 가변 길이의 블록으로 메모리를 관리하는 ‘세그먼테이션(Segmentation)‘이 사용되었습니다. CS(코드 세그먼트), DS(데이터 세그먼트) 등의 레지스터를 사용하여 논리 주소를 베이스 주소 + 오프셋으로 계산하는 방식입니다. 하지만 세그먼테이션은 ‘외부 단편화(External Fragmentation)‘를 일으키기 쉽고 관리가 매우 번거로웠습니다. 그 후 80386의 등장과 함께 고정 길이(일반적으로 4KB)의 블록으로 관리하는 ‘페이징(Paging)‘이 도입되어 주류가 되었습니다. 현대의 64비트 OS(Linux나 Windows)는 세그먼테이션을 플랫 메모리 모델(베이스 주소 0, 리미트 최대)로 사실상 무효화하고 페이징으로만 메모리 관리를 수행합니다. 세그먼테이션은 현재 스레드 로컬 스토리지(TLS)의 참조(FS/GS 레지스터) 등 극히 일부 용도로만 사용되고 있습니다.
제2장: x86-64의 페이지 테이블 다단계 구조와 비트 레이아웃 완전 해부
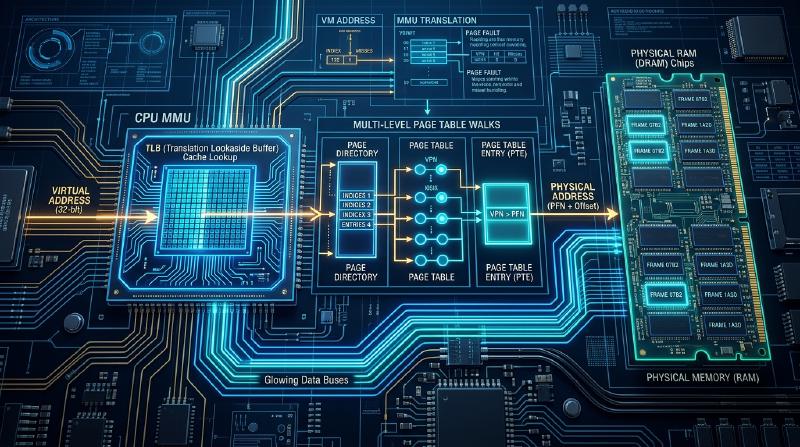
64비트 아키텍처(x86-64/AMD64)에서 가상 주소 공간은 광활합니다. 현재 주류인 ‘48비트 가상 주소 공간’에서는 하드웨어 MMU가 4단계의 페이지 테이블을 스캔합니다.
2.1 48bit/57bit 가상 주소 공간과 정규형(Canonical Form) 제약
64비트 레지스터는 16엑사바이트라는 광활한 주소 공간을 표현할 수 있지만, 현재의 하드웨어 구현에서는 비용과 복잡성 문제로 인해 전체를 다 사용하지는 않습니다. 48비트 구현에서는 가상 주소의 비트 47부터 63까지 모두 같은 값(부호 확장)이어야 한다는 제약이 있습니다. 이 제약을 만족하는 주소를 ‘정규형 주소(Canonical Address)‘라고 부릅니다.
이로 인해 메모리 공간은 중앙에 거대한 미사용 영역(Non-canonical 홀)을 갖는 구조가 되며, 하반부의 사용자 공간(0x0000000000000000 ~ 0x00007FFFFFFFFFFF)과 상반부의 커널 공간(0xFFFF800000000000 ~ 0xFFFFFFFFFFFFFFFF)으로 깔끔하게 양분됩니다. 잘못된 포인터(예를 들어 최상위 비트에 메타데이터를 끼워넣은 포인터)를 역참조하면, MMU는 Canonical 위반으로 판단하여 즉시 일반 보호 예외(#GP)를 발생시킵니다. 최근 Intel Ice Lake 이후의 프로세서에서는 이를 더욱 확장한 57비트 가상 공간(5단계 페이지 테이블)도 지원되기 시작하여, 페타바이트급 메모리를 다루는 클라우드 인프라의 기반이 되고 있습니다.
2.2 4단계 페이지 테이블의 계층 구조(PML4, PDPT, PD, PT) 상세
48비트 가상 주소를 물리 주소로 변환하기 위해 x86-64는 4계층의 페이지 테이블(Radix Tree 형태의 데이터 구조)을 사용합니다. 각 테이블은 4KB 크기를 가지며, 512개의 64비트(8바이트) 항목을 저장합니다(2^9 = 512). 가상 주소는 다음과 같이 분할되어 각 계층의 인덱스로 기능합니다.
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - 최상위. CR3 레지스터가 물리 베이스 주소를 가리킴.
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - 2MB HugePage의 경우 이곳이 종단점이 됨.
- Bits 12-20 (9 bits): PT (Page Table) Index - 일반적인 4KB 페이지에서의 최종 테이블.
- Bits 0-11 (12 bits): Page Offset - 4KB(4096바이트) 페이지 내의 오프셋.
2.3 페이지 테이블 항목(PTE)의 64비트 레이아웃 완전 표
페이지 테이블의 각 64비트 항목은 단순한 물리 주소 포인터가 아니라, 강력한 접근 제어와 캐시 제어를 담당하는 메타데이터의 집합체입니다. 아래에 x86-64 PTE의 완전한 비트 레이아웃과 그 상세한 기능을 나타냅니다.
- Bit 0 [P] Present: 1이면 물리 메모리 상에 존재. 0이면 스왑 아웃되었거나 할당되지 않음. 0일 때 접근하면 페이지 폴트(#PF) 예외 발생.
- Bit 1 [R/W] Read/Write: 0이면 Read-Only(쓰기 불가), 1이면 Read/Write 가능. CoW(Copy-on-Write) 구현에 있어 매우 중요한 역할을 수행.
- Bit 2 [U/S] User/Supervisor: 0이면 특권 모드(커널)만 접근 가능. 1이면 사용자 모드(Ring 3)에서도 접근 가능. KPTI나 SMAP 등에서 엄격하게 관리됨.
- Bit 3 [PWT] Page-level Write-Through: 1이면 이 페이지에 대한 캐시 쓰기 정책을 Write-Through로 설정. 0이면 Write-Back.
- Bit 4 [PCD] Page-level Cache Disable: 1이면 이 페이지의 캐시를 무효화(Uncacheable). 메모리 맵드 I/O(MMIO) 등으로 PCIe 장치의 레지스터에 직접 접근할 때 사용.
- Bit 5 [A] Accessed: MMU가 이 페이지에 접근(Read 또는 Write)했을 때 하드웨어에 의해 자동으로 1로 설정됨. OS의 LRU 알고리즘(페이지 회수)에서 참조 비트로 사용됨.
- Bit 6 [D] Dirty: MMU가 이 페이지에 ‘쓰기’를 수행했을 때 하드웨어에 의해 자동으로 1로 설정됨. 디스크로 다시 써야 할지(스왑 아웃) OS가 판단하기 위해 필수적인 비트.
- Bit 7 [PAT] Page Attribute Table: PWT/PCD와 조합하여 더 상세 메모리 캐시 타입(WC: Write-Combining 등)을 지정하기 위한 인덱스. 그래픽 메모리(VRAM)로의 고속 대량 전송 등에 이용.
- Bit 8 [G] Global: 1이면 CR3 레지스터가 전환되어도(컨텍스트 스위치가 발생해도) TLB에서 이 항목을 플러시하지 않음. 주로 커널 공간의 페이지에서 사용되며, 시스템 콜 시의 TLB 미스 페널티를 회피함.
- Bits 9-11 [AVL] Available: OS(커널)가 자유롭게 사용할 수 있는 3비트. Linux에서는 스왑 엔트리의 메타데이터나 NUMA 노드 식별 등에 활용되기도 함.
- Bits 12-51 [PFN] Physical Frame Number: 변환 대상 물리 페이지의 베이스 주소(물리 프레임 번호). 4KB 정렬되어 있기 때문에 하위 12비트는 항상 0으로 취급됨.
- Bits 52-62 [AVL/PKU] Available/Ignored: CPU 세대나 기능 확장(Intel MPK: Memory Protection Keys 등)에 의해 예약되거나 OS에서 사용할 수 있는 영역.
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: 1이면 이 페이지 상의 데이터를 ‘명령어로서 실행 불가’로 만듦. 버퍼 오버플로우 등에 의한 데이터 영역으로의 코드 인젝션 공격을 방지하는 강력한 보안 메커니즘(DEP: Data Execution Prevention).
이처럼 PTE의 각 비트는 OS의 메모리 관리 알고리즘(특히 스왑 처리나 보안 보호, I/O 제어)과 밀접하게 결합되어 있으며, 하드웨어와 소프트웨어의 경계선 상에 있는 인터페이스로서 매우 세련되게 설계되어 있습니다.
제3장: MMU에 의한 하드웨어 페이지 테이블 워크와 지연의 장벽
가상 주소에서 물리 주소로의 변환은 CPU 코어 내부에 존재하는 **MMU(Memory Management Unit)**라는 전용 하드웨어 회로에 의해 수행됩니다.
3.1 CR3 레지스터를 기점으로 하는 테이블 워크 메커니즘
프로세서의 컨트롤 레지스터 CR3에는 현재 실행 중인 프로세스의 최상위 페이지 테이블(PML4)의 물리 주소가 저장되어 있습니다. Linux 등의 OS는 컨텍스트 스위치를 통해 다른 프로세스에게 CPU 실행 권한을 넘겨줄 때, 이 CR3 레지스터를 새로운 프로세스의 PML4 주소로 덮어씁니다. 이를 통해 프로세스의 메모리 공간 전체가 순식간에 전환됩니다.
아래에 개념적인 흐름을 보여줍니다.
- 가상 주소의 최상위 인덱스를 추출하여, CR3가 가리키는 PML4 테이블의 해당 항목을 읽는다.
- PML4 항목의 PFN을 추출하여, 다음 PDPT 테이블의 물리 주소를 계산한다.
- PDPT 테이블의 해당 항목을 읽는다.
- 마찬가지로 PD 테이블, PT 테이블 순으로 따라가서, 최종적인 4KB 물리 페이지의 베이스 주소를 얻는다.
- 마지막으로 12비트의 페이지 오프셋을 더하여 완전한 물리 주소를 구성한다.
3.2 메모리 버스 접근과 지연(Latency)이라는 가장 큰 장벽
이 4단계 페이지 테이블 워크의 가장 큰 약점은 ‘메모리 접근 레이턴시‘입니다. 가상 주소 1개를 변환하는 것만으로 최악의 경우 물리 메모리에 대해 4번의 접근(PML4, PDPT, PD, PT 읽기)이 발생합니다. 현대 DRAM의 접근 레이턴시는 약 50~100나노초입니다. 만약 4번의 메모리 접근이 모두 CPU 캐시(L1/L2/L3)를 미스하고 DRAM까지 도달할 경우, 그것만으로 수백 나노초의 스톨(Stall)이 발생합니다. CPU의 클럭 사이클이 0.3나노초(3GHz) 정도임을 고려하면 이는 수천 사이클에 해당하는 치명적인 지연이며, CPU 파이프라인은 완전히 고갈되어 멈춰버리게 됩니다. 이토록 심각한 성능 장벽을 극복하기 위해 설계된 것이 다음에 설명할 TLB입니다.
제4장: 멀티코어 환경의 TLB 아키텍처와 슛다운의 고뇌
TLB(Translation Lookaside Buffer)는 MMU 내에 내장된 ‘가상 주소에서 물리 주소로의 변환 결과 캐시’이며, 초고속 SRAM(또는 CAM: Content Addressable Memory)으로 구성되어 있습니다.
4.1 TLB의 계층 구조와 PCID(Process-Context Identifier)를 통한 최적화
최신 CPU에서는 TLB 역시 L1/L2 계층 구조를 갖습니다. L1 D-TLB(데이터용)나 L1 I-TLB(명령어용)는 매우 작은 용량(수십 개의 항목)이지만 1사이클 만에 응답합니다. L2 TLB는 수백에서 수천 개의 항목을 가지며, 수 사이클 만에 응답합니다. TLB에 항목이 존재하지 않을 경우(TLB 미스), 앞서 설명한 하드웨어 테이블 워크(페이지 워크)가 발생합니다. 이를 지원하기 위해 페이지 워크 전용 캐시(PWC: Page Walk Cache)도 구현되어 있습니다.
프로세스가 전환되면 가상 주소의 의미가 달라지기 때문에, 기존(초기 x86)에는 CR3를 덮어쓸 때 TLB를 모두 지웠습니다(Flush). 하지만 이렇게 하면 컨텍스트 스위치 직후에 TLB 미스가 다발하여 성능이 현저하게 떨어집니다. 이를 해결하기 위해 도입된 것이 **PCID(Process-Context Identifier)**라는 기술입니다(ARM 아키텍처에서는 ASID라고 부릅니다). TLB 항목에 프로세스를 고유하게 식별하는 12비트의 ID(태그)를 부여함으로써, 컨텍스트 스위치 후에도 이전 프로세스의 TLB 항목을 계속 유지하는 것이 가능해져, 웹 서버나 데이터베이스와 같은 멀티프로세스 환경에서의 성능이 비약적으로 향상되었습니다.
4.2 TLB 슛다운(TLB Shootdown)의 프로세서 간 인터럽트(IPI) 프로토콜
멀티코어 환경에서 가상 메모리 시스템은 매우 까다로운 동기화 문제에 직면합니다. 예를 들어 코어 0(CPU0)에서 실행 중인 프로세스가 특정 메모리 영역을 munmap()으로 해제하고, 페이지 테이블의 PTE를 무효화(Present = 0)했다고 가정해 보겠습니다. 그러나 코어 1(CPU1)의 로컬 TLB에는 아직 해당 가상 주소에서 물리 주소로의 ‘오래된 변환 정보(Stale TLB Entry)‘가 캐시로 남아있을 수 있습니다.
이대로라면 코어 1이 이미 해제된 메모리에 접근하게 되어, 다른 프로세스에 할당된 데이터를 파괴하거나 기밀 정보를 읽어버리는 심각한 보안 취약점으로 이어집니다. 이를 방지하기 위해 OS는 코어 1의 TLB에서 해당 항목을 강제로 삭제하도록 해야 합니다. 이것이 **TLB 슛다운(TLB Shootdown)**입니다.
TLB 슛다운은 다음과 같은 단계(IPI 프로토콜)로 엄격하게 실행됩니다.
- 개시자(코어 0): 페이지 테이블을 업데이트(PTE를 클리어)한 후, 메모리 배리어(
mfence등)를 발행하고 대상이 되는 다른 코어(코어 1)의 로컬 APIC(Advanced Programmable Interrupt Controller)로 **IPI(Inter-Processor Interrupt: 프로세서 간 인터럽트)**를 전송한다. - 대기(비지 웨이트): 코어 0은 다른 모든 타겟 코어가 인터럽트 처리를 마칠 때까지 스핀락으로 대기한다.
- 타겟(코어 1): IPI를 수신하면 현재 실행 중인 사용자 코드를 즉시 중단하고 커널의 인터럽트 핸들러(Linux에서는
smp_call_function을 경유하는flush_tlb_func등)로 분기한다. - 플러시 실행: 코어 1은 자신의 로컬 TLB에서 지정된 가상 주소의 항목을 무효화한다(x86에서는
INVLPG명령 사용, 전체 플러시의 경우 CR3를 다시 로드). - 완료 통지: 코어 1은 플러시 완료를 메모리 상의 플래그에 쓰고, 코어 0의 대기 상태를 해제한다. 그 후 중단했던 처리로 복귀(
iret)한다.
성능 병목 현상과 확장성의 한계: TLB 슛다운은 하드웨어의 IPI 발행, 인터럽트의 컨텍스트 스위치, 파이프라인의 플러시, 그리고 여러 코어 간의 스핀락 대기를 동반하므로 수천~수만 사이클을 소비하는 매우 고비용의 작업입니다. 코어 수가 16, 64, 128로 늘어날수록 이 동기화 비용은 지수 함수적으로 증가하며, 클라우드 서버나 HPC에서의 멀티스레드 애플리케이션(특히 메모리 할당/해제를 빈번하게 반복하는 프로그램)에서 심각한 확장성 저해 요인이 되고 있습니다.
제5장: Linux 커널의 페이지 폴트 처리 완벽 추적
프로그램이 페이지 테이블의 Present 비트가 0인 영역이나 권한이 없는 영역(Read-Only에 쓰기를 시도했거나, 사용자 모드에서 커널 영역에 접근하는 등)에 접근하면, MMU는 **페이지 폴트 예외(x86에서는 Exception 14, #PF)**를 발생시킵니다. 여기부터 Linux 커널의 심오한 예외 처리로의 여정이 시작됩니다.
5.1 페이지 폴트의 제어 흐름과 아키텍처 종속 부분의 추적
x86-64의 Linux 커널에서 페이지 폴트가 발생했을 때의 함수 호출 그래프(콜 트레이스)는 다음과 같습니다. 아키텍처에 종속적인 저수준 핸들러에서 아키텍처에 독립적인 범용 메모리 관리 서브시스템으로 제어가 넘어갑니다.
asm_exc_page_fault(어셈블리어: arch/x86/entry/entry_64.S)- CPU가 예외를 감지하면, 하드웨어가
CR2레지스터에 폴트가 발생한 가상 주소를 세팅하고 인터럽트 스택에 레지스터 상태를 대피시킨 뒤 커널의 엔트리 포인트로 점프합니다.
- CPU가 예외를 감지하면, 하드웨어가
exc_page_fault()(C언어: arch/x86/mm/fault.c)- 아키텍처 종속적인 폴트 핸들러입니다. 에러 코드(Read/Write, User/Kernel, PF 등)를 분석하고 인터럽트 컨텍스트 등을 확인합니다.
do_page_fault()/do_user_addr_fault()- 폴트가 발생한 곳이 커널 공간(버그나 vmalloc 영역 등)인지 사용자 공간인지 판별합니다. 사용자 공간일 경우, 대상 프로세스의 메모리 맵(
vm_area_struct의 레드-블랙 트리·VMA 리스트)을 검색하여 해당 주소가 정당한 영역에 속해 있는지(세그멘테이션 폴트가 아닌지) 확인합니다.
- 폴트가 발생한 곳이 커널 공간(버그나 vmalloc 영역 등)인지 사용자 공간인지 판별합니다. 사용자 공간일 경우, 대상 프로세스의 메모리 맵(
handle_mm_fault()(C언어: mm/memory.c)- 여기서부터가 아키텍처에 독립적인 핵심 함수입니다. 페이지 테이블의 각 계층(PGD -> P4D -> PUD -> PMD -> PTE)을 스캔하며, 아직 테이블이 할당되어 있지 않으면 중간 디렉터리를 새로 할당(
pmd_alloc등)하면서 최종적인 PTE의 주소를 특정합니다.
- 여기서부터가 아키텍처에 독립적인 핵심 함수입니다. 페이지 테이블의 각 계층(PGD -> P4D -> PUD -> PMD -> PTE)을 스캔하며, 아직 테이블이 할당되어 있지 않으면 중간 디렉터리를 새로 할당(
5.2 메모리 할당의 진수: handle_mm_fault에서의 분기
handle_mm_fault()는 특정한 PTE의 상태(PTE가 비어있는지, 스왑 아웃되었는지, 권한 에러인지)에 따라 실제 페이지 할당 처리를 분기시킵니다.
do_anonymous_page()(요구 페이징의 극치): PTE가 완전히 비어(0) 있을 때 호출됩니다. 힙(malloc의 이면에 있는brk나mmap)이나 스택의 확장 등 파일과 연결되지 않은 익명 페이지(Anonymous Page)에 대한 최초 접근입니다. 커널은 여기서 비로소 물리 메모리(프레임)를 버디 시스템(Buddy System)에서 확보하고, 0으로 초기화한 뒤 PTE에 매핑합니다. 이를 통해 사용되지 않는 메모리를 절약합니다.do_fault()/__do_fault()(파일 백 페이징):mmap된 파일 등의 최초 접근 시에 호출됩니다. 페이지 캐시에서 파일 데이터를 읽어 들이거나, 파일 시스템(ext4나 xfs)의 드라이버를 호출하여 디스크로부터 데이터를 로드하여 페이지 테이블에 매핑합니다.do_swap_page()(스왑 인의 고통): PTE의 Present 비트가 0이지만, 다른 플래그 비트에 스왑 영역의 오프셋 정보가 기록되어 있을 때 호출됩니다. 디스크(스왑 파티션이나 스왑 파일)에서 물리 메모리로 데이터를 다시 로드합니다. 디스크 I/O를 동반하므로 프로세스는 여기서 장시간 Sleep(블록) 상태에 빠집니다.do_wp_page()(Copy-on-Write): 후술할 CoW 처리입니다. Present=1이지만 Write 권한이 없는 페이지에 쓰기를 시도했을 때 호출됩니다.
5.3 Copy-on-Write(CoW)의 물리적 메커니즘과 참조 카운트의 마법
Linux 프로세스 생성의 핵심인 fork() 시스템 콜은 CoW(Copy-on-Write)라는 지연 평가 메커니즘에 의해 매우 빠르게 동작합니다. 부모 프로세스가 수 GB의 메모리를 사용하고 있어도 fork()가 순식간에 완료되는 이면의 물리적 메커니즘을 해설합니다.
- 페이지 테이블 공유:
fork()가 호출되면 커널은 부모 프로세스의 페이지 테이블을 자식 프로세스에 그대로 복사합니다. 그러나 물리 메모리 자체는 전혀 복사하지 않습니다. 부모와 자식의 PTE는 완전히 동일한 물리 메모리(프레임)를 가리킵니다. - Read-Only 비트 강제 설정(Write-Protect):
이때 커널은 공유된 모든 페이지의 PTE
R/W비트를0(Read-Only)으로 강제로 덮어씁니다(원래 쓰기 가능했던 데이터 영역 등도 모두 포함됩니다). - 참조 카운트(Reference Count) 증가:
대상이 되는 물리 페이지를 관리하는 커널 구조체(
struct page의_refcount)를 증가시켜 ‘2개의 프로세스가 참조하고 있는’ 상태로 만듭니다. - 쓰기와 페이지 폴트(do_wp_page 트리거):
부모 또는 자식 중 한쪽이 공유하고 있는 변수나 힙 영역에 쓰기(Write)를 시도하면, 하드웨어 MMU가
R/W=0을 감지하고 즉시 페이지 폴트를 발생시킵니다. - 페이지 복제(Duplication):
페이지 폴트 핸들러에서
do_wp_page()가 호출됩니다. 커널은 VMA 플래그를 확인하여 ‘이것은 잘못된 접근이 아니라 정당한 CoW에 의한 폴트’라고 판단합니다. 새로운 물리 페이지를 버디 시스템에서 하나 확보하고, 원본 페이지의 데이터를 통째로 복사(copy_page)합니다. - PTE 업데이트 및 참조 카운트 감소:
쓰기를 수행한 프로세스의 PTE가 새로운 물리 페이지를 가리키도록 변경하고,
R/W비트를1(Read/Write 가능)로 설정합니다. 그리고 원본 물리 페이지의 참조 카운트를 감소시킵니다. 만약 참조 카운트가 1이 되면, 다른 한쪽의 프로세스가 해당 페이지를 독점하고 있는 상태가 되므로, 다음에 그 프로세스가 폴트를 일으켰을 때는 메모리 복사를 하지 않고 단순히 R/W 비트를 1로 되돌리기만 하면 됩니다(페이지 재사용).
이처럼 CoW는 MMU의 하드웨어 보호 기능(Read-Only 트랩)과 커널의 소프트웨어 제어가 훌륭하게 융합된 예술적인 알고리즘이며, 메모리의 극적인 절약과 프로세스의 빠른 시작을 실현하고 있습니다.
제6장: 메모리 회수(Reclaim) 알고리즘의 심연과 OOM Killer의 단죄
물리 메모리는 유한합니다. 시스템이 장기간 가동되어 파일 캐시나 프로세스 힙이 메모리를 다 써버리면, OS는 새로 메모리를 확보하기 위해 기존의 메모리 영역을 해제·회수(Reclaim)해야 합니다. 이 메모리 회수 서브시스템은 Linux 커널 중에서도 가장 복잡하고 난해한 영역 중 하나입니다.
6.1 액티브/인액티브 LRU 리스트와 유사 LRU 알고리즘
Linux 커널은 물리 페이지를 관리하고 추적하기 위해 LRU(Least Recently Used) 리스트를 사용합니다. 그러나 모든 페이지를 엄격한 LRU로 관리하는 것은 락(Lock) 경합이나 스캔 비용 측면에서 불가능합니다. 따라서 ‘Active 리스트’와 ‘Inactive 리스트’라는 2개의 큐(리스트)를 이용한 유사 LRU 알고리즘(Clock 알고리즘의 파생)을 채택하고 있습니다.
- Active 리스트: 최근 빈번하게 접근된 ‘핫(Hot)‘한 페이지들의 집합. 이들은 회수 대상이 되지 않습니다.
- Inactive 리스트: 한동안 접근되지 않은 ‘콜드(Cold)‘한 페이지들의 집합. 끝(tail)에 있는 페이지부터 순서대로 회수 후보가 됩니다.
커널은 페이지에 접근이 발생했다는 사실을 어떻게 알 수 있을까요? 여기서 제2장에서 설명했던 PTE의 **Accessed 비트(A 비트)**가 활약합니다. 커널(kswapd)은 페이지 테이블을 주기적으로 스캔하여 PTE에서 A 비트를 읽어내고, 소프트웨어 측에 접근 기록을 남긴 뒤 A 비트를 0으로 클리어합니다. A 비트가 다시 하드웨어에 의해 1로 세팅되면 그 페이지는 Active 리스트에 머무르거나 Inactive에서 승격됩니다. 세팅되지 않았다면 서서히 Inactive 리스트의 끝으로 강등되어 갑니다.
6.2 kswapd 데몬과 다이렉트 리클레임(Direct Reclaim)의 공포
메모리의 여유 용량(Free Pages)이 특정 임계값(워터마크: low) 밑으로 떨어지면 커널의 백그라운드 스레드인 kswapd(각 NUMA 노드마다 존재함)가 깨어납니다.
kswapd는 Inactive 리스트의 끝에서 페이지를 꺼냅니다.
- 그것이 클린한 파일 캐시(변경되지 않은 파일 데이터)라면 단순히 파기(Drop)하여 메모리를 비웁니다.
- 그것이 더티한(변경이 발생한) 파일 캐시라면 디스크로 다시 쓰고(Writeback) 파기합니다.
- 그것이 익명 페이지(프로세스 힙이나 스택)라면 스왑 영역으로 기록합니다(스왑 아웃).
여유 용량이
high워터마크에 도달할 때까지 이 백그라운드 작업을 계속합니다.
그러나 애플리케이션의 메모리 할당 속도(메모리 압박)가 너무 높아서 kswapd의 회수 속도가 따라잡지 못하고 여유 메모리가 극한의 임계값(min 워터마크) 미만으로 떨어지면 **다이렉트 리클레임(Direct Reclaim)**이 발동합니다.
다이렉트 리클레임이란 메모리를 요구한 프로세스(애플리케이션 자신)의 컨텍스트에서 직접 메모리 회수 처리(캐시 파기나 스왑 아웃)를 동기적으로 실행시키는 메커니즘입니다. 다이렉트 리클레임에 들어가면 애플리케이션의 실행(malloc이나 페이지 폴트 완료)이 완전히 정지(스톨)되므로, 수백 밀리초에서 수 초에 달하는 심각한 성능 저하(레이턴시 스파이크)의 직접적인 원인이 됩니다. 데이터베이스나 실시간 시스템에서는 이를 피하기 위한 튜닝(vm.swappiness나 워터마크 조정)이 필수입니다.
6.3 OOM Killer의 점수 계산식과 프로세스의 단죄
다이렉트 리클레임을 수행해도 스왑 영역까지 고갈되고 캐시도 다 지워져 도저히 메모리를 확보할 수 없는 경우, Linux 커널은 최후의 수단으로 OOM(Out Of Memory) Killer를 소환합니다.
OOM Killer는 시스템 전체가 메모리 부족으로 패닉(커널 크래시나 완전한 프리즈)에 빠지는 것을 막기 위해, 메모리를 대량으로 소비하고 있는 프로세스를 ‘강제 종료(SIGKILL)‘시켜 메모리를 되찾습니다. 희생자를 결정하는 냉혹한 알고리즘이 존재합니다.
어떤 프로세스를 죽일 것인지의 결정은 **oom_score**라는 평가 값에 기반하여 이루어집니다(커널의 mm/oom_kill.c에 있는 oom_badness() 함수에서 계산됩니다).
OOM Score의 기본 계산 로직(개념):
- 기본 점수: 프로세스가 현재 사용하고 있는 메모리 양(RSS: Resident Set Size + 페이지 테이블 양 + 스왑 사용량)이 전체 메모리에서 차지하는 비율. 최대 1000포인트. 즉, 많은 메모리를 소비하고 있는 프로세스(메모리 릭이 발생한 프로세스 등)일수록 죽기 쉽습니다.
- 루트 권한 페널티 완화: root 사용자 권한으로 동작 중인 프로세스(시스템 핵심 데몬 등)는 시스템 유지에 필수적일 가능성이 높기 때문에 점수가 약간 할인(마이너스)되어 덜 죽게 됩니다.
- 사용자 조정 값(OOM Score Adj):
/proc/[pid]/oom_score_adj(-1000 ~ +1000) 값이 더해집니다. 시스템 관리자는 이를 사용하여 OOM Killer의 동작을 제어할 수 있습니다. 이 값이 -1000으로 설정된 프로세스(예: sshd, kubelet, 데이터베이스 마스터 프로세스 등)는 ‘OOM Killer의 대상 제외(무적)’ 상태가 됩니다.
OOM Killer가 발동했을 때는 커널 로그(dmesg 또는 /var/log/messages)에 ‘Out of memory: Killed process 1234 (java)‘와 같은 메시지와 함께 당시의 프로세스 목록, 각 점수, 메모리 상태의 상세한 덤프가 출력됩니다. 시스템 관리자는 이 로그와 점수 계산 메커니즘을 이해함으로써 예기치 않은 프로세스 종료 원인을 규명하고 적절한 리소스 제한(cgroups나 ulimit)을 설정할 수 있습니다.
제7장: 최신 초고속 메모리 기법과 하드웨어 보안
7.1 2MB/1GB HugePages의 위력과 THP의 공과
제3장과 제4장에서 언급한 TLB 미스와 테이블 워크의 지연을 해결하는 강력한 수단이 ‘HugePage‘입니다. 일반적인 4KB 페이지 대신 2MB(Page Directory 단계에서 물리 주소를 직접 가리킴, 즉 PT 계층을 건너뜀)나 1GB(PDPT 단계에서 직접 가리킴)의 거대한 페이지를 사용합니다.
이를 통해 하나의 TLB 항목으로 광활한 메모리 영역(4KB의 512배 또는 26만 배)을 커버할 수 있으므로 TLB 미스가 극적으로 감소합니다. 대량의 메모리에 랜덤 접근하는 데이터베이스(Oracle, PostgreSQL)나 가상화 환경(KVM/QEMU)에서는 HugePage의 사용이 성능 튜닝의 필수 항목이 되었습니다.
Linux의 **THP(Transparent Huge Pages)**는 애플리케이션이 의식하지 않아도 커널의 백그라운드 스레드(khugepaged)가 연속된 4KB 페이지를 자동으로 2MB의 HugePage로 통합(조각 모음)해 주는 메커니즘입니다. 하지만 메모리 단편화가 진행된 환경에서는 이 통합 처리(메모리 컴팩션) 자체가 CPU를 크게 소비하고 레이턴시 스파이크를 일으키기 때문에, Redis 등의 인메모리 KVS에서는 THP를 비활성화(never 또는 madvise)할 것이 권장됩니다.
7.2 커널 페이지 테이블 분리(KPTI)와 Meltdown 대책의 대가
2018년에 발각된 CPU 추측 실행(Speculative Execution) 취약점인 ‘Meltdown (CVE-2017-5754)‘는 사용자 프로세스에서 커널 메모리 공간(캐시)을 부정하게 읽을 수 있다는, 하드웨어의 근간을 뒤흔드는 치명적인 결함이었습니다.
이에 대한 대책으로 OS 측에 도입된 것이 KPTI(Kernel Page-Table Isolation)(초기에는 KAISER로 불림)입니다.
기존에는 컨텍스트 스위치의 오버헤드를 줄이기 위해 사용자 공간 실행 시에도 페이지 테이블 상반부에는 커널 영역 전체가 매핑되어 있었습니다(PTE의 U/S 비트로 특권 체크를 하여 접근이 거부된다는 전제). 하지만 추측 실행은 이 특권 체크를 빠져나가 버렸습니다.
KPTI 도입 후에는 사용자 실행 시 커널의 대부분을 매핑하지 않는 ‘최소한의 섀도우 페이지 테이블(User PGD)‘을 사용합니다. 시스템 콜이나 인터럽트로 커널 공간에 진입할 때 반드시 CR3 레지스터를 전환하여 완전한 커널 페이지 테이블(Kernel PGD)로 다시 로드해야 합니다.
이로 인해 보안은 완벽하게 보장되었으나 시스템 콜이나 인터럽트마다 비용이 높은 CR3 전환(및 PCID/TLB 플러시 관리)이 발생하기 때문에, I/O 집약적인 애플리케이션(Syscall을 많이 사용하는 웹 서버나 DB)에서는 수%~십수%에 달하는 무시할 수 없는 성능 오버헤드를 가져왔습니다.
7.3 Direct I/O와 제로 카피 기술의 진화
파일 I/O를 최적화하기 위해 OS는 가상 메모 메커니즘을 극한까지 응용합니다.
mmap() 시스템 콜을 사용하면 파일 내용을 직접 가상 주소 공간에 매핑합니다. 접근하면 페이지 폴트가 발생하여 페이지 캐시에 파일 데이터가 읽혀지며, 사용자 공간에서 포인터로 직접 접근할 수 있게 됩니다.
나아가 네트워크 송수신이나 스토리지 I/O에서 커널 공간(페이지 캐시)과 사용자 공간 버퍼 사이의 CPU에 의한 데이터 복사(컨텍스트 스위치에 수반되는 복사)를 생략하기 위해 제로 카피(Zero-copy) 기술이 활용되고 있습니다. sendfile() 시스템 콜이나 최신 io_uring, AF_XDP에서는 NIC나 NVMe 드라이브의 DMA(Direct Memory Access) 컨트롤러와 연계하여 페이지 테이블의 PTE를 조작함으로써 커널 페이지를 사용자 공간에 직접 ‘교체(리맵)‘하는 방식으로 메모리 복사 오버헤드를 완전히 제로로 만들고 있습니다. 여기서도 근본적인 메커니즘으로 페이지 테이블의 정교한 조작이 수행되고 있습니다.
맺음말
가상 메모리와 페이징 메커니즘은 OS 커널과 CPU(하드웨어)가 만들어내는 매우 고도의 교향곡입니다. 페이지 테이블의 1비트 플래그 설정, TLB 슛다운을 둘러싼 스핀락의 고뇌, CoW 참조 카운트에 의한 메모리 마법, 그리고 OOM Killer의 냉혹한 휴리스틱에 이르기까지, 그 심층에는 ‘제한된 물리 리소스를 어떻게 안전하고 빠르게 추상화하여 프로세스에 무한한 환상을 줄 것인가’라는 컴퓨터 과학의 지혜가 담겨 있습니다.
저수준 메커니즘을 이해하는 것은 C/C++나 Rust 같은 시스템 프로그래밍 언어에서의 최적화(캐시 라인을 의식한 데이터 구조 설계나 mmap의 효과적인 이용)뿐만 아니라, Go나 Java 같은 고수준 언어에서의 가비지 컬렉션(GC) 정지 시간(STW)이나 메모리 할당자(jemalloc이나 tcmalloc)의 동작을 깊이 이해하는 데에도 필수적입니다. 시스템의 ‘마술’ 베일을 벗기고 하드웨어와 커널의 고동을 직접 느낌으로써 더 세련되고 확장성 있는 소프트웨어를 설계할 수 있는 뛰어난 아키텍트로의 길이 열릴 것입니다.