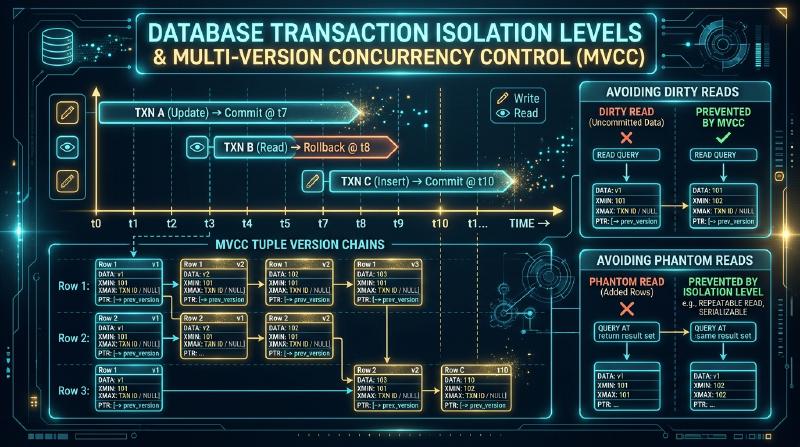
데이터베이스의 트랜잭션 격리 수준과 MVCC: ACID의 현실과 다중 버전 동시성 제어
현대 소프트웨어 아키텍처에서 관계형 데이터베이스 관리 시스템(RDBMS)은 여전히 데이터 영속화의 핵심입니다. 그 중핵을 이루는 것이 ‘트랜잭션’이라는 개념이며, 특히 ACID 특성(Atomicity, Consistency, Isolation, Durability)은 견고한 시스템을 구축하기 위한 기초 이론으로 널리 알려져 있습니다. 하지만 ACID 특성 중에서도 ‘Isolation(격리성)‘은 이론과 실제 사이에 가장 큰 괴리가 존재하는 영역입니다.
본고에서는 데이터베이스 트랜잭션 격리 수준의 역사적 배경부터, ANSI SQL-92 표준의 한계, 그리고 현대 데이터베이스 엔진이 채택하고 있는 Multi-Version Concurrency Control(MVCC: 다중 버전 동시성 제어)의 내부 구조에 이르기까지, 극히 상세하고 학술적이며 실천적인 관점에서 깊이 있게 파헤칩니다. 특히, PostgreSQL과 MySQL(InnoDB)이라는 양대 오픈소스 RDBMS의 MVCC 구현의 결정적 차이를 해부하고, 분산 데이터베이스의 최전선인 직렬화 가능 스냅샷 격리(SSI)까지 망라하는, 총 12,000자가 넘는 초대작으로 전해드립니다.
제1장: ACID 특성의 신화와 동시 처리의 딜레마
1.1 직렬화 가능성(Serializability)의 이상
트랜잭션의 Isolation(격리성)이 지향하는 궁극적인 이상형은 ‘직렬화 가능성(Serializability)‘입니다. 이는 여러 트랜잭션이 동시에 병렬로 실행되더라도, 그 실행 결과가 ‘트랜잭션을 어떤 순서로든 하나씩 직렬(시리얼)로 실행했을 때의 결과와 동등해지는’ 성질을 말합니다.
시스템 상에서 트랜잭션 $T_1$과 $T_2$가 동시에 실행될 때, 동시 실행으로 인한 인터리빙(조작의 교차)이 어떻게 발생하든 간에, 최종적인 데이터베이스 상태가 ‘$T_1 \rightarrow T_2$’ 또는 ‘$T_2 \rightarrow T_1$’ 순서로 실행한 결과와 완전히 일치한다면 그 스케줄은 직렬화 가능하다고 정의됩니다. 이 직렬화 가능성이 보장된다면 애플리케이션 개발자는 동시 처리로 인한 데이터 불일치(레이스 컨디션이나 부적절한 덮어쓰기 등)를 전혀 의식하지 않고 비즈니스 로직 구축에 전념할 수 있습니다.
1.2 잠금에 의한 직렬화의 성능 붕괴
초기 데이터베이스 시스템에서는 이 직렬화 가능성을 보장하기 위해 ‘2단계 잠금(2PL: Two-Phase Locking)‘이라 불리는 엄격한 잠금 매커니즘이 도입되었습니다. 2PL에서 트랜잭션은 데이터를 읽고 쓰기 전에 반드시 잠금(공유 잠금 또는 배타 잠금)을 획득하고(1단계: Growing Phase), 트랜잭션 종료 시(커밋 또는 롤백 시)에 모든 잠금을 해제합니다(2단계: Shrinking Phase).
하지만 이 엄격한 잠금 매커니즘에는 치명적인 결함이 있었습니다. 그것은 바로 ‘성능의 극단적인 저하’입니다.
- 읽기 작업이 쓰기 작업을 차단한다.
- 쓰기 작업이 읽기 작업을 차단한다.
- 잠금 경합으로 인한 대기 시간 증가와 데드락의 빈발.
트래픽이 증가하고 다수의 사용자가 동시에 데이터베이스에 접근하게 되면서, 2PL에 의한 완전한 직렬화는 시스템의 병목이 되었고 처리량은 급격히 감소했습니다. 시스템은 ‘데이터의 정합성’과 ‘동시 처리 성능(처리량)‘이라는 트레이드오프의 딜레마에 직면하게 됩니다.
1.3 동시성 제어의 역사와 타협
이 딜레마를 해결하기 위해 데이터베이스 공학 연구자들은 ‘격리 수준(Isolation Level)‘이라는 개념을 도입했습니다. 이는 완전한 직렬화 가능성을 일부 완화하여 특정한 데이터 불일치(이상 현상: Anomaly)의 발생을 허용하는 대신, 동시 처리 성능을 향상시키겠다는 ‘타협의 산물’입니다. 애플리케이션의 요구사항에 맞춰 정합성과 성능의 균형을 선택할 수 있게 한 것입니다.
제2장: ANSI SQL-92 표준의 격리 수준과 그에 대한 비판
2.1 ANSI SQL-92 표준에 의한 격리 수준 정의
1992년에 제정된 SQL 표준 규격인 ‘SQL-92’에서는 동시 처리로 인해 발생할 수 있는 3가지 대표적인 이상 현상(Phenomena)을 바탕으로 4가지 격리 수준을 정의했습니다.
정의된 3가지 이상 현상(Phenomena)
- Dirty Read (더티 리드 / 오염된 읽기): 트랜잭션 $T_1$이 데이터를 갱신하고 아직 커밋하지 않은 상태에서 다른 트랜잭션 $T_2$가 그 미커밋 데이터를 읽어버리는 현상. $T_1$이 롤백될 경우 $T_2$는 존재하지 않는 환상의 데이터를 읽은 셈이 됩니다.
- Non-repeatable Read (논리피터블 리드 / 반복 불가능한 읽기): 트랜잭션 $T_1$이 같은 행을 2번 읽는 사이에 다른 트랜잭션 $T_2$가 그 행을 갱신하고 커밋해버리는 현상. $T_1$의 1번째와 2번째 읽기 결과가 달라집니다.
- Phantom Read (팬텀 리드 / 환영 읽기): 트랜잭션 $T_1$이 특정 검색 조건으로 여러 행을 읽는 사이에 다른 트랜잭션 $T_2$가 그 조건에 부합하는 새로운 행을 삽입(또는 삭제)하고 커밋하는 현상. $T_1$이 같은 조건으로 재검색하면 행 수가 늘어나거나 줄어듭니다.
SQL-92에 따른 4가지 격리 수준
SQL-92는 이러한 이상 현상의 발생을 막는 정도에 따라 격리 수준을 정의했습니다.
- Read Uncommitted: 더티 리드를 허용한다.
- Read Committed: 더티 리드는 막지만, 논리피터블 리드와 팬텀 리드는 허용한다.
- Repeatable Read: 더티 리드와 논리피터블 리드는 막지만, 팬텀 리드는 허용한다.
- Serializable: 모든 이상 현상을 막고 완전한 직렬화 가능성을 보장한다.
2.2 Berenson 등의 비판 논문 『A Critique of ANSI SQL Isolation Levels』
SQL-92 표준의 정의는 언뜻 보기에 매우 명확하고 논리적으로 보입니다. 하지만 1995년 Hal Berenson, Jim Gray(튜링상 수상자), Phil Bernstein 등 데이터베이스계의 거장들이 발표한 논문 『A Critique of ANSI SQL Isolation Levels』는 이 ANSI 표준의 정의에 궤멸적인 타격을 입혔습니다.
이 논문에서 지적된 SQL-92 표준의 주요 결함은 다음과 같습니다.
1. 잠금 기반의 암묵적 전제
SQL-92의 정의는 암묵적으로 ‘데이터베이스가 잠금 기반의 동시성 제어(2PL)로 구현되어 있을 것’을 전제로 하고 있었습니다. 하지만 1990년대에는 이미 MVCC(후술)나 기타 낙관적 동시성 제어(OCC)를 채택하는 데이터베이스가 등장하기 시작했으며, 잠금을 전제로 한 이상 현상의 정의는 시대에 뒤떨어지고 있었습니다.
2. 정의의 모호함과 불완전성
SQL-92에서 정의된 3가지 이상 현상(Dirty Read, Non-repeatable Read, Phantom Read)만으로는 동시 처리에서 발생할 수 있는 모든 이상 현상을 망라하지 못했다는 점이 지적되었습니다. 예를 들어, **‘더티 라이트(Dirty Write)’**라는 현상이 있습니다. 이는 미커밋된 트랜잭션이 쓴 데이터를 다른 미커밋 트랜잭션이 덮어써버리는 현상인데, SQL-92 표준에는 더티 라이트에 관한 언급이 없습니다. 모든 격리 수준(Read Uncommitted 포함)은 더티 라이트를 방지해야만 함에도 불구하고(그렇지 않으면 데이터베이스의 내부 정합성이 붕괴됨) 표준 규격은 그 점을 언급하지 않았던 것입니다.
3. 새로운 이상 현상의 발견
논문에서는 SQL-92 표준에 존재하지 않는 새로운 이상 현상이 다수 정의되었습니다. 대표적인 것이 다음 두 가지입니다.
- Lost Update (로스트 업데이트 / 갱신 손실): 두 트랜잭션이 동시에 같은 데이터를 읽고 각각 연산 결과를 다시 쓸 때, 한쪽의 갱신이 다른 쪽의 갱신을 덮어써서 지워버리는 현상.
- Write Skew (쓰기 스큐): 후술할 스냅샷 격리에 특유한 현상.
Berenson 등의 논문은 SQL-92 표준이 격리 수준을 수학적, 엄밀하게 정의하지 못했음을 증명하며 데이터베이스 업계에 큰 충격을 주었습니다. 현재 데이터베이스 이론에서 ANSI SQL-92의 격리 수준 정의는 ‘역사적 배경으로서 배워야 할 것’이자 ‘엄밀한 기술적 정의로서는 불충분한 것’으로 취급되고 있습니다.
제3장: 스냅샷 격리(Snapshot Isolation)와 쓰기 스큐
3.1 Repeatable Read와 스냅샷 격리의 차이
Berenson 등의 논문에서 특히 주목받은 것이 **‘스냅샷 격리(Snapshot Isolation: SI)’**라는 새로운 격리 수준의 제창입니다.
MVCC를 채택하는 많은 데이터베이스(PostgreSQL이나 Oracle 등)에서 ‘Repeatable Read’로 제공되는 격리 수준의 실체는 사실 이 ‘스냅샷 격리’입니다. 스냅샷 격리에서는 각 트랜잭션이 시작 시점에서의 데이터베이스의 일관된 ‘스냅샷(과거의 정지 상태)‘에 대해 읽기를 수행합니다.
- 트랜잭션 시작 시점 이후에 이루어진 다른 트랜잭션에 의한 갱신은 전혀 보이지 않습니다(논리피터블 리드 방지).
- 레코드의 존재 자체를 과거 시점에 고정하므로 다른 트랜잭션에 의한 INSERT도 보이지 않습니다(팬텀 리드 방지).
즉, 스냅샷 격리는 SQL-92가 정의하는 ‘Repeatable Read’의 요건을 충족할 뿐만 아니라, 많은 경우 ‘팬텀 리드’까지 막아버립니다. 그렇다면 스냅샷 격리는 ‘Serializable’과 동등할까요? 정답은 ‘아니오’입니다. 스냅샷 격리에는 **‘쓰기 스큐(Write Skew)’**라는, 직렬화 불가능한 치명적인 이상 현상이 존재하기 때문입니다.
3.2 의사 온콜 당번 문제와 쓰기 스큐(Write Skew)
쓰기 스큐를 이해하기 위한 가장 유명한 예시가 ‘의사 온콜(당번) 시스템’입니다.
【비즈니스 규칙】 병원의 시프트 관리 시스템이 있고, ‘최소한 1명의 의사는 항상 온콜(대기) 상태여야 한다’는 규칙이 있다고 가정합시다.
현재 Alice와 Bob 두 명의 의사가 온콜 상태입니다(on_call = true).
이때 Alice와 Bob이 우연히 동시에 ‘몸이 좋지 않아 온콜에서 빠지고 싶다’고 생각하여 각자의 단말기에서 시프트 변경 트랜잭션을 시작했습니다.
【트랜잭션 흐름(스냅샷 격리 하에서)】
- [Tx1: Alice] 스냅샷을 획득. 현재 온콜 상태인 사람이 Alice와 Bob 두 명임을 확인.
SELECT count(*) FROM doctors WHERE on_call = true;-> 결과: 2 - [Tx2: Bob] 스냅샷을 획득. 마찬가지로 Alice와 Bob 두 명임을 확인.
SELECT count(*) FROM doctors WHERE on_call = true;-> 결과: 2 - [Tx1: Alice] 규칙(온콜은 1명 이상)을 만족한다고 판단하고, 자기 자신을 온콜에서 제외함.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] 마찬가지로 규칙을 만족한다고 판단하고, 자기 자신을 온콜에서 제외함.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] 커밋 성공.
- [Tx2: Bob] 커밋 성공. (Alice와 Bob은 다른 레코드를 갱신하고 있으므로 행 잠금은 경합하지 않음)
【결과】 Tx1과 Tx2가 모두 커밋된 결과, 온콜 상태인 의사가 ‘0명’이 되어버렸습니다. 비즈니스 규칙이 붕괴된 것입니다.
이것이 **쓰기 스큐(Write Skew)**입니다. 직렬화 가능(Serializable)하다면 Tx1과 Tx2 중 어느 하나가 먼저 직렬 실행될 것이므로, 나중에 실행된 트랜잭션은 온콜 인원이 ‘1명’임을 감지하고 자신을 제외하는 조작을 중단(롤백)할 수 있었을 것입니다. 하지만 스냅샷 격리에서는 서로 다른 데이터 행(Alice 행과 Bob 행)을 갱신하고 있기 때문에 충돌이 감지되지 않아 비즈니스 규칙의 불일치를 초래하게 됩니다.
3.3 ReadOnly Anomaly (읽기 전용 이상 현상)
더 나아가 스냅샷 격리에는 ‘읽기 전용 트랜잭션’이 개입함으로써 직렬화 가능성이 무너지는 ReadOnly Anomaly라는 극히 특수한 이상 현상도 존재합니다. 은행 계좌의 예금 잔액과 이자 지급 예시 등에서 나타나는 이 이상 현상은, 갱신 트랜잭션들 사이에서는 경합이 발생하지 않음에도 불구하고 읽기 전용 트랜잭션이 과거의 스냅샷을 봄으로써 ‘논리적으로 있을 수 없는 시간축의 상태’를 읽어버리는 현상입니다. 이러한 이상 현상들의 존재로 인해 스냅샷 격리는 엄밀한 의미의 Serializable과는 구별됩니다.
제4장: MVCC (Multi-Version Concurrency Control)의 동작 원리
지금까지 격리 수준의 이론과 이상 현상에 대해 서술해왔는데, 현대의 데이터베이스는 이들을 어떻게 제어하고 있을까요? 그 핵심 기술이 **MVCC(Multi-Version Concurrency Control: 다중 버전 동시성 제어)**입니다.
4.1 “읽기는 쓰기를 차단하지 않고, 쓰기는 읽기를 차단하지 않는다”
MVCC의 최대 설계 사상이자 잠금 기반 제어(2PL)와 결정적으로 다른 점은 ‘읽기와 쓰기가 서로 차단하지 않는다’는 점에 있습니다. 레코드를 갱신할 때 MVCC 데이터베이스는 기존 레코드를 직접 덮어쓰지(In-place update) 않습니다. 대신 새로운 버전의 레코드(버전・튜플)를 생성하고, 이전 버전의 레코드도 동시에 유지합니다.
데이터베이스 내에는 같은 레코드의 여러 버전(과거부터 현재에 이르는 이력)이 동시에 존재하게 됩니다. 트랜잭션이 데이터를 읽을 때는 자신의 ‘트랜잭션 ID(XID)‘나 ‘시작 시각(타임스탬프)‘을 바탕으로 시스템 내에 존재하는 다수의 버전 중에서 ‘자신이 읽어야 할 올바른 과거의 버전’을 계산하여 읽습니다.
이를 통해 어떤 트랜잭션이 레코드를 고쳐 쓰고 있는 도중이라도 다른 트랜잭션은 ‘고쳐 쓰기 전의 과거 버전’을 읽을 수 있어 잠금으로 인한 대기를 회피할 수 있습니다.
4.2 튜플의 버전 관리 체인과 가시성(Visibility) 규칙
MVCC에서 가장 중요한 알고리즘은 ‘어떤 트랜잭션이 어떤 버전의 데이터를 볼 수 있는가’를 판정하는 **가시성 규칙(Visibility Rule)**입니다.
각 트랜잭션에는 시작 시점에 단조 증가하는 고유한 트랜잭션 ID(XID)가 할당됩니다. 데이터베이스에 저장되는 각 레코드의 버전(튜플)에는 메타데이터로서 다음 정보가 부여됩니다.
- 생성 XID: 이 버전을 INSERT/UPDATE를 통해 생성한 트랜잭션의 ID.
- 삭제 XID: 이 버전을 UPDATE/DELETE를 통해 논리적으로 삭제한(무효화한) 트랜잭션의 ID.
트랜잭션 $T_i$가 데이터 행을 읽을 때, 다음 기본 규칙에 따라 가시성을 판정합니다.
- 커밋되었는가: 생성 XID의 트랜잭션이 이미 커밋되었는가?
- 미래가 아닌가: 생성 XID는 $T_i$가 시작된 시점보다 과거의 트랜잭션인가?
- 삭제되지 않았는가: 삭제 XID가 설정되어 있지 않거나, 삭제 XID의 트랜잭션이 아직 커밋되지 않았거나, $T_i$ 시작 시점보다 미래의 트랜잭션인가?
이러한 조건들을 엄밀하게 평가함으로써 각 트랜잭션에 일관된 스냅샷을 제공합니다.
제5장: PostgreSQL vs MySQL (InnoDB)의 MVCC 구현의 결정적 차이
MVCC의 기본 이념은 같지만, 그 내부 구현은 데이터베이스 제품에 따라 놀라울 정도로 다릅니다. 여기서는 오픈소스계의 양대 산맥을 이루는 PostgreSQL과 MySQL(InnoDB)의 MVCC 아키텍처를 비교 해부합니다.
5.1 PostgreSQL의 MVCC 구현: 힙 내 추가 쓰기와 VACUUM의 필연성
PostgreSQL의 MVCC는 매우 독특하고 직관적인 **‘추가 쓰기형(Append-only) 아키텍처’**를 채택하고 있습니다.
5.1.1 xmin과 xmax에 의한 비트 판정 로직
PostgreSQL 테이블의 실체인 데이터 파일(힙) 내에는 각 행(튜플)의 헤더에 xmin과 xmax라는 두 개의 트랜잭션 ID가 기록되어 있습니다.
xmin(Transaction ID of Insert): 이 튜플을 생성한 트랜잭션의 XID.xmax(Transaction ID of Delete): 이 튜플을 삭제(또는 갱신으로 인한 구버전의 논리적 삭제)한 트랜잭션의 XID.
【UPDATE 조작의 동작】
PostgreSQL에서 UPDATE는 논리적으로 DELETE와 INSERT의 조합으로 처리됩니다.
- 이전 튜플의
xmax에 현재 트랜잭션 XID를 기록한다. (논리적 삭제) - 힙의 여유 공간에 완전히 새로운 튜플을 생성하여 새로운 데이터를 기록하고,
xmin에 현재 트랜잭션 XID를 설정한다. (신규 추가)
즉, 신구 양쪽의 튜플이 동일한 테이블 데이터 파일(힙) 내에 혼재되어 저장됩니다.
5.1.2 거대한 이점과 치명적인 과제: VACUUM의 존재
이 아키텍처의 최대 이점은 롤백이 극히 빠르다는 것입니다. 트랜잭션이 중단(Abort)된 경우 추가한 튜플을 ‘미커밋’으로 취급하기만 하면 되므로 데이터를 되돌리는 처리가 필요 없습니다.
하지만 치명적인 과제로 **‘불필요한 튜플(Dead Tuples)의 비대화’**가 있습니다.
UPDATE나 DELETE를 반복하면, 아무도 참조하지 않게 된 이전 버전의 튜플(xmax가 커밋 완료된 과거의 트랜잭션 ID로 되어 있는 튜플)이 힙 내에 무한히 축적됩니다. 이를 방치하면 테이블의 물리적 크기가 폭발적으로 팽창하여 순차 스캔(Sequential Scan)의 성능이 궤멸적으로 저하됩니다.
이 불필요한 튜플을 물리적으로 삭제하고 빈 공간을 재사용 가능하게 만들기 위한 시스템 프로세스가 VACUUM(그리고 자동으로 실행되는 autovacuum 데몬)입니다. PostgreSQL 운영에서 VACUUM 튜닝이 극히 중요하다고 여겨지는 이유는 바로 이 MVCC 아키텍처의 근간에 기인합니다.
5.2 MySQL InnoDB의 MVCC 구현: 인플레이스 갱신과 Undo 로그의 동적 재구축
반면 MySQL의 기본 스토리지 엔진인 InnoDB는 Oracle Database에 가까운 **‘인플레이스 갱신(In-place update)과 Undo 로그(롤백 세그먼트)’**에 의한 아키텍처를 채택하고 있습니다.
5.2.1 클러스터형 인덱스와 인플레이스 갱신
InnoDB의 테이블은 기본 키를 기반으로 한 B+Tree(클러스터형 인덱스)로 구성되어 있습니다.
InnoDB에서 UPDATE가 실행되면 PostgreSQL처럼 새로운 행을 추가하는 것이 아니라, B+Tree 상의 데이터 행을 직접 덮어씁니다(In-place update).
그렇다면 다른 트랜잭션이 과거의 스냅샷을 읽고 싶을 때는 어떻게 할까요? 이를 위해 InnoDB는 덮어쓰기 전의 ‘이전 데이터’를 전용 영역인 **Undo 로그(Undo Log Segment)**로 대피시킵니다.
5.2.2 롤 포인터(Roll Pointer)를 통한 과거의 동적 재구축
InnoDB의 각 데이터 행의 숨겨진 컬럼에는 다음 두 가지가 포함되어 있습니다.
DB_TRX_ID: 이 행을 마지막으로 삽입 또는 갱신한 트랜잭션의 ID.DB_ROLL_PTR(Roll Pointer): 이 행의 ‘한 단계 이전 버전’이 저장되어 있는 Undo 로그 내의 위치를 가리키는 포인터.
트랜잭션이 과거의 스냅샷을 읽어들이는 프로세스는 다음과 같습니다.
- B+Tree에서 최신 데이터 행을 읽는다.
DB_TRX_ID를 확인하여 자신의 스냅샷보다 미래의 트랜잭션에 의한 갱신이라면 이 최신 행은 읽어서는 안 된다고 판단한다.DB_ROLL_PTR을 따라가 Undo 로그에서 과거 버전의 데이터를 가져온다.- Undo 로그 상의 데이터를 사용하여 메모리 상에서 과거 레코드 상태를 **동적으로 재구축(Rollback in memory)**한다.
- 그럼에도 여전히 미래의 갱신이라면, 다시 Undo 로그 체인을 과거로 거슬러 올라간다.
5.2.3 InnoDB의 이점과 과제
이 아키텍처의 이점은 메인 테이블 영역(테이블스페이스)이 잘 비대해지지 않는다는 것입니다. 최신 데이터는 항상 B+Tree의 적절한 위치에 있고 과거의 버전은 별도 영역(Undo 로그)에 격리되어 있기 때문에 물리적인 탐색 효율이 높게 유지됩니다(PostgreSQL과 같은 대규모 VACUUM은 필요하지 않으며, Undo 로그의 퍼지 프로세스가 백그라운드에서 가볍게 동작합니다).
반면 단점은 과거의 스냅샷을 대량으로 읽어들이는 장시간 실행 트랜잭션(배치 처리나 mysqldump 등)이 존재할 경우, Undo 로그를 깊이 거슬러 올라가 데이터를 재구축하는 오버헤드가 발생하여 읽기 성능이 저하된다는 것입니다. 또한 Undo 로그 자체가 비대해져 디스크 공간을 압박할 위험도 안고 있습니다.
제6장: 직렬화 가능 스냅샷 격리(SSI)와 분산 데이터베이스의 최전선
MVCC의 진화는 여기서 끝나지 않습니다. 제3장에서 설명했듯이 스냅샷 격리(SI)에는 ‘쓰기 스큐’ 등의 이상 현상이 존재하여 완전한 Serializable이 아니었습니다. 하지만 애플리케이션 개발자에게 동시 처리의 복잡성을 의식시키지 않기 위해서는 완전한 Serializable을 MVCC의 높은 성능을 유지한 채 구현할 필요가 있습니다.
6.1 직렬화 가능 스냅샷 격리(SSI)의 탄생
2008년, Michael Cahill 등의 논문에서 **‘Serializable Snapshot Isolation (SSI)’**이라는 획기적인 알고리즘이 발표되었습니다. 이는 MVCC 아키텍처를 기반으로 하면서 완전한 직렬화 가능성(Serializable)을 보장하는 기술입니다. PostgreSQL은 버전 9.1부터 발빠르게 이 SSI를 ‘Serializable’ 격리 수준의 구현으로 채택했습니다.
SSI의 동작 원리: 경합 그래프와 위험 구조(rw-antidependency)
SSI는 잠금에 의한 차단을 수행하지 않습니다. 그 대신 트랜잭션 실행 중에 ‘어떤 데이터를 읽었고(Read), 어떤 데이터를 썼는지(Write)‘를 세밀하게 추적(트래킹)합니다.
SSI는 트랜잭션 간의 경합 관계를 감시하고, **‘rw-antidependency(읽기-쓰기 반종속성)’**이라 불리는 특정 경합 패턴을 찾습니다. 구체적으로는, 트랜잭션 $T_1$이 과거 버전의 데이터를 읽고, 그 데이터를 나중에 다른 트랜잭션 $T_2$가 덮어쓰고 커밋하는 관계입니다. SSI는 내부적으로 트랜잭션의 경합 그래프를 구축하고, ‘rw-antidependency 화살표가 2번 연속되는 구조(위험 구조)‘를 감지하는 순간, 직렬화 가능성이 붕괴될 가능성이 있다고 판단하여 한쪽 트랜잭션을 강제적으로 중단(롤백)시킵니다.
이를 통해 쓰기 스큐(예: 의사 온콜 문제)와 같은 이상 현상이 발생하기 전에 트랜잭션을 정지시켜, 결과적으로 완전한 Serializable을 보장합니다. 낙관적 동시성 제어(OCC)의 궁극적인 형태라고 할 수 있습니다.
6.2 분산 데이터베이스에서의 MVCC: Spanner, CockroachDB, TiDB
현대 데이터베이스 기술은 단일 서버의 한계를 넘어 전 세계 데이터 센터에 분산 배치되는 분산 SQL 데이터베이스(NewSQL)로 진화하고 있습니다. 분산 환경에서 전역적인 일관성을 가진 MVCC를 구현하는 것은 물리 법칙에 대한 도전이기도 했습니다.
Google Spanner와 TrueTime API
Google의 Spanner는 분산 시스템에서의 트랜잭션 순서화 문제를 해결하기 위해 TrueTime API를 개발했습니다. 각 서버의 시계(물리적 클럭)는 반드시 어긋난다(클럭 스큐)는 전제 하에, GPS와 원자시계를 결합하여 현재 시각을 ‘불확실성의 범위(타임 윈도우)‘로 제공합니다. Spanner의 MVCC는 트랜잭션 커밋 시 이 TrueTime의 불확실성 윈도우가 지나기를 기다림(Commit Wait)으로써, ‘인과 관계가 있는 트랜잭션은 반드시 타임스탬프 순서가 올바르게 된다(외부 일관성 / External Consistency)‘는 것을 물리적으로 보장했습니다.
CockroachDB와 HLC (Hybrid Logical Clock)
Spanner에서 영감을 받은 오픈소스 분산 데이터베이스인 CockroachDB는 값비싼 원자시계를 사용하지 않고 이에 가까운 일관성을 구현하기 위해 **HLC(하이브리드 논리 클럭)**를 채택하고 있습니다. NTP에 의한 물리적 클럭 동기와 Lamport 논리 클럭(이벤트 간 인과관계에 기반한 카운터)을 결합함으로써 분산 노드 간에 전역적으로 일관된 MVCC 스냅샷 타임스탬프를 생성하고, SSI(Serializable Snapshot Isolation)를 분산 환경에서 실현하고 있습니다.
TiDB와 Percolator 모델
PingCAP사가 개발하는 TiDB는 Google Percolator 모델을 기반으로 한 분산 트랜잭션 모델을 채택하고 있습니다. 전역 타임스탬프를 발급하는 단일 컴포넌트(Placement Driver: PD)를 두고, 각 노드의 스토리지 엔진(TiKV)이 그 타임스탬프를 사용하여 로컬에서 MVCC를 처리하는 아키텍처입니다. 2PC(Two-Phase Commit)를 기반으로 하면서도 잠금 유지 기간을 최소화하여 분산 환경에서의 거대한 트랜잭션과 MVCC를 양립시키고 있습니다.
결론: ACID의 너머로
데이터베이스의 트랜잭션 격리 수준은 결코 단순한 암기 항목이 아닙니다. 그것은 데이터의 일관성과 시스템의 성능이라는 상반된 요구를 어떻게 조화시킬 것인가 하는, 수십 년에 걸친 컴퓨터 과학 투쟁의 역사 그 자체입니다.
ANSI SQL-92의 불완전한 정의에서 시작하여 MVCC에 의한 동시 처리의 비약적 향상, PostgreSQL과 InnoDB라는 아키텍처의 분기, 그리고 SSI와 분산 데이터베이스를 통한 궁극의 일관성에 대한 도전. 이들의 내부 구조를 깊이 이해하는 것은 더 견고하고 고성능의 애플리케이션을 설계하기 위한 강력한 무기가 될 것입니다.
우리는 지금 ACID 특성이 단순한 ‘신화’가 아니라 고도의 알고리즘과 물리적 시계의 동기화를 통해 ‘현실’의 것으로 구현되는 시대를 살고 있습니다. 데이터의 바다를 항해하는 엔지니어에게 데이터베이스 엔진의 심연을 아는 것은 결코 끝나지 않는 지적 탐구의 여정입니다.