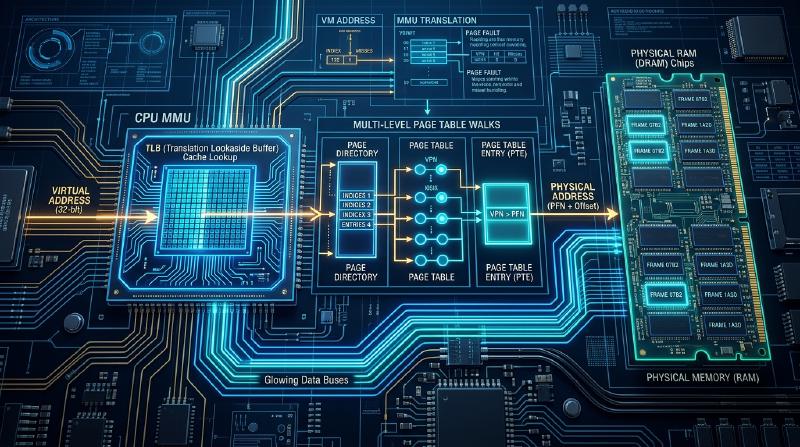
Anatomi Lengkap Memori Virtual dan Mekanisme Paging: Dari MMU ke TLB, HugePage, dan Kedalaman Manajemen Memori
Dalam sistem operasi (OS) modern dan arsitektur CPU, salah satu sistem yang paling kompleks namun paling penting adalah mekanisme “Memori Virtual (Virtual Memory)” dan “Paging”. Di balik ruang memori yang biasanya tidak disadari oleh pengembang aplikasi, MMU (Memory Management Unit) perangkat keras dan kernel OS bekerja sama erat, melakukan konversi alamat dalam jumlah besar dan penanganan pengecualian di dunia nanosekon.
Dalam artikel ini, kita akan membedah bagian terdalam dari sistem memori virtual dari perspektif struktur internal sistem operasi dan arsitektur komputer. Mulai dari tata letak bit lengkap dari struktur tabel halaman arsitektur x86-64, protokol IPI dari TLB shootdown, pelacakan lengkap page fault di kernel Linux, mekanisme fisik dari Copy-on-Write (CoW), algoritma pemulihan memori (Reclaim), hingga rumus perhitungan skor OOM Killer, kita akan menjelaskan mekanisme tingkat rendah secara menyeluruh di tingkat kode sumber dan register.
Bab 1: Alasan Keberadaan Memori Virtual dan Latar Belakang Historis
Mengapa komputer membutuhkan memori virtual? Pada sistem komputer awal, program mengakses alamat tertentu di memori fisik (RAM) secara langsung. Namun, seiring memasyarakatnya lingkungan multitasking, “metode penetapan alamat fisik langsung” ini mencapai batasnya.
1.1 Perlindungan Memori dan Pemisahan Total Ruang Proses
Tujuan utama dari memori virtual adalah “menjamin keamanan dan stabilitas”. Jika Proses A secara tidak sengaja (atau dengan niat jahat) menimpa memori Proses B, seluruh sistem bisa macet, atau informasi rahasia bisa bocor. Memori virtual memberikan ilusi kepada setiap proses bahwa mereka “memiliki ruang memori berkelanjutan milik mereka sendiri”. Dengan ini, memori antar proses dipisahkan secara ketat di tingkat perangkat keras (MMU), dan akses memori yang tidak sah akan segera ditangkap dan diproses sebagai segmentation fault. Pemisahan ruang pengguna dan ruang kernel juga diwujudkan oleh mekanisme ini, dengan transisi ring hak istimewa dan pemeriksaan izin akses memori dilakukan oleh perangkat keras setiap siklus.
1.2 Mendobrak Batas Kapasitas Memori Fisik dan Filosofi Demand Paging
Tidak jarang jumlah memori yang diminta oleh aplikasi melebihi kapasitas RAM fisik yang terpasang. Memori virtual menyediakan ruang alamat yang sangat luas, melebihi memori fisik, dengan menyimpan (swap out) area memori (halaman) yang saat ini tidak digunakan ke perangkat penyimpanan sekunder (HDD/SSD), dan memuatnya kembali (swap in) saat dibutuhkan. Selain itu, alih-alih memuat semua kode dan data ke memori saat program mulai dieksekusi, ia menggunakan filosofi “demand paging” di mana memuat ke memori baru dilakukan saat akses terjadi, yang menyeimbangkan penghematan memori dan waktu mulai (startup) yang cepat.
1.3 Pergeseran Paradigma dari Segmentasi ke Paging
Pada x86 awal (seperti 80286), “segmentasi” digunakan untuk mengelola memori dalam blok dengan panjang variabel. Ini adalah metode yang menggunakan register seperti CS (code segment) dan DS (data segment) untuk menghitung alamat logis dengan alamat basis + offset. Namun, segmentasi rentan menyebabkan “fragmentasi eksternal (fragmentasi memori)”, dan pengelolaannya sangat rumit. Kemudian, dengan munculnya 80386, “paging” diperkenalkan untuk mengelola dalam blok dengan panjang tetap (biasanya 4KB), yang menjadi arus utama. OS 64-bit modern (Linux dan Windows) secara efektif menonaktifkan segmentasi sebagai model memori datar (alamat basis 0, batas maksimum), dan mengelola memori hanya dengan paging. Segmentasi saat ini hanya digunakan untuk sejumlah kecil tujuan khusus, seperti mereferensikan Thread Local Storage (TLS) (register FS/GS).
Bab 2: Anatomi Lengkap Struktur Multi-level Tabel Halaman dan Tata Letak Bit pada x86-64
Dalam arsitektur 64-bit (x86-64/AMD64), ruang alamat virtual sangat luas. Dalam “ruang alamat virtual 48-bit” yang dominan saat ini, perangkat keras MMU menelusuri 4 tingkat tabel halaman.
2.1 Ruang Alamat Virtual 48-bit/57-bit dan Batasan Bentuk Kanonik (Canonical Form)
Register 64-bit dapat merepresentasikan ruang alamat seluas 16 exabyte, tetapi implementasi perangkat keras saat ini tidak menggunakan semuanya dari perspektif biaya dan kompleksitas. Dalam implementasi 48-bit, ada batasan bahwa bit 47 hingga 63 dari alamat virtual semuanya harus memiliki nilai yang sama (ekstensi tanda). Alamat yang memenuhi batasan ini disebut “Alamat Kanonik (Canonical Address)”.
Ini menghasilkan struktur ruang memori yang memiliki area tak terpakai yang besar di tengah (lubang Non-canonical), dan secara rapi terbagi dua menjadi ruang pengguna di bagian bawah (0x0000000000000000 ~ 0x00007FFFFFFFFFFF) dan ruang kernel di bagian atas (0xFFFF800000000000 ~ 0xFFFFFFFFFFFFFFFF). Jika Anda mendereferensi penunjuk yang tidak valid (misalnya penunjuk yang metadata-nya disematkan di bit paling signifikan), MMU akan segera memunculkan General Protection Fault (#GP) sebagai pelanggaran Canonical. Baru-baru ini, pada prosesor mulai dari Intel Ice Lake, ruang virtual 57-bit (tabel halaman 5 level) yang lebih luas juga mulai didukung, menjadi fondasi untuk infrastruktur cloud yang menangani memori dalam skala petabyte.
2.2 Rincian Struktur Hierarkis Tabel Halaman 4-Level (PML4, PDPT, PD, PT)
Untuk menerjemahkan alamat virtual 48-bit ke alamat fisik, x86-64 menggunakan tabel halaman 4 hierarki (struktur data seperti Radix Tree). Setiap tabel berukuran 4KB dan menyimpan 512 entri 64-bit (8-byte) (2^9 = 512). Alamat virtual dibagi sebagai berikut, berfungsi sebagai indeks untuk setiap hierarki.
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - Tingkat tertinggi. Register CR3 menunjuk ke alamat basis fisik.
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - Ini menjadi titik akhir untuk kasus 2MB HugePage.
- Bits 12-20 (9 bits): PT (Page Table) Index - Tabel akhir untuk halaman 4KB biasa.
- Bits 0-11 (12 bits): Page Offset - Offset dalam halaman 4KB (4096 byte).
2.3 Tabel Lengkap Tata Letak 64-bit dari Page Table Entry (PTE)
Setiap entri 64-bit di tabel halaman bukan sekadar penunjuk alamat fisik, melainkan kumpulan metadata yang mengatur kontrol akses dan kontrol cache yang kuat. Berikut adalah tata letak bit PTE x86-64 lengkap dan fungsi rincinya.
- Bit 0 [P] Present: Jika 1, ada di memori fisik. Jika 0, telah di-swap out atau belum dialokasikan. Jika diakses saat bernilai 0, terjadi pengecualian page fault (#PF).
- Bit 1 [R/W] Read/Write: Jika 0, Read-Only (tidak bisa ditulis), jika 1, Read/Write diizinkan. Memainkan peran krusial dalam implementasi CoW (Copy-on-Write).
- Bit 2 [U/S] User/Supervisor: Jika 0, hanya dapat diakses dalam mode hak istimewa (kernel). Jika 1, dapat diakses juga dari mode pengguna (Ring 3). Dikelola secara ketat oleh KPTI, SMAP, dll.
- Bit 3 [PWT] Page-level Write-Through: Jika 1, kebijakan penulisan cache untuk halaman ini adalah Write-Through. Jika 0, Write-Back.
- Bit 4 [PCD] Page-level Cache Disable: Jika 1, cache halaman ini dinonaktifkan (Uncacheable). Digunakan saat mengakses langsung register perangkat PCIe seperti dalam Memory-Mapped I/O (MMIO).
- Bit 5 [A] Accessed: Secara otomatis disetel ke 1 oleh perangkat keras ketika MMU mengakses (Read atau Write) halaman ini. Digunakan sebagai bit referensi dalam algoritma LRU OS (pemulihan halaman).
- Bit 6 [D] Dirty: Secara otomatis disetel ke 1 oleh perangkat keras ketika MMU melakukan “penulisan” pada halaman ini. Bit esensial bagi OS untuk menentukan apakah perlu menulis ulang ke disk (swap out).
- Bit 7 [PAT] Page Attribute Table: Digabungkan dengan PWT/PCD, ini adalah indeks untuk menentukan jenis cache memori yang lebih detail (seperti WC: Write-Combining). Digunakan untuk transfer massal berkecepatan tinggi ke memori grafis (VRAM).
- Bit 8 [G] Global: Jika 1, entri ini tidak di-flush dari TLB bahkan jika register CR3 beralih (terjadi context switch). Terutama digunakan untuk halaman di ruang kernel guna menghindari penalti akibat TLB miss saat panggilan sistem.
- Bits 9-11 [AVL] Available: 3 bit yang bebas digunakan oleh OS (kernel). Di Linux, terkadang digunakan untuk metadata entri swap atau untuk mengidentifikasi node NUMA.
- Bits 12-51 [PFN] Physical Frame Number: Alamat basis dari halaman fisik tujuan konversi (Nomor Frame Fisik). Karena disejajarkan ke 4KB (4KB aligned), 12 bit terbawah selalu diperlakukan sebagai 0.
- Bits 52-62 [AVL/PKU] Available/Ignored: Dicadangkan atau area yang dapat digunakan OS tergantung pada generasi CPU atau ekstensi fungsional (seperti Intel MPK: Memory Protection Keys).
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: Jika 1, data pada halaman ini “tidak dapat dieksekusi sebagai instruksi”. Mekanisme keamanan yang kuat (DEP: Data Execution Prevention) untuk mencegah serangan injeksi kode ke area data melalui buffer overflow dll.
Seperti yang Anda lihat, setiap bit PTE saling terkait erat dengan algoritma manajemen memori OS (terutama proses swap, perlindungan keamanan, kontrol I/O), menjadikannya desain antarmuka yang sangat canggih di batas antara perangkat keras dan perangkat lunak.
Bab 3: Penelusuran Tabel Halaman Perangkat Keras oleh MMU dan Dinding Keterlambatan (Latensi)
Konversi alamat virtual ke alamat fisik dilakukan oleh sirkuit perangkat keras khusus yang disebut MMU (Memory Management Unit) yang berada di dalam inti (core) CPU.
3.1 Mekanisme Penelusuran Tabel yang Berawal dari Register CR3
Register kontrol CR3 milik prosesor berisi alamat fisik tabel halaman tingkat atas (PML4) untuk proses yang sedang berjalan. OS seperti Linux, ketika melakukan context switch dan menyerahkan hak eksekusi CPU ke proses lain, menulis ulang register CR3 ini dengan alamat PML4 dari proses baru. Ini membuat ruang memori proses berganti seketika.
Berikut adalah alur konseptualnya:
- Mengekstrak indeks tingkat teratas dari alamat virtual dan membaca entri yang sesuai di tabel PML4 yang ditunjuk oleh CR3.
- Mengambil PFN dari entri PML4 dan menghitung alamat fisik tabel PDPT berikutnya.
- Membaca entri yang sesuai di tabel PDPT.
- Demikian pula menelusuri tabel PD dan tabel PT untuk mendapatkan alamat basis halaman fisik 4KB akhir.
- Terakhir, menambahkan offset halaman 12-bit untuk membuat alamat fisik lengkap.
3.2 Akses Bus Memori dan Keterlambatan (Latensi) sebagai Dinding Terbesar
Kelemahan terbesar dari penelusuran tabel halaman 4 level ini adalah “Latensi Akses Memori”. Hanya dengan mengonversi satu alamat virtual, dalam kasus terburuk, ada 4 akses ke memori fisik (pembacaan PML4, PDPT, PD, PT). Latensi akses DRAM modern adalah sekitar 50 hingga 100 nanosekon. Jika keempat akses memori ini luput (miss) dari cache CPU (L1/L2/L3) dan mencapai DRAM, hal ini saja akan menyebabkan hambatan (stall) selama ratusan nanosekon. Mengingat siklus clock CPU sekitar 0,3 nanosekon (3GHz), ini merupakan penundaan fatal yang setara dengan ribuan siklus, menyebabkan alur (pipeline) CPU sepenuhnya kosong dan terhenti. Untuk menembus dinding kinerja yang sangat serius ini, dirancanglah TLB yang akan dijelaskan selanjutnya.
Bab 4: Arsitektur TLB di Lingkungan Multi-Core dan Penderitaan TLB Shootdown
TLB (Translation Lookaside Buffer) adalah “cache dari hasil terjemahan alamat virtual ke alamat fisik” yang dibangun di dalam MMU, dan terdiri dari SRAM (atau CAM: Content Addressable Memory) super cepat.
4.1 Struktur Hierarkis TLB dan Optimalisasi melalui PCID (Process-Context Identifier)
Pada CPU terbaru, TLB juga memiliki struktur hierarkis L1/L2. L1 D-TLB (untuk data) dan L1 I-TLB (untuk instruksi) berkapasitas sangat kecil (puluhan entri) tetapi merespons dalam 1 siklus. L2 TLB memiliki ratusan hingga ribuan entri dan merespons dalam beberapa siklus. Jika entri tidak ada di TLB (TLB miss), penelusuran tabel perangkat keras (page walk) yang dijelaskan sebelumnya terjadi. Untuk mendukung ini, cache khusus untuk page walk (PWC: Page Walk Cache) juga diimplementasikan.
Karena arti alamat virtual berubah ketika proses berganti, secara historis (pada x86 awal), seluruh isi TLB dihapus (Flush) saat CR3 ditulis ulang. Namun, hal ini menyebabkan banyak TLB miss segera setelah context switch, sehingga sangat menurunkan kinerja. Teknologi yang diperkenalkan untuk memecahkan masalah ini adalah PCID (Process-Context Identifier) (disebut ASID pada arsitektur ARM). Dengan memberikan ID (tag) 12-bit yang mengidentifikasi proses secara unik ke entri TLB, menjadi mungkin untuk tetap menyimpan entri TLB dari proses sebelumnya bahkan setelah context switch, yang secara dramatis meningkatkan kinerja dalam lingkungan multi-proses seperti server web dan basis data.
4.2 Protokol Inter-Processor Interrupt (IPI) dari TLB Shootdown
Dalam lingkungan multi-core, sistem memori virtual menghadapi masalah sinkronisasi yang sangat rumit. Misalnya, misalkan proses yang berjalan pada core 0 (CPU0) melepaskan area memori tertentu menggunakan munmap() dan menonaktifkan PTE dari tabel halaman (Present = 0). Namun, di TLB lokal core 1 (CPU1), mungkin masih ada sisa “informasi terjemahan lama (Stale TLB Entry)” dari alamat virtual ke alamat fisik tersebut sebagai cache.
Jika dibiarkan, core 1 mungkin mengakses memori yang sudah dilepas, menyebabkan celah keamanan serius karena dapat merusak data yang dialokasikan untuk proses lain, atau membaca informasi rahasia. Untuk mencegah hal ini, OS harus memaksa core 1 menghapus entri yang relevan dari TLB-nya. Ini disebut TLB Shootdown.
TLB Shootdown dieksekusi secara ketat dengan langkah-langkah berikut (Protokol IPI):
- Inisiator (Core 0): Setelah memperbarui tabel halaman (membersihkan PTE), menerbitkan memory barrier (seperti
mfence), dan mengirimkan IPI (Inter-Processor Interrupt) ke pengontrol APIC lokal (Advanced Programmable Interrupt Controller) dari core target lain (Core 1). - Menunggu (Busy Wait): Core 0 menunggu menggunakan spinlock sampai semua core target selesai memproses interupsi.
- Target (Core 1): Saat menerima IPI, ia segera menyela kode pengguna yang sedang berjalan, dan beralih ke handler interupsi kernel (di Linux, seperti
flush_tlb_funcmelaluismp_call_function). - Eksekusi Flush: Core 1 menonaktifkan entri untuk alamat virtual yang ditentukan dari TLB lokalnya (menggunakan instruksi
INVLPGdi x86, memuat ulang CR3 untuk pembilasan penuh). - Notifikasi Selesai: Core 1 menulis penyelesaian flush ke bendera di memori, melepaskan waktu tunggu core 0. Kemudian, kembali ke pemrosesan yang terputus (
iret).
Hambatan Kinerja dan Batas Skalabilitas: Karena TLB Shootdown melibatkan penerbitan IPI perangkat keras, context switch akibat interupsi, pengosongan alur (pipeline flush), dan penantian spinlock di antara banyak core, ini adalah operasi berbiaya sangat tinggi yang menghabiskan ribuan hingga puluhan ribu siklus. Semakin banyak jumlah core seperti 16, 64, atau 128, biaya sinkronisasi ini meningkat secara eksponensial, dan telah menjadi faktor penghambat skalabilitas yang serius untuk aplikasi multi-thread di server cloud atau HPC (khususnya yang sering mengalokasikan dan melepaskan memori).
Bab 5: Jejak Lengkap Penanganan Page Fault di Kernel Linux
Ketika sebuah program mengakses area dengan bit Present di tabel halaman bernilai 0, atau area yang tidak sah (mencoba menulis ke area Read-Only, mengakses area kernel dari mode pengguna, dll.), MMU mengeluarkan Pengecualian Page Fault (di x86 disebut Exception 14, #PF). Dari sinilah perjalanan menuju kedalaman penanganan pengecualian kernel Linux dimulai.
5.1 Alur Kontrol Page Fault dan Pelacakan Bagian yang Bergantung pada Arsitektur
Pada kernel Linux x86-64, grafik pemanggilan fungsi (call trace) saat terjadi page fault adalah sebagai berikut. Kontrol berpindah dari handler tingkat rendah yang bergantung pada arsitektur ke subsistem manajemen memori umum yang tidak bergantung pada arsitektur.
asm_exc_page_fault(Bahasa Assembly: arch/x86/entry/entry_64.S)- CPU mendeteksi pengecualian, perangkat keras mengatur register
CR2dengan alamat virtual di mana fault terjadi, menyimpan state register ke tumpukan (stack) interupsi, dan melompat ke titik masuk kernel.
- CPU mendeteksi pengecualian, perangkat keras mengatur register
exc_page_fault()(Bahasa C: arch/x86/mm/fault.c)- Handler fault yang bergantung pada arsitektur. Ini menganalisis kode kesalahan (Read/Write, User/Kernel, PF dll.) dan memeriksa konteks interupsi.
do_page_fault()/do_user_addr_fault()- Menentukan apakah fault terjadi di ruang kernel (bug, area vmalloc, dll.) atau ruang pengguna. Jika di ruang pengguna, sistem mencari peta memori proses terkait (red-black tree atau daftar VMA di
vm_area_struct) dan memastikan apakah alamat tersebut termasuk di area yang valid (bukan segmentation fault).
- Menentukan apakah fault terjadi di ruang kernel (bug, area vmalloc, dll.) atau ruang pengguna. Jika di ruang pengguna, sistem mencari peta memori proses terkait (red-black tree atau daftar VMA di
handle_mm_fault()(Bahasa C: mm/memory.c)- Mulai dari sini adalah fungsi inti yang tidak bergantung pada arsitektur. Fungsi ini menelusuri setiap hierarki tabel halaman (PGD -> P4D -> PUD -> PMD -> PTE), mengalokasikan direktori perantara secara baru (seperti
pmd_alloc) jika tabel tersebut belum dialokasikan, dan mengidentifikasi alamat PTE akhir.
- Mulai dari sini adalah fungsi inti yang tidak bergantung pada arsitektur. Fungsi ini menelusuri setiap hierarki tabel halaman (PGD -> P4D -> PUD -> PMD -> PTE), mengalokasikan direktori perantara secara baru (seperti
5.2 Esensi Alokasi Memori: Percabangan dari handle_mm_fault
handle_mm_fault() akan memercabangkan proses alokasi halaman sebenarnya berdasarkan status dari PTE yang teridentifikasi (apakah PTE kosong, diswap keluar, atau kesalahan izin).
do_anonymous_page()(Puncak Demand Paging): Dipanggil saat PTE benar-benar kosong (nol). Ini adalah akses pertama ke halaman anonim (Anonymous Page) yang tidak terikat pada file, seperti ekstensi heap (di balikmallocyaitubrkataummap) atau stack. Di sini kernel pertama kali memesan memori fisik (frame) dari Buddy System, membersihkannya menjadi nol, lalu memetakannya ke PTE. Dengan ini memori yang tidak terpakai dapat dihemat.do_fault()/__do_fault()(Paging didukung File / File-backed Paging): Dipanggil pada akses pertama ke file yang di-mmapdan sebagainya. Membaca data file dari page cache, atau memanggil driver sistem file (ext4 atau xfs) untuk memuat data dari disk, dan memetakannya ke tabel halaman.do_swap_page()(Rasa Sakit dari Swap In): Dipanggil jika bit Present dari PTE adalah 0, namun informasi offset area swap tercatat pada bit penanda (flag bit) lainnya. Data dimuat ulang dari disk (partisi swap atau file swap) ke memori fisik. Karena melibatkan I/O disk, proses memasuki kondisi Sleep (blok) dalam waktu yang lama.do_wp_page()(Copy-on-Write): Proses CoW yang dijelaskan nanti. Dipanggil saat mencoba menulis pada halaman dengan Present=1, namun tidak memiliki izin Write.
5.3 Mekanisme Fisik Copy-on-Write (CoW) dan Keajaiban Penghitungan Referensi (Reference Count)
Panggilan sistem (system call) fork(), yang merupakan inti dari pembuatan proses Linux, beroperasi dengan sangat cepat menggunakan mekanisme evaluasi tertunda (lazy evaluation) bernama CoW (Copy-on-Write). Di sini dijelaskan mekanisme fisik di balik penyelesaian sesaat fork() meskipun proses induk (parent) menggunakan memori beberapa gigabyte.
- Berbagi Tabel Halaman:
Saat
fork()dipanggil, kernel menyalin persis tabel halaman dari proses induk ke proses anak (child). Akan tetapi, memori fisik itu sendiri sama sekali tidak disalin. PTE proses induk dan anak menunjuk pada memori fisik (frame) yang persis sama. - Pengaturan Paksa Bit Read-Only (Write-Protect):
Pada saat ini, kernel menimpa secara paksa bit
R/Wsemua PTE dari halaman yang dibagikan menjadi0(Read-Only) (termasuk area data yang pada awalnya bisa ditulis). - Peningkatan (Increment) Penghitungan Referensi (Reference Count):
Kernel menambahkan struktur data (struktur kernel
struct pagevariabel_refcount) yang mengelola halaman fisik tujuan, dengan ini keadaannya diubah menjadi “direferensikan oleh 2 proses”. - Penulisan dan Page Fault (Pemicuan do_wp_page):
Saat salah satu, proses induk atau anak, mencoba menulis (Write) variabel atau area heap yang dibagikan bersama, MMU perangkat keras mendeteksi
R/W=0dan secara seketika menghasilkan page fault. - Duplikasi Halaman (Duplication):
do_wp_page()dipanggil dari handler page fault. Kernel memeriksa bendera dari VMA dan memutuskan bahwa “Ini bukan akses tidak sah, ini adalah fault yang valid karena CoW”. Satu halaman fisik baru dialokasikan dari Buddy System, dan data seluruh halaman aslinya disalin (copy_page). - Pembaruan PTE dan Penurunan (Decrement) Penghitungan Referensi:
PTE dari proses yang melakukan penulisan diarahkan ulang ke halaman fisik baru, dan bit
R/Wdiubah menjadi1(Read/Write diperbolehkan). Selanjutnya, hitungan referensi pada halaman fisik aslinya diturunkan. Jika hitungan referensinya menjadi 1, maka ini menunjukkan proses lainnya sekarang memonopoli halaman tersebut, sehingga ketika proses lainnya itu kemudian menyebabkan fault, cukup mengembalikan bit R/W menjadi 1 tanpa melakukan penyalinan memori (penggunaan ulang halaman).
Dengan demikian, CoW adalah algoritma artistik yang menggabungkan secara brilian fitur perlindungan perangkat keras MMU (Jebakan Read-Only) dan kendali perangkat lunak kernel, serta mencapai penghematan memori dramatis serta peluncuran proses berkecepatan tinggi.
Bab 6: Kedalaman Algoritma Pemulihan (Reclaim) Memori dan Eksekusi oleh OOM Killer
Memori fisik terbatas. Jika sistem berjalan lama dan cache file maupun heap proses memakan habis semua memori, OS harus melepaskan dan mengambil kembali (Reclaim) area memori yang sudah ada untuk mendapatkan memori baru. Subsistem pemulihan memori ini merupakan salah satu dari bidang yang paling kompleks dan membingungkan di kernel Linux.
6.1 Daftar LRU Aktif/Inaktif dan Algoritma Pseudo-LRU
Kernel Linux menggunakan Daftar LRU (Least Recently Used) untuk mengelola dan melacak halaman fisik. Akan tetapi, tidaklah mungkin mengelola semua halaman dengan LRU ketat dari sisi konflik penguncian (lock contention) dan biaya pemindaian. Oleh karena itu, diperkenalkan algoritma Pseudo-LRU (turunan dari algoritma Clock) yang menggunakan 2 antrean (daftar): “Daftar Active” dan “Daftar Inactive”.
- Daftar Active: Kumpulan halaman “panas (hot)” yang baru-baru ini sering diakses. Area ini bukan target pemulihan.
- Daftar Inactive: Kumpulan halaman “dingin (cold)” yang belakangan tidak diakses. Menjadi kandidat pemulihan secara berurutan dari halaman di akhir (tail).
Bagaimana cara kernel mengetahui kapan sebuah halaman diakses? Di sinilah Accessed bit (bit A) pada PTE, yang dijelaskan di bab 2, memainkan peran. Kernel (kswapd) memindai tabel halaman secara periodik, membaca bit A dari PTE, mencatat rekam jejak akses di sisi perangkat lunak, dan menghapus (clear) bit A menjadi 0. Jika bit A disetel ke 1 lagi oleh perangkat keras, halaman tersebut akan bertahan di daftar Active, atau dipromosikan dari Inactive. Jika tidak disetel, secara bertahap diturunkan hingga akhir daftar Inactive.
6.2 Daemon kswapd dan Kengerian Direct Reclaim
Ketika kapasitas ruang memori yang kosong (Free Pages) jatuh di bawah ambang batas tertentu (watermark: low), thread latar belakang kernel yaitu kswapd (yang ada di setiap node NUMA) akan terbangun.
kswapd mengambil halaman dari akhir daftar Inactive.
- Jika itu adalah cache file yang bersih (clean - data file tidak diubah), kernel cukup membuangnya (Drop) dan mengosongkan memori.
- Jika itu adalah cache file yang kotor (dirty - sudah diubah), ia menuliskannya kembali (Writeback) ke disk, kemudian membuangnya.
- Jika itu halaman anonim (heap atau stack dari suatu proses), itu dituliskan ke area swap (swap out).
Proses pekerjaan latar belakang ini terus berlangsung sampai memori yang bebas mencapai ambang batas watermark
high.
Namun, ketika laju pemesanan memori dari aplikasi (tekanan memori/memory pressure) sangat tinggi, laju pemulihan oleh kswapd tak mampu mengejar, dan sisa memori kosong menembus di bawah ambang batas kritis (watermark min), Direct Reclaim (Pemulihan Langsung) pun dipicu.
Direct Reclaim adalah mekanisme dimana pengeksekusian dari proses memulihkan memori (pembuangan cache dan swap out) dilakukan secara sinkron secara langsung di konteks proses (aplikasi itu sendiri) yang meminta memori. Begitu masuk ke Direct Reclaim, eksekusi aplikasi (malloc dan penyelesaian page fault) menjadi benar-benar tersendat (berhenti sementara), sehingga ini menjadi penyebab langsung dari penurunan performa serius (lonjakan latensi / latency spike) yang mencapai ratusan milidetik hingga hitungan detik. Untuk basis data atau sistem waktu-nyata (real-time system), tuning (penyetelan vm.swappiness dan penyesuaian batas watermark) merupakan keharusan guna menghindari hal ini.
6.3 Formula Penghitungan Skor OOM Killer dan Eksekusi Proses
Bahkan jika setelah dilakukan Direct Reclaim area swap telah habis terkuras, dan chache sudah dipangkas sampai habis tapi tak kunjung mampu mengamankan memori, maka kernel Linux akan memanggil OOM (Out Of Memory) Killer sebagai langkah terakhir.
Untuk menghindari sistem dari terjatuh ke dalam keadaan panik (kernel macet atau beku sepenuhnya) karena memori yang kurang, OOM Killer akan merebut memori kembali dengan “mematikan secara paksa (SIGKILL)” proses yang banyak mengkonsumsi memori. Terdapat algoritma yang dingin (kejam) untuk menentukan siapa korbannya.
Keputusan tentang proses apa yang dibunuh, dilakukan berdasarkan nilai evaluasi yang bernama oom_score (Dihitung dalam fungsi oom_badness() di mm/oom_kill.c pada kernel).
Logika Perhitungan Dasar OOM Score (Konseptual):
- Skor Dasar: Rasio jumlah penggunaan memori oleh suatu proses saat ini (RSS: Resident Set Size + jumlah ukuran pada page table + jumlah penggunaan swap) terhadap total memori. Poin maksimal adalah 1000 poin. Artinya, proses yang mengkonsumsi memori lebih banyak (misal: proses yang mengalami kebocoran memori dll) lebih rentan untuk dibunuh.
- Pengurangan Hukuman Hak Akses Root: Proses yang berjalan dengan izin pengguna root (misal daemon inti pada suatu sistem, dll) besar kemungkinan sangat diperlukan agar sistem tetap terjaga keberlangsungannya, jadi karena itu, skornya akan didiskon (dikurangi) sedikit agar lebih sulit terbunuh.
- Nilai Penyesuaian Pengguna (OOM Score Adj): Nilai dari
/proc/[pid]/oom_score_adj(rentang -1000 hingga +1000) ditambahkan. Administrator sistem dapat menggunakan hal ini untuk mengontrol tingkah laku dari OOM Killer. Jika nilai dari OOM Score Adj pada sebuah proses di set dengan nilai -1000 (contoh: sshd, kubelet, proses master basis data dll), ini akan membuat proses itu menjadi “tidak menjadi sasaran OOM Killer (kebal)”.
Saat OOM Killer terpicu, pesan log pada kernel (dmesg atau /var/log/messages) memunculkan “Out of memory: Killed process 1234 (java)”, sekaligus rincian dump mendetail akan muncul tentang daftar seluruh proses, status dari penggunaan setiap skor memori ketika keadaan terpicu itu. Dengan memahami catatan dari log dan mekanisme perhitungan skor, administrator suatu sistem bisa menemukan asal muasal atau penyebab sebuah proses dapat terhenti atau diakhiri tak terduga, yang kemudian hal ini digunakan sebagai petunjuk dalam menentukan limitasi penggunaan (batasan limit sumber daya, misal cgroups atau ulimit).
Bab 7: Teknik Memori Berkecepatan Sangat Tinggi Terbaru dan Keamanan Perangkat Keras
7.1 Kekuatan dari 2MB/1GB HugePages dan Sisi Baik-Buruk THP
Cara yang ampuh dalam menyelesaikan TLB miss dan penundaan oleh page table walk seperti apa yang telah diterangkan dalam Bab 3 dan 4 ialah menggunakan “HugePage”. Tidak sekadar hanya laman berukuran 4KB biasa, ia memanfaatkan ukuran raksasa yakni laman 2MB (secara langsung menunjuk kepada alamat fisiknya di tahapan Page Directory, alias melompati tingkatan hierarki tabel PT) ataupun ukuran laman yang sebesar 1GB (secara langsung menunjuknya pada tingkatan tahapan hierarki tabel PDPT).
Melalui metode ini, wilayah ruang memori super besar (512 kali, atau 260.000 kali dari 4KB) akan tercakup hanya dari satu entri TLB, karenanya peristiwa meleset di dalam TLB (TLB miss) secara dramatis mengalami penurunan tajam. Di dalam aplikasi pangkalan data yang secara ngacak berulang kali dapat mengakses jumlah porsi memori raksasa (misalkan Oracle, PostgreSQL) serta lingkungan komputasi mesin-mesin virtualisasi (KVM/QEMU), menggunakan sistem konfigurasi berbekal HugePage saat ini adalah menu pilihan penyetelan peningkatan performa secara mandatori atau diwajibkan.
Di Linux, mekanisme yang ada di latar dari kernel (khugepaged) itu disebut dengan THP (Transparent Huge Pages). THP akan menggabungkan laman halaman 4KB biasa tadi menjadi bentuk bersatu 2MB dari HugePage (mendefrag). Meski hal ini berjalan secara tersembunyi (otomatis disetel oleh kernel sendiri tanpa kesadaran perancang aplikasi), pada suatu lingkungan keadaan jika keadaan fragmentasi kepingan memori itu meningkat naik tajam, konsumsi memori akan bengkak (pemadatan atau konsolidasi yang makan porsi kinerja proses CPU lebih ekstra/besar) yang bisa memantik terjadinya lonjakan angka dari jeda kemacetan waktu respons latensi. Maka dari pada itu di sistem seperti program simpanan tipe In-Memory berformat KVS semacam peranti Redis, sering dianjurkan supaya menonaktifkan fitur operasional THP ini secara permanen (setting via never ataupun menggunakan madvise).
7.2 Pemisahan Tabel Laman Kernel (KPTI) dan Kompensasi (Dampak) dari Mitigasi Meltdown
Pada tahun 2018 kerentanan keamanan atau jebol keamanan dari celah (bug cacat fatal di hardware CPU) proses eksekusi berspekulasi ("Meltdown (CVE-2017-5754)") mulai mencuat dan mengguncang struktur fundamental hardware, karena masalah kelemahan memori celah di kernel dari proses pengguna, dan hal itu adalah peretasan rahasia pada penampungan data memori dalam singgahan (cache).
Bentuk pencegahan dan jalan rilis untuk tingkatkan sisi stabilitas kerentanan dari sisi penambalan pihak peranti lunak di tataran sistem operasi ini disebut KPTI (Kernel Page-Table Isolation) (awalnya dipanggil bernama KAISER).
Dalam hal biasanya demi turunkan pemakaian sumber sistem lebih jauh lewat context switch yang ditimbulkan (overhead) dari sistem, sistem operasi mengawinkan seluruh tabel halaman area wilayah pada lapis ruang kernel itu dalam kesatuan area sisi tabel batas proses level user, yang pada kenyataannya itu juga digunakan bersama untuk eksekusinya (hal tersebut bertumpu ke prinsip: akan ada proteksi perizinan pada saat cek pemeriksaan pengecualian istimewa berpedoman memakai bit PTE U/S yang diklaim diyakini akan mengusir pengakses). Namun celah eksekusi secara berspekulasi/spekulatif mampu menghindari ini dari mekanisme penahanan atau hambatan keamanan cek itu tadi secara menerobos dan terlewat begitu saja.
Pasca instalasi dari KPTI dirilis, pemetaan area kernel takkan dilakukan pada sebagian mayoritas wilayah sisi ruang pengeksekusian lingkungan pada posisi batas pengguna dan peranti itu di-update dirombak sehingga harus dengan merujuk menggunakan cara pemakaian “bayangan dari bayangan di dalam area halaman wilayah terbatas secara ukuran bayangan minimal di table (User PGD)”. Sehingga di saat panggilan transisi ke area ruang kernel seperti layaknya saat panggilan system (system call) atau via interupsi gangguan (interrupt) berlangsung, mewajibkan atau secara mutlak register perantara atau jembatannya yaitu si CR3 diganti dirombak serta akan digantikan kemudian dimuat lagi meminjam tabel ruang PGD khusus Kernel (Kernel PGD).
Tindakan ini sangat memastikan dari bahayanya lubang retas kemanan yang terekspos serta terjamin mutlak di-seal penuh, namun dalam transisinya secara interupsi di kernel atau di tiap langkah rujukan ke syscall selalu menuntut adanya pemakaian beban atau bea yang teramat mahal karena dari langkah sakelar perombakan di CR3 tadi (termasuk bea PCID dan siraman pengelolaan flushes bagi pembuangan TLB). Oleh akibat yang mendasar hal dari biaya-biaya tersebut yang lahir dan berlangsung di I/O, untuk di ranah web atau database khusus operasional intensitas input yang gencar melakukan pemanggilan syscall (I/O intensive) telah menelan pil pahit rugi karena mendatangkan imbas dan membikin lamban tingkat pencapaian (sekitar persentase margin dari hitungan mulai poin di bawah persentase sepuluh maupun hinggap mendarat belasan) sebagai ongkos harga yang tak mungkin mampu diabai atau dianggap tutup mata lagi (performa menjadi pinalti biaya overhead berangsur-angsur turun ke merugikan).
7.3 Direct I/O dan Evolusi Teknologi Zero-Copy
Untuk mengoptimalkan file I/O, OS menerapkan mekanisme memori virtual hingga batas maksimalnya.
Penggunaan pemanggilan sistem mmap() memetakan secara langsung konten pada file beranjak pindah ke sebuah ruang wilayah di tataran perwakilan tempat maya/alam maya ruang-alamat. Akses ke hal ini memicu pemicu error pengecualian memori (page fault), lalu membaca muatan isinya, menyalin dari pangkalan ke tempat cache (page cache), supaya membuatnya lalu lekas kemudian beralih sedia untuk proses perizinan dengan bentuk interaksi menggunakan pointer secara arah alamat tepat dituju lansung pada zona pihak pengguna/pengakses.
Selain daripada hal perihal perpindahan alamat transmisi, ini berkembang dipakai demi melayani optimal untuk porsi lajur pertukaran komunikasi berwujud via perantara internet jalur komunikasi (Network transfer) maupun I/O wadah untuk alat persinggahan memori di-disk, teknologi ini bertujuan memapas ongkos CPU copy dari proses saat pergeseran perpindahan data (copying konteks/konteks peralihan context switch) dengan merengkuh dua tataran alam ranah perantara zona antara Kernel (di Page Cache) serta user / tataran ruang perwakilan pengguna secara saling kirim yang dilaraskan melalui cara teknik mutakhir tanpa fotokopian alias pemindahan bersih yakni zero-copy. Penerapan ini melalui sendfile() hingga pengembangan terikini seperti implementasi pangkalan platform seperti io_uring maupun wadah format AF_XDP, perpaduan atau kerja gabungannya dari kolaborasi kontrol penggerak NIC hardware via modul DMA transfer langsung pengakses ke memori perantara (Direct Memory Access controller) termasuk NVMe memacu kecepatan secara gesit mengkombinasikan penyetelan pada PTE lewat si tabel laman secara mengawinkan (“menautkan lagi dengan mengulang kait pemetaan (remap) ulang”) lembar kernel dialih ke langsung tangan atau ruang pengakses ranah dari pelanggannya dalam sekejap saja, itu membabati segala hambatan pinalti keterlambatan durasi dan menjungkirbalikan biaya ekstra penyalinan atau penulisan rangkap ulang menjadi seketika berbiaya mutlak nol mutlak (zero). Pun tak ketinggalan dalam cara mendasar untuk melancarkan eksekusi operasional manipulasi hebat nan rumit di sisi tabel lama terkuak lagi rahasia dasar utamanya.
Penutup
Memori virtual dan mekanisme paging merupakan orkestra simfoni di tingkat yang sangat tinggi antara perpaduan kecerdasan Kernel dari OS dengan elemen-elemen di peranti CPU (Hardware). Dimulai melacak cara sekelumit setelan sekecil ukuran bit status pemetaan tabel lama halaman, sampai rasa perih sakitnya menunggu kemacetan lock pemicu antrean penundaan di saat eksekusi jatuhan dari tembak senapan untuk si TLB Shootdown berdentang bunyi spinlock, pesulapan hebat yang memukau CoW untuk mereferensikan penggunaan sihitungan (referensinya) di pemanfaatan memori magis, serta kebiadapan tak pandang bulunya algoritma perhitungan kalkulasi pembunuh berdarah dingin sistem algojo kematian pencabut nyawa atau dieksekutor OOM Killer sang mesin perenggut itu, hal mendalam nan luar biasa semuanya pada dasarnya menyimpulkan kebijaksanaan mutakhir (ilmu pamungkas pengetahuan komputasi atau pijakan mahakarya dari si anak manusia ke keilmuan Computer Science) yang intisarinya bermuara tentang satu tajuk “bagaimanakah di dalam hal memanajemenkan batas ukuran jatah alokasi dari ruang keras peranti fisik terbatas yang bisa untuk dicoba diabstraksikan secanggih teraman cepat kencang dalam waktu sama lalu dipersembahkan kemudian kepada sisi klien pengguna/program (proses) sehingga memberikannya semacam kesan angan ilusi bahwa dia merasai tak terbatas”.
Pemahaman mekanisme di lapis tingkat bawah, tidak hanya dibutuhkan mendalam sebatas pada pemahaman tata olah rancang memori struktur data cache-line ataupun efek magis cara pemaikain pemanfaatan pada mmap pada seputar lingkup optimalisasi program pengkodean sistem di tingkatan C/C++ ataupun menggunakan Rust semata. Akan tetapi pemahaman pada pengoperasian ini mutlak diperuntukan tak terkecuali dalam menyentuh batas menguak tabir seluk-beluk untuk memahami fenomena tingkah lakunya dari mesin otomatis si pembersih sampah otomatis di memori semacam fitur peranti Garbage Collection (GC) untuk tataran level tingkat yang berkasta lebih ke atas berperingkat kelas peranti atas atau High-Level semisal bahasa program peranti Java ataupun untuk produk Go dalam hubungannya dengan kejadian masa waktu penghentian secara keseluruhan (STW) dari sistem penampung peranti memori atau memori alokator (tcmalloc dan sejenis jemalloc). Menyingkap mengupas cadar pembalut tirai si “mistis pesulapan ajaib” dari pergerakan irama kinerja mesin ini lantas menyentuhnya langsung meraba menempelkan merasakan pada jantung si peranti fisik hardware mesin sistem dengan beresonansi terhadap kernel secara gamblang ke arah di urat nadinya, kelak niscaya membentangkan jenjang lebar rute lintasan atau anak tangga dalam jalan penempaan langkah bagi seseorang supaya bermetamorfosis berpeluang tumbuh sebagai sosok mahaguru unggulan sang perancang arsitek luar biasa bagi bangunan sistem peranti lunak berkemampuan tingkat teratas terskala dan tercanggih terelok untuk segala era.