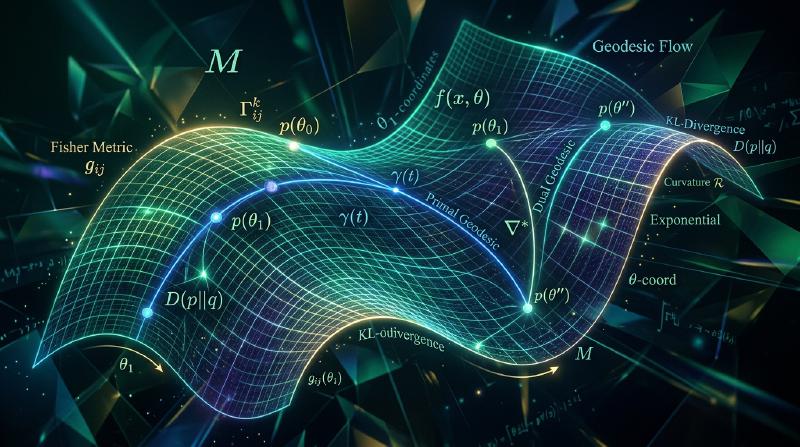
Geometri Informasi (Information Geometry) adalah teori berskala global yang berasal dari Jepang, yang memperkenalkan struktur geometri diferensial ke dalam ruang yang dibentuk oleh distribusi probabilitas, dan mengungkap esensi dari inferensi statistik, pembelajaran mesin, dan teori informasi berdasarkan intuisi geometris. Teori yang disistematisasikan oleh Dr. Shun-ichi Amari dan rekan-rekannya ini, saat ini diterapkan di berbagai bidang seperti metode penurunan gradien natural (Natural Gradient Descent) yang mendukung fondasi AI dan pembelajaran mendalam (deep learning), teori informasi kuantum, dan fisika statistik, serta sedang memantapkan posisinya sebagai “bahasa umum” dalam sains modern.
Dalam artikel ini, kami akan menjelaskan dunia Geometri Informasi yang dalam ini secara sedetail dan sesistematis mungkin, dengan menggabungkan ketelitian matematis, intuisi geometris, dan contoh perhitungan konkret. Tidak hanya sekadar menyusun rumus matematika, kita akan memulai dari pertanyaan mendasar seperti “mengapa ruang distribusi probabilitas itu melengkung?” dan “mengapa matriks informasi Fisher menjadi tensor metrik?”, lalu memaparkan keseluruhan gambaran Geometri Informasi, hingga ke koneksi dual (dual connection), geometri entropi, dan aplikasinya pada pembelajaran mesin termutakhir serta ilmu saraf.
Bab 1: Fajar Geometri Informasi dan Intuisi Shun-ichi Amari
Dari Statistik Ruang Euclidean ke Ruang Melengkung Distribusi Probabilitas
Dalam statistik klasik dan analisis data, kita secara tidak sadar sering memperlakukan data sebagai titik-titik di ruang Euclidean. Misalnya, ketika mempertimbangkan model statistik dengan parameter $\theta = (\theta_1, \theta_2, \dots, \theta_n)$, ruang parameter sering kali dianggap sebagai ruang datar, dan jarak antar parameter diukur menggunakan jarak Euclidean biasa. Metode kuadrat terkecil (least squares) yang meminimalkan kesalahan kuadrat juga didasarkan pada intuisi geometri Euclidean ini.
Namun, apakah ruang yang memparameterisasi distribusi probabilitas benar-benar “datar”?
Mari kita ambil distribusi normal $N(\mu, \sigma^2)$ sebagai contoh. Ruang parameternya adalah setengah bidang atas $\{(\mu, \sigma^2) \in \mathbb{R} \times \mathbb{R}_{>0}\}$ yang terdiri dari rata-rata $\mu$ dan varians $\sigma^2 > 0$. Di sini, kita akan mempertimbangkan dua pasang distribusi normal:
- $N(0, 1)$ dan $N(0.1, 1)$
- $N(0, 100)$ dan $N(0.1, 100)$
Jika dilihat dari jarak Euclidean parameternya, jarak kedua pasang tersebut adalah sama, yaitu $0.1$. Namun, bagaimana jika dilihat dari perspektif “kemampuan diferensiasi” atau “perbedaan informasi” sebagai distribusi probabilitas? Ketika variansnya kecil yaitu $1$, perbedaan rata-rata sebesar $0.1$ saja secara signifikan mengubah bentuk distribusi, sehingga relatif mudah untuk membedakan keduanya dari data. Sebaliknya, ketika variansnya sangat besar yaitu $100$, distribusi akan menyebar datar, dan perbedaan rata-rata sebesar $0.1$ menghasilkan tumpang tindih distribusi yang sangat besar, sehingga sangat sulit untuk membedakan keduanya dari data.
Dengan kata lain, “perbedaan hakiki sebagai distribusi” tidak sesuai dengan jarak Euclidean parameter. Pada daerah di mana variansnya besar, sedikit perubahan pada rata-rata hampir tidak memengaruhi bentuk distribusi, sementara pada daerah dengan varians kecil, hal itu membawa perubahan drastis. Hal ini sangat menunjukkan bahwa ruang parameter distribusi probabilitas tidak seragam, melainkan sebuah “ruang melengkung (manifold Riemann) dengan skala jarak yang berbeda tergantung pada lokasinya.”
Mengapa Keluarga Distribusi Probabilitas Merupakan Manifold?
Geometri informasi memformulasikan model statistik (keluarga distribusi probabilitas) sebagai manifold yang dapat dideferensiasi (Differentiable Manifold).
Misalkan $S$ adalah keluarga distribusi probabilitas pada ruang probabilitas $\mathcal{X}$. Ketika keluarga ini secara unik ditentukan oleh $n$ parameter real kontinu $\theta = (\theta^1, \dots, \theta^n)$ dan fungsi kepadatan probabilitas $p(x; \theta)$ mulus (smooth) terhadap $\theta$, maka $S$ disebut sebagai manifold statistik (Statistical Manifold) berdimensi $n$.
$$ S = \{ p(x; \theta) \mid \theta \in \Theta \subset \mathbb{R}^n \} $$Di sini, $\theta$ tidak lain adalah “sistem koordinat lokal (Local Coordinate System)” pada manifold $S$. Dalam teori manifold, sistem koordinat bukanlah sesuatu yang esensial, melainkan hanya salah satu representasi. Misalnya, untuk distribusi normal, kita bisa memilih $(\mu, \sigma^2)$ sebagai parameter, atau bisa juga memilih $(\mu, \sigma)$ atau $(\frac{\mu}{\sigma^2}, -\frac{1}{2\sigma^2})$.
Inti dari geometri informasi terletak pada upayanya mengungkap “struktur geometri intrinsik yang dimiliki oleh keluarga distribusi probabilitas itu sendiri, yang tidak bergantung pada pemilihan sistem koordinat”. Shun-ichi Amari lebih memperdalam konsep “manifold Riemann dengan matriks informasi Fisher sebagai metrik” yang diajukan oleh C.R. Rao, dan dengan memperkenalkan konsep koneksi afin (Affine Connection), ia menemukan struktur yang kaya pada ruang distribusi probabilitas, tidak hanya berupa “kelengkungan (curvature)” tetapi juga “konsep garis lurus (geodesik)” dan “dualitas (duality)”.
Bab 2: Model Statistik sebagai Manifold Riemann
Untuk mendefinisikan “jarak” dan “sudut” pada manifold, diperlukan metrik Riemann (Riemannian Metric). Apa yang menjadi metrik Riemann natural pada manifold statistik?
Fungsi Skor dan Matriks Informasi Fisher
Dalam statistik, turunan parsial dari fungsi log-likelihood $\log p(x; \theta)$ terhadap parameternya disebut “fungsi skor (Score Function)”, yang memainkan peran penting.
$$ \partial_i \ell(x; \theta) = \frac{\partial}{\partial \theta^i} \log p(x; \theta) $$$$ E_\theta[\partial_i \ell(x; \theta)] = \int \frac{\partial p(x; \theta)}{\partial \theta^i} dx = \frac{\partial}{\partial \theta^i} \int p(x; \theta) dx = 0 $$$$ g_{ij}(\theta) = E_\theta \left[ \partial_i \ell(x; \theta) \partial_j \ell(x; \theta) \right] $$C.R. Rao (1945) memperhatikan bahwa matriks informasi Fisher ini adalah matriks simetris definit positif yang memenuhi aturan transformasi tensor, dan mengusulkan untuk mengadopsinya sebagai metrik Riemann (metrik Fisher) dari manifold statistik.
$$ ds^2 = \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$Dengan demikian, model statistik menjadi manifold Riemann $(S, G)$. “Kuadrat jarak” infinitesimal antara dua distribusi probabilitas yang berdekatan $p(x; \theta)$ dan $p(x; \theta + d\theta)$ diukur oleh metrik Fisher ini.
Teorema Chentsov sebagai Metrik Invarian
Mengapa matriks informasi Fisher harus dipilih sebagai metrik? Ini bukan sekadar ide sesaat, melainkan ada keniscayaan matematis yang dalam di baliknya.
N.N. Chentsov (1972) memformulasikan “invariansi (Invariance)” yang disyaratkan dalam kerangka inferensi statistik. Inferensi statistik tidak boleh berubah hasilnya karena cara representasi data atau transformasi ke statistik cukup (pemetaan Markov). Teorema Chentsov menunjukkan fakta mengejutkan bahwa “pada manifold yang terdiri dari distribusi probabilitas pada himpunan berhingga, metrik Riemann yang memenuhi monotonisitas (kontraktibilitas) di bawah pemetaan Markov, selain dari perkalian konstanta, terbatas hanya pada metrik informasi Fisher”.
Dengan kata lain, cara mengukur jarak yang memenuhi syarat statistik yang wajar bahwa “informasi tidak berkurang” dalam ruang distribusi probabilitas hanyalah metrik Fisher. Hal ini membuktikan bahwa metrik Fisher adalah struktur geometris intrinsik dan niscaya yang khas pada statistika.
Contoh Perhitungan Metrik Fisher pada Keluarga Distribusi Normal
$$ p(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) $$$$ \log p = -\log(\sqrt{2\pi}) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2} $$$$ \partial_\mu \log p = \frac{x-\mu}{\sigma^2}, \quad \partial_\sigma \log p = -\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3} $$$$ g_{\mu\mu} = E\left[ \left(\frac{x-\mu}{\sigma^2}\right)^2 \right] = \frac{1}{\sigma^2} $$$$ g_{\sigma\sigma} = E\left[ \left(-\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3}\right)^2 \right] = \frac{2}{\sigma^2} $$$$ g_{\mu\sigma} = g_{\sigma\mu} = 0 $$$$ ds^2 = \frac{1}{\sigma^2} d\mu^2 + \frac{2}{\sigma^2} d\sigma^2 $$Hal ini sepenuhnya identik (kecuali perbedaan pengali konstan) dengan metrik model geometri hiperbolik setengah bidang atas Poincaré yang diusulkan oleh Henri Poincaré (sejenis geometri non-Euclidean). Dengan kata lain, ruang distribusi normal adalah ruang hiperbolik dengan kelengkungan konstan negatif. Seperti intuisi kita sebelumnya, terbukti secara matematis bahwa pada daerah di mana $\sigma$ besar (varians besar), tensor metrik $1/\sigma^2$ menjadi kecil, sehingga perubahan parameter dievaluasi sebagai “jarak” yang kecil.
Bab 3: Kedalaman Koneksi Dual dan Koneksi $\alpha$
Hanya dengan metrik Riemann tidaklah cukup untuk mendeskripsikan secara utuh “kelengkungan” ruang. Diperlukan koneksi afin (Affine Connection) untuk menentukan “arah mana yang lurus”. Pencapaian terbesar Shun-ichi Amari terletak pada penemuannya bahwa pada manifold statistik terdapat tak terhingga banyaknya koneksi yang natural, dan mereka membentuk struktur yang indah yaitu “dualitas (Duality)”.
Definisi Koneksi $\alpha$
Amari memperkenalkan keluarga koneksi afin yang disebut koneksi $\alpha$, dengan menggunakan parameter bilangan real $\alpha$. Koefisien koneksinya $\Gamma_{ij,k}^{(\alpha)}$ didefinisikan sebagai berikut:
$$ \Gamma_{ij,k}^{(\alpha)} = E \left[ \left( \partial_i \partial_j \ell + \frac{1 - \alpha}{2} \partial_i \ell \partial_j \ell \right) \partial_k \ell \right] $$Koneksi-$0$ saat $\alpha = 0$ secara unik sesuai dengan koneksi Levi-Civita (Levi-Civita Connection) yang ditentukan dari metrik Fisher. Ini adalah koneksi yang digunakan dalam geometri Riemann biasa. Namun, yang memainkan peran paling penting dalam geometri informasi adalah koneksi $\alpha = 1$ dan $\alpha = -1$.
Koneksi-e dan Koneksi-m, serta Ruang Datar Dual
- Koneksi-e (Koneksi Eksponensial $\alpha = 1$): Koneksi yang muncul secara natural ketika berhadapan dengan keluarga eksponensial (Exponential Family).
- Koneksi-m (Koneksi Campuran $\alpha = -1$): Koneksi yang muncul secara natural ketika berhadapan dengan keluarga campuran (Mixture Family).
Kedua koneksi ini memiliki hubungan “dual (Dual)” terhadap metrik Fisher $g_{ij}$. Pada manifold Riemann, ketika turunan dari hasil kali dalam (metrik) dua medan vektor dapat dinyatakan sebagai jumlah turunan kovarian oleh masing-masing koneksi, mereka disebut koneksi dual.
$$ X \langle Y, Z \rangle = \langle \nabla_X^{(e)} Y, Z \rangle + \langle Y, \nabla_X^{(m)} Z \rangle $$Hal yang patut dicatat adalah fakta bahwa ruang keluarga eksponensial (seperti distribusi normal, distribusi Poisson, distribusi gamma, dll.) adalah “datar (tensor kelengkungan bernilai nol)” terhadap koneksi-e, dan secara bersamaan juga “datar” terhadap koneksi-m. Ruang semacam ini disebut ruang datar dual (Dually Flat Space).
Pada ruang datar dual, terdapat garis lurus terhadap koneksi-e (geodesik-e) dan garis lurus terhadap koneksi-m (geodesik-m). Lebih jauh lagi, pada ruang ini terdapat sistem koordinat dual (parameter natural $\theta$ dan parameter ekspektasi $\eta$) yang saling terhubung melalui transformasi Legendre (Legendre Transformation).
Teorema Pythagoras yang Diperumum
Keindahan ruang datar dual terkonsentrasi pada “Teorema Pythagoras yang Diperumum (Generalized Pythagorean Theorem)”.
Di ruang Euclidean, ketika 3 titik $P, Q, R$ membentuk segitiga siku-siku dengan $\angle PQR = 90^\circ$, maka berlaku $d(P, R)^2 = d(P, Q)^2 + d(Q, R)^2$. Pada ruang datar dual di geometri informasi, ketika kurva yang menghubungkan titik $P, Q, R$ (distribusi probabilitas) terdiri dari geodesik-e dan geodesik-m, dan mereka “tegak lurus” dalam arti metrik Fisher pada titik $Q$, maka persamaan berikut akan berlaku secara ketat terkait divergensi (konsep jarak asimetris) antar distribusi.
$$ D(P \parallel R) = D(P \parallel Q) + D(Q \parallel R) $$Teorema ini menjelaskan secara geometris dan sempurna kriteria jumlah informasi dalam statistik, konvergensi algoritma EM dalam pembelajaran mesin, dan teorema proyeksi (Information Projection), menjadikannya sebagai sebuah hasil yang monumental dari geometri informasi.
Bab 4: Divergensi dan Geometri Entropi
Jarak dalam geometri Riemann adalah simetris ($d(x, y) = d(y, x)$), tetapi ukuran “perbedaan” antara distribusi probabilitas dalam teori informasi pada umumnya bersifat asimetris. Geometri informasi menghubungkan dengan indah jarak asimetris yang disebut “divergensi (Divergence)” ini dengan struktur geometri ruang datar dual.
Kuantitas Informasi Kullback-Leibler (Divergensi KL)
$$ D_{KL}(P \parallel Q) = \int p(x) \log \frac{p(x)}{q(x)} dx $$Divergensi KL tidak memenuhi aksioma jarak (karena asimetris dan tidak memenuhi ketaksamaan segitiga). Namun, pada limit di mana titik $Q$ semakin mendekati titik $P$, suku orde kedua dari ekspansi Taylor dari divergensi KL sama persis dengan matriks informasi Fisher.
$$ D_{KL}(\theta \parallel \theta + d\theta) \approx \frac{1}{2} \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$Dengan kata lain, divergensi KL adalah jarak asimetris makroskopik, dan limit mikroskopiknya (jarak infinitesimal) menginduksi metrik Fisher (geometri Riemann).
Divergensi Bregman dan Transformasi Legendre
Dalam ruang datar dual, divergensi diformulasikan sebagai “divergensi Bregman (Bregman Divergence)” yang lebih umum. Pertimbangkan fungsi konveks $\psi(\theta)$ (berkaitan dengan fungsi pembangkit kumulan atau energi bebas). Divergensi Bregman $D_\psi(\theta_P \parallel \theta_Q)$ didefinisikan sebagai “kesalahan” antara bidang singgung dari fungsi konveks di titik $\theta_Q$ dan nilai fungsi konveks di titik $\theta_P$.
$$ D_\psi(\theta_P \parallel \theta_Q) = \psi(\theta_P) - \psi(\theta_Q) - \sum_i (\theta_P^i - \theta_Q^i) \frac{\partial \psi(\theta_Q)}{\partial \theta^i} $$$$ \eta_i = \frac{\partial \psi(\theta)}{\partial \theta^i}, \quad \phi(\eta) = \sum_i \theta^i \eta_i - \psi(\theta) $$Dalam geometri informasi, divergensi KL adalah divergensi Bregman itu sendiri pada keluarga eksponensial, dan dengan menggunakan parameter dual $\theta$ (parameter natural) dan $\eta$ (parameter ekspektasi), divergensi dapat diekspresikan dalam bentuk kanonik (Canonical form) yang sangat simetris dan indah menggunakan fungsi dual $\psi, \phi$.
$$ D(P \parallel Q) = \psi(\theta_P) + \phi(\eta_Q) - \sum_i \theta_P^i \eta_Q^i $$Persamaan ini menunjukkan dengan sangat jelas bahwa geometri informasi bukanlah sekadar aplikasi dari geometri diferensial, melainkan “geometri yang melekat pada teori informasi” yang sangat terkait erat dengan transformasi Legendre dan analisis konveks.
Bab 5: Pembelajaran Mendalam dan Metode Penurunan Gradien Natural
Geometri informasi tidak berhenti pada keindahan teoretisnya, tetapi juga menunjukkan kekuatan yang sangat praktis dalam AI modern, khususnya pada pembelajaran mendalam (deep learning). Contoh paling utamanya adalah “Metode Penurunan Gradien Natural (Natural Gradient Descent; NGD)”.
Keterbatasan Metode Penurunan Gradien Biasa
$$ w_{t+1} = w_t - \eta \nabla L(w_t) $$Namun, gradien biasa $\nabla L$ berasumsi bahwa ruang parameter adalah “ruang Euclidean yang datar”. Seperti yang kita lihat pada Bab 1, ruang parameter dari model probabilitas yang direpresentasikan oleh jaringan saraf adalah manifold Riemann yang melengkung oleh metrik Fisher. Gradien di ruang Euclidean (arah paling curam) tidak selalu searah dengan arah paling curam yang sebenarnya di manifold Riemann. Akibatnya, jejak pembelajaran sangat berubah tergantung pada skala parameter atau transformasi koordinat, sehingga sering terjadi fenomena “plateau (stagnasi pembelajaran)” di mana efisiensi optimasi menurun drastis.
Pembaruan Parameter Berdasarkan Metrik Fisher: Metode Gradien Natural
Pada tahun 1998, Shun-ichi Amari mengusulkan “gradien natural (Natural Gradient)” yang merupakan arah paling curam yang sebenarnya di atas manifold Riemann. Gradien pada manifold $\tilde{\nabla} L$ adalah hasil perkalian antara gradien biasa $\nabla L$ dengan invers dari matriks informasi Fisher $F^{-1}$.
$$ \tilde{\nabla} L(w) = F(w)^{-1} \nabla L(w) $$$$ w_{t+1} = w_t - \eta F(w_t)^{-1} \nabla L(w_t) $$Metode gradien natural merealisasikan pembelajaran invarian yang tidak bergantung pada cara pengambilan parameter (sistem koordinat) dengan memperhitungkan kelengkungan (matriks informasi Fisher) dari ruang parameter. Ini memungkinkan lintasan langsung menuju solusi optimal, bahkan di area yang melengkung tajam pada permukaan fungsi kerugian, sehingga kecepatan pembelajaran meningkat secara drastis. Hal ini mirip dengan metode optimasi orde kedua seperti metode Newton, namun dapat dikatakan sebagai metode yang optimal untuk model probabilitas karena ia menggunakan matriks informasi Fisher yang dijamin semidefinit positif sebagai ganti matriks Hessian.
Implementasi dan Terobosan Melalui Aproksimasi K-FAC
Secara teoretis, metode gradien natural sangat kuat, tetapi penerapannya pada pembelajaran mendalam menemui hambatan besar. Pada jaringan saraf modern yang memiliki puluhan juta hingga puluhan miliar parameter, menghitung matriks informasi Fisher raksasa $F$ (ukuran $N \times N$) dan kemudian mencari inversnya hampir mustahil (dengan kompleksitas waktu $O(N^3)$).
Masalah ini diselesaikan oleh metode yang diusulkan oleh James Martens dan Roger Grosse pada tahun 2015 yang dinamakan K-FAC (Kronecker-factored Approximate Curvature). Mereka menunjukkan bahwa matriks informasi Fisher dari parameter antar lapisan jaringan saraf dapat diaproksimasi dengan presisi yang baik menggunakan “produk Kronecker (Kronecker Product)” dari matriks kovarians input dan matriks kovarians dari gradien output.
$$ F_{layer} \approx A \otimes S $$(Di mana $A$ adalah kovarians dari nilai aktivasi, $S$ adalah kovarians dari gradien pra-aktivasi)
Dengan memanfaatkan sifat produk Kronecker $(A \otimes S)^{-1} = A^{-1} \otimes S^{-1}$, komputasi matriks invers yang besar dapat dipecah menjadi komputasi matriks invers yang jauh lebih kecil, dan berhasil memangkas biaya komputasi secara dramatis (dari $O(N^3)$ menjadi $O(n^3)$, di mana $n$ adalah lebar dari suatu lapisan). Dengan implementasi K-FAC, metode gradien natural dapat diaplikasikan dengan waktu komputasi yang realistis pada model pembelajaran mendalam berskala besar (seperti ResNet dan Transformer), serta telah terbukti menunjukkan konvergensi yang sangat cepat di dalam lingkungan komputasi terdistribusi (distributed learning). Ini adalah momen bersejarah saat geometri informasi mendobrak batasan AI.
Bab 6: Perluasan ke Fisika Statistik, Informasi Kuantum, dan Ilmu Saraf
Keserbagunaan geometri informasi tidak hanya terbatas pada statistik dan pembelajaran mesin. Akar pijakannya pada “geometri probabilitas dan informasi” telah berdampak kepada banyak disiplin ilmu.
Geometri Informasi Kuantum
Geometri informasi yang menangani distribusi probabilitas klasik diperluas secara natural ke Geometri Informasi Kuantum (Quantum Information Geometry) yang menangani “matriks kepadatan (Density Matrix)” dalam mekanika kuantum. Pada sistem kuantum, karena non-komutativitas dari observabilitas (operator yang bergantung pada urutannya), kuantitas yang ekuivalen dengan metrik Fisher tidak dapat ditetapkan secara unik. Sebagai gantinya, terdapat berbagai metrik Riemann, seperti metrik Bures (informasi SLD Fisher) dan metrik Kubo-Mori-Bogoliubov, yang masing-masingnya memiliki arti fisika dan informasional yang berbeda-beda. Geometri informasi kuantum berkembang pesat sebagai fondasi teori untuk komputasi kuantum dan telekomunikasi kuantum, misalnya pada batas akurasi estimasi keadaan kuantum (ketaksamaan kuantum Cramer-Rao), pengungkapan geometri dari keterikatan kuantum (entanglement), dan optimasi algoritma kuantum.
Prinsip Energi Bebas dan Ilmu Saraf (Pengkodean Prediktif)
Di bidang ilmu saraf otak, Prinsip Energi Bebas (Free Energy Principle; FEP) yang diusulkan oleh Karl Friston, berasumsi bahwa otak adalah sistem yang menyimpulkan persepsi dan tindakan sedemikian rupa untuk meminimalkan “kejutan (Surprise)”. Proses inferensi ini diformulasikan sebagai Variational Bayesian Inference, yang pada akhirnya diturunkan ke dalam masalah optimasi untuk meminimalkan divergensi KL (energi bebas variasi) antara distribusi probabilitas model internal otak dan distribusi sebenarnya dari lingkungan luar.
Dari sudut pandang geometri informasi, otak dapat diinterpretasikan sebagai sistem dinamik yang bergerak di sepanjang manifold distribusi probabilitas mengikuti gradien divergensi (yaitu gradien natural). Persepsi (pembaruan keadaan internal) dan tindakan (pengaruh ke lingkungan luar) dideskripsikan secara indah sebagai algoritma iteratif dari proyeksi-e dan proyeksi-m di dalam ruang datar dual. Geometri informasi memberikan bahasa matematis untuk mengungkap mekanisme mendasar dari inteligensi (kecerdasan).
Sebagai Garis Depan Matematika Modern
Dari sudut pandang matematika murni, geometri informasi juga memaparkan suatu paradigma yang baru. Kaitan yang erat dengan geometri diferensial afin, geometri Hesse, dan geometri simplektik perlahan mulai terungkap. Secara khusus, penyatuan antara Geometri Wasserstein (teori transpor optimal) dan geometri informasi menjadi salah satu topik penelitian terpanas di bidang matematika dan pembelajaran mesin saat ini. Divergensi KL (geometri informasi) mengukur pergerakan “informasi”, sedangkan jarak Wasserstein mengukur pergerakan “massa”. Upaya untuk menggabungkan dua geometri ini terhubung langsung dengan penjelasan teoretis untuk model generatif mendalam (seperti model difusi dan GAN).
Penutup: Bentuk Alam Semesta yang Ditenun oleh Informasi
Berangkat dari intuisi Shun-ichi Amari bahwa “model statistik itu mungkin melengkung”, Geometri Informasi kini telah tumbuh melampaui batas statistik, berkembang menjadi sebuah sistem teori epik yang mengaitkan pembelajaran mesin, fisika kuantum, dan ilmu saraf. Dengan memahami distribusi probabilitas bukan sekadar sebagai fungsi matematika melainkan sebagai sebuah “ruang” geometris, kita bisa memvisualisasikan dinamika dari informasi, lintasan pembelajaran, hingga makna sejati dari kecerdasan.
“Derajat kelengkungan informasi” yang diajarkan oleh metrik informasi Fisher. “Teorema Pythagoras yang Diperumum” yang dituntun oleh koneksi dual. Dan, “evolusi AI yang pesat” yang dibukakan jalannya oleh metode gradien natural.
Geometri Informasi akan terus menjadi “kompas” yang paling mutakhir, yang membimbing kita untuk melihat “konstelasi kebenaran” di antara “bintang-bintang data”. Eksplorasi pada manifold Riemann yang sangat indah dan dalam ini, sesungguhnya baru saja dimulai.