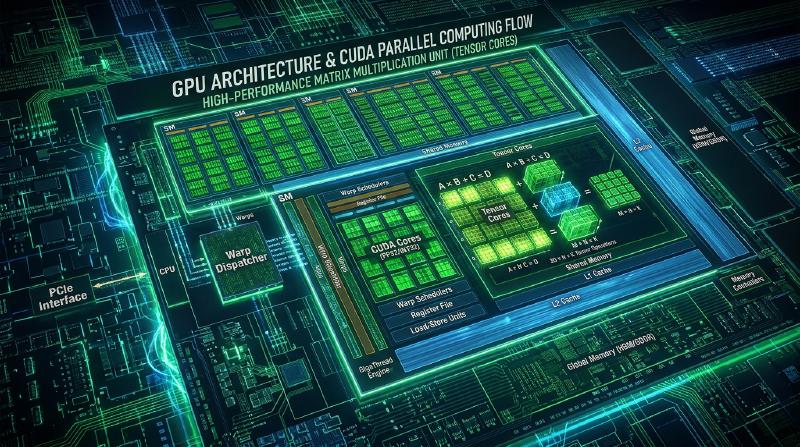
Arsitektur Paralel Masif GPU dan Fisika CUDA: Prinsip Komputasi SIMT, Warp, dan Tensor Core
Teknologi mendasar yang mendukung ilmu komputasi tingkat lanjut modern, kecerdasan buatan, pembelajaran mendalam (deep learning), dan grafik komputer definisi tinggi adalah GPU (Graphics Processing Unit). Dalam artikel ini, kita akan menggali lebih dalam aspek fisik dan perangkat keras dari arsitektur GPU dan CUDA (Compute Unified Device Architecture), platform komputasi paralel yang berjalan di atasnya. Bukan sekadar tata bahasa pemrograman, tetapi anatomi menyeluruh dari perangkat keras mengenai “mengapa dirancang seperti itu” dan “bagaimana ia mencapai throughput komputasi yang ekstrem” dari perspektif Streaming Multiprocessor (SM), model eksekusi SIMT, penjadwalan warp, tensor core, dan hierarki memori.
Bab 1: Titik Percabangan Filosofi Desain CPU dan GPU
1.1 Mengejar Latensi Rendah vs Mengejar Throughput Tinggi
CPU (Central Processing Unit), yang merupakan prosesor tujuan umum, dan GPU, yang dikhususkan untuk komputasi paralel, memiliki filosofi desain yang sangat berbeda sejak awal penciptaannya. CPU telah berevolusi dengan tujuan utama “latensi rendah (meminimalkan penundaan)” yaitu “seberapa cepat menyelesaikan satu tugas (utas/thread)”. Di sisi lain, GPU mengejar “throughput tinggi (memaksimalkan volume pemrosesan)”, yaitu “berapa banyak pemrosesan yang dapat diselesaikan per satuan waktu secara keseluruhan dengan menggabungkan tugas-tugas dalam jumlah besar”.
CPU harus dengan cepat menangani pemrosesan yang tidak dapat diprediksi, seperti mengendalikan sistem operasi, menjalankan aplikasi dengan kondisi percabangan yang kompleks, dan gangguan acak dari pengguna. Untuk alasan ini, CPU dilengkapi dengan sirkuit prediksi percabangan tingkat lanjut, eksekusi out-of-order (mekanisme yang mengeksekusi instruksi di luar urutan), dan cache memori L1/L2/L3 yang sangat besar untuk menyembunyikan penundaan akses memori sambil memaksimalkan kinerja utas tunggal secara ekstrem.
Sebaliknya, GPU pada awalnya diciptakan untuk memproses tugas-tugas yang sangat dapat diparalelkan, seperti menerapkan operasi bayangan yang sama ke jutaan piksel pada layar. Alih-alih mengalokasikan area die untuk sirkuit kontrol yang kompleks atau cache raksasa, GPU memilih untuk mengemas unit aritmatika (ALU: Arithmetic Logic Unit) sederhana hingga batas maksimum.
1.2 Rasio Alokasi Cache, Sirkuit Kontrol, dan ALU pada Area Die
Bagaimana mengalokasikan area terbatas (anggaran transistor) dari die silikon (chip semikonduktor) sangat menentukan perbedaan arsitektur di antara keduanya.
- Alokasi Area Die CPU: Lebih dari setengah die ditempati oleh memori cache berkapasitas besar (SRAM) dan sirkuit kontrol tingkat lanjut (prediksi percabangan, pengambilan instruksi, dekode, penjadwalan, dll.). Proporsi yang ditempati oleh ALU yang melakukan operasi aktual relatif kecil.
- Alokasi Area Die GPU: Memori cache dan sirkuit kontrol dijaga seminimal mungkin yang diperlukan, dan sebagian besar die ditempati oleh ALU (CUDA core) yang jumlahnya mencapai ribuan hingga puluhan ribu.
GPU tidak menyembunyikan penundaan (latensi) akses memori dengan cache, melainkan menyembunyikannya melalui “context switching”. Ketika sekelompok utas menunggu data tiba dari memori, GPU segera mengeksekusi operasi dari kelompok utas lain, sehingga unit operasi tetap beroperasi (tingkat hunian/occupancy tinggi). Inilah implementasi fisik dari “pengejaran throughput tinggi” pada GPU. Karena multithreading tingkat perangkat keras (Hardware Multithreading) dilakukan dengan sangat ringan, diasumsikan ada ribuan hingga puluhan ribu utas paralel.
Bab 2: Esensi Model Eksekusi SIMT
2.1 Perbedaan Antara SIMD dan SIMT
Sebagai klasifikasi pemrosesan paralel, ada Taksonomi Flynn (Flynn’s taxonomy), dan model eksekusi GPU sering dibandingkan dengan SIMD (Single Instruction, Multiple Data). Instruksi ekstensi vektor CPU (seperti AVX) adalah SIMD murni, yang memproses beberapa data secara bersamaan dengan satu instruksi (misalnya, delapan bilangan floating-point 32-bit yang disimpan dalam register 256-bit). Dalam SIMD, sangat sulit untuk melakukan percabangan yang berbeda (if-else) untuk setiap elemen data.
Di sisi lain, model eksekusi CUDA yang diusulkan oleh NVIDIA disebut SIMT (Single Instruction, Multiple Threads). Dalam SIMT, beberapa “utas” independen membentuk sebuah grup (disebut “warp”, yang akan dibahas nanti) dan berbagi serta mengeksekusi instruksi yang sama. Namun, tidak seperti SIMD, setiap utas dalam SIMT memiliki status register independen dan penghitung alamat instruksi (pada model pemrograman). Hal ini memungkinkan programmer untuk menulis kode seolah-olah setiap utas beroperasi secara independen.
2.2 “Warp” dalam Unit 32 Utas
Perangkat keras GPU tidak menjadwalkan utas secara individual, melainkan mengelola dan mengeksekusinya dalam satuan yang disebut “Warp”, yaitu pengelompokan 32 utas (Pada GPU AMD disebut Wavefront, dan terkadang menggunakan satuan 64 utas).
Unit pengambilan dan dekode instruksi di dalam Streaming Multiprocessor (SM) mengambil satu instruksi per warp dan menerbitkan (dispatch) instruksi yang sama ke semua 32 utas dalam warp tersebut. Artinya, 32 utas dalam sebuah warp, secara fisik pada saat yang persis bersamaan, mengeksekusi instruksi yang sama terhadap data berbeda yang mereka miliki. Inilah inti dari SIMT.
2.3 Penalti Fisik dari Warp Divergence (Ketidaksesuaian Percabangan)
Meskipun setiap utas dapat bertindak seolah-olah memiliki penghitung program yang independen, secara fisik semua utas dalam sebuah warp harus mengeksekusi instruksi yang sama. Lalu, apa yang terjadi jika ada percabangan kondisional seperti if-else di dalam kode, dan kebenaran kondisi percabangan berbeda di antara utas-utas di dalam warp?
Fenomena ini disebut Warp Divergence (Ketidaksesuaian Percabangan).
Ketika warp divergence terjadi, perangkat keras akan melakukan pemrosesan dalam langkah-langkah berikut:
- Pertama, instruksi hanya dieksekusi untuk utas yang kondisi
if-nya bernilai benar (utas aktif). Pada saat ini, utas yang kondisinya bernilai salah akan “ditutupi (di-mask/dinonaktifkan)”, dan hasil operasi tidak akan ditulis. - Selanjutnya, beralih ke jalur kondisi
else(atau jalur jika kondisinya salah), dan kali ini utas yang sebelumnya ditutupi menjadi aktif, sementara utas yang tadinya benar akan ditutupi, lalu instruksi dieksekusi.
Dengan kata lain, ketika ada beberapa jalur percabangan, perangkat keras terpaksa mengeksekusi jalur-jalur tersebut secara serial (berurutan) alih-alih paralel. Sebagai contoh ekstrem, jika 32 utas dalam sebuah warp mengambil 32 jalur percabangan yang berbeda, waktu eksekusi akan melonjak 32 kali lipat. Warp divergence adalah salah satu faktor terbesar yang secara drastis mengurangi throughput komputasi GPU, dan ini adalah anti-pola yang paling harus dihindari dalam desain algoritma. Secara fisik, ini berarti meskipun ALU mengkonsumsi daya, mereka menghasilkan “siklus sia-sia” yang tidak membuahkan hasil perhitungan valid karena mereka ditutupi.
Bab 3: Anatomi Perangkat Keras Streaming Multiprocessor (SM)
GPU dikonfigurasi sebagai kumpulan dari banyak Streaming Multiprocessor (SM). SM adalah mesin komputasi GPU yang sebenarnya. Dalam arsitektur terbaru (misalnya Hopper H100), lebih dari 100 SM disematkan pada satu die GPU.
3.1 Konfigurasi Pipeline Internal SM
SM selanjutnya dibagi secara internal ke dalam beberapa sub-partisi (biasanya empat), yang masing-masing memiliki penjadwal warp dan unit dispatch independen.
- Penjadwal Warp (Warp Scheduler): Memilih warp yang berada dalam keadaan siap dieksekusi (keadaan di mana register dan memori sudah siap). Penjadwal GPU dapat beralih antar warp dengan zero overhead, dan ini adalah kunci untuk menyembunyikan latensi akses memori.
- Unit Dispatch (Dispatch Unit): Menerbitkan instruksi ke warp yang telah dijadwalkan.
- CUDA Core (INT32 / FP32 / FP64 ALU): Unit yang melakukan operasi bilangan bulat aktual dan operasi floating-point.
- Unit Load/Store (LD/ST Unit): Bertanggung jawab untuk membaca dari dan menulis ke memori.
- Special Function Unit (SFU): Perangkat keras khusus yang dengan cepat menghitung fungsi transenden seperti sin, cos, exp, dan nilai kebalikan.
Pipeline instruksi dirancang sangat dalam, memiliki tahapan fetch, decode, scheduling, register read, execution (beberapa siklus), dan write-back. Latensi operasi FMA (Fused Multiply-Add) FP32 biasanya memakan waktu beberapa hingga belasan siklus, tetapi dengan menerbitkan instruksi dari warp yang berbeda setiap siklus, pipeline selalu dipertahankan dalam keadaan penuh.
3.2 File Register Raksasa dan Register Pressure
SM dilengkapi dengan file register yang sangat besar dan tidak bisa dibandingkan dengan CPU (misalnya: SRAM 64KB hingga 256KB per SM). Hal ini ditujukan untuk menampung semua konteks dari ribuan utas yang dieksekusi secara bersamaan pada SM.
Context switch dapat diselesaikan dalam nol siklus karena tidak perlu memindahkan (spill) status register utas ke memori. Namun, saat jumlah register yang digunakan per utas meningkat, jumlah warp yang dapat diluncurkan secara bersamaan di SM (occupancy) akan menurun. Ini disebut Register Pressure (Tekanan Register). Ketika register habis, data akan di-spill ke memori lokal berkecepatan rendah (secara fisik merupakan bagian dari memori global), yang menyebabkan penurunan kinerja yang sangat merugikan.
3.3 Memori Bersama (Shared Memory) dan Konflik Bank
Di dalam SM, terdapat memori on-chip super cepat yang secara eksplisit dapat dikendalikan oleh programmer, yaitu Memori Bersama (Shared Memory). Memori ini berbagi area fisik SRAM yang sama dengan cache L1, tetapi berfungsi sebagai cache data eksplisit dan digunakan untuk berbagi data serta sinkronisasi di antara utas-utas dalam sebuah blok.
Struktur fisik memori bersama dibagi menjadi beberapa modul independen (biasanya 32) yang disebut Bank Memori (Memory Banks). Alamat 32-bit yang berurutan akan di-interleave (dialokasikan) ke bank yang berbeda.
Ketika 32 utas dalam sebuah warp mengakses bank yang berbeda secara bersamaan, akses diproses sepenuhnya secara paralel (dalam 1 siklus). Ini disebut bebas konflik bank (bank conflict-free). Namun, jika beberapa utas mencoba mengakses alamat yang berbeda di bank yang sama pada waktu bersamaan, permintaan tersebut akan diserialisasi, sehingga menimbulkan penalti (penundaan). Ini disebut Konflik Bank (Bank Conflict). Misalnya, konflik bank 2-jalur akan menggandakan waktu akses, dan dalam kasus terburuk, konflik 32-jalur akan menunda waktu hingga 32 kali lipat. Dalam algoritma seperti transpos matriks, konflik bank yang parah terjadi karena akses berjarak (stride access), sehingga optimasi tingkat lanjut yang menghindari konflik dengan menggunakan padding (teknik menyisipkan data dummy untuk menggeser alamat memori) menjadi sangat penting.
Bab 4: Pipeline Operasi Perkalian-Penjumlahan Tensor Core
Perangkat keras revolusioner yang pertama kali diperkenalkan pada arsitektur Volta dan kemudian secara dramatis meningkatkan performa GPU adalah Tensor Core. Perkembangan eksplosif dalam AI dan deep learning tidak akan mungkin terjadi tanpa Tensor Core.
4.1 Implementasi Perangkat Keras dari Matrix Multiply-Accumulate (MMA)
Sebagian besar perhitungan dalam deep learning adalah perkalian matriks (GEMM: General Matrix Multiply) antara matriks bobot jaringan saraf dan data masukan. Rumus perhitungannya dinyatakan sebagai $D = A \times B + C$ (di mana $A, B$ adalah matriks masukan, dan $C$ adalah matriks akumulator).
Pada CUDA core konvensional, perkalian matriks ini dihitung satu elemen pada satu waktu menggunakan instruksi FMA (Fused Multiply-Add). Sebaliknya, Tensor Core adalah sirkuit khusus yang mengeksekusi operasi perkalian-penjumlahan dari matriks kecil (misalnya 4x4 atau 16x16) pada tingkat perangkat keras dalam 1 siklus (atau beberapa siklus).
Secara fisik, puluhan hingga ratusan multiplier dan pohon penjumlahan raksasa dihubungkan secara langsung dengan kabel, menyelesaikan perkalian-penjumlahan sekaligus tanpa harus menulis ulang hasil antara ke register. Hal ini menghasilkan throughput komputasi (TFLOPS) per area yang jauh lebih tinggi dibandingkan dengan CUDA core biasa.
4.2 Rahasia Presisi Campuran (Mixed-Precision)
Esensi lain dari Tensor Core adalah dukungannya terhadap operasi Mixed-Precision (Presisi Campuran). Dalam deep learning, ada banyak situasi selama proses perhitungan di mana presisi tinggi (FP32/FP64) tidak diperlukan. Tensor Core memiliki pipeline di mana matriks masukan $A$ dan $B$ dibaca dalam presisi rendah (FP16, BF16, atau presisi lebih rendah lagi seperti FP8, INT8, INT4), perkalian internal dilakukan dalam presisi rendah, dan kemudian proses penjumlahan (akumulasi) dilakukan dalam presisi yang lebih tinggi (FP32 atau INT32).
- FP16 / BF16: Standar untuk pelatihan. BF16 (Bfloat16) memiliki bagian eksponen 8-bit yang sama dengan FP32, dan jangkauan dinamisnya yang luas membuatnya lebih mudah untuk mencegah hilangnya gradien.
- FP8 / INT8 / INT4: Kunci percepatan untuk Inferensi (Inference). Karena volume transfer data (bandwidth memori) juga berkurang, throughput meningkat secara dramatis.
Pada arsitektur Hopper, “FP8 Tensor Core” diperkenalkan, yang secara dramatis mempercepat perhitungan model Transformer dan secara teoritis mencapai throughput puluhan kali lipat dibandingkan dengan FP32. Dari sisi perangkat lunak (CUDA), Tensor Core dikendalikan secara langsung melalui API wmma (Warp-Level Matrix Multiply and Accumulate) atau instruksi PTX mma.sync, melakukan pemrosesan kolektif yang sangat kompleks di mana utas dalam sebuah warp berkoordinasi untuk memuat potongan matriks ke dalam register, menghitung, dan menyimpannya.
Bab 5: Hierarki Memori CUDA dan Teknik Optimasi
Sebesar apa pun kemampuan komputasi GPU, kinerjanya tidak akan maksimal jika pasokan data menjadi hambatan (masalah memory wall). Tidaklah berlebihan untuk mengatakan bahwa 90% optimasi dalam pemrograman CUDA adalah “optimasi akses memori”.
5.1 Akses Coalescing ke Memori Global
Memori global, yang merupakan memori utama GPU (HBM atau GDDR), memiliki bandwidth yang sangat lebar (misalnya beberapa TB/s), tetapi latensinya juga sangat besar, mencapai ratusan siklus.
Prinsip mutlak untuk memaksimalkan efisiensi akses ke memori global adalah Coalescing (Penggabungan). Pengontrol memori GPU mengakses memori dalam transaksi unit 32-byte, 64-byte, atau 128-byte. Saat 32 utas dalam warp mengakses memori, jika alamat memori mereka berada dalam area yang berdampingan (dalam batas 128-byte yang diselaraskan), perangkat keras akan menggabungkan (coalesce) permintaan ini menjadi satu transaksi memori untuk diproses.
Sebaliknya, jika utas mengakses alamat secara acak, atau melakukan akses berjarak (stride), penggabungan tidak akan terjadi, dan banyak transaksi akan dihasilkan. Hal ini disebut “akses non-coalesced”, sebuah bug performa fatal yang dapat mengurangi bandwidth memori efektif menjadi kurang dari sepersepuluh.
5.2 Contoh Kode C++ CUDA: Optimasi Transpos Matriks dan Memori Bersama
Berikut adalah contoh kode kernel yang dioptimalkan untuk transpos matriks (Matrix Transpose), yang menghindari akses non-coalesced dan memanfaatkan memori bersama untuk meningkatkan performa secara dramatis.
| |
Ada 3 poin penting dalam kode ini:
- Coalescing saat membaca: Membaca dari
idatadilakukan dalam arah X yang berkelanjutan padathreadIdx.x, sehingga di-coalesce secara sempurna. - Coalescing saat menulis: Menulis ke
odatajuga dirancang agar berkesinambungan pada arahthreadIdx.xdengan menukar koordinat blok, sehingga di-coalesce. - Padding di memori bersama: Dengan menggeser 1 elemen (
tile[TILE_DIM][TILE_DIM + 1]), konflik bank yang terjadi saat mengakses kolom secara searah (tile[threadIdx.x][threadIdx.y + j]) pada saat penulisan dapat dihilangkan sepenuhnya.
5.3 Hierarki Cache dan Memori Khusus
- Kebijakan Cache L1/L2: Dalam arsitektur GPU terbaru, programmer dapat mengendalikan perilaku cache sebagai petunjuk menggunakan instruksi PTX (seperti
.ca,.cg,.cs). Misalnya, data yang hanya akan diakses sekali dapat mem-bypass cache L2 (streaming access) untuk mencegah polusi cache. - Memori Tekstur / Memori Konstanta: Memori tekstur yang dikhususkan untuk pemrosesan gambar memanfaatkan cache khusus untuk akses yang memiliki lokalitas spasial 2D. Memori konstanta memiliki efisiensi yang sangat tinggi untuk akses broadcast di mana semua utas membaca konstanta yang sama.
Bab 6: Masa Depan GPU di Era Deep Learning
Bukan hanya peningkatan performa dari satu GPU tunggal, tetapi penskalaan keseluruhan sistem kini menjadi garda terdepan dari ilmu komputasi.
6.1 Interkoneksi Berkecepatan Ultra dengan NVLink dan NVSwitch
LLM (Large Language Model) yang masif tidak akan muat di dalam memori satu GPU (misalnya 80GB atau 144GB). Untuk melakukan paralelisasi model (tensor parallel atau pipeline parallel), data dalam skala terabyte perlu dipertukarkan antar GPU setiap detiknya. Karena bus PCIe (PCI Express) konvensional tidak dapat memenuhi kebutuhan bandwidth ini, NVIDIA mengembangkan interkonek berkecepatan tinggi eksklusif yang disebut NVLink. Lebih lanjut, melalui chip sakelar yang disebut NVSwitch, dimungkinkan untuk menggabungkan 8 hingga 256 GPU menggunakan sakelar crossbar non-blocking yang utuh, membangun sebuah kluster yang bertindak seolah-olah merupakan satu GPU raksasa.
6.2 Ekosistem Transformer Engine dan FP8
Untuk mengoptimalkan arsitektur Transformer yang telah menjadi standar de facto tidak hanya dalam pemrosesan bahasa alami tetapi juga pengenalan gambar dan suara, arsitektur Hopper dilengkapi dengan mekanisme kolaborasi perangkat keras dan lunak khusus yang disebut Transformer Engine. Sistem ini secara dinamis memantau informasi statistik tensor dan secara otomatis mengubah presisi perhitungan antara FP8 dan FP16 lapis demi lapis (Dynamic Scaling), mewujudkan kecepatan perhitungan ekstrem dan penghematan bandwidth memori sambil mencegah degradasi presisi.
6.3 Hukum Penskalaan Kluster GPU dan Prospek Masa Depan
Seperti yang ditunjukkan oleh “Scaling Laws (Hukum Penskalaan)” OpenAI, semakin banyak parameter model dan volume perhitungan yang ditambahkan, kinerja AI akan terus meningkat. Sejalan dengan ini, GPU telah berevolusi dari sekadar prosesor menjadi kluster puluhan ribu unit yang terhubung oleh serat optik, menjadikan “pusat data itu sendiri sebagai sebuah GPU raksasa (superkomputer)”.
Evolusi arsitektur ke depannya kemungkinan akan mengarah ke adopsi fotonik silikon (interkonek optik), CPO (Co-Packaged Optics), dan peningkatan lebih lanjut pada teknologi penumpukan 3D dari SRAM ke HBM. Namun, “memaksimalkan throughput melalui pemrosesan paralel”, yang merupakan DNA GPU sejak awal kelahirannya, akan terus membuka jalan bagi garis depan ilmu komputasi.
[Analisis Tambahan] Analisis Matematis Penjadwalan dan Occupancy pada GPU
title: “Arsitektur Paralel Masif Prosesor Komputasi Grafis dan Fisika CUDA: Prinsip Komputasi SIMT, Warp, dan Tensor Core” description: “Desain internal prosesor komputasi grafis yang mengejar throughput tinggi secara ekstrem. Esensi dari SM, penjadwalan warp, tensor core, dan optimasi memori bersama.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
Arsitektur Paralel Masif Prosesor Komputasi Grafis dan Fisika CUDA: Prinsip Komputasi SIMT, Warp, dan Tensor Core
Teknologi mendasar yang mendukung ilmu komputasi tingkat lanjut modern, kecerdasan buatan, pembelajaran mendalam (deep learning), dan grafik komputer definisi tinggi adalah Prosesor Komputasi Grafis (Graphics Processing Unit). Dalam artikel ini, kita akan menggali lebih dalam aspek fisik dan perangkat keras dari arsitektur prosesor komputasi grafis dan CUDA (Compute Unified Device Architecture), platform komputasi paralel yang berjalan di atasnya. Bukan sekadar tata bahasa pemrograman, tetapi anatomi menyeluruh dari perangkat keras mengenai “mengapa dirancang seperti itu” dan “bagaimana ia mencapai throughput komputasi yang ekstrem” dari perspektif Streaming Multiprocessor (SM), model eksekusi SIMT, penjadwalan warp, tensor core, dan hierarki memori.
Suplemen Tambahan Bab 1: Titik Percabangan Filosofi Desain Prosesor Komputasi Tujuan Umum dan Prosesor Komputasi Grafis
1.1 Mengejar Latensi Rendah vs Mengejar Throughput Tinggi
Prosesor komputasi tujuan umum (Central Processing Unit) dan prosesor komputasi grafis, yang dikhususkan untuk komputasi paralel, memiliki filosofi desain yang sangat berbeda sejak awal penciptaannya. Prosesor komputasi tujuan umum telah berevolusi dengan tujuan utama “latensi rendah (meminimalkan penundaan)” yaitu “seberapa cepat menyelesaikan satu tugas (utas)”. Di sisi lain, prosesor komputasi grafis mengejar “throughput tinggi (memaksimalkan volume pemrosesan)”, yaitu “berapa banyak pemrosesan yang dapat diselesaikan per satuan waktu secara keseluruhan dengan menggabungkan tugas-tugas dalam jumlah besar”.
Prosesor komputasi tujuan umum harus dengan cepat menangani pemrosesan yang tidak dapat diprediksi, seperti mengendalikan sistem operasi, menjalankan aplikasi dengan kondisi percabangan yang kompleks, dan gangguan acak dari pengguna. Untuk alasan ini, ia dilengkapi dengan sirkuit prediksi percabangan tingkat lanjut, eksekusi out-of-order (mekanisme yang mengeksekusi instruksi di luar urutan), dan cache memori L1/L2/L3 yang sangat besar untuk menyembunyikan penundaan akses memori sambil memaksimalkan kinerja utas tunggal secara ekstrem.
Sebaliknya, prosesor komputasi grafis pada awalnya diciptakan untuk memproses tugas-tugas yang sangat dapat diparalelkan, seperti menerapkan operasi bayangan yang sama ke jutaan piksel pada layar. Alih-alih mengalokasikan area die untuk sirkuit kontrol yang kompleks atau cache raksasa, ia memilih untuk mengemas unit aritmatika (ALU: Arithmetic Logic Unit) sederhana hingga batas maksimum.
1.2 Rasio Alokasi Cache, Sirkuit Kontrol, dan ALU pada Area Die
Bagaimana mengalokasikan area terbatas (anggaran transistor) dari die silikon (chip semikonduktor) sangat menentukan perbedaan arsitektur di antara keduanya.
- Alokasi Area Die Prosesor Komputasi Tujuan Umum: Lebih dari setengah die ditempati oleh memori cache berkapasitas besar (SRAM) dan sirkuit kontrol tingkat lanjut (prediksi percabangan, pengambilan instruksi, dekode, penjadwalan, dll.). Proporsi yang ditempati oleh ALU yang melakukan operasi aktual relatif kecil.
- Alokasi Area Die Prosesor Komputasi Grafis: Memori cache dan sirkuit kontrol dijaga seminimal mungkin yang diperlukan, dan sebagian besar die ditempati oleh ALU (CUDA core) yang jumlahnya mencapai ribuan hingga puluhan ribu.
Prosesor komputasi grafis tidak menyembunyikan penundaan (latensi) akses memori dengan cache, melainkan menyembunyikannya melalui “context switching”. Ketika sekelompok utas menunggu data tiba dari memori, perangkat ini segera mengeksekusi operasi dari kelompok utas lain, sehingga unit operasi tetap beroperasi (tingkat hunian/occupancy tinggi). Inilah implementasi fisik dari “pengejaran throughput tinggi” pada prosesor komputasi grafis. Karena multithreading tingkat perangkat keras (Hardware Multithreading) dilakukan dengan sangat ringan, diasumsikan ada ribuan hingga puluhan ribu utas paralel.
Suplemen Tambahan Bab 2: Esensi Model Eksekusi SIMT
2.1 Perbedaan Antara SIMD dan SIMT
Sebagai klasifikasi pemrosesan paralel, ada Taksonomi Flynn (Flynn’s taxonomy), dan model eksekusi prosesor komputasi grafis sering dibandingkan dengan SIMD (Single Instruction, Multiple Data). Instruksi ekstensi vektor prosesor komputasi tujuan umum (seperti AVX) adalah SIMD murni, yang memproses beberapa data secara bersamaan dengan satu instruksi (misalnya, delapan bilangan floating-point 32-bit yang disimpan dalam register 256-bit). Dalam SIMD, sangat sulit untuk melakukan percabangan yang berbeda (if-else) untuk setiap elemen data.
Di sisi lain, model eksekusi CUDA yang diusulkan oleh NVIDIA disebut SIMT (Single Instruction, Multiple Threads). Dalam SIMT, beberapa “utas” independen membentuk sebuah grup (disebut “warp”, yang akan dibahas nanti) dan berbagi serta mengeksekusi instruksi yang sama. Namun, tidak seperti SIMD, setiap utas dalam SIMT memiliki status register independen dan penghitung alamat instruksi (pada model pemrograman). Hal ini memungkinkan programmer untuk menulis kode seolah-olah setiap utas beroperasi secara independen.
2.2 “Warp” dalam Unit 32 Utas
Perangkat keras prosesor komputasi grafis tidak menjadwalkan utas secara individual, melainkan mengelola dan mengeksekusinya dalam satuan yang disebut “Warp”, yaitu pengelompokan 32 utas (Pada prosesor komputasi grafis AMD disebut Wavefront, dan terkadang menggunakan satuan 64 utas).
Unit pengambilan dan dekode instruksi di dalam Streaming Multiprocessor (SM) mengambil satu instruksi per warp dan menerbitkan (dispatch) instruksi yang sama ke semua 32 utas dalam warp tersebut. Artinya, 32 utas dalam sebuah warp, secara fisik pada saat yang persis bersamaan, mengeksekusi instruksi yang sama terhadap data berbeda yang mereka miliki. Inilah inti dari SIMT.
2.3 Penalti Fisik dari Warp Divergence (Ketidaksesuaian Percabangan)
Meskipun setiap utas dapat bertindak seolah-olah memiliki penghitung program yang independen, secara fisik semua utas dalam sebuah warp harus mengeksekusi instruksi yang sama. Lalu, apa yang terjadi jika ada percabangan kondisional seperti if-else di dalam kode, dan kebenaran kondisi percabangan berbeda di antara utas-utas di dalam warp?
Fenomena ini disebut Warp Divergence (Ketidaksesuaian Percabangan).
Ketika warp divergence terjadi, perangkat keras akan melakukan pemrosesan dalam langkah-langkah berikut:
- Pertama, instruksi hanya dieksekusi untuk utas yang kondisi
if-nya bernilai benar (utas aktif). Pada saat ini, utas yang kondisinya bernilai salah akan “ditutupi (di-mask/dinonaktifkan)”, dan hasil operasi tidak akan ditulis. - Selanjutnya, beralih ke jalur kondisi
else(atau jalur jika kondisinya salah), dan kali ini utas yang sebelumnya ditutupi menjadi aktif, sementara utas yang tadinya benar akan ditutupi, lalu instruksi dieksekusi.
Dengan kata lain, ketika ada beberapa jalur percabangan, perangkat keras terpaksa mengeksekusi jalur-jalur tersebut secara serial (berurutan) alih-alih paralel. Sebagai contoh ekstrem, jika 32 utas dalam sebuah warp mengambil 32 jalur percabangan yang berbeda, waktu eksekusi akan melonjak 32 kali lipat. Warp divergence adalah salah satu faktor terbesar yang secara drastis mengurangi throughput komputasi prosesor komputasi grafis, dan ini adalah anti-pola yang paling harus dihindari dalam desain algoritma. Secara fisik, ini berarti meskipun ALU mengkonsumsi daya, mereka menghasilkan “siklus sia-sia” yang tidak membuahkan hasil perhitungan valid karena mereka ditutupi.
Suplemen Tambahan Bab 3: Anatomi Perangkat Keras Streaming Multiprocessor (SM)
Prosesor komputasi grafis dikonfigurasi sebagai kumpulan dari banyak Streaming Multiprocessor (SM). SM adalah mesin komputasi yang sebenarnya. Dalam arsitektur terbaru (misalnya Hopper H100), lebih dari 100 SM disematkan pada satu die prosesor komputasi grafis.
3.1 Konfigurasi Pipeline Internal SM
SM selanjutnya dibagi secara internal ke dalam beberapa sub-partisi (biasanya empat), yang masing-masing memiliki penjadwal warp dan unit dispatch independen.
- Penjadwal Warp (Warp Scheduler): Memilih warp yang berada dalam keadaan siap dieksekusi (keadaan di mana register dan memori sudah siap). Penjadwal prosesor komputasi grafis dapat beralih antar warp dengan zero overhead, dan ini adalah kunci untuk menyembunyikan latensi akses memori.
- Unit Dispatch (Dispatch Unit): Menerbitkan instruksi ke warp yang telah dijadwalkan.
- CUDA Core (INT32 / FP32 / FP64 ALU): Unit yang melakukan operasi bilangan bulat aktual dan operasi floating-point.
- Unit Load/Store (LD/ST Unit): Bertanggung jawab untuk membaca dari dan menulis ke memori.
- Special Function Unit (SFU): Perangkat keras khusus yang dengan cepat menghitung fungsi transenden seperti sin, cos, exp, dan nilai kebalikan.
Pipeline instruksi dirancang sangat dalam, memiliki tahapan fetch, decode, scheduling, register read, execution (beberapa siklus), dan write-back. Latensi operasi FMA (Fused Multiply-Add) FP32 biasanya memakan waktu beberapa hingga belasan siklus, tetapi dengan menerbitkan instruksi dari warp yang berbeda setiap siklus, pipeline selalu dipertahankan dalam keadaan penuh.
3.2 File Register Raksasa dan Register Pressure
SM dilengkapi dengan file register yang sangat besar dan tidak bisa dibandingkan dengan prosesor komputasi tujuan umum (misalnya: SRAM 64KB hingga 256KB per SM). Hal ini ditujukan untuk menampung semua konteks dari ribuan utas yang dieksekusi secara bersamaan pada SM.
Context switch dapat diselesaikan dalam nol siklus karena tidak perlu memindahkan (spill) status register utas ke memori. Namun, saat jumlah register yang digunakan per utas meningkat, jumlah warp yang dapat diluncurkan secara bersamaan di SM (occupancy) akan menurun. Ini disebut Register Pressure (Tekanan Register). Ketika register habis, data akan di-spill ke memori lokal berkecepatan rendah (secara fisik merupakan bagian dari memori global), yang menyebabkan penurunan kinerja yang sangat merugikan.
3.3 Memori Bersama (Shared Memory) dan Konflik Bank
Di dalam SM, terdapat memori on-chip super cepat yang secara eksplisit dapat dikendalikan oleh programmer, yaitu Memori Bersama (Shared Memory). Memori ini berbagi area fisik SRAM yang sama dengan cache L1, tetapi berfungsi sebagai cache data eksplisit dan digunakan untuk berbagi data serta sinkronisasi di antara utas-utas dalam sebuah blok.
Struktur fisik memori bersama dibagi menjadi beberapa modul independen (biasanya 32) yang disebut Bank Memori (Memory Banks). Alamat 32-bit yang berurutan akan di-interleave (dialokasikan) ke bank yang berbeda.
Ketika 32 utas dalam sebuah warp mengakses bank yang berbeda secara bersamaan, akses diproses sepenuhnya secara paralel (dalam 1 siklus). Ini disebut bebas konflik bank (bank conflict-free). Namun, jika beberapa utas mencoba mengakses alamat yang berbeda di bank yang sama pada waktu bersamaan, permintaan tersebut akan diserialisasi, sehingga menimbulkan penalti (penundaan). Ini disebut Konflik Bank (Bank Conflict). Misalnya, konflik bank 2-jalur akan menggandakan waktu akses, dan dalam kasus terburuk, konflik 32-jalur akan menunda waktu hingga 32 kali lipat. Dalam algoritma seperti transpos matriks, konflik bank yang parah terjadi karena akses berjarak (stride access), sehingga optimasi tingkat lanjut yang menghindari konflik dengan menggunakan padding (teknik menyisipkan data dummy untuk menggeser alamat memori) menjadi sangat penting.
Suplemen Tambahan Bab 4: Pipeline Operasi Perkalian-Penjumlahan Tensor Core
Perangkat keras revolusioner yang pertama kali diperkenalkan pada arsitektur Volta dan kemudian secara dramatis meningkatkan performa prosesor komputasi grafis adalah Tensor Core. Perkembangan eksplosif dalam AI dan deep learning tidak akan mungkin terjadi tanpa Tensor Core.
4.1 Implementasi Perangkat Keras dari Matrix Multiply-Accumulate (MMA)
Sebagian besar perhitungan dalam deep learning adalah perkalian matriks (GEMM: General Matrix Multiply) antara matriks bobot jaringan saraf dan data masukan. Rumus perhitungannya dinyatakan sebagai $D = A \times B + C$ (di mana $A, B$ adalah matriks masukan, dan $C$ adalah matriks akumulator).
Pada CUDA core konvensional, perkalian matriks ini dihitung satu elemen pada satu waktu menggunakan instruksi FMA (Fused Multiply-Add). Sebaliknya, Tensor Core adalah sirkuit khusus yang mengeksekusi operasi perkalian-penjumlahan dari matriks kecil (misalnya 4x4 atau 16x16) pada tingkat perangkat keras dalam 1 siklus (atau beberapa siklus).
Secara fisik, puluhan hingga ratusan multiplier dan pohon penjumlahan raksasa dihubungkan secara langsung dengan kabel, menyelesaikan perkalian-penjumlahan sekaligus tanpa harus menulis ulang hasil antara ke register. Hal ini menghasilkan throughput komputasi (TFLOPS) per area yang jauh lebih tinggi dibandingkan dengan CUDA core biasa.
4.2 Rahasia Presisi Campuran (Mixed-Precision)
Esensi lain dari Tensor Core adalah dukungannya terhadap operasi Mixed-Precision (Presisi Campuran). Dalam deep learning, ada banyak situasi selama proses perhitungan di mana presisi tinggi (FP32/FP64) tidak diperlukan. Tensor Core memiliki pipeline di mana matriks masukan $A$ dan $B$ dibaca dalam presisi rendah (FP16, BF16, atau presisi lebih rendah lagi seperti FP8, INT8, INT4), perkalian internal dilakukan dalam presisi rendah, dan kemudian proses penjumlahan (akumulasi) dilakukan dalam presisi yang lebih tinggi (FP32 atau INT32).
- FP16 / BF16: Standar untuk pelatihan. BF16 (Bfloat16) memiliki bagian eksponen 8-bit yang sama dengan FP32, dan jangkauan dinamisnya yang luas membuatnya lebih mudah untuk mencegah hilangnya gradien.
- FP8 / INT8 / INT4: Kunci percepatan untuk Inferensi (Inference). Karena volume transfer data (bandwidth memori) juga berkurang, throughput meningkat secara dramatis.
Pada arsitektur Hopper, “FP8 Tensor Core” diperkenalkan, yang secara dramatis mempercepat perhitungan model Transformer dan secara teoritis mencapai throughput puluhan kali lipat dibandingkan dengan FP32. Dari sisi perangkat lunak (CUDA), Tensor Core dikendalikan secara langsung melalui API wmma (Warp-Level Matrix Multiply and Accumulate) atau instruksi PTX mma.sync, melakukan pemrosesan kolektif yang sangat kompleks di mana utas dalam sebuah warp berkoordinasi untuk memuat potongan matriks ke dalam register, menghitung, dan menyimpannya.
Suplemen Tambahan Bab 5: Hierarki Memori CUDA dan Teknik Optimasi
Sebesar apa pun kemampuan komputasi prosesor komputasi grafis, kinerjanya tidak akan maksimal jika pasokan data menjadi hambatan (masalah memory wall). Tidaklah berlebihan untuk mengatakan bahwa 90% optimasi dalam pemrograman CUDA adalah “optimasi akses memori”.
5.1 Akses Coalescing ke Memori Global
Memori global, yang merupakan memori utama prosesor komputasi grafis (HBM atau GDDR), memiliki bandwidth yang sangat lebar (misalnya beberapa TB/s), tetapi latensinya juga sangat besar, mencapai ratusan siklus.
Prinsip mutlak untuk memaksimalkan efisiensi akses ke memori global adalah Coalescing (Penggabungan). Pengontrol memori prosesor komputasi grafis mengakses memori dalam transaksi unit 32-byte, 64-byte, atau 128-byte. Saat 32 utas dalam warp mengakses memori, jika alamat memori mereka berada dalam area yang berdampingan (dalam batas 128-byte yang diselaraskan), perangkat keras akan menggabungkan (coalesce) permintaan ini menjadi satu transaksi memori untuk diproses.
Sebaliknya, jika utas mengakses alamat secara acak, atau melakukan akses berjarak (stride), penggabungan tidak akan terjadi, dan banyak transaksi akan dihasilkan. Hal ini disebut “akses non-coalesced”, sebuah bug performa fatal yang dapat mengurangi bandwidth memori efektif menjadi kurang dari sepersepuluh.
5.2 Contoh Kode C++ CUDA: Optimasi Transpos Matriks dan Memori Bersama
Berikut adalah contoh kode kernel yang dioptimalkan untuk transpos matriks (Matrix Transpose), yang menghindari akses non-coalesced dan memanfaatkan memori bersama untuk meningkatkan performa secara dramatis.
| |
Ada 3 poin penting dalam kode ini:
- Coalescing saat membaca: Membaca dari
idatadilakukan dalam arah X yang berkelanjutan padathreadIdx.x, sehingga di-coalesce secara sempurna. - Coalescing saat menulis: Menulis ke
odatajuga dirancang agar berkesinambungan pada arahthreadIdx.xdengan menukar koordinat blok, sehingga di-coalesce. - Padding di memori bersama: Dengan menggeser 1 elemen (
tile[TILE_DIM][TILE_DIM + 1]), konflik bank yang terjadi saat mengakses kolom secara searah (tile[threadIdx.x][threadIdx.y + j]) pada saat penulisan dapat dihilangkan sepenuhnya.
5.3 Hierarki Cache dan Memori Khusus
- Kebijakan Cache L1/L2: Dalam arsitektur prosesor komputasi grafis terbaru, programmer dapat mengendalikan perilaku cache sebagai petunjuk menggunakan instruksi PTX (seperti
.ca,.cg,.cs). Misalnya, data yang hanya akan diakses sekali dapat mem-bypass cache L2 (streaming access) untuk mencegah polusi cache. - Memori Tekstur / Memori Konstanta: Memori tekstur yang dikhususkan untuk pemrosesan gambar memanfaatkan cache khusus untuk akses yang memiliki lokalitas spasial 2D. Memori konstanta memiliki efisiensi yang sangat tinggi untuk akses broadcast di mana semua utas membaca konstanta yang sama.
Suplemen Tambahan Bab 6: Masa Depan Prosesor Komputasi Grafis di Era Deep Learning
Bukan hanya peningkatan performa dari satu prosesor komputasi grafis tunggal, tetapi penskalaan keseluruhan sistem kini menjadi garda terdepan dari ilmu komputasi.
6.1 Interkoneksi Berkecepatan Ultra dengan NVLink dan NVSwitch
LLM (Large Language Model) yang masif tidak akan muat di dalam memori satu prosesor komputasi grafis (misalnya 80GB atau 144GB). Untuk melakukan paralelisasi model (tensor parallel atau pipeline parallel), data dalam skala terabyte perlu dipertukarkan antar perangkat setiap detiknya. Karena bus PCIe (PCI Express) konvensional tidak dapat memenuhi kebutuhan bandwidth ini, NVIDIA mengembangkan interkonek berkecepatan tinggi eksklusif yang disebut NVLink. Lebih lanjut, melalui chip sakelar yang disebut NVSwitch, dimungkinkan untuk menggabungkan 8 hingga 256 unit prosesor komputasi grafis menggunakan sakelar crossbar non-blocking yang utuh, membangun sebuah kluster yang bertindak seolah-olah merupakan satu prosesor raksasa.
6.2 Ekosistem Transformer Engine dan FP8
Untuk mengoptimalkan arsitektur Transformer yang telah menjadi standar de facto tidak hanya dalam pemrosesan bahasa alami tetapi juga pengenalan gambar dan suara, arsitektur Hopper dilengkapi dengan mekanisme kolaborasi perangkat keras dan lunak khusus yang disebut Transformer Engine. Sistem ini secara dinamis memantau informasi statistik tensor dan secara otomatis mengubah presisi perhitungan antara FP8 dan FP16 lapis demi lapis (Dynamic Scaling), mewujudkan kecepatan perhitungan ekstrem dan penghematan bandwidth memori sambil mencegah degradasi presisi.
6.3 Hukum Penskalaan Kluster Prosesor Komputasi Grafis dan Prospek Masa Depan
Seperti yang ditunjukkan oleh “Scaling Laws (Hukum Penskalaan)” OpenAI, semakin banyak parameter model dan volume perhitungan yang ditambahkan, kinerja AI akan terus meningkat. Sejalan dengan ini, prosesor komputasi grafis telah berevolusi dari sekadar prosesor menjadi kluster puluhan ribu unit yang terhubung oleh serat optik, menjadikan “pusat data itu sendiri sebagai sebuah prosesor raksasa (superkomputer)”.
Evolusi arsitektur ke depannya kemungkinan akan mengarah ke adopsi fotonik silikon (interkonek optik), CPO (Co-Packaged Optics), dan peningkatan lebih lanjut pada teknologi penumpukan 3D dari SRAM ke HBM. Namun, “memaksimalkan throughput melalui pemrosesan paralel”, yang merupakan DNA prosesor komputasi grafis sejak awal kelahirannya, akan terus membuka jalan bagi garis depan ilmu komputasi.
Kesimpulan: Menuju Puncak Ilmu Komputasi
Arsitektur GPU adalah mesin komputasi yang paling kompleks dan paling dikhususkan untuk throughput yang pernah diciptakan umat manusia. Jika CPU adalah “sebuah mobil balap F1 berkinerja sangat tinggi”, maka GPU dapat diibaratkan sebagai “sistem logistik raksasa di mana puluhan ribu truk pengangkut membawa barang pada saat bersamaan dengan gerakan yang terkoordinasi”.
Eksekusi instruksi per warp oleh SIMT, penjadwalan perangkat keras yang beralih di antara ribuan utas dalam nol siklus, akses coalescing yang memaksimalkan bandwidth hingga batasnya, dan pipeline Tensor Core yang memelopori terobosan deep learning. Semua ini adalah puncak dari dedikasi yang hampir gila dari para insinyur mengenai “bagaimana memaksimalkan volume total perhitungan titik mengambang (floating-point) dalam batasan hukum fisika (kecepatan cahaya, panas, listrik, batas miniaturisasi silikon)”.
Bagi para insinyur perangkat lunak, peneliti AI, dan peneliti HPC di masa depan, memahami arsitektur GPU bukan sekadar pengetahuan umum. Ini adalah “mata pelajaran wajib” untuk secara intuitif memahami apa yang terjadi di balik kerangka kerja (seperti PyTorch dan TensorFlow) dan untuk memaksimalkan kemampuan perangkat keras secara ekstrem. Menghindari konflik bank memori, menghilangkan warp divergence, dan menjaga pipeline Tensor Core tetap terisi dengan data. Pada akhir pengoptimalan tersebut, masa depan di mana komputasi yang dulunya membutuhkan waktu berbulan-bulan dengan superkomputer kini dapat diselesaikan dalam beberapa jam dengan beberapa GPU di atas meja, kini telah menjadi kenyataan.
Kita sekarang hidup di era keemasan arsitektur komputer yang paling menarik dalam sejarah manusia. Mungkin Andalah yang membaca artikel ini yang akan memahami esensi dari fisika CUDA dan arsitektur paralel masif GPU, serta menciptakan inovasi generasi berikutnya.
Daftar Istilah (Glossary)
- SM (Streaming Multiprocessor): Blok perhitungan utama pada GPU. Setara dengan inti (core) pada CPU, tetapi menampung banyak CUDA core, penjadwal warp, memori bersama, dll. di dalamnya.
- SIMT (Single Instruction, Multiple Threads): Model eksekusi khas GPU di mana semua utas di dalam sebuah warp berbagi instruksi yang sama sambil melakukan perhitungan terhadap data yang independen.
- Warp: Sekumpulan 32 utas. Unit minimum penjadwalan dan penerbitan instruksi oleh perangkat keras.
- Warp Divergence (Ketidaksesuaian Percabangan): Fenomena di mana utas di dalam sebuah warp memiliki kondisi percabangan yang berbeda, menyebabkan jalur eksekusi diserialisasi dan throughput menurun.
- Tensor Core: Sirkuit khusus yang memproses operasi perkalian-penjumlahan matriks (MMA) sekaligus pada tingkat perangkat keras. Dikhususkan untuk percepatan deep learning.
- Coalesced Access (Akses Bersebelahan/Tergabung): Mekanisme di mana perangkat keras menggabungkan akses ke dalam satu transaksi ketika utas dalam warp mengakses alamat memori yang berurutan, guna mewujudkan bandwidth tinggi.
- Shared Memory (Memori Bersama): Memori scratchpad L1 super cepat yang dapat dikontrol oleh programmer yang disematkan di dalam SM.
- Bank Conflict (Konflik Bank): Pada memori bersama, penalti ketika beberapa utas mencoba mengakses alamat berbeda di bank yang sama pada saat bersamaan, yang menyebabkan akses diserialisasi.
- Occupancy (Tingkat Hunian): Rasio persentase aktual dari jumlah warp yang dapat diaktifkan secara bersamaan di SM terhadap nilai maksimum teoretisnya. Semakin tinggi, semakin mudah menyembunyikan latensi akses memori.
- Register Spilling (Pelimpahan Register): Fenomena ketika jumlah register yang digunakan oleh sebuah utas melebihi batas perangkat keras, dan kelebihan data dipindahkan ke memori yang lambat (memori lokal).
Referensi dan Daftar Bacaan yang Disarankan
- NVIDIA CUDA C++ Programming Guide: Dokumen resmi yang wajib dibaca oleh setiap programmer CUDA. Mencakup pola akses memori dan praktik terbaik optimasi secara menyeluruh.
- NVIDIA Ampere / Hopper Architecture Whitepaper: Whitepaper resmi yang mendeskripsikan rincian pipeline Tensor Core, transfer memori asinkron, dan implementasi perangkat keras Transformer Engine.
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): Karya klasik tentang arsitektur komputer. Memberikan wawasan mendalam tentang perbedaan filosofi desain antara CPU dan GPU, hierarki cache, dan paralelisme tingkat instruksi.
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): Buku teks yang menjelaskan pemrograman CUDA dari perspektif desain algoritma. Implementasi dari teknik tiling memori bersama, reduksi, prefix sum, dan lainnya dijelaskan secara rinci.
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: Makalah akademis. Mahakarya yang mengungkapkan latensi cache yang tidak dipublikasikan oleh NVIDIA dan throughput akurat Tensor Core menggunakan microbenchmarking.
Pengetahuan tentang arsitektur yang dijelaskan dalam artikel ini mungkin ada yang menjadi usang seiring dengan evolusi perangkat keras, namun prinsip-prinsip dasar fisik mengenai “memaksimalkan bandwidth, memanfaatkan paralelisme, dan menyembunyikan latensi” akan terus bertahan sebagai kebenaran universal dalam ilmu komputer.