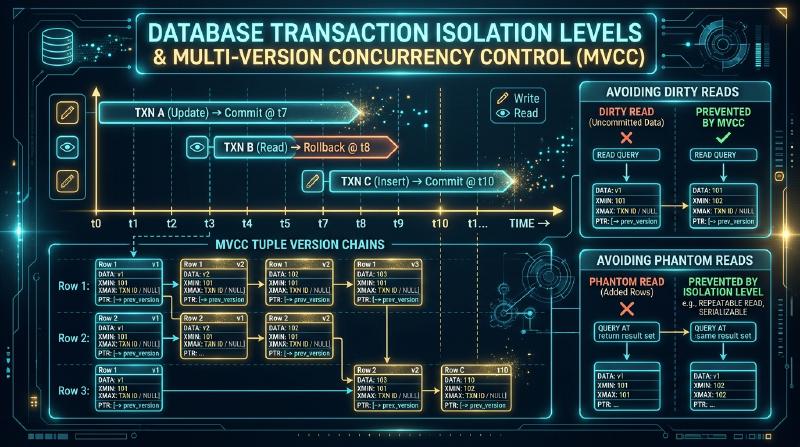
Tingkat Isolasi Transaksi Basis Data dan MVCC: Realitas ACID dan Kontrol Konkurensi Multiversi
Dalam arsitektur perangkat lunak modern, sistem manajemen basis data relasional (RDBMS) tetap menjadi kunci utama dari persistensi data. Inti dari hal ini adalah konsep “transaksi”, di mana secara khusus sifat ACID (Atomicity, Consistency, Isolation, Durability) secara luas diakui sebagai teori dasar untuk membangun sistem yang kuat. Namun, di antara sifat-sifat ACID, “Isolation (Isolasi)” adalah area di mana terdapat kesenjangan terbesar antara teori dan praktik.
Artikel ini menggali lebih dalam dari perspektif yang sangat detail, akademis, dan praktis, mulai dari latar belakang sejarah tingkat isolasi transaksi basis data, keterbatasan standar ANSI SQL-92, hingga struktur internal Multi-Version Concurrency Control (MVCC: Kontrol Konkurensi Multiversi) yang diadopsi oleh mesin basis data modern. Secara khusus, kami akan membedah perbedaan implementasi MVCC yang krusial antara dua RDBMS sumber terbuka (open source) utama, PostgreSQL dan MySQL (InnoDB), serta mencakup hingga garis depan basis data terdistribusi yaitu Serializable Snapshot Isolation (SSI), yang disajikan sebagai karya besar dengan lebih dari 12.000 karakter.
Bab 1: Mitos Sifat ACID dan Dilema Pemrosesan Konkuren
1.1 Ideal dari Serializability (Keterurutan)
Bentuk ideal utama yang dituju oleh Isolation (Isolasi) transaksi adalah “Serializability (Keterurutan)”. Ini mengacu pada sifat di mana bahkan ketika beberapa transaksi dieksekusi secara bersamaan (konkuren), hasil eksekusinya “setara dengan hasil jika transaksi dieksekusi secara berurutan (serial) satu per satu dalam urutan tertentu”.
Ketika transaksi $T_1$ dan $T_2$ dieksekusi secara bersamaan pada sistem, tidak peduli bagaimana interleaving (persilangan operasi) terjadi akibat eksekusi konkuren, jika status basis data akhir sama persis dengan hasil eksekusi dalam urutan “$T_1 \rightarrow T_2$” atau “$T_2 \rightarrow T_1$”, maka penjadwalan tersebut didefinisikan sebagai serializable (dapat diurutkan). Jika serializability ini dijamin, pengembang aplikasi dapat fokus pada membangun logika bisnis tanpa perlu khawatir tentang inkonsistensi data (seperti race condition atau penimpaan yang tidak tepat) karena pemrosesan konkuren.
1.2 Keruntuhan Kinerja akibat Serialisasi dengan Penguncian (Locking)
Pada sistem basis data awal, mekanisme penguncian ketat yang disebut “Two-Phase Locking (2PL)” diadopsi untuk menjamin serializability ini. Dalam 2PL, sebuah transaksi harus selalu mendapatkan kunci (kunci bersama/shared lock atau kunci eksklusif/exclusive lock) sebelum membaca atau menulis data (Fase 1: Growing Phase), dan melepaskan semua kunci saat transaksi berakhir (baik komit maupun pembatalan/rollback) (Fase 2: Shrinking Phase).
Namun, mekanisme penguncian ketat ini memiliki cacat fatal. Yaitu “penurunan kinerja yang ekstrem”.
- Operasi baca memblokir operasi tulis.
- Operasi tulis memblokir operasi baca.
- Peningkatan waktu tunggu akibat konflik penguncian dan sering terjadinya deadlock.
Ketika lalu lintas data meningkat dan sejumlah besar pengguna mengakses basis data secara bersamaan, serialisasi penuh melalui 2PL menjadi hambatan (bottleneck) sistem, dan throughput menurun tajam. Sistem menghadapi dilema tarik-ulur (trade-off) antara “konsistensi data” dan “kinerja pemrosesan konkuren (throughput)”.
1.3 Sejarah dan Kompromi Kontrol Konkurensi
Untuk menyelesaikan dilema ini, para peneliti rekayasa basis data memperkenalkan konsep “Isolation Level (Tingkat Isolasi)”. Ini adalah “produk kompromi” yang secara parsial melonggarkan serializability penuh dan mengizinkan terjadinya inkonsistensi data tertentu (Anomaly / Anomali) dengan imbalan peningkatan kinerja pemrosesan konkuren. Hal ini memungkinkan pemilihan keseimbangan antara konsistensi dan kinerja sesuai dengan kebutuhan aplikasi.
Bab 2: Tingkat Isolasi Standar ANSI SQL-92 dan Kritiknya
2.1 Definisi Tingkat Isolasi menurut Standar ANSI SQL-92
Standar SQL “SQL-92” yang ditetapkan pada tahun 1992 mendefinisikan 4 tingkat isolasi berdasarkan 3 anomali (Phenomena) representatif yang mungkin terjadi akibat pemrosesan konkuren.
3 Anomali (Phenomena) yang Didefinisikan
- Dirty Read (Baca Kotor): Fenomena di mana transaksi $T_1$ memperbarui data dan, selagi belum dikomit, transaksi lain $T_2$ membaca data yang belum dikomit tersebut. Jika $T_1$ dibatalkan (rollback), $T_2$ berarti telah membaca data hantu yang sebenarnya tidak ada.
- Non-repeatable Read (Baca Tidak Dapat Diulang): Fenomena di mana selama transaksi $T_1$ membaca baris yang sama dua kali, transaksi lain $T_2$ memperbarui dan mengkomit baris tersebut di sela-selanya. Akibatnya, hasil pembacaan pertama dan kedua dari $T_1$ menjadi berbeda.
- Phantom Read (Baca Bayangan/Hantu): Fenomena di mana selama transaksi $T_1$ membaca beberapa baris dengan kriteria pencarian tertentu, transaksi lain $T_2$ menyisipkan (atau menghapus) baris baru yang sesuai dengan kriteria tersebut dan mengkomitnya. Jika $T_1$ melakukan pencarian ulang dengan kriteria yang sama, jumlah baris akan bertambah atau berkurang.
4 Tingkat Isolasi menurut SQL-92
SQL-92 mendefinisikan tingkat isolasi berdasarkan sejauh mana mereka mencegah terjadinya anomali-anomali ini.
- Read Uncommitted: Mengizinkan dirty read.
- Read Committed: Mencegah dirty read, tetapi mengizinkan non-repeatable read dan phantom read.
- Repeatable Read: Mencegah dirty read dan non-repeatable read, tetapi mengizinkan phantom read.
- Serializable: Mencegah semua anomali dan menjamin serializability secara penuh.
2.2 Makalah Kritik oleh Berenson dkk., “A Critique of ANSI SQL Isolation Levels”
Definisi standar SQL-92 pada pandangan pertama terlihat sangat jelas dan logis. Namun, makalah “A Critique of ANSI SQL Isolation Levels” yang diterbitkan pada tahun 1995 oleh tokoh-tokoh besar di dunia basis data seperti Hal Berenson, Jim Gray (pemenang Turing Award), dan Phil Bernstein, memberikan pukulan telak terhadap definisi standar ANSI ini.
Berikut adalah cacat utama dari standar SQL-92 yang ditunjukkan dalam makalah tersebut.
1. Premis Tersirat Berbasis Penguncian (Lock-based)
Definisi SQL-92 secara implisit beranggapan bahwa “basis data diimplementasikan dengan kontrol konkurensi berbasis penguncian (2PL)”. Namun, pada tahun 1990-an, basis data yang mengadopsi MVCC (dijelaskan nanti) dan Kontrol Konkurensi Optimis (OCC) lainnya sudah mulai muncul, sehingga definisi anomali yang didasarkan pada asumsi adanya penguncian menjadi usang.
2. Ambiguitas dan Ketidaklengkapan Definisi
Makalah tersebut menunjukkan bahwa 3 anomali yang didefinisikan dalam SQL-92 (Dirty Read, Non-repeatable Read, Phantom Read) saja tidak dapat mencakup semua anomali yang dapat terjadi dalam pemrosesan konkuren. Sebagai contoh, ada fenomena yang disebut “Dirty Write (Tulis Kotor)”. Ini adalah fenomena di mana data yang ditulis oleh transaksi yang belum dikomit ditimpa oleh transaksi lain yang juga belum dikomit. Namun, tidak ada penyebutan tentang dirty write dalam standar SQL-92. Meskipun semua tingkat isolasi (termasuk Read Uncommitted) harus mencegah dirty write (jika tidak, konsistensi internal basis data akan runtuh), standar tersebut tidak menyinggung poin tersebut.
3. Penemuan Anomali Baru
Makalah ini juga mendefinisikan beberapa anomali baru yang tidak ada dalam standar SQL-92. Dua yang paling representatif adalah:
- Lost Update (Pembaruan Hilang): Fenomena di mana dua transaksi membaca data yang sama pada saat yang sama, dan ketika masing-masing menulis kembali hasil perhitungannya, satu pembaruan menimpa dan menghapus pembaruan yang lain.
- Write Skew (Kemiringan Tulis): Fenomena spesifik pada Snapshot Isolation (Isolasi Cuplikan) yang akan dijelaskan kemudian.
Makalah Berenson dkk. membuktikan bahwa standar SQL-92 gagal mendefinisikan tingkat isolasi secara matematis dan ketat, yang memberikan kejutan besar pada industri basis data. Dalam teori basis data saat ini, definisi tingkat isolasi ANSI SQL-92 diperlakukan sebagai “sesuatu yang dipelajari sebagai latar belakang sejarah” dan “tidak cukup sebagai definisi teknis yang ketat”.
Bab 3: Snapshot Isolation (Isolasi Cuplikan) dan Write Skew
3.1 Perbedaan antara Repeatable Read dan Snapshot Isolation
Yang mendapat perhatian khusus dalam makalah Berenson dkk. adalah usulan tingkat isolasi baru yang disebut “Snapshot Isolation (SI)”.
Pada banyak basis data yang mengadopsi MVCC (seperti PostgreSQL dan Oracle), realitas tingkat isolasi yang disediakan sebagai “Repeatable Read” sebenarnya adalah “Snapshot Isolation”. Dalam Snapshot Isolation, setiap transaksi melakukan pembacaan terhadap “cuplikan (snapshot / keadaan statis di masa lalu)” basis data yang konsisten pada saat transaksi dimulai.
- Setiap pembaruan oleh transaksi lain yang dilakukan setelah waktu mulai transaksi sama sekali tidak terlihat (mencegah non-repeatable read).
- Karena keberadaan record itu sendiri ditetapkan pada titik di masa lalu, INSERT oleh transaksi lain juga tidak terlihat (mencegah phantom read).
Dengan kata lain, Snapshot Isolation tidak hanya memenuhi persyaratan “Repeatable Read” yang didefinisikan oleh SQL-92, tetapi dalam banyak kasus juga mencegah “phantom read”. Lalu, apakah Snapshot Isolation setara dengan “Serializable”? Jawabannya adalah “Tidak”. Ini karena Snapshot Isolation memiliki anomali fatal yang tidak dapat diserialisasi (not serializable) yaitu “Write Skew (Kemiringan Tulis)”.
3.2 Masalah Dokter Jaga (On-Call) dan Write Skew
Contoh paling terkenal untuk memahami write skew adalah “sistem dokter jaga (on-call)”.
【Aturan Bisnis】 Misalkan ada sistem manajemen giliran rumah sakit yang memiliki aturan: “Setidaknya 1 dokter harus selalu berstatus siap siaga (on-call)”.
Saat ini, 2 dokter, Alice dan Bob, sedang dalam status on-call (on_call = true).
Pada saat ini, Alice dan Bob kebetulan secara bersamaan berpikir “Saya merasa kurang sehat, jadi saya ingin keluar dari status on-call”, dan mereka berdua memulai transaksi perubahan giliran dari terminal masing-masing.
【Alur Transaksi (di bawah Snapshot Isolation)】
- [Tx1: Alice] Mengambil snapshot. Mengonfirmasi bahwa saat ini ada 2 orang yang on-call, yaitu Alice dan Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Hasil: 2 - [Tx2: Bob] Mengambil snapshot. Sama-sama mengonfirmasi bahwa ada 2 orang, Alice dan Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Hasil: 2 - [Tx1: Alice] Menilai bahwa aturan (minimal 1 orang on-call) terpenuhi, dan mengeluarkan dirinya sendiri dari on-call.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] Sama-sama menilai bahwa aturan terpenuhi, dan mengeluarkan dirinya sendiri dari on-call.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] Komit berhasil.
- [Tx2: Bob] Komit berhasil. (Karena Alice dan Bob memperbarui baris data yang berbeda, kunci baris tidak mengalami konflik)
【Hasil】 Akibat dari Tx1 dan Tx2 yang keduanya dikomit, jumlah dokter on-call menjadi “0”. Aturan bisnis telah runtuh.
Inilah yang disebut Write Skew. Jika sifatnya Serializable, salah satu dari Tx1 dan Tx2 akan dieksekusi secara serial terlebih dahulu, sehingga transaksi yang dieksekusi belakangan akan mendeteksi bahwa jumlah on-call adalah “1”, dan seharusnya dapat membatalkan (abort/rollback) operasinya untuk mengeluarkan diri. Namun, dalam Snapshot Isolation, karena mereka memperbarui baris data yang berbeda (baris Alice dan baris Bob), tabrakan tidak terdeteksi, yang menyebabkan inkonsistensi aturan bisnis.
3.3 ReadOnly Anomaly (Anomali Hanya-Baca)
Selain itu, dalam Snapshot Isolation terdapat anomali yang sangat khusus yang disebut ReadOnly Anomaly, di mana serializability rusak karena adanya intervensi dari “transaksi hanya-baca (read-only)”. Ditunjukkan dalam contoh seperti saldo deposito rekening bank dan pemberian bunga, anomali ini adalah fenomena di mana meskipun tidak ada konflik antara transaksi pembaruan, transaksi hanya-baca yang melihat snapshot masa lalu membaca “keadaan garis waktu yang tidak mungkin secara logis”. Karena keberadaan anomali ini, Snapshot Isolation dibedakan dari Serializable dalam arti yang ketat.
Bab 4: Prinsip Kerja MVCC (Multi-Version Concurrency Control)
Sejauh ini kita telah membahas tentang teori tingkat isolasi dan anomali, namun bagaimana basis data modern mengontrol hal-hal ini? Teknologi intinya adalah MVCC (Multi-Version Concurrency Control: Kontrol Konkurensi Multiversi).
4.1 “Baca tidak memblokir tulis, dan tulis tidak memblokir baca”
Filosofi desain terbesar dari MVCC, dan yang secara definitif membedakannya dari kontrol berbasis penguncian (2PL), adalah pada poin “baca dan tulis tidak saling memblokir”. Saat memperbarui sebuah record (catatan), basis data MVCC tidak langsung menimpa record yang ada (In-place update). Sebaliknya, basis data membuat versi baru dari record (versi / tuple), dan mempertahankan versi lama dari record tersebut pada saat yang bersamaan.
Di dalam basis data, beberapa versi dari record yang sama (riwayat dari masa lalu ke masa kini) akan ada secara bersamaan. Ketika sebuah transaksi membaca data, berdasarkan “ID Transaksi (XID)” miliknya atau “Waktu Mulai (timestamp)”, ia menghitung dan membaca “versi masa lalu yang benar yang seharusnya ia baca” dari berbagai versi yang ada di dalam sistem.
Dengan ini, bahkan jika sebuah transaksi sedang menulis ulang record, transaksi lain dapat membaca “versi masa lalu sebelum ditulis ulang”, dan dapat menghindari waktu tunggu akibat penguncian.
4.2 Rantai Manajemen Versi Tuple dan Aturan Visibilitas (Visibility)
Algoritma terpenting dalam MVCC adalah Aturan Visibilitas (Visibility Rule), yang menentukan “transaksi mana yang dapat melihat versi data yang mana”.
Setiap transaksi diberi ID transaksi (XID) unik yang meningkat secara monoton saat dimulai. Setiap versi record (tuple) yang disimpan di basis data memiliki informasi berikut sebagai metadata:
- XID Pembuat (Creation XID): ID dari transaksi yang membuat versi ini melalui INSERT/UPDATE.
- XID Penghapus (Deletion XID): ID dari transaksi yang menghapus secara logis (membatalkan) versi ini melalui UPDATE/DELETE.
Ketika transaksi $T_i$ membaca baris data, visibilitas dievaluasi berdasarkan aturan dasar berikut:
- Apakah sudah dikomit?: Apakah transaksi dari XID Pembuat sudah dikomit?
- Bukan di masa depan?: Apakah XID Pembuat adalah transaksi yang terjadi di masa lalu dari titik dimulainya $T_i$?
- Apakah belum dihapus?: Apakah XID Penghapus belum diatur, atau transaksi dari XID Penghapus belum dikomit, atau apakah ia merupakan transaksi di masa depan dari titik dimulainya $T_i$?
Dengan mengevaluasi kondisi-kondisi ini secara ketat, sistem menyediakan snapshot yang konsisten kepada setiap transaksi.
Bab 5: Perbedaan Implementasi MVCC yang Krusial: PostgreSQL vs MySQL (InnoDB)
Meskipun filosofi dasar MVCC sama, implementasi internalnya bisa sangat berbeda tergantung pada produk basis datanya. Di sini kita akan membandingkan dan membedah arsitektur MVCC dari PostgreSQL dan MySQL (InnoDB), dua pilar utama dalam dunia open-source.
5.1 Implementasi MVCC PostgreSQL: Penambahan pada Heap dan Keniscayaan VACUUM
MVCC PostgreSQL mengadopsi “Arsitektur Tambah Saja (Append-only)” yang sangat unik dan intuitif.
5.1.1 Logika Penilaian Bit melalui xmin dan xmax
Di dalam file data (heap) yang merupakan entitas sebenarnya dari tabel PostgreSQL, 2 ID transaksi yang disebut xmin dan xmax dicatat di header setiap baris (tuple).
xmin(Transaction ID of Insert): XID dari transaksi yang membuat tuple ini.xmax(Transaction ID of Delete): XID dari transaksi yang menghapus (atau menghapus logis tuple versi lama melalui pembaruan) tuple ini.
【Perilaku Operasi UPDATE】
Dalam PostgreSQL, secara logis UPDATE diproses sebagai kombinasi dari DELETE dan INSERT.
- Menuliskan XID transaksi saat ini ke dalam
xmaxdari tuple lama. (Penghapusan logis) - Membuat tuple yang benar-benar baru di ruang kosong heap, menuliskan data baru, dan mengatur
xminke XID transaksi saat ini. (Penambahan baru)
Artinya, baik tuple lama maupun baru bercampur dan disimpan di dalam file data tabel (heap) yang sama.
5.1.2 Keuntungan Besar dan Masalah Fatal: Keberadaan VACUUM
Keuntungan terbesar dari arsitektur ini adalah pembatalan (rollback) yang sangat cepat. Jika transaksi dibatalkan, cukup menangani tuple yang ditambahkan sebagai “belum dikomit”, tanpa perlu proses untuk mengembalikan (rewrite) data.
Namun, masalah fatalnya adalah “Pembengkakan Tuple Mati (Dead Tuples)”.
Jika operasi UPDATE atau DELETE diulang, versi lama dari tuple yang tidak lagi direferensikan oleh siapa pun (tuple dengan xmax yang sudah dikomit sebagai ID transaksi lama) akan terus menumpuk di dalam heap tanpa batas. Jika dibiarkan, ukuran fisik tabel akan membesar secara eksplosif, dan performa dari pemindaian sekuensial (sequential scan) akan turun secara drastis.
Proses sistem yang secara fisik menghapus tuple mati ini dan membuat ruang kosong agar dapat digunakan kembali disebut VACUUM (serta daemon autovacuum yang berjalan secara otomatis). Alasan mengapa tuning (penyetelan) VACUUM dianggap sangat penting dalam operasi PostgreSQL berakar pada inti dari arsitektur MVCC ini.
5.2 Implementasi MVCC MySQL InnoDB: Pembaruan di Tempat (In-place update) dan Rekonstruksi Dinamis Log Undo
Di sisi lain, InnoDB, yang merupakan storage engine (mesin penyimpanan) default MySQL, mengadopsi arsitektur yang lebih mirip dengan Oracle Database, yaitu “Pembaruan di Tempat (In-place update) dan Log Undo (Segmen Rollback)”.
5.2.1 Indeks Terkluster (Clustered Index) dan Pembaruan di Tempat
Tabel InnoDB disusun sebagai B+Tree (Indeks Terkluster) yang berbasis pada kunci utama (primary key).
Saat UPDATE dieksekusi di InnoDB, tidak menambah baris baru seperti PostgreSQL, melainkan langsung menimpa baris data di B+Tree (In-place update).
Lalu, bagaimana jika transaksi lain ingin membaca snapshot dari masa lalu? Untuk tujuan itu, InnoDB menyelamatkan (memindahkan) “data lama” sebelum ditimpa ke dalam area khusus yang disebut Log Undo (Undo Log Segment).
5.2.2 Rekonstruksi Dinamis Masa Lalu menggunakan Roll Pointer
Kolom tersembunyi di setiap baris data InnoDB menyertakan dua hal berikut:
DB_TRX_ID: ID dari transaksi yang terakhir kali menyisipkan atau memperbarui baris ini.DB_ROLL_PTR(Roll Pointer): Pointer yang menunjuk ke lokasi di dalam log undo di mana “1 versi lebih lama” dari baris ini disimpan.
Proses di mana sebuah transaksi membaca snapshot masa lalu adalah sebagai berikut:
- Membaca baris data terbaru dari B+Tree.
- Memeriksa
DB_TRX_ID, dan jika pembaruan dilakukan oleh transaksi yang berada di masa depan dari snapshot-nya, ia memutuskan bahwa baris terbaru ini tidak boleh dibaca. - Mengikuti
DB_ROLL_PTRdan mengambil data versi sebelumnya dari log undo. - Menggunakan data dari log undo, status record masa lalu direkonstruksi secara dinamis di memori (Rollback in memory).
- Jika ini masih merupakan pembaruan dari masa depan, ia akan menelusuri rantai log undo lebih jauh ke masa lalu.
5.2.3 Keuntungan dan Masalah InnoDB
Keuntungan arsitektur ini adalah area tabel utama (tablespace) tidak mudah membengkak. Data terbaru selalu berada di lokasi yang tepat pada B+Tree, dan versi-versi sebelumnya diisolasi di area terpisah (log undo), sehingga efisiensi pemindaian fisik tetap tinggi (tidak perlu VACUUM skala besar seperti PostgreSQL, dan proses pembersihan log undo berjalan ringan di latar belakang).
Di sisi lain, kekurangannya adalah, jika ada transaksi jangka panjang yang membaca banyak snapshot masa lalu (seperti pemrosesan batch atau mysqldump), terjadi overhead untuk menelusuri log undo secara dalam dan merekonstruksi data, yang akan menurunkan kinerja pembacaan. Selain itu, ada juga risiko bahwa log undo itu sendiri membengkak dan menekan ruang penyimpanan (disk space).
Bab 6: Serializable Snapshot Isolation (SSI) dan Garis Depan Basis Data Terdistribusi
Evolusi MVCC tidak berhenti di sini. Seperti yang dijelaskan pada Bab 3, Snapshot Isolation (SI) memiliki anomali seperti “Write Skew”, dan bukanlah Serializable yang utuh. Namun, untuk membuat pengembang aplikasi tidak perlu memikirkan kerumitan pemrosesan konkuren, Serializable yang utuh perlu dicapai sambil mempertahankan kinerja tinggi MVCC.
6.1 Lahirnya Serializable Snapshot Isolation (SSI)
Pada tahun 2008, sebuah algoritma inovatif yang disebut “Serializable Snapshot Isolation (SSI)” dipublikasikan dalam makalah oleh Michael Cahill dan rekan-rekannya. Ini adalah teknologi yang menjamin keterurutan secara penuh (Serializable) sambil menggunakan arsitektur MVCC sebagai dasarnya. PostgreSQL dengan cepat mengadopsi SSI ini sebagai implementasi dari tingkat isolasi “Serializable” mulai dari versi 9.1.
Prinsip Kerja SSI: Grafik Konflik dan Struktur Berbahaya (rw-antidependency)
SSI tidak memblokir menggunakan penguncian (lock). Sebaliknya, selama transaksi dijalankan, ia melacak (tracking) secara rinci “data mana yang dibaca (Read) dan data mana yang ditulis (Write)”.
SSI memonitor hubungan konflik antar transaksi dan mencari pola konflik spesifik yang disebut “rw-antidependency (anti-ketergantungan baca-tulis)”. Secara spesifik, ini adalah hubungan di mana transaksi $T_1$ membaca data dari versi lama, dan data tersebut kemudian ditimpa dan dikomit oleh transaksi lain $T_2$. SSI membangun grafik konflik transaksi secara internal, dan saat mendeteksi “struktur di mana panah rw-antidependency terjadi dua kali berturut-turut (struktur berbahaya)”, ia menilainya sebagai potensi keruntuhan serializability dan secara paksa membatalkan (rollback) salah satu transaksi.
Melalui hal ini, ia menghentikan transaksi sebelum anomali seperti Write Skew (contoh: masalah dokter on-call) terjadi, dan sebagai hasilnya, menjamin Serializable yang seutuhnya. Ini bisa dikatakan sebagai bentuk pamungkas dari Optimistic Concurrency Control (OCC).
6.2 MVCC dalam Basis Data Terdistribusi: Spanner, CockroachDB, TiDB
Teknologi basis data modern telah melampaui batas server tunggal dan berevolusi menjadi basis data SQL terdistribusi (NewSQL) yang tersebar di pusat-pusat data di seluruh dunia. Mencapai MVCC dengan konsistensi global di dalam lingkungan terdistribusi merupakan tantangan terhadap hukum fisika.
Google Spanner dan API TrueTime
Spanner dari Google mengembangkan API TrueTime untuk memecahkan masalah pengurutan transaksi pada sistem terdistribusi. Berdasarkan asumsi bahwa jam setiap server (jam fisik) pasti memiliki selisih (clock skew), ia menggabungkan GPS dan jam atom untuk menyediakan waktu saat ini sebagai “rentang ketidakpastian (time window)”. MVCC Spanner secara fisik menjamin bahwa “transaksi yang memiliki hubungan kausal (sebab-akibat) selalu memiliki urutan timestamp yang benar (Konsistensi Eksternal / External Consistency)” dengan cara menunggu hingga rentang ketidakpastian TrueTime ini berlalu saat komit transaksi (Commit Wait).
CockroachDB dan HLC (Hybrid Logical Clock)
CockroachDB, basis data terdistribusi open-source yang terinspirasi oleh Spanner, mengadopsi HLC (Hybrid Logical Clock / Jam Logika Hibrida) untuk mencapai konsistensi yang mendekati tanpa menggunakan jam atom yang mahal. Dengan menggabungkan sinkronisasi jam fisik melalui NTP dan Lamport Logical Clock (penghitung berdasarkan hubungan kausal antar event), ia menghasilkan timestamp snapshot MVCC yang konsisten secara global antar node yang terdistribusi, dan mewujudkan SSI (Serializable Snapshot Isolation) di dalam lingkungan terdistribusi.
TiDB dan Model Percolator
TiDB yang dikembangkan oleh PingCAP mengadopsi model transaksi terdistribusi yang didasarkan pada model Google Percolator. Ini adalah arsitektur di mana ada satu komponen (Placement Driver: PD) yang mengeluarkan timestamp global, dan storage engine di setiap node (TiKV) menggunakan timestamp tersebut untuk memproses MVCC secara lokal. Sambil berdasar pada 2PC (Two-Phase Commit), arsitektur ini meminimalkan durasi penguncian (lock), menyeimbangkan transaksi raksasa dalam lingkungan terdistribusi dengan MVCC.
Kesimpulan: Melampaui ACID
Tingkat isolasi transaksi dari basis data sama sekali bukanlah sekadar hal untuk dihafal. Itu adalah inti dari sejarah panjang perjuangan ilmu komputer selama puluhan tahun untuk menyelaraskan tuntutan yang bertentangan antara konsistensi data dan kinerja sistem.
Berawal dari definisi ANSI SQL-92 yang tidak lengkap, lompatan besar dalam pemrosesan konkuren melalui MVCC, percabangan arsitektur antara PostgreSQL dan InnoDB, hingga tantangan menuju konsistensi tertinggi melalui SSI dan basis data terdistribusi. Memahami struktur internal ini secara mendalam pastinya akan menjadi senjata ampuh dalam merancang aplikasi yang lebih tangguh dan berperforma tinggi.
Saat ini kita hidup di era di mana sifat ACID bukan lagi sekadar “mitos”, melainkan diterapkan sebagai “kenyataan” melalui algoritma mutakhir dan sinkronisasi jam fisik. Bagi para insinyur yang berlayar mengarungi lautan data, mengetahui kedalaman dari mesin basis data adalah sebuah perjalanan eksplorasi intelektual yang tidak akan pernah berakhir.