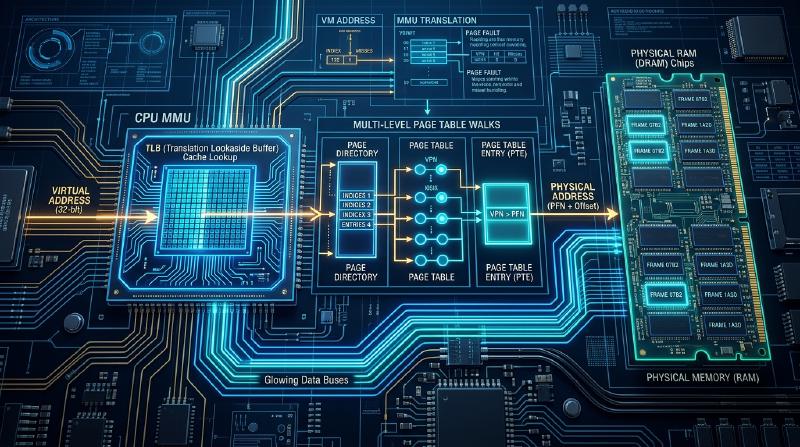
वर्चुअल मेमोरी और पेजिंग मैकेनिज्म का संपूर्ण विश्लेषण: MMU से TLB, HugePage और मेमोरी प्रबंधन की गहराई तक
आधुनिक ऑपरेटिंग सिस्टम (OS) और CPU आर्किटेक्चर में, सबसे जटिल लेकिन सबसे महत्वपूर्ण प्रणालियों में से एक “वर्चुअल मेमोरी” (Virtual Memory) और “पेजिंग” (Paging) तंत्र है। मेमोरी स्पेस के पीछे, जिसके बारे में एप्लिकेशन डेवलपर्स आमतौर पर अवगत नहीं होते हैं, हार्डवेयर का MMU (Memory Management Unit) और OS कर्नेल नैनोसेकंड की दुनिया में भारी मात्रा में एड्रेस ट्रांसलेशन और एक्सेप्शन हैंडलिंग करने के लिए मिलकर काम करते हैं।
इस लेख में, हम ऑपरेटिंग सिस्टम की आंतरिक संरचना और कंप्यूटर आर्किटेक्चर के दृष्टिकोण से वर्चुअल मेमोरी सिस्टम के सबसे गहरे हिस्सों का विश्लेषण करेंगे। x86-64 आर्किटेक्चर की पेज टेबल संरचना के संपूर्ण बिट लेआउट से लेकर, TLB शटडाउन के IPI प्रोटोकॉल, लिनक्स कर्नेल में पेज फॉल्ट के पूर्ण ट्रेस, Copy-on-Write (CoW) के भौतिक तंत्र, मेमोरी रिक्लेम (Reclaim) एल्गोरिदम और OOM Killer के स्कोर गणना सूत्र तक, हम सोर्स कोड स्तर और रजिस्टर स्तर पर निम्न-स्तर के तंत्र की पूरी तरह से व्याख्या करेंगे।
अध्याय 1: वर्चुअल मेमोरी का अस्तित्व कारण और ऐतिहासिक पृष्ठभूमि
कंप्यूटर को वर्चुअल मेमोरी की आवश्यकता क्यों है? शुरुआती कंप्यूटर सिस्टम में, प्रोग्राम सीधे भौतिक मेमोरी (RAM) के विशिष्ट पतों तक पहुँचते थे। हालाँकि, जैसे-जैसे मल्टीटास्किंग वातावरण लोकप्रिय होता गया, यह “प्रत्यक्ष भौतिक पता विनिर्देशन विधि” अपनी सीमा तक पहुँच गई।
1.1 मेमोरी सुरक्षा और प्रोसेस स्पेस का पूर्ण अलगाव
वर्चुअल मेमोरी का सबसे बड़ा उद्देश्य “सुरक्षा और स्थिरता की गारंटी” है। यदि प्रोसेस A गलती से (या दुर्भावनापूर्ण रूप से) प्रोसेस B की मेमोरी को ओवरराइट कर देता है, तो पूरा सिस्टम क्रैश हो सकता है या गोपनीय जानकारी लीक हो सकती है। वर्चुअल मेमोरी प्रत्येक प्रोसेस को यह भ्रम देती है कि “उसके पास अपना स्वयं का निरंतर मेमोरी स्पेस है”। नतीजतन, प्रक्रियाओं के बीच मेमोरी को हार्डवेयर स्तर (MMU) पर सख्ती से अलग किया जाता है, और अनधिकृत मेमोरी एक्सेस को तुरंत ट्रैप किया जाता है और सेगमेंटेशन फॉल्ट के रूप में नियंत्रित किया जाता है। यूजर स्पेस और कर्नेल स्पेस का अलगाव भी इसी तंत्र द्वारा महसूस किया जाता है, और प्रिविलेज रिंग के संक्रमण और मेमोरी एक्सेस अधिकारों की जाँच हार्डवेयर द्वारा हर साइकिल में की जाती है।
1.2 भौतिक मेमोरी क्षमता की बाधा को तोड़ना और डिमांड पेजिंग की अवधारणा
एप्लिकेशन द्वारा आवश्यक मेमोरी की मात्रा का स्थापित भौतिक RAM की क्षमता से अधिक होना असामान्य नहीं है। वर्चुअल मेमोरी उन मेमोरी क्षेत्रों (पेज) को जो वर्तमान में उपयोग में नहीं हैं, सेकेंडरी स्टोरेज (HDD/SSD) में स्वैप (Swap out) करती है, और जब उनकी आवश्यकता होती है तो उन्हें वापस लोड (Swap in) करती है, जिससे भौतिक मेमोरी से भी बड़ा एक विशाल एड्रेस स्पेस प्रदान किया जाता है। इसके अलावा, प्रोग्राम के निष्पादन की शुरुआत में सभी कोड और डेटा को मेमोरी में लोड करने के बजाय, “डिमांड पेजिंग” (Demand Paging) की अवधारणा, जो उन्हें मेमोरी में केवल तभी लोड करती है जब उन्हें एक्सेस किया जाता है, मेमोरी बचत और तेज़ स्टार्टअप दोनों प्राप्त करती है।
1.3 सेगमेंटेशन से पेजिंग तक पैराडाइम शिफ्ट
शुरुआती x86 (जैसे 80286) में, “सेगमेंटेशन”, जो मेमोरी को वेरिएबल-लेंथ ब्लॉक में प्रबंधित करता है, का उपयोग किया गया था। यह एक ऐसी विधि है जो CS (कोड सेगमेंट) और DS (डेटा सेगमेंट) जैसे रजिस्टरों का उपयोग करके बेस एड्रेस + ऑफसेट के साथ लॉजिकल एड्रेस की गणना करती है। हालांकि, सेगमेंटेशन में “बाहरी विखंडन” (External Fragmentation) होने की संभावना थी और प्रबंधन बहुत जटिल था। बाद में, 80386 के आगमन के साथ, “पेजिंग”, जो मेमोरी को फिक्स्ड-लेंथ (आमतौर पर 4KB) ब्लॉक में प्रबंधित करती है, पेश की गई और मुख्यधारा बन गई। आधुनिक 64-बिट OS (लिनक्स और विंडोज) ने सेगमेंटेशन को फ्लैट मेमोरी मॉडल (बेस एड्रेस 0, अधिकतम सीमा) के रूप में प्रभावी रूप से अक्षम कर दिया है, और केवल पेजिंग का उपयोग करके मेमोरी प्रबंधन करते हैं। सेगमेंटेशन का वर्तमान में उपयोग केवल कुछ उद्देश्यों के लिए किया जाता है, जैसे थ्रेड-लोकल स्टोरेज (TLS) का संदर्भ देना (FS/GS रजिस्टर)।
अध्याय 2: x86-64 में पेज टेबल की बहु-स्तरीय संरचना और बिट लेआउट का संपूर्ण विश्लेषण
64-बिट आर्किटेक्चर (x86-64/AMD64) में, वर्चुअल एड्रेस स्पेस बहुत विशाल है। वर्तमान मुख्यधारा के “48-बिट वर्चुअल एड्रेस स्पेस” में, हार्डवेयर MMU 4-स्तरीय पेज टेबल को स्कैन करता है।
2.1 48-बिट/57-बिट वर्चुअल एड्रेस स्पेस और कैनोनिकल फॉर्म (Canonical Form) की बाधाएं
हालांकि 64-बिट रजिस्टर 16 एक्साबाइट के विशाल एड्रेस स्पेस को प्रदर्शित कर सकते हैं, वर्तमान हार्डवेयर कार्यान्वयन लागत और जटिलता के दृष्टिकोण से उन सभी का उपयोग नहीं करते हैं। 48-बिट कार्यान्वयन में एक बाधा है कि वर्चुअल एड्रेस के बिट 47 से 63 तक सभी का मान समान होना चाहिए (चिह्न विस्तार / Sign Extension)। इस बाधा को पूरा करने वाले पते को “कैनोनिकल एड्रेस” (Canonical Address) कहा जाता है।
नतीजतन, मेमोरी स्पेस की संरचना ऐसी होती है कि इसके केंद्र में एक विशाल अप्रयुक्त क्षेत्र (Non-canonical hole) होता है, और यह बड़े करीने से निचले आधे भाग में यूजर स्पेस (0x0000000000000000 से 0x00007FFFFFFFFFFF) और ऊपरी आधे भाग में कर्नेल स्पेस (0xFFFF800000000000 से 0xFFFFFFFFFFFFFFFF) में विभाजित होता है। यदि कोई अमान्य पॉइंटर (उदाहरण के लिए, एक पॉइंटर जिसके सबसे महत्वपूर्ण बिट में मेटाडेटा एम्बेडेड हो) को डीरेफरेंस किया जाता है, तो MMU तुरंत एक कैनोनिकल उल्लंघन के रूप में एक सामान्य सुरक्षा अपवाद (General Protection Exception, #GP) उत्पन्न करता है। हाल के वर्षों में, Intel Ice Lake और उसके बाद के प्रोसेसर पर, इस 57-बिट वर्चुअल स्पेस (5-स्तरीय पेज टेबल) का एक विस्तारित संस्करण भी समर्थित होना शुरू हो गया है, जो पेटाबाइट-स्केल मेमोरी को संभालने वाले क्लाउड इन्फ्रास्ट्रक्चर की नींव बन गया है।
2.2 4-स्तरीय पेज टेबल की पदानुक्रमित संरचना (PML4, PDPT, PD, PT) का विवरण
48-बिट वर्चुअल एड्रेस को भौतिक एड्रेस में बदलने के लिए, x86-64 पेज टेबल (रेडिक्स ट्री जैसी डेटा संरचना) के 4 पदानुक्रमों का उपयोग करता है। प्रत्येक टेबल का आकार 4KB होता है और यह 512 64-बिट (8 बाइट) प्रविष्टियाँ (entries) संग्रहीत करता है (2^9 = 512)। वर्चुअल एड्रेस को निम्नानुसार विभाजित किया जाता है और यह प्रत्येक पदानुक्रम के लिए एक सूचकांक (index) के रूप में कार्य करता है।
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - उच्चतम स्तर। CR3 रजिस्टर भौतिक बेस एड्रेस को इंगित करता है।
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - 2MB HugePage के मामले में, यह टर्मिनल बन जाता है।
- Bits 12-20 (9 bits): PT (Page Table) Index - सामान्य 4KB पेज के लिए अंतिम टेबल।
- Bits 0-11 (12 bits): Page Offset - 4KB (4096 बाइट्स) पेज के भीतर ऑफसेट।
2.3 पेज टेबल एंट्री (PTE) का 64-बिट लेआउट संपूर्ण चार्ट
पेज टेबल की प्रत्येक 64-बिट प्रविष्टि केवल भौतिक पते का पॉइंटर नहीं है, बल्कि शक्तिशाली एक्सेस नियंत्रण और कैश नियंत्रण को प्रबंधित करने वाले मेटाडेटा का एक संग्रह है। नीचे x86-64 PTE का पूर्ण बिट लेआउट और इसके विस्तृत कार्य दिए गए हैं।
- Bit 0 [P] Present: यदि 1 है, तो यह भौतिक मेमोरी पर मौजूद है। यदि 0 है, तो इसे स्वैप आउट कर दिया गया है, या अनअलोकेटेड है। 0 होने पर एक्सेस करने से पेज फॉल्ट (#PF) अपवाद उत्पन्न होता है।
- Bit 1 [R/W] Read/Write: यदि 0 है, तो रीड-ओनली (गैर-लिखने योग्य)। यदि 1 है, तो रीड/राइट संभव है। CoW (Copy-on-Write) के कार्यान्वयन में अत्यंत महत्वपूर्ण भूमिका निभाता है।
- Bit 2 [U/S] User/Supervisor: यदि 0 है, तो केवल प्रिविलेज्ड मोड (कर्नेल) एक्सेस कर सकता है। यदि 1 है, तो इसे यूजर मोड (रिंग 3) से भी एक्सेस किया जा सकता है। KPTI और SMAP जैसी चीजों द्वारा सख्ती से प्रबंधित।
- Bit 3 [PWT] Page-level Write-Through: यदि 1 है, तो इस पेज के लिए कैश राइट पॉलिसी को राइट-थ्रू पर सेट करें। यदि 0 है, तो राइट-बैक।
- Bit 4 [PCD] Page-level Cache Disable: यदि 1 है, तो इस पेज के कैश को अक्षम (Uncacheable) करें। मेमोरी-मैप्ड I/O (MMIO) आदि में सीधे PCIe डिवाइस के रजिस्टर तक पहुँचने के लिए उपयोग किया जाता है।
- Bit 5 [A] Accessed: जब MMU इस पेज को एक्सेस (रीड या राइट) करता है, तो हार्डवेयर द्वारा इसे स्वचालित रूप से 1 पर सेट किया जाता है। OS के LRU एल्गोरिदम (पेज रिक्लेम) में रेफरेंस बिट के रूप में उपयोग किया जाता है।
- Bit 6 [D] Dirty: जब MMU इस पेज पर “राइट” करता है, तो हार्डवेयर द्वारा इसे स्वचालित रूप से 1 पर सेट किया जाता है। OS के लिए यह निर्धारित करने के लिए आवश्यक बिट कि क्या डिस्क पर राइट-बैक (स्वैप आउट) आवश्यक है।
- Bit 7 [PAT] Page Attribute Table: PWT/PCD के संयोजन में अधिक विस्तृत मेमोरी कैश प्रकार (WC: Write-Combining, आदि) निर्दिष्ट करने के लिए एक सूचकांक। ग्राफ़िक्स मेमोरी (VRAM) में उच्च गति वाले बल्क ट्रांसफर आदि के लिए उपयोग किया जाता है।
- Bit 8 [G] Global: यदि 1 है, तो CR3 रजिस्टर स्विच होने (कॉन्टेक्स्ट स्विच होने) पर भी TLB से इस प्रविष्टि को फ्लश न करें। मुख्य रूप से कर्नेल स्पेस पेजों में उपयोग किया जाता है, जिससे सिस्टम कॉल के दौरान TLB मिस पेनल्टी से बचा जा सके।
- Bits 9-11 [AVL] Available: 3 बिट जिनका OS (कर्नेल) स्वतंत्र रूप से उपयोग कर सकता है। लिनक्स में, इसका उपयोग स्वैप एंट्री मेटाडेटा या NUMA नोड पहचान आदि के लिए किया जा सकता है।
- Bits 12-51 [PFN] Physical Frame Number: गंतव्य भौतिक पेज का बेस एड्रेस (भौतिक फ्रेम संख्या)। चूंकि यह 4KB अलाइन है, निचले 12 बिट्स को हमेशा 0 माना जाता है।
- Bits 52-62 [AVL/PKU] Available/Ignored: CPU जनरेशन और फीचर एक्सटेंशन (Intel MPK: Memory Protection Keys आदि) द्वारा आरक्षित, या OS उपयोग योग्य क्षेत्र।
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: यदि 1 है, तो इस पेज पर डेटा “निर्देश के रूप में निष्पादन योग्य नहीं” है। बफर ओवरफ्लो आदि के कारण डेटा क्षेत्र में कोड इंजेक्शन हमलों को रोकने के लिए शक्तिशाली सुरक्षा तंत्र (DEP: Data Execution Prevention)।
इस तरह, PTE का प्रत्येक बिट OS के मेमोरी प्रबंधन एल्गोरिदम (विशेष रूप से स्वैप प्रोसेसिंग, सुरक्षा संरक्षण और I/O नियंत्रण) के साथ कसकर एकीकृत है, और हार्डवेयर और सॉफ़्टवेयर के बीच की सीमा पर एक इंटरफ़ेस के रूप में एक अत्यंत परिष्कृत डिज़ाइन है।
अध्याय 3: MMU द्वारा हार्डवेयर पेज टेबल वॉक और देरी की बाधा
वर्चुअल एड्रेस से भौतिक एड्रेस में रूपांतरण CPU कोर के अंदर एक समर्पित हार्डवेयर सर्किट द्वारा किया जाता है जिसे MMU (Memory Management Unit) कहा जाता है।
3.1 CR3 रजिस्टर से शुरू होने वाला टेबल वॉक मैकेनिज्म
प्रोसेसर के कंट्रोल रजिस्टर CR3 में वर्तमान में निष्पादित हो रहे प्रोसेस के टॉप-लेवल पेज टेबल (PML4) का भौतिक पता होता है। जब लिनक्स जैसे OS किसी अन्य प्रोसेस को CPU का निष्पादन अधिकार देने के लिए कॉन्टेक्स्ट स्विच करते हैं, तो वे इस CR3 रजिस्टर को नए प्रोसेस के PML4 पते पर फिर से लिखते हैं। यह तुरंत प्रोसेस के पूरे मेमोरी स्पेस को स्विच कर देता है।
वैचारिक प्रवाह नीचे दिखाया गया है:
- वर्चुअल एड्रेस का टॉप-लेवल इंडेक्स निकाला जाता है, और CR3 द्वारा इंगित PML4 टेबल की संबंधित प्रविष्टि पढ़ी जाती है।
- PML4 प्रविष्टि के PFN को निकाला जाता है, और अगली PDPT टेबल का भौतिक पता परिकलित किया जाता है।
- PDPT टेबल की संबंधित प्रविष्टि पढ़ी जाती है।
- इसी तरह, PD टेबल और PT टेबल को ट्रेस किया जाता है, और अंतिम 4KB भौतिक पेज का बेस एड्रेस प्राप्त किया जाता है।
- अंत में, 12-बिट पेज ऑफसेट जोड़ा जाता है, और एक पूर्ण भौतिक पता बनाया जाता है।
3.2 मेमोरी बस एक्सेस और विलंबता (Latency) की सबसे बड़ी बाधा
इस 4-स्तरीय पेज टेबल वॉक की सबसे बड़ी कमजोरी “मेमोरी एक्सेस लेटेंसी” है। केवल एक वर्चुअल एड्रेस को बदलने पर, सबसे खराब स्थिति में, भौतिक मेमोरी तक 4 एक्सेस (PML4, PDPT, PD, PT पढ़ना) होते हैं। आधुनिक DRAM की एक्सेस लेटेंसी लगभग 50-100 नैनोसेकंड है। यदि सभी 4 मेमोरी एक्सेस CPU के कैश (L1/L2/L3) से चूक जाते हैं और DRAM तक पहुँचते हैं, तो अकेले इसके कारण सैकड़ों नैनोसेकंड का स्टॉल हो जाएगा। यह देखते हुए कि CPU की क्लॉक साइकिल लगभग 0.3 नैनोसेकंड (3GHz) है, यह एक घातक देरी है जो हजारों साइकिल के बराबर है, और CPU की पाइपलाइन पूरी तरह से समाप्त होकर रुक जाएगी। इस अत्यंत गंभीर प्रदर्शन बाधा को पार करने के लिए डिज़ाइन किया गया समाधान TLB है, जिसे आगे समझाया जाएगा।
अध्याय 4: मल्टी-कोर वातावरण में TLB का आर्किटेक्चर और शटडाउन की दुविधा
TLB (Translation Lookaside Buffer) MMU में निर्मित “वर्चुअल एड्रेस से भौतिक एड्रेस में अनुवाद परिणामों का कैश” है, और यह अल्ट्रा-हाई-स्पीड SRAM (या CAM: Content Addressable Memory) से बना है।
4.1 TLB की पदानुक्रमित संरचना और PCID (Process-Context Identifier) द्वारा अनुकूलन
नवीनतम CPU में, TLB में L1/L2 पदानुक्रमित संरचना भी होती है। L1 D-TLB (डेटा के लिए) और L1 I-TLB (निर्देशों के लिए) में बहुत कम क्षमता (दसियों प्रविष्टियाँ) होती है, लेकिन वे 1 साइकिल में प्रतिक्रिया करते हैं। L2 TLB में सैकड़ों से हजारों प्रविष्टियाँ होती हैं और यह कई साइकिलों में प्रतिक्रिया करता है। यदि TLB में कोई प्रविष्टि नहीं है (TLB मिस), तो ऊपर वर्णित हार्डवेयर टेबल वॉक (पेज वॉक) होता है। इसका समर्थन करने के लिए, पेज वॉक के लिए समर्पित एक कैश (PWC: Page Walk Cache) भी लागू किया गया है।
चूंकि प्रोसेस स्विच होने पर वर्चुअल एड्रेस का अर्थ बदल जाता है, अतीत में (शुरुआती x86 में), CR3 को फिर से लिखते समय TLB को पूरी तरह से मिटा (Flush) दिया जाता था। हालांकि, इसके कारण कॉन्टेक्स्ट स्विच के तुरंत बाद कई TLB मिस होते थे, जिससे प्रदर्शन में काफी गिरावट आती थी। इसे हल करने के लिए जो तकनीक पेश की गई, वह PCID (Process-Context Identifier) है (इसे ARM आर्किटेक्चर में ASID कहा जाता है)। TLB प्रविष्टि को विशिष्ट रूप से प्रोसेस की पहचान करने वाला 12-बिट आईडी (टैग) देकर, कॉन्टेक्स्ट स्विच के बाद भी पिछले प्रोसेस की TLB प्रविष्टि को बनाए रखना संभव हो गया, जिससे वेब सर्वर और डेटाबेस जैसे मल्टी-प्रोसेस वातावरण में प्रदर्शन में नाटकीय रूप से सुधार हुआ।
4.2 TLB शटडाउन (TLB Shootdown) का इंटर-प्रोसेसर इंटरप्ट (IPI) प्रोटोकॉल
मल्टी-कोर वातावरण में, वर्चुअल मेमोरी सिस्टम को एक बहुत ही पेचीदा सिंक्रोनाइज़ेशन समस्या का सामना करना पड़ता है। उदाहरण के लिए, मान लें कि कोर 0 (CPU0) पर चल रहा एक प्रोसेस munmap() के साथ एक विशिष्ट मेमोरी क्षेत्र को मुक्त करता है, और पेज टेबल के PTE को अमान्य (Present = 0) कर देता है। हालाँकि, कोर 1 (CPU1) के स्थानीय TLB में, वर्चुअल एड्रेस से भौतिक एड्रेस तक की “पुरानी अनुवाद जानकारी (Stale TLB Entry)” अभी भी कैश के रूप में मौजूद हो सकती है।
यदि यह स्थिति बनी रहती है, तो कोर 1 मुक्त की गई मेमोरी को एक्सेस कर लेगा, जो अन्य प्रक्रियाओं को आवंटित डेटा को नष्ट कर सकता है, या गोपनीय जानकारी पढ़ सकता है, जिससे एक गंभीर सुरक्षा छेद हो सकता है। इसे रोकने के लिए, OS को कोर 1 के TLB से उस प्रविष्टि को बलपूर्वक हटाने की आवश्यकता होती है। यही TLB शटडाउन (TLB Shootdown) है।
TLB शटडाउन को निम्नलिखित चरणों (IPI प्रोटोकॉल) में सख्ती से निष्पादित किया जाता है:
- इनिशिएटर (कोर 0): पेज टेबल (PTE को साफ़ करना) को अपडेट करने के बाद, यह एक मेमोरी बैरियर (
mfenceआदि) जारी करता है, और लक्षित अन्य कोर (कोर 1) के स्थानीय APIC (Advanced Programmable Interrupt Controller) को एक IPI (Inter-Processor Interrupt: प्रोसेसर के बीच इंटरप्ट) भेजता है। - प्रतीक्षा (बिजी-वेट): कोर 0 स्पिन-लॉक के साथ तब तक प्रतीक्षा करता है जब तक कि अन्य सभी लक्ष्य कोर इंटरप्ट को संसाधित करना समाप्त नहीं कर लेते।
- लक्ष्य (कोर 1): IPI प्राप्त करने पर, यह तुरंत वर्तमान में चल रहे उपयोगकर्ता कोड को बाधित करता है और कर्नेल के इंटरप्ट हैंडलर (लिनक्स में,
smp_call_functionके माध्यम सेflush_tlb_funcआदि) में संक्रमण करता है। - फ्लश निष्पादन: कोर 1 अपने स्थानीय TLB से निर्दिष्ट वर्चुअल एड्रेस की प्रविष्टि को अमान्य कर देता है (x86 में,
INVLPGनिर्देश का उपयोग किया जाता है, पूर्ण फ्लश के मामले में, CR3 को फिर से लोड किया जाता है)। - पूर्णता अधिसूचना: कोर 1 मेमोरी में एक फ्लैग पर फ्लश के पूरा होने को लिखता है, और कोर 0 की प्रतीक्षा को मुक्त करता है। उसके बाद, यह उस प्रक्रिया पर वापस लौटता है जो बाधित हो गई थी (
iret)।
प्रदर्शन बाधाएं और स्केलेबिलिटी सीमाएं: चूंकि TLB शटडाउन में हार्डवेयर IPI जारी करना, इंटरप्ट के लिए कॉन्टेक्स्ट स्विचिंग, पाइपलाइन को फ्लश करना, और कई कोर के बीच स्पिन-लॉक प्रतीक्षा शामिल है, यह एक अत्यंत उच्च लागत वाला ऑपरेशन है जो हजारों से दसियों हज़ार साइकिल की खपत करता है। जैसे-जैसे कोर की संख्या 16, 64, और 128 तक बढ़ती है, यह सिंक्रनाइज़ेशन लागत घातीय रूप से बढ़ती है, जो क्लाउड सर्वर और HPC में मल्टी-थ्रेडेड अनुप्रयोगों (विशेष रूप से वे जो अक्सर मेमोरी आवंटित और मुक्त करते हैं) के लिए एक गंभीर स्केलिंग बाधा बन गई है।
अध्याय 5: लिनक्स कर्नेल में पेज फॉल्ट प्रोसेसिंग का पूर्ण ट्रेस
जब कोई प्रोग्राम पेज टेबल के एक क्षेत्र को एक्सेस करता है जहाँ Present बिट 0 है, या एक ऐसे क्षेत्र को जिसे एक्सेस करने का अधिकार नहीं है (जैसे रीड-ओनली में लिखने की कोशिश करना, यूजर मोड से कर्नेल क्षेत्र तक पहुँचना, आदि), तो MMU एक पेज फॉल्ट अपवाद (x86 में Exception 14, #PF) जारी करता है। यहाँ से, लिनक्स कर्नेल की एक्सेप्शन हैंडलिंग की गहरी दुनिया की यात्रा शुरू होती है।
5.1 पेज फॉल्ट का कंट्रोल फ्लो और आर्किटेक्चर-डिपेंडेंट पार्ट का ट्रेस
x86-64 लिनक्स कर्नेल में, जब पेज फॉल्ट होता है तो फंक्शन कॉल ग्राफ़ (कॉल ट्रेस) कुछ इस तरह दिखता है। नियंत्रण आर्किटेक्चर-निर्भर निम्न-स्तरीय हैंडलर से आर्किटेक्चर-स्वतंत्र सामान्य मेमोरी प्रबंधन सबसिस्टम में स्थानांतरित होता है।
asm_exc_page_fault(असेंबली भाषा: arch/x86/entry/entry_64.S)- CPU अपवाद का पता लगाता है, हार्डवेयर फॉल्ट वाले वर्चुअल एड्रेस को
CR2रजिस्टर में सेट करता है, रजिस्टर स्टेट को इंटरप्ट स्टैक में सहेजता है, और कर्नेल के एंट्री पॉइंट पर जंप करता है।
- CPU अपवाद का पता लगाता है, हार्डवेयर फॉल्ट वाले वर्चुअल एड्रेस को
exc_page_fault()(C भाषा: arch/x86/mm/fault.c)- यह एक आर्किटेक्चर-निर्भर फॉल्ट हैंडलर है। यह एरर कोड (Read/Write, User/Kernel, PF, आदि) का विश्लेषण करता है और इंटरप्ट कॉन्टेक्स्ट की जाँच करता है।
do_page_fault()/do_user_addr_fault()- यह निर्धारित करता है कि क्या फॉल्ट कर्नेल स्पेस (बग या vmalloc क्षेत्र, आदि) या यूजर स्पेस में हुआ है। यूजर स्पेस के मामले में, यह लक्ष्य प्रोसेस के मेमोरी मैप (
vm_area_structकी रेड-ब्लैक ट्री/VMA लिस्ट) की खोज करता है और जांचता है कि क्या पता एक वैध क्षेत्र का है (कि यह सेगमेंटेशन फॉल्ट नहीं है)।
- यह निर्धारित करता है कि क्या फॉल्ट कर्नेल स्पेस (बग या vmalloc क्षेत्र, आदि) या यूजर स्पेस में हुआ है। यूजर स्पेस के मामले में, यह लक्ष्य प्रोसेस के मेमोरी मैप (
handle_mm_fault()(C भाषा: mm/memory.c)- यहाँ से, आर्किटेक्चर-स्वतंत्र कोर फ़ंक्शन शुरू होते हैं। यह पेज टेबल (PGD -> P4D -> PUD -> PMD -> PTE) के प्रत्येक पदानुक्रम को स्कैन करता है, और यदि टेबल अभी तक आवंटित नहीं की गई है, तो यह अंतिम PTE के पते की पहचान करते हुए एक नई मध्यवर्ती निर्देशिका (जैसे
pmd_alloc) आवंटित करता है।
- यहाँ से, आर्किटेक्चर-स्वतंत्र कोर फ़ंक्शन शुरू होते हैं। यह पेज टेबल (PGD -> P4D -> PUD -> PMD -> PTE) के प्रत्येक पदानुक्रम को स्कैन करता है, और यदि टेबल अभी तक आवंटित नहीं की गई है, तो यह अंतिम PTE के पते की पहचान करते हुए एक नई मध्यवर्ती निर्देशिका (जैसे
5.2 मेमोरी आवंटन का सार: handle_mm_fault से ब्रांचिंग
handle_mm_fault(), पहचाने गए PTE की स्थिति के आधार पर (क्या PTE खाली है, स्वैप आउट किया गया है, या अनुमति त्रुटि है), वास्तविक पेज आवंटन प्रक्रिया को शाखाबद्ध करता है।
do_anonymous_page()(डिमांड पेजिंग का चरम): जब PTE पूरी तरह से खाली (शून्य) हो तो इसे कॉल किया जाता है। यह एक गुमनाम पेज (Anonymous Page) तक पहली पहुँच है जो किसी फ़ाइल से बंधा नहीं है, जैसे हीप (malloc के पीछेbrkयाmmap) या स्टैक का विस्तार। कर्नेल यहाँ पहली बार बडी सिस्टम (Buddy System) से भौतिक मेमोरी (फ्रेम) को सुरक्षित करता है, इसे शून्य कर देता है, और इसे PTE में मैप करता है। इससे अप्रयुक्त मेमोरी की बचत होती है।do_fault()/__do_fault()(फाइल-बैक्ड पेजिंग): इसेmmapकी गई फ़ाइल आदि तक पहली पहुँच पर कॉल किया जाता है। यह पेज कैश से फ़ाइल डेटा पढ़ता है, या डिस्क से डेटा लोड करने के लिए फ़ाइल सिस्टम (ext4 या xfs) के ड्राइवर को कॉल करता है, और इसे पेज टेबल में मैप करता है।do_swap_page()(स्वैप-इन का दर्द): इसे तब कॉल किया जाता है जब PTE का Present बिट 0 होता है, लेकिन स्वैप क्षेत्र की ऑफसेट जानकारी एक अन्य फ्लैग बिट में दर्ज की गई होती है। यह डिस्क (स्वैप विभाजन या स्वैप फ़ाइल) से डेटा को वापस भौतिक मेमोरी में लोड करता है। चूँकि इसमें डिस्क I/O शामिल है, प्रोसेस यहाँ लंबे समय तक स्लीप (ब्लॉक) स्थिति में प्रवेश करता है।do_wp_page()(Copy-on-Write): यह CoW प्रक्रिया है जिसे बाद में समझाया जाएगा। इसे तब कॉल किया जाता है जब Present=1 हो, लेकिन आप एक ऐसे पेज पर लिखने का प्रयास करते हैं जिसके पास राइट अनुमतियाँ नहीं हैं।
5.3 Copy-on-Write (CoW) का भौतिक तंत्र और संदर्भ गणना (Reference Count) का जादू
लिनक्स प्रोसेस निर्माण की कुंजी, fork() सिस्टम कॉल, CoW (Copy-on-Write) नामक लेज़ी इवैल्यूएशन मैकेनिज्म के कारण अत्यधिक तेज़ गति से काम करती है। हम उस भौतिक तंत्र की व्याख्या करेंगे जिसके पीछे fork() एक पल में पूरा हो जाता है, भले ही पेरेंट प्रोसेस कई गीगाबाइट मेमोरी का उपयोग कर रहा हो।
- पेज टेबल शेयरिंग:
जब
fork()को कॉल किया जाता है, तो कर्नेल पैरेंट प्रोसेस की पेज टेबल को चाइल्ड प्रोसेस में ज्यों का त्यों कॉपी कर देता है। हालाँकि, भौतिक मेमोरी को बिल्कुल भी कॉपी नहीं किया जाता है। पैरेंट और चाइल्ड के PTE बिल्कुल उसी भौतिक मेमोरी (फ्रेम) की ओर इशारा करते हैं। - रीड-ओनली बिट का जबरन सेट होना (Write-Protect):
इस समय, कर्नेल सभी साझा पेजों के PTE के
R/Wबिट को बलपूर्वक0(रीड-ओनली) कर देता है (उन सभी डेटा क्षेत्रों सहित जो मूल रूप से लिखने योग्य थे)। - संदर्भ गणना (Reference Count) की वृद्धि:
यह लक्षित भौतिक पेज को प्रबंधित करने वाले कर्नेल स्ट्रक्चर (
struct pageके_refcount) को बढ़ाता है, और इसे “दो प्रक्रियाओं द्वारा संदर्भित” स्थिति में रखता है। - राइट और पेज फॉल्ट (do_wp_page को ट्रिगर करना):
जब या तो पेरेंट या चाइल्ड साझा चर या हीप क्षेत्र में राइट करने का प्रयास करता है, तो हार्डवेयर MMU
R/W=0का पता लगाता है और तुरंत एक पेज फॉल्ट उत्पन्न करता है। - पेज का डुप्लीकेशन (Duplication):
पेज फॉल्ट हैंडलर से
do_wp_page()को कॉल किया जाता है। कर्नेल VMA फ्लैग की जाँच करता है और यह निर्धारित करता है कि “यह अनधिकृत पहुँच नहीं है, बल्कि वैध CoW के कारण एक फॉल्ट है”। यह बडी सिस्टम से एक नया भौतिक पेज सुरक्षित करता है और मूल पेज के पूरे डेटा को कॉपी (copy_page) करता है। - PTE अपडेट और संदर्भ गणना में कमी:
जिस प्रोसेस ने राइट किया था, उसका PTE नए भौतिक पेज की ओर पुनर्निर्देशित किया जाता है, और
R/Wबिट को1(Read/Write संभव) पर सेट किया जाता है। फिर मूल भौतिक पेज की संदर्भ गणना कम हो जाती है। यदि संदर्भ गणना 1 हो जाती है, तो इसका मतलब है कि दूसरी प्रक्रिया उस पेज पर एकाधिकार कर रही है, इसलिए अगली बार जब वह प्रक्रिया फॉल्ट का कारण बनती है, तो उसे मेमोरी को कॉपी करने की आवश्यकता नहीं होती है, बल्कि केवल R/W बिट को वापस 1 पर सेट करना पड़ता है (पेज का पुन: उपयोग)।
इस तरह, CoW एक कलात्मक एल्गोरिदम है जो MMU के हार्डवेयर सुरक्षा फ़ंक्शन (रीड-ओनली ट्रैप) और कर्नेल के सॉफ़्टवेयर नियंत्रण को शानदार ढंग से जोड़ता है, जिससे नाटकीय रूप से मेमोरी की बचत होती है और प्रोसेस का तेज़ स्टार्टअप प्राप्त होता है।
अध्याय 6: मेमोरी रिक्लेम (Reclaim) एल्गोरिदम की गहराई और OOM Killer की सजा
भौतिक मेमोरी सीमित है। जब कोई सिस्टम लंबे समय तक चलता है और फाइल कैश और प्रोसेस हीप मेमोरी को खत्म कर देते हैं, तो OS को नई मेमोरी सुरक्षित करने के लिए मौजूदा मेमोरी क्षेत्रों को मुक्त और रिक्लेम (पुनर्प्राप्त) करना चाहिए। यह मेमोरी रिक्लेम सबसिस्टम लिनक्स कर्नेल में सबसे जटिल और कठिन क्षेत्रों में से एक है।
6.1 एक्टिव/इनएक्टिव LRU लिस्ट और स्यूडो (Pseudo) LRU एल्गोरिदम
भौतिक पेजों को प्रबंधित और ट्रैक करने के लिए लिनक्स कर्नेल LRU (Least Recently Used) लिस्ट का उपयोग करता है। हालांकि, लॉक विवाद और स्कैनिंग लागत के संदर्भ में सख्त LRU के साथ सभी पेजों का प्रबंधन करना असंभव है। इसलिए, यह “एक्टिव लिस्ट” (Active List) और “इनएक्टिव लिस्ट” (Inactive List) (क्लॉक एल्गोरिदम का एक व्युत्पन्न) के दो कतारों (सूचियों) का उपयोग करके एक स्यूडो-LRU एल्गोरिदम (Pseudo-LRU) को अपनाता है।
- एक्टिव लिस्ट: “हॉट” (Hot) पेजों का एक संग्रह जो हाल ही में अक्सर एक्सेस किए गए हैं। ये रिक्लेम के अधीन नहीं हैं।
- इनएक्टिव लिस्ट: “कोल्ड” (Cold) पेजों का एक संग्रह जिन्हें कुछ समय के लिए एक्सेस नहीं किया गया है। अंत (tail) वाले पेजों से शुरू होकर, वे रिक्लेमेशन के उम्मीदवार बन जाते हैं।
कर्नेल को कैसे पता चलता है कि किसी पेज को एक्सेस किया गया है? यहीं पर अध्याय 2 में वर्णित PTE का Accessed बिट (A बिट) चलन में आता है। कर्नेल (kswapd) समय-समय पर पेज टेबल को स्कैन करता है, PTE से A बिट पढ़ता है, सॉफ़्टवेयर पक्ष में एक्सेस इतिहास रिकॉर्ड करता है, और फिर A बिट को 0 पर साफ़ कर देता है। यदि हार्डवेयर द्वारा A बिट को फिर से 1 पर सेट किया जाता है, तो पेज एक्टिव लिस्ट में रहेगा या इनएक्टिव से पदोन्नत हो जाएगा। यदि यह सेट नहीं है, तो इसे धीरे-धीरे इनएक्टिव लिस्ट के अंत में पदावनत (Demote) कर दिया जाएगा।
6.2 kswapd डेमन और डायरेक्ट रिक्लेम (Direct Reclaim) का आतंक
जब खाली मेमोरी की मात्रा (Free Pages) एक निश्चित सीमा (वाटरमार्क: low) से नीचे आ जाती है, तो कर्नेल का बैकग्राउंड थ्रेड kswapd (जो प्रत्येक NUMA नोड के लिए मौजूद होता है) जाग जाता है।
kswapd इनएक्टिव लिस्ट के अंत से पेज निकालता है।
- यदि यह एक साफ फाइल कैश (अपरिवर्तित फ़ाइल डेटा) है, तो यह मेमोरी को खाली करने के लिए इसे छोड़ (Drop) देता है।
- यदि यह एक डर्टी (परिवर्तित) फाइल कैश है, तो इसे डिस्क पर वापस लिख (Writeback) दिया जाता है और फिर छोड़ दिया जाता है।
- यदि यह एक अनाम पेज (प्रोसेस का हीप या स्टैक) है, तो इसे स्वैप स्पेस में लिख दिया जाता है (स्वैप आउट)।
यह बैकग्राउंड का काम तब तक जारी रखता है जब तक खाली जगह
highवाटरमार्क तक नहीं पहुँच जाती।
हालाँकि, यदि एप्लिकेशन की मेमोरी आवंटन दर (मेमोरी प्रेशर) अत्यधिक अधिक है, और kswapd की रिक्लेम गति तालमेल नहीं रख सकती है और खाली मेमोरी चरम सीमा (min वाटरमार्क) से नीचे आ जाती है, तो डायरेक्ट रिक्लेम (Direct Reclaim) चालू हो जाता है।
डायरेक्ट रिक्लेम एक ऐसा तंत्र है जो मेमोरी का अनुरोध करने वाली प्रोसेस (स्वयं एप्लिकेशन) के संदर्भ में समकालिक रूप से मेमोरी रिकवरी प्रोसेसिंग (कैश को हटाना या स्वैप आउट करना) को सीधे निष्पादित करता है। जब आप डायरेक्ट रिक्लेम में प्रवेश करते हैं, तो एप्लिकेशन का निष्पादन (malloc या पेज फॉल्ट का पूरा होना) पूरी तरह से रुक (स्टॉल) जाता है, जो सैकड़ों मिलीसेकंड से लेकर कई सेकंड तक के गंभीर प्रदर्शन में गिरावट (लेटेंसी स्पाइक) का प्रत्यक्ष कारण है। डेटाबेस और रीयल-टाइम सिस्टम में, इससे बचने के लिए ट्यूनिंग (vm.swappiness और वाटरमार्क को समायोजित करना) आवश्यक है।
6.3 OOM Killer का स्कोर गणना सूत्र और प्रक्रियाओं की सजा
यदि डायरेक्ट रिक्लेम के बाद भी, स्वैप क्षेत्र समाप्त हो जाता है, कैश स्क्रैप हो जाता है, और किसी भी तरह से मेमोरी सुरक्षित नहीं की जा सकती है, तो लिनक्स कर्नेल अंतिम उपाय के रूप में OOM (Out Of Memory) Killer को बुलाता है।
सिस्टम को मेमोरी की कमी के कारण घबराहट (कर्नेल क्रैश या पूरी तरह से फ्रीज) में पड़ने से रोकने के लिए, OOM Killer बड़ी मात्रा में मेमोरी की खपत करने वाली प्रक्रियाओं को “बलपूर्वक समाप्त” (SIGKILL) करके मेमोरी को वापस ले लेता है। एक क्रूर एल्गोरिदम है जो शिकार को निर्धारित करता है।
किसे मारना है, इसका निर्णय oom_score नामक मूल्यांकन मान के आधार पर किया जाता है (कर्नेल के mm/oom_kill.c में oom_badness() फ़ंक्शन द्वारा गणना की जाती है)।
OOM स्कोर का मूल गणना तर्क (अवधारणा):
- मूल स्कोर: कुल मेमोरी के प्रतिशत के रूप में प्रोसेस द्वारा वर्तमान में उपयोग की जाने वाली मेमोरी की मात्रा (RSS: Resident Set Size + पेज टेबल का आकार + स्वैप उपयोग)। अधिकतम 1000 अंक। दूसरे शब्दों में, जो प्रोसेस जितनी अधिक मेमोरी की खपत करती है (जैसे मेमोरी लीक करने वाली प्रोसेस), उसके मारे जाने की संभावना उतनी ही अधिक होती है।
- रूट प्रिविलेज पेनल्टी शमन: रूट उपयोगकर्ता विशेषाधिकारों (जैसे सिस्टम कोर डेमन्स) के तहत चलने वाली प्रक्रियाओं के सिस्टम रखरखाव के लिए आवश्यक होने की अत्यधिक संभावना होती है, इसलिए उनके स्कोर पर थोड़ी छूट (माइनस) दी जाती है, जिससे उनके मारे जाने की संभावना कम हो जाती है।
- उपयोगकर्ता समायोजन मूल्य (OOM Score Adj):
/proc/[pid]/oom_score_adj(-1000 से +1000) का मान जोड़ा जाता है। सिस्टम एडमिनिस्ट्रेटर इसका उपयोग OOM Killer के व्यवहार को नियंत्रित करने के लिए कर सकते हैं। जिस प्रोसेस का मान -1000 पर सेट है (जैसे sshd, kubelet, डेटाबेस मास्टर प्रोसेस, आदि) वह “OOM Killer से मुक्त (अजेय)” हो जाता है।
जब OOM Killer चालू होता है, तो कर्नेल लॉग (dmesg या /var/log/messages) में “Out of memory: Killed process 1234 (java)” जैसा संदेश आउटपुट होता है, साथ ही उस समय की प्रोसेस लिस्ट, प्रत्येक स्कोर, और मेमोरी की स्थिति का विस्तृत डंप भी होता है। इस लॉग और स्कोर गणना तंत्र को समझकर, सिस्टम व्यवस्थापक अप्रत्याशित प्रक्रिया समाप्ति के कारण की जांच कर सकते हैं और उचित संसाधन सीमाएँ (cgroups और ulimit) निर्धारित कर सकते हैं।
अध्याय 7: नवीनतम अति-उच्च-गति मेमोरी तकनीक और हार्डवेयर सुरक्षा
7.1 2MB/1GB HugePages की शक्ति और THP के फायदे और नुकसान
अध्याय 3 और 4 में वर्णित TLB मिस और टेबल वॉक देरी को हल करने का एक शक्तिशाली साधन “HugePage” है। सामान्य 4KB पेजों के बजाय, 2MB (यह पेज डायरेक्टरी चरण में भौतिक पते को सीधे इंगित करता है, अर्थात PT पदानुक्रम को छोड़ देता है) या 1GB (PDPT चरण में सीधे इंगित करता है) के विशाल पेजों का उपयोग किया जाता है।
नतीजतन, एक एकल TLB प्रविष्टि एक विशाल मेमोरी क्षेत्र (4KB के 512 गुना, या 260,000 गुना) को कवर कर सकती है, इसलिए TLB मिस नाटकीय रूप से कम हो जाते हैं। बड़ी मात्रा में मेमोरी (Oracle, PostgreSQL) और वर्चुअलाइजेशन वातावरण (KVM/QEMU) को बेतरतीब ढंग से एक्सेस करने वाले डेटाबेस के लिए प्रदर्शन ट्यूनिंग के लिए HugePages का उपयोग एक शर्त बन गया है।
लिनक्स का THP (Transparent Huge Pages) एक ऐसा तंत्र है जिसमें कर्नेल का बैकग्राउंड थ्रेड (khugepaged) स्वचालित रूप से 4KB पेजों को 2MB HugePages में एकीकृत (डीफ़्रैग्मेन्ट) करता है, बिना एप्लिकेशन को इसके बारे में पता चले। हालाँकि, ऐसे वातावरण में जहाँ मेमोरी विखंडन (Fragmentation) उन्नत है, यह एकीकरण प्रक्रिया (मेमोरी कॉम्पेक्शन) स्वयं CPU की काफी खपत करती है और लेटेंसी स्पाइक्स का कारण बनती है, इसलिए रेडिस (Redis) जैसे इन-मेमोरी KVS में THP को अक्षम करने (never या madvise) की सिफारिश की जाती है।
7.2 कर्नेल पेज-टेबल आइसोलेशन (KPTI) और मेल्टडाउन (Meltdown) शमन की कीमत
2018 में खोजा गया CPU सट्टा निष्पादन (Speculative Execution) भेद्यता “मेल्टडाउन (Meltdown - CVE-2017-5754)” एक घातक हार्डवेयर दोष था जिसने उपयोगकर्ता प्रक्रियाओं को कर्नेल के मेमोरी स्पेस (कैश) को अवैध रूप से पढ़ने की अनुमति दी, जिससे हार्डवेयर की नींव हिल गई।
इसके प्रतिकार के रूप में OS पक्ष में KPTI (Kernel Page-Table Isolation) (शुरू में इसे KAISER कहा जाता था) पेश किया गया।
परंपरागत रूप से, कॉन्टेक्स्ट स्विच के ओवरहेड को कम करने减 करने के लिए, उपयोगकर्ता स्पेस के निष्पादन के दौरान भी संपूर्ण कर्नेल क्षेत्र को पेज टेबल के ऊपरी आधे हिस्से में मैप किया जाता था (यह माना जाता था कि PTE के U/S बिट के साथ विशेषाधिकार की जाँच की जाती थी, और एक्सेस को अस्वीकार कर दिया जाता था)। हालाँकि, सट्टा निष्पादन ने इस विशेषाधिकार जाँच को बायपास कर दिया।
KPTI की शुरुआत के बाद, उपयोगकर्ता के निष्पादन के दौरान एक “न्यूनतम शैडो पेज टेबल (User PGD)” का उपयोग किया जाता है जो कर्नेल के अधिकांश हिस्से को मैप नहीं करता है। जब सिस्टम कॉल या इंटरप्ट द्वारा कर्नेल स्पेस में संक्रमण होता है, तो CR3 रजिस्टर को स्विच करना और इसे पूर्ण कर्नेल पेज टेबल (Kernel PGD) के साथ फिर से लोड करना हमेशा आवश्यक होता है।
इससे सुरक्षा की पूरी तरह से गारंटी हो गई, लेकिन हर सिस्टम कॉल या इंटरप्ट के साथ उच्च लागत वाले CR3 स्विचिंग (और PCID/TLB फ्लश का प्रबंधन) होता है, इसलिए I/O-गहन अनुप्रयोगों (जैसे वेब सर्वर या DB जो Syscalls का बहुत अधिक उपयोग करते हैं) में इसके कारण कुछ प्रतिशत से लेकर दस प्रतिशत से अधिक तक का ध्यान देने योग्य प्रदर्शन ओवरहेड आया।
7.3 डायरेक्ट I/O और ज़ीरो-कॉपी तकनीक का विकास
फ़ाइल I/O को अनुकूलित करने के लिए, OS वर्चुअल मेमोरी तंत्र को उसकी सीमा तक लागू करता है।
जब mmap() सिस्टम कॉल का उपयोग किया जाता है, तो फ़ाइल की सामग्री सीधे वर्चुअल एड्रेस स्पेस में मैप की जाती है। जब एक्सेस किया जाता है, तो एक पेज फॉल्ट होता है, फ़ाइल डेटा को पेज कैश में पढ़ा जाता है, और इसे उपयोगकर्ता स्पेस से पॉइंटर के रूप में सीधे एक्सेस किया जा सकता है।
इसके अलावा, नेटवर्क ट्रांसमिशन/रिसेप्शन और स्टोरेज I/O में, कर्नेल स्पेस (पेज कैश) और उपयोगकर्ता स्पेस बफर (कॉन्टेक्स्ट स्विच से जुड़ी कॉपी) के बीच CPU द्वारा डेटा की कॉपी को खत्म करने के लिए ज़ीरो-कॉपी (Zero-Copy) तकनीक का उपयोग किया जाता है। sendfile() सिस्टम कॉल और नवीनतम io_uring तथा AF_XDP में, NIC या NVMe ड्राइव के DMA (Direct Memory Access) कंट्रोलर के साथ सहयोग करके, और पेज टेबल के PTE में हेरफेर करके कर्नेल पेज को सीधे उपयोगकर्ता स्पेस में “पुनर्निर्देशित (रीमैप)” करके, मेमोरी कॉपी का ओवरहेड पूरी तरह से शून्य कर दिया गया है। यहां भी, मूल तंत्र के रूप में पेज टेबल का कुशलतापूर्वक उपयोग किया जाता है।
निष्कर्ष
वर्चुअल मेमोरी और पेजिंग मैकेनिज्म OS कर्नेल और CPU (हार्डवेयर) द्वारा बजाई जाने वाली एक अत्यंत परिष्कृत सिम्फनी है। पेज टेबल के 1-बिट फ्लैग सेटिंग, TLB शटडाउन पर स्पिन-लॉक की पीड़ा, CoW संदर्भ गणना के मेमोरी जादू से लेकर, OOM Killer के क्रूर ह्युरिस्टिक्स तक, इसकी गहराई में कंप्यूटर विज्ञान की बुद्धिमत्ता छिपी है कि “कैसे सीमित भौतिक संसाधनों को सुरक्षित और तेज़ी से अमूर्त किया जाए, और प्रक्रियाओं को असीम होने का भ्रम दिया जाए।”
निम्न-स्तरीय तंत्र को समझना न केवल C/C++ या Rust जैसी सिस्टम प्रोग्रामिंग भाषाओं में अनुकूलन (कैश लाइन को ध्यान में रखते हुए डेटा संरचना डिज़ाइन, या mmap का प्रभावी उपयोग) के लिए आवश्यक है, बल्कि Go और Java जैसी उच्च-स्तरीय भाषाओं में गार्बेज कलेक्शन (GC) के स्टॉप-द-वर्ल्ड (STW) समय और मेमोरी एलोकेटर (jemalloc या tcmalloc) के व्यवहार को गहराई से समझने के लिए भी अनिवार्य है। सिस्टम के “जादू” के आवरण को हटाकर और हार्डवेयर और कर्नेल की धड़कन को सीधे महसूस करके, आप अधिक परिष्कृत और स्केलेबल सॉफ़्टवेयर डिज़ाइन करने में सक्षम एक उत्कृष्ट आर्किटेक्ट बनने का मार्ग प्रशस्त करेंगे।