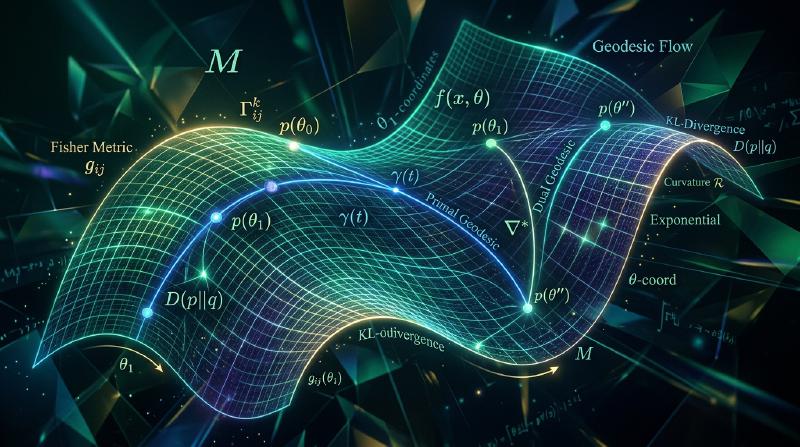
सूचना ज्यामिति (Information Geometry) जापान से उत्पन्न एक वैश्विक सिद्धांत है जो संभाव्यता वितरण (probability distributions) के स्थान में अवकल ज्यामिति (differential geometry) की संरचना का परिचय देता है, और ज्यामितीय अंतर्ज्ञान के तहत सांख्यिकीय अनुमान, मशीन लर्निंग, और सूचना सिद्धांत के सार को स्पष्ट करता है। डॉ. शुन-इची अमारी (Shun-ichi Amari) और अन्य लोगों द्वारा व्यवस्थित किया गया यह सिद्धांत, अब प्राकृतिक ग्रेडिएंट विधि (Natural Gradient Descent) का समर्थन करता है, जो एआई और डीप लर्निंग, क्वांटम सूचना सिद्धांत, और सांख्यिकीय भौतिकी जैसे विस्तृत क्षेत्रों का आधार है, और आधुनिक विज्ञान में “सामान्य भाषा” के रूप में अपनी स्थिति स्थापित कर रहा है।
इस लेख में, हम सूचना ज्यामिति की इस गहरी दुनिया को गणितीय कठोरता, ज्यामितीय अंतर्ज्ञान, और ठोस गणना उदाहरणों के साथ जितना संभव हो उतना विस्तृत और व्यवस्थित रूप से समझाएंगे। केवल गणितीय सूत्रों को सूचीबद्ध करने के बजाय, यह मौलिक प्रश्नों से शुरू होता है जैसे “संभाव्यता वितरण का स्थान क्यों घुमावदार है” और “क्यों फिशर सूचना मैट्रिक्स एक मीट्रिक टेंसर बन जाता है”, और दोहरी कनेक्शन (dual connections), एंट्रॉपी की ज्यामिति, और अत्याधुनिक मशीन लर्निंग और तंत्रिका विज्ञान के अनुप्रयोगों तक, सूचना ज्यामिति की पूरी तस्वीर को चित्रित करता है।
अध्याय 1: सूचना ज्यामिति का उदय और शुन-इची अमारी का अंतर्ज्ञान
यूक्लिडियन स्पेस के सांख्यिकी से संभाव्यता वितरण के घुमावदार स्पेस तक
शास्त्रीय सांख्यिकी और डेटा विश्लेषण में, हम अनजाने में डेटा को यूक्लिडियन स्पेस के बिंदुओं के रूप में मानते हैं। उदाहरण के लिए, जब हम पैरामीटर $\theta = (\theta_1, \theta_2, \dots, \theta_n)$ वाले एक सांख्यिकीय मॉडल पर विचार करते हैं, तो हम अक्सर पैरामीटर स्पेस को एक सपाट स्पेस मानते हैं और पैरामीटर के बीच की दूरी को सामान्य यूक्लिडियन दूरी से मापते हैं। न्यूनतम वर्ग विधि (least squares method), जो वर्ग त्रुटि को कम करती है, भी इस यूक्लिडियन ज्यामितीय अंतर्ज्ञान पर आधारित है।
हालाँकि, क्या संभाव्यता वितरण को पैरामीटराइज़ करने वाला स्पेस वास्तव में “सपाट” है?
आइए सामान्य वितरण $N(\mu, \sigma^2)$ का उदाहरण लें। पैरामीटर स्पेस माध्य $\mu$ और विचरण (variance) $\sigma^2 > 0$ से बना एक ऊपरी आधा समतल (upper half-plane) $\{(\mu, \sigma^2) \in \mathbb{R} \times \mathbb{R}_{>0}\}$ है। यहाँ, दो सामान्य वितरणों के जोड़े पर विचार करें।
- $N(0, 1)$ और $N(0.1, 1)$
- $N(0, 100)$ और $N(0.1, 100)$
यदि आप पैरामीटर की यूक्लिडियन दूरी को देखें, तो दोनों जोड़ों की दूरी $0.1$ के बराबर है। लेकिन, एक संभाव्यता वितरण के रूप में “पहचाने जाने की क्षमता (identifiability)” या “सूचना में अंतर” के दृष्टिकोण से क्या होगा? जब विचरण $1$ जितना छोटा होता है, तो माध्य में केवल $0.1$ का बदलाव वितरण के आकार को महत्वपूर्ण रूप से बदल देता है, और डेटा से दोनों के बीच अंतर करना अपेक्षाकृत आसान होता है। दूसरी ओर, जब विचरण $100$ जितना बड़ा होता है, तो वितरण सपाट रूप से फैला होता है, और भले ही माध्य $0.1$ से बदल जाता है, वितरणों का ओवरलैप बहुत बड़ा होता है, जिससे डेटा से दोनों को अलग करना बेहद मुश्किल हो जाता है।
दूसरे शब्दों में, “एक वितरण के रूप में मूल अंतर” पैरामीटर की यूक्लिडियन दूरी से मेल नहीं खाता है। बड़े विचरण वाले क्षेत्रों में, माध्य में थोड़ा बदलाव वितरण के आकार को मुश्किल से प्रभावित करता है, जबकि इसके विपरीत, छोटे विचरण वाले क्षेत्रों में यह नाटकीय परिवर्तन लाता है। यह दृढ़ता से सुझाव देता है कि संभाव्यता वितरण का पैरामीटर स्पेस एक समान नहीं है, बल्कि यह एक “घुमावदार स्पेस (Riemannian Manifold)” है जहाँ “दूरी का पैमाना स्थान के अनुसार भिन्न होता है”।
संभाव्यता वितरण परिवार एक मैनिफोल्ड (Manifold) क्यों है
सूचना ज्यामिति सांख्यिकीय मॉडलों (संभाव्यता वितरण के परिवारों) को एक अवकलनीय मैनिफोल्ड (Differentiable Manifold) के रूप में तैयार करती है।
मान लीजिए कि एक संभाव्यता स्पेस $\mathcal{X}$ पर संभाव्यता वितरण का परिवार $S$ है। जब यह परिवार $n$ निरंतर वास्तविक मापदंडों $\theta = (\theta^1, \dots, \theta^n)$ द्वारा विशिष्ट रूप से निर्दिष्ट होता है और संभाव्यता घनत्व फ़ंक्शन (probability density function) $p(x; \theta)$, $\theta$ के संबंध में सुचारू (smooth) है, तो $S$ को एक $n$-आयामी सांख्यिकीय मैनिफोल्ड (Statistical Manifold) कहा जाता है।
$$ S = \{ p(x; \theta) \mid \theta \in \Theta \subset \mathbb{R}^n \} $$यहाँ, $\theta$ मैनिफोल्ड $S$ पर “स्थानीय समन्वय प्रणाली (Local Coordinate System)” के अलावा और कुछ नहीं है। मैनिफोल्ड सिद्धांत में, एक समन्वय प्रणाली आवश्यक नहीं है, बल्कि यह केवल एक प्रतिनिधित्व (representation) है। उदाहरण के लिए, एक सामान्य वितरण के मामले में, आप मापदंडों के रूप में $(\mu, \sigma^2)$ चुन सकते हैं, या आप $(\mu, \sigma)$ या $(\frac{\mu}{\sigma^2}, -\frac{1}{2\sigma^2})$ चुन सकते हैं।
सूचना ज्यामिति का सार “समन्वय प्रणाली के विकल्प से स्वतंत्र संभाव्यता वितरण परिवार की अंतर्निहित ज्यामितीय संरचना” को स्पष्ट करना है। शुन-इची अमारी ने सी.आर. राव द्वारा प्रस्तावित अवधारणा “फिशर सूचना मैट्रिक्स को मीट्रिक के रूप में उपयोग करने वाला रीमैनियन मैनिफोल्ड” को और गहरा किया, और एफ़िन कनेक्शन (Affine Connection) की अवधारणा को पेश करके, उन्होंने संभाव्यता वितरण के स्पेस में न केवल “वक्रता (curvature)” बल्कि “सरल रेखा की अवधारणा (geodesics)” और “द्वैत (duality)” जैसी एक समृद्ध संरचना पाई।
अध्याय 2: रीमैनियन मैनिफोल्ड के रूप में सांख्यिकीय मॉडल
एक मैनिफोल्ड में “दूरी” और “कोण” को परिभाषित करने के लिए, एक रीमैनियन मीट्रिक (Riemannian Metric) आवश्यक है। सांख्यिकीय मैनिफोल्ड में एक प्राकृतिक रीमैनियन मीट्रिक क्या है?
स्कोर फ़ंक्शन और फिशर सूचना मैट्रिक्स
सांख्यिकी में, पैरामीटर के संबंध में लॉग-संभाव्यता फ़ंक्शन (log-likelihood function) $\log p(x; \theta)$ का आंशिक व्युत्पन्न (partial derivative) “स्कोर फ़ंक्शन (Score Function)” कहलाता है और यह एक महत्वपूर्ण भूमिका निभाता है।
$$ \partial_i \ell(x; \theta) = \frac{\partial}{\partial \theta^i} \log p(x; \theta) $$$$ E_\theta[\partial_i \ell(x; \theta)] = \int \frac{\partial p(x; \theta)}{\partial \theta^i} dx = \frac{\partial}{\partial \theta^i} \int p(x; \theta) dx = 0 $$$$ g_{ij}(\theta) = E_\theta \left[ \partial_i \ell(x; \theta) \partial_j \ell(x; \theta) \right] $$C.R. Rao (1945) ने इस तथ्य पर ध्यान दिया कि यह फिशर सूचना मैट्रिक्स एक धनात्मक सममित मैट्रिक्स (positive-definite symmetric matrix) है जो टेंसर (tensor) के परिवर्तन नियमों को संतुष्ट करता है, और इसे सांख्यिकीय मैनिफोल्ड के रीमैनियन मीट्रिक (फिशर मीट्रिक) के रूप में अपनाने का प्रस्ताव दिया।
$$ ds^2 = \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$नतीजतन, सांख्यिकीय मॉडल एक रीमैनियन मैनिफोल्ड $(S, G)$ बन जाता है। दो आसन्न संभाव्यता वितरण $p(x; \theta)$ और $p(x; \theta + d\theta)$ के बीच न्यूनतम “दूरी का वर्ग” इस फिशर मीट्रिक द्वारा मापा जाता है।
अपरिवर्तनीय मीट्रिक के रूप में चेन्त्सोव का प्रमेय
हमें मीट्रिक के रूप में फिशर सूचना मैट्रिक्स को क्यों चुनना चाहिए? यह कोई यादृच्छिक विचार नहीं है, बल्कि इसके पीछे एक गहरी गणितीय आवश्यकता है।
N.N. Chentsov (1972) ने सांख्यिकीय अनुमान ढांचे में आवश्यक “अपरिवर्तनीयता (Invariance)” को तैयार किया। सांख्यिकीय निष्कर्ष को डेटा के प्रतिनिधित्व या पर्याप्त आँकड़ों (मार्कोव मैपिंग) में परिवर्तन द्वारा नहीं बदला जाना चाहिए। चेन्त्सोव के प्रमेय ने एक आश्चर्यजनक तथ्य दिखाया कि “परिमित समुच्चयों पर संभाव्यता वितरण के मैनिफोल्ड पर, रीमैनियन मीट्रिक जो मार्कोव मैपिंग के तहत एकरसता (संकुचन क्षमता) को संतुष्ट करता है, एक स्थिर गुणक को छोड़कर, फिशर सूचना मीट्रिक तक सीमित है।”
दूसरे शब्दों में, संभाव्यता वितरण के स्पेस में दूरी को मापने का एकमात्र तरीका जो प्राकृतिक सांख्यिकीय आवश्यकता को पूरा करता है कि “सूचना कम नहीं होती है” वह फिशर मीट्रिक है। यह साबित करता है कि फिशर मीट्रिक सांख्यिकी के लिए विशिष्ट एक अंतर्निहित और अपरिहार्य ज्यामितीय संरचना है।
सामान्य वितरण परिवार में फिशर मीट्रिक का विशिष्ट गणना उदाहरण
$$ p(x; \mu, \sigma) = \frac{1}{\sqrt{2\pi}\sigma} \exp\left(-\frac{(x-\mu)^2}{2\sigma^2}\right) $$$$ \log p = -\log(\sqrt{2\pi}) - \log\sigma - \frac{(x-\mu)^2}{2\sigma^2} $$$$ \partial_\mu \log p = \frac{x-\mu}{\sigma^2}, \quad \partial_\sigma \log p = -\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3} $$$$ g_{\mu\mu} = E\left[ \left(\frac{x-\mu}{\sigma^2}\right)^2 \right] = \frac{1}{\sigma^2} $$$$ g_{\sigma\sigma} = E\left[ \left(-\frac{1}{\sigma} + \frac{(x-\mu)^2}{\sigma^3}\right)^2 \right] = \frac{2}{\sigma^2} $$$$ g_{\mu\sigma} = g_{\sigma\mu} = 0 $$$$ ds^2 = \frac{1}{\sigma^2} d\mu^2 + \frac{2}{\sigma^2} d\sigma^2 $$यह पोंकारे अपर हाफ-प्लेन (Poincare upper half-plane) के मीट्रिक (एक स्थिर गुणक के अंतर को छोड़कर) से पूरी तरह मेल खाता है, जो हेनरी पोंकारे (Henri Poincare) द्वारा प्रस्तावित अतिपरवलयिक ज्यामिति (हाइपरबोलिक ज्यामिति, गैर-यूक्लिडियन ज्यामिति का एक प्रकार) का एक मॉडल है। दूसरे शब्दों में, यह समझा जाता है कि सामान्य वितरण का स्थान नकारात्मक स्थिर वक्रता के साथ एक हाइपरबोलिक स्पेस है। जैसा कि हमने पहले सहज ज्ञान युक्त अनुमान लगाया था, गणितीय सूत्र भी इसकी पुष्टि करते हैं कि जहाँ $\sigma$ बड़ा है (विचरण बड़ा है), मीट्रिक टेंसर $1/\sigma^2$ छोटा हो जाता है, और पैरामीटर भिन्नता को “दूरी” के रूप में छोटा माना जाता है।
अध्याय 3: दोहरे कनेक्शन और $\alpha$-कनेक्शन की गहराई
अकेले रीमैनियन मीट्रिक स्पेस की “वक्रता” का पूरी तरह से वर्णन नहीं कर सकता है। एक एफ़िन कनेक्शन (Affine Connection) जो निर्धारित करता है कि “कौन सी दिशा सीधी है” की आवश्यकता है। शुन-इची अमारी की सबसे बड़ी उपलब्धि यह खोज थी कि सांख्यिकीय मैनिफोल्ड में असीम रूप से कई प्राकृतिक कनेक्शन हैं, और वे “द्वैत (Duality)” की एक सुंदर संरचना बनाते हैं।
$\alpha$-कनेक्शन की परिभाषा
अमारी ने वास्तविक पैरामीटर $\alpha$ का उपयोग करते हुए, $\alpha$-कनेक्शन नामक एफ़िन कनेक्शन का एक परिवार पेश किया। इसके कनेक्शन गुणांक $\Gamma_{ij,k}^{(\alpha)}$ को इस प्रकार परिभाषित किया गया है:
$$ \Gamma_{ij,k}^{(\alpha)} = E \left[ \left( \partial_i \partial_j \ell + \frac{1 - \alpha}{2} \partial_i \ell \partial_j \ell \right) \partial_k \ell \right] $$जब $\alpha = 0$, $0$-कनेक्शन लेवी-सिविटा कनेक्शन (Levi-Civita Connection) से मेल खाता है, जो फिशर मीट्रिक द्वारा विशिष्ट रूप से निर्धारित होता है। यह सामान्य रीमैनियन ज्यामिति में उपयोग किया जाने वाला कनेक्शन है। हालाँकि, सूचना ज्यामिति में सबसे महत्वपूर्ण भूमिका निभाने वाले कनेक्शन $\alpha = 1$ और $\alpha = -1$ हैं।
e-कनेक्शन, m-कनेक्शन, और दोहरा सपाट स्पेस (Dually Flat Space)
- e-कनेक्शन ($\alpha = 1$ एक्सपोनेंशियल कनेक्शन): एक कनेक्शन जो स्वाभाविक रूप से तब प्रकट होता है जब घातीय वितरण परिवारों (Exponential Family) के साथ काम किया जाता है।
- m-कनेक्शन ($\alpha = -1$ मिश्रण कनेक्शन): एक कनेक्शन जो स्वाभाविक रूप से तब प्रकट होता है जब मिश्रण वितरण परिवारों (Mixture Family) के साथ काम किया जाता है।
ये दोनों कनेक्शन फिशर मीट्रिक $g_{ij}$ के संबंध में “दोहरे (Dual)” संबंध में हैं। एक रीमैनियन मैनिफोल्ड पर, जब दो वेक्टर फ़ील्ड के आंतरिक उत्पाद (मीट्रिक) के व्युत्पन्न को संबंधित कनेक्शनों द्वारा सहसंयोजक डेरिवेटिव (covariant derivatives) के योग के रूप में व्यक्त किया जाता है, तो उन्हें दोहरे कनेक्शन कहा जाता है।
$$ X \langle Y, Z \rangle = \langle \nabla_X^{(e)} Y, Z \rangle + \langle Y, \nabla_X^{(m)} Z \rangle $$विशेष रूप से उल्लेखनीय तथ्य यह है कि एक्सपोनेंशियल वितरण परिवार (उदाहरण के लिए सामान्य वितरण, पोइसन वितरण, गामा वितरण, आदि) का स्थान e-कनेक्शन के संबंध में “सपाट (वक्रता टेंसर शून्य है)” है, और एक ही समय में, यह m-कनेक्शन के संबंध में भी “सपाट” है। ऐसे स्थान को दोहरा सपाट स्पेस (Dually Flat Space) कहा जाता है।
दोहरे सपाट स्पेस में, e-कनेक्शन के संबंध में सीधी रेखाएँ (e-geodesics) और m-कनेक्शन के संबंध में सीधी रेखाएँ (m-geodesics) हैं। इसके अलावा, इन स्थानों में, एक दोहरी समन्वय प्रणाली (प्राकृतिक पैरामीटर $\theta$ और प्रत्याशा पैरामीटर $\eta$) है जो लीजेंड्रे परिवर्तन (Legendre Transformation) द्वारा एक दूसरे से जुड़ी होती है, पैरामीटर सिस्टम के रूप में मौजूद है।
सामान्यीकृत पाइथागोरस प्रमेय
दोहरे सपाट स्पेस की सुंदरता को “सामान्यीकृत पाइथागोरस प्रमेय (Generalized Pythagorean Theorem)” में संक्षेपित किया गया है।
यूक्लिडियन स्पेस में, যখন 3 बिंदु $P, Q, R$ एक समकोण त्रिभुज बनाते हैं जहाँ $\angle PQR = 90^\circ$, तब $d(P, R)^2 = d(P, Q)^2 + d(Q, R)^2$ लागू होता है। सूचना ज्यामिति के दोहरे सपाट स्थान में, जब बिंदु $P, Q, R$ (संभाव्यता वितरण) को जोड़ने वाला वक्र e-geodesic और m-geodesic से बना होता है, और वे बिंदु $Q$ पर फिशर मीट्रिक के अर्थ में “ऑर्थोगोनल (orthogonal)” होते हैं, तो वितरणों के बीच विचलन (असममित दूरी की अवधारणा) के संबंध में निम्नलिखित समीकरण सख्ती से स्थापित होता है:
$$ D(P \parallel R) = D(P \parallel Q) + D(Q \parallel R) $$यह प्रमेय सांख्यिकी में सूचना मापदंड (information criteria), मशीन लर्निंग में EM एल्गोरिदम के अभिसरण, और प्रक्षेपण प्रमेय (Information Projection) को ज्यामितीय रूप से पूरी तरह समझाता है, और इसे सूचना ज्यामिति की सबसे बड़ी उपलब्धि माना जा सकता है।
अध्याय 4: डाइवर्जेंस और एंट्रॉपी की ज्यामिति
रीमैनियन ज्यामिति में दूरी सममित (symmetric) होती है ($d(x, y) = d(y, x)$), लेकिन सूचना सिद्धांत में संभाव्यता वितरण के बीच “अंतर” का पैमाना आम तौर पर असममित होता है। सूचना ज्यामिति इस असममित दूरी “डाइवर्जेंस (Divergence)” और दोहरे सपाट स्थान की ज्यामितीय संरचना को शानदार ढंग से जोड़ती है।
कुल्बैक-लीबलर सूचना (KL डाइवर्जेंस)
$$ D_{KL}(P \parallel Q) = \int p(x) \log \frac{p(x)}{q(x)} dx $$KL डाइवर्जेंस दूरी के स्वयंसिद्ध (distance axioms) को संतुष्ट नहीं करता है (यह असममित है और त्रिकोण असमानता को भी संतुष्ट नहीं करता है)। हालाँकि, उस सीमा में जहाँ बिंदु $Q$ असीमित रूप से बिंदु $P$ के करीब पहुँचता है, KL डाइवर्जेंस के टेलर विस्तार का दूसरा क्रम का शब्द फिशर सूचना मैट्रिक्स से पूरी तरह मेल खाता है।
$$ D_{KL}(\theta \parallel \theta + d\theta) \approx \frac{1}{2} \sum_{i,j} g_{ij}(\theta) d\theta^i d\theta^j $$दूसरे शब्दों में, KL डाइवर्जेंस एक स्थूल (macro) असममित दूरी है, और इसकी सूक्ष्म (micro) सीमा (अनंत दूरी) फिशर मीट्रिक (रीमैनियन ज्यामिति) को प्रेरित कर रही है।
ब्रेगमैन डाइवर्जेंस और लीजेंड्रे परिवर्तन
दोहरे सपाट स्पेस में, डाइवर्जेंस को अधिक सामान्य “ब्रेगमैन डाइवर्जेंस (Bregman Divergence)” के रूप में तैयार किया गया है। मान लें एक उत्तल फ़ंक्शन (convex function) $\psi(\theta)$ (कम्युलेन्ट जनरेटिंग फ़ंक्शन या मुक्त ऊर्जा के अनुरूप)। ब्रेगमैन डाइवर्जेंस $D_\psi(\theta_P \parallel \theta_Q)$ को बिंदु $\theta_Q$ पर उत्तल फ़ंक्शन के स्पर्शरेखा तल और बिंदु $\theta_P$ पर उत्तल फ़ंक्शन के मान के बीच “त्रुटि” के रूप में परिभाषित किया गया है।
$$ D_\psi(\theta_P \parallel \theta_Q) = \psi(\theta_P) - \psi(\theta_Q) - \sum_i (\theta_P^i - \theta_Q^i) \frac{\partial \psi(\theta_Q)}{\partial \theta^i} $$$$ \eta_i = \frac{\partial \psi(\theta)}{\partial \theta^i}, \quad \phi(\eta) = \sum_i \theta^i \eta_i - \psi(\theta) $$सूचना ज्यामिति में, KL डाइवर्जेंस बिल्कुल घातीय वितरण परिवारों पर ब्रेगमैन डाइवर्जेंस है, और दोहरे पैरामीटर $\theta$ (प्राकृतिक पैरामीटर) और $\eta$ (अपेक्षित मान पैरामीटर) का उपयोग करके, डाइवर्जेंस को दोहरे फ़ंक्शन $\psi, \phi$ का उपयोग करते हुए एक बहुत ही सममित और सुंदर विहित रूप (canonical form) में लिखा जा सकता है।
$$ D(P \parallel Q) = \psi(\theta_P) + \phi(\eta_Q) - \sum_i \theta_P^i \eta_Q^i $$यह सूत्र स्पष्ट रूप से दर्शाता है कि सूचना ज्यामिति केवल अवकल ज्यामिति का अनुप्रयोग नहीं है, बल्कि “सूचना सिद्धांत के लिए अद्वितीय ज्यामिति” है जो गहराई से लीजेंड्रे परिवर्तन और उत्तल विश्लेषण (convex analysis) से जुड़ी है।
अध्याय 5: डीप लर्निंग और नेचुरल ग्रेडिएंट डिसेंट (Natural Gradient Descent)
सूचना ज्यामिति न केवल सैद्धांतिक सुंदरता तक सीमित है, बल्कि यह आधुनिक एआई, विशेष रूप से डीप लर्निंग में अत्यंत व्यावहारिक शक्ति भी प्रदर्शित करती है। इसका प्रमुख उदाहरण “प्राकृतिक ग्रेडिएंट डिसेंट (Natural Gradient Descent; NGD)” है।
सामान्य ग्रेडिएंट डिसेंट की सीमाएँ
$$ w_{t+1} = w_t - \eta \nabla L(w_t) $$हालाँकि, सामान्य ग्रेडिएंट $\nabla L$ यह मान कर चलता है कि पैरामीटर स्पेस एक “सपाट यूक्लिडियन स्पेस” है। जैसा कि हमने अध्याय 1 में देखा, न्यूरल नेटवर्क द्वारा दर्शाए गए संभाव्य मॉडल का पैरामीटर स्पेस फिशर मीट्रिक द्वारा घुमावदार एक रीमैनियन मैनिफोल्ड है। यूक्लिडियन स्पेस का ग्रेडिएंट (सबसे तेज गिरावट की दिशा) रीमैनियन मैनिफोल्ड पर सबसे तेज गिरावट की वास्तविक दिशा से मेल नहीं खाता है। इसलिए, पैरामीटर के पैमाने या समन्वय परिवर्तनों के कारण सीखने का प्रक्षेपवक्र काफी बदल जाता है, और अनुकूलन की दक्षता काफी कम हो जाती है, जिसे अक्सर “पठार (plateau)” परिघटना कहा जाता है।
फिशर मीट्रिक द्वारा पैरामीटर अपडेट: नेचुरल ग्रेडिएंट मेथड
1998 में, शुन-इची अमारी ने “प्राकृतिक ग्रेडिएंट (Natural Gradient)” का प्रस्ताव रखा, जो रीमैनियन मैनिफोल्ड पर सबसे तेज गिरावट की वास्तविक दिशा है। मैनिफोल्ड पर ग्रेडिएंट $\tilde{\nabla} L$ फिशर सूचना मैट्रिक्स के व्युत्क्रम (inverse) $F^{-1}$ से गुणा किया गया सामान्य ग्रेडिएंट $\nabla L$ है।
$$ \tilde{\nabla} L(w) = F(w)^{-1} \nabla L(w) $$$$ w_{t+1} = w_t - \eta F(w_t)^{-1} \nabla L(w_t) $$नेचुरल ग्रेडिएंट विधि पैरामीटर स्पेस की वक्रता (फिशर सूचना मैट्रिक्स) को ध्यान में रखकर पैरामीटर के विकल्प (समन्वय प्रणाली) से स्वतंत्र अपरिवर्तनीय शिक्षण (invariant learning) प्राप्त करती है। इसके परिणामस्वरूप, भले ही हानि फ़ंक्शन का समोच्च एक विकृत घाटी की तरह हो, यह एक सीधी रेखा में इष्टतम समाधान की ओर बढ़ सकता है, जिससे सीखने की गति में नाटकीय रूप से सुधार होता है। यह न्यूटन की विधि (Newton’s method) जैसे द्वितीय-क्रम अनुकूलन विधि के समान है, लेकिन हेसियन मैट्रिक्स के बजाय, यह फिशर सूचना मैट्रिक्स का उपयोग करता है जिसकी सकारात्मक-अर्ध-निश्चितता (positive semi-definiteness) की गारंटी होती है, जो इसे संभाव्य मॉडल के लिए एक अनुकूलित विधि बनाता है।
K-FAC का उपयोग करते हुए अनुमानित गणना कार्यान्वयन और सफलता
नेचुरल ग्रेडिएंट विधि सैद्धांतिक रूप से शक्तिशाली है, लेकिन इसे डीप लर्निंग में लागू करने में एक बड़ी बाधा थी। दसियों लाख से लेकर दसियों अरबों मापदंडों वाले आधुनिक न्यूरल नेटवर्क में, एक विशाल फिशर सूचना मैट्रिक्स $F$ (आकार $N \times N$) की गणना करना और उसका व्युत्क्रम खोजना कम्प्यूटेशनल जटिलता के दृष्टिकोण से हताशाजनक ($O(N^3)$) था।
जिसने इस समस्या का समाधान किया वह 2015 में जेम्स मार्टेंस और रोजर ग्रोस द्वारा प्रस्तावित K-FAC (Kronecker-factored Approximate Curvature) नामक विधि थी। उन्होंने दिखाया कि न्यूरल नेटवर्क की परतों के बीच मापदंडों में फिशर सूचना मैट्रिक्स को इनपुट के सहप्रसरण मैट्रिक्स और आउटपुट के ग्रेडिएंट के सहप्रसरण मैट्रिक्स के “क्रोनकर उत्पाद (Kronecker Product)” द्वारा अच्छी सटीकता के साथ अनुमानित किया जा सकता है।
$$ F_{layer} \approx A \otimes S $$(जहाँ $A$ सक्रियण मान (activation value) का सहप्रसरण है, $S$ पूर्व-सक्रियण (pre-activation) के ग्रेडिएंट का सहप्रसरण है)
क्रोनकर उत्पाद की संपत्ति $(A \otimes S)^{-1} = A^{-1} \otimes S^{-1}$ का उपयोग करके, एक विशाल मैट्रिक्स के व्युत्क्रम की गणना को बहुत छोटे मैट्रिक्स के व्युत्क्रम की गणना में विघटित किया जा सकता है, और वे कम्प्यूटेशनल लागत को नाटकीय रूप से कम करने ($O(N^3)$ से $O(n^3)$ तक, जहाँ $n$ परत की चौड़ाई है) में सफल रहे। K-FAC के कार्यान्वयन के साथ, नेचुरल ग्रेडिएंट विधि को यथार्थवादी गणना समय में बड़े पैमाने के डीप लर्निंग मॉडल (ResNet या Transformer आदि) पर लागू किया जा सकता है, और यह साबित हुआ है कि यह वितरित शिक्षण (distributed learning) वातावरण में अत्यंत तेज़ अभिसरण (convergence) दिखाता है। यह एक ऐतिहासिक क्षण था जब सूचना ज्यामिति ने एआई की सीमाओं को पार कर लिया।
अध्याय 6: सांख्यिकीय भौतिकी, क्वांटम सूचना और तंत्रिका विज्ञान (Neuroscience) में विस्तार
सूचना ज्यामिति की बहुमुखी प्रतिभा सांख्यिकी और मशीन लर्निंग तक सीमित नहीं है। इसकी जड़ में “संभाव्यता और सूचना की ज्यामिति” कई वैज्ञानिक क्षेत्रों में फैल गई है।
क्वांटम सूचना ज्यामिति
सूचना ज्यामिति, जो शास्त्रीय संभाव्यता वितरणों से संबंधित है, स्वाभाविक रूप से क्वांटम सूचना ज्यामिति (Quantum Information Geometry) तक फैली हुई है, जो क्वांटम यांत्रिकी में “घनत्व मैट्रिक्स (Density Matrix)” से संबंधित है। क्वांटम प्रणालियों में, अवलोकनीय की गैर-कम्यूटेटिविटी (non-commutativity) (यह तथ्य कि ऑपरेटरों के क्रम के आधार पर परिणाम बदलता है) के कारण फिशर मीट्रिक के समतुल्य विशिष्ट रूप से निर्धारित नहीं होता है। इसके बजाय, कई रीमैनियन मीट्रिक हैं, जैसे बर्स मीट्रिक (SLD फिशर जानकारी) और कुबो-मोरी-बोगोलीउबोव मीट्रिक, और प्रत्येक का अलग-अलग भौतिक और सूचना-सैद्धांतिक अर्थ है। क्वांटम सूचना ज्यामिति तेजी से क्वांटम कंप्यूटर और क्वांटम संचार के लिए एक सैद्धांतिक आधार के रूप में विकसित हो रही है, जैसे क्वांटम अवस्थाओं के अनुमान सटीकता की सीमा (क्वांटम क्रैमर-राव असमानता), क्वांटम उलझाव (entanglement) का ज्यामितीय स्पष्टीकरण, और क्वांटम एल्गोरिदम का अनुकूलन।
मुक्त ऊर्जा सिद्धांत (Free Energy Principle) और तंत्रिका विज्ञान (Predictive Coding)
मस्तिष्क तंत्रिका विज्ञान के क्षेत्र में, कार्ल फ्रिस्टन द्वारा प्रस्तावित मुक्त ऊर्जा सिद्धांत (Free Energy Principle; FEP) यह मानता है कि मस्तिष्क एक प्रणाली है जो धारणा और क्रिया का अनुमान लगाती है ताकि “आश्चर्य (Surprise)” को कम किया जा सके। यह अनुमान प्रक्रिया वेरिएशनल बायेसियन इन्फेरेंस (Variational Bayesian Inference) के रूप में तैयार की गई है, जहाँ यह मस्तिष्क में आंतरिक मॉडल के संभाव्यता वितरण और बाहरी वातावरण के वास्तविक वितरण के बीच KL डाइवर्जेंस (वेरिएशनल मुक्त ऊर्जा) को कम करने के लिए एक अनुकूलन समस्या के रूप में सामने आती है।
सूचना ज्यामिति के दृष्टिकोण से, मस्तिष्क को एक गतिशील प्रणाली के रूप में समझा जा सकता है जो डाइवर्जेंस के ग्रेडिएंट (यानी, प्राकृतिक ग्रेडिएंट) के अनुसार संभाव्यता वितरण के मैनिफोल्ड पर चलती है। धारणा (आंतरिक अवस्थाओं का अद्यतन) और क्रिया (बाहरी वातावरण पर कार्य करना) को दोहरे सपाट स्पेस में e-प्रक्षेपण (e-projection) और m-प्रक्षेपण (m-projection) के पुनरावृत्त एल्गोरिदम के रूप में खूबसूरती से वर्णित किया गया है। सूचना ज्यामिति बुद्धिमत्ता के मौलिक तंत्र को उजागर करने के लिए एक गणितीय भाषा प्रदान करती है।
आधुनिक गणित की सीमा के रूप में
शुद्ध गणित के दृष्टिकोण से भी, सूचना ज्यामिति ने एक नया प्रतिमान (paradigm) प्रस्तुत किया है। एफ़िन अवकल ज्यामिति, हेसियन ज्यामिति, और सिम्पलेक्टिक ज्यामिति के साथ इसके गहरे संबंधों को स्पष्ट किया जा रहा है। विशेष रूप से, वासरस्टीन ज्यामिति (इष्टतम परिवहन सिद्धांत) और सूचना ज्यामिति का एकीकरण वर्तमान गणित और मशीन लर्निंग में सबसे गर्म शोध विषयों में से एक है। KL डाइवर्जेंस (सूचना ज्यामिति) “सूचना” की गति को मापता है, जबकि वासरस्टीन दूरी “द्रव्यमान (mass)” की गति को मापती है। इन दोनों ज्यामितियों को एकीकृत करने के प्रयास डीप जनरेटिव मॉडल (डिफ्यूजन मॉडल और GAN) के सैद्धांतिक स्पष्टीकरण से सीधे जुड़े हुए हैं।
निष्कर्ष: सूचना द्वारा बुना गया ब्रह्मांड का आकार
शुन-इची अमारी के इस अंतर्ज्ञान से पैदा हुई सूचना ज्यामिति कि “सांख्यिकीय मॉडल घुमावदार हो सकते हैं” अब सांख्यिकी की सीमाओं को पार कर गई है और एक भव्य सैद्धांतिक प्रणाली में विकसित हो गई है जो मशीन लर्निंग, क्वांटम भौतिकी और तंत्रिका विज्ञान को जोड़ती है। संभाव्यता वितरण को केवल कार्यों के रूप में नहीं, बल्कि ज्यामितीय “स्थानों” के रूप में मानकर, हम सूचना की गति, सीखने के प्रक्षेपवक्र और बुद्धिमत्ता के सार को नेत्रहीन रूप से समझ सकते हैं।
“सूचना की वक्रता” जो फिशर सूचना मीट्रिक सिखाती है। “सामान्यीकृत पाइथागोरस प्रमेय” दोहरे कनेक्शन द्वारा निर्देशित। और “एआई का तेज़ विकास” जिसका मार्ग प्राकृतिक ग्रेडिएंट विधि द्वारा प्रशस्त किया गया।
सूचना ज्यामिति हमारे लिए डेटा नामक सितारों से सत्य नामक नक्षत्रों को खोजने के लिए सबसे परिष्कृत “कम्पास (compass)” बनी रहेगी। इस सुंदर और गहरे रीमैनियन मैनिफोल्ड की खोज अभी शुरू हुई है。