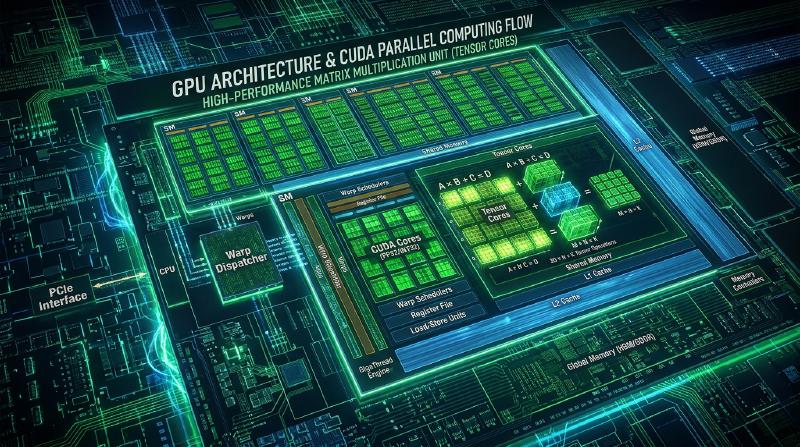
GPU का मैसिव पैरेलल आर्किटेक्चर और CUDA की भौतिकी: SIMT, वॉर्प और टेंसर कोर के कंप्यूटिंग सिद्धांत
आधुनिक उन्नत कम्प्यूटेशनल विज्ञान, आर्टिफिशियल इंटेलिजेंस, डीप लर्निंग और हाई-डेफिनिशन कंप्यूटर ग्राफिक्स का समर्थन करने वाली मुख्य तकनीक GPU (Graphics Processing Unit) है। इस लेख में, हम GPU आर्किटेक्चर और इसके ऊपर चलने वाले समानांतर कंप्यूटिंग बुनियादी ढांचे, CUDA (Compute Unified Device Architecture) के भौतिक और हार्डवेयर पहलुओं में गहराई से जाएंगे। केवल प्रोग्रामिंग सिंटैक्स के बजाय, हम स्ट्रीमिंग मल्टीप्रोसेसर (SM), SIMT निष्पादन मॉडल, वॉर्प शेड्यूलिंग, टेंसर कोर, और मेमोरी पदानुक्रम के दृष्टिकोण से हार्डवेयर को पूरी तरह से विच्छेदित करेंगे कि “इसे इस तरह क्यों डिज़ाइन किया गया है” और “यह कैसे चरम कम्प्यूटेशनल थ्रूपुट प्राप्त करता है”।
अध्याय 1: CPU और GPU के डिज़ाइन दर्शन का प्रस्थान बिंदु
1.1 कम लेटेंसी की खोज बनाम उच्च थ्रूपुट की खोज
एक सामान्य-उद्देश्य प्रोसेसर, CPU (Central Processing Unit) और समानांतर कंप्यूटिंग के लिए विशेषीकृत GPU के डिज़ाइन दर्शन उनके जन्म के इतिहास से मौलिक रूप से भिन्न हैं। CPU विकसित हुए हैं इस मुख्य उद्देश्य के साथ कि “एकल कार्य (थ्रेड) को कितनी जल्दी पूरा किया जा सकता है,” जिसे “कम लेटेंसी (देरी को कम करना)” कहा जाता है। दूसरी ओर, GPU “समानांतर कार्यों के एक बड़े बैच को बंडल करने और प्रति यूनिट समय में समग्र रूप से कितने प्रसंस्करण को पूरा करने” की खोज करता है, जिसे “उच्च थ्रूपुट (प्रसंस्करण मात्रा को अधिकतम करना)” कहा जाता है।
CPU को अप्रत्याशित प्रसंस्करण को जल्दी से संभालने की आवश्यकता होती है, जैसे ऑपरेटिंग सिस्टम को नियंत्रित करना, जटिल ब्रांचिंग स्थितियों वाले एप्लिकेशन चलाना, और उपयोगकर्ताओं से यादृच्छिक इंटरप्ट को संभालना। इस कारण से, यह एक उन्नत शाखा भविष्यवाणी सर्किट (branch prediction circuit), आउट-ऑफ-ऑर्डर निष्पादन (निष्पादन के लिए निर्देशों के क्रम को बदलने के लिए एक तंत्र), और विशाल L1/L2/L3 कैश मेमोरी से लैस है, जो मेमोरी एक्सेस में देरी को छिपाता है और एकल-थ्रेड प्रदर्शन को अपनी सीमा तक बढ़ाता है।
इसके विपरीत, GPU मूल रूप से अत्यधिक समानांतर कार्यों को संसाधित करने के लिए बनाए गए थे, जैसे स्क्रीन पर लाखों पिक्सेल में समान शेडिंग संचालन लागू करना। जटिल नियंत्रण सर्किट और विशाल कैश पर डाई क्षेत्र खर्च करने के बजाय, उन्होंने साधारण गणना इकाइयों (ALU: Arithmetic Logic Unit) को अधिकतम सीमा तक पैक करने का विकल्प चुना।
1.2 डाई एरिया में कैश, कंट्रोल सर्किट और ALU का आवंटन अनुपात
सिलिकॉन डाई (सेमीकंडक्टर चिप) के सीमित क्षेत्र (ट्रांजिस्टर बजट) को कैसे आवंटित किया जाता है, यह दोनों आर्किटेक्चर के बीच का अंतर निर्धारित करता है।
- CPU का डाई क्षेत्र आवंटन: डाई के आधे से अधिक हिस्से पर बड़ी क्षमता वाली कैश मेमोरी (SRAM) और उन्नत नियंत्रण सर्किट (शाखा भविष्यवाणी, निर्देश फ़ेच, डिकोड, शेड्यूलिंग, आदि) का कब्ज़ा है। वास्तविक गणना करने वाले ALU का अनुपात अपेक्षाकृत छोटा होता है।
- GPU का डाई क्षेत्र आवंटन: कैश मेमोरी और नियंत्रण सर्किट को न्यूनतम आवश्यक तक रखा जाता है, और डाई का अधिकांश हिस्सा हजारों से लेकर दसियों हज़ार ALU (CUDA कोर) द्वारा लिया जाता है।
GPU कैश के साथ मेमोरी एक्सेस लेटेंसी को नहीं छिपाते, बल्कि वे “कंटेक्स्ट स्विचिंग” (context switching) द्वारा इसे छिपाते हैं। जबकि थ्रेड्स का एक समूह मेमोरी से डेटा आने की प्रतीक्षा कर रहा है, यह तुरंत थ्रेड्स के दूसरे समूह के संचालन को निष्पादित करता है, गणना इकाइयों को हमेशा चालू (उच्च अधिभोग (occupancy) दर) रखता है। यह GPU में “उच्च थ्रूपुट की खोज” का भौतिक कार्यान्वयन है। क्योंकि हार्डवेयर-स्तरीय मल्टीथ्रेडिंग (Hardware Multithreading) बहुत हल्के ढंग से की जाती है, यह माना जाता है कि हजारों से लेकर दसियों हज़ार समवर्ती थ्रेड मौजूद हैं।
अध्याय 2: SIMT निष्पादन मॉडल का सार
2.1 SIMD और SIMT के बीच अंतर
समानांतर प्रसंस्करण के वर्गीकरण के रूप में फ्लिन की टैक्सोनॉमी (Flynn’s taxonomy) है, और GPU के निष्पादन मॉडल की तुलना अक्सर SIMD (Single Instruction, Multiple Data) से की जाती है। CPU का वेक्टर एक्सटेंशन निर्देश (जैसे AVX) एक शुद्ध SIMD है, और एक निर्देश एक ही समय में कई डेटा (उदाहरण के लिए, 256-बिट रजिस्टर में संग्रहीत 8 32-बिट फ़्लोटिंग-पॉइंट नंबर) को संसाधित करता है। SIMD में, प्रत्येक डेटा तत्व के लिए अलग-अलग शाखाएं (if-else) बनाना बहुत मुश्किल है।
दूसरी ओर, NVIDIA द्वारा वकालत किए गए CUDA निष्पादन मॉडल को SIMT (Single Instruction, Multiple Threads) कहा जाता है। SIMT में, कई स्वतंत्र “थ्रेड” एक समूह बनाते हैं (नीचे वर्णित “वॉर्प”), और एक ही निर्देश को साझा और निष्पादित करते हैं। हालाँकि, SIMD के विपरीत, SIMT में प्रत्येक थ्रेड में एक स्वतंत्र रजिस्टर अवस्था और निर्देश पता काउंटर (प्रोग्रामिंग मॉडल पर) होता है। यह प्रोग्रामर को कोड लिखने की अनुमति देता है जैसे कि प्रत्येक थ्रेड स्वतंत्र रूप से काम कर रहा हो।
2.2 32 थ्रेड्स की इकाई “वॉर्प (Warp)”
GPU हार्डवेयर थ्रेड्स को अलग-अलग शेड्यूल नहीं करता है, बल्कि 32 थ्रेड्स के “वॉर्प (Warp)” की इकाई में उनका प्रबंधन और निष्पादन करता है। (AMD GPU में, इसे वेवफ्रंट कहा जाता है, और 64-थ्रेड इकाइयों को भी अपनाया जा सकता है)।
स्ट्रीमिंग मल्टीप्रोसेसर (SM) में निर्देश फ़ेच और डिकोड यूनिट वॉर्प के आधार पर एक निर्देश फ़ेच करती है और वॉर्प में सभी 32 थ्रेड्स को समान निर्देश जारी (डिस्पैच) करती है। दूसरे शब्दों में, वॉर्प में 32 थ्रेड शारीरिक रूप से ठीक एक ही समय में उनके अलग-अलग डेटा पर समान निर्देश निष्पादित करते हैं। यह SIMT का मूल है।
2.3 वॉर्प डाइवर्जेंस (शाखा बेमेल) का भौतिक जुर्माना
भले ही प्रत्येक थ्रेड ऐसे व्यवहार कर सकता है जैसे उसके पास एक स्वतंत्र प्रोग्राम काउंटर हो, शारीरिक रूप से वॉर्प में सभी थ्रेड्स को एक ही निर्देश निष्पादित करना चाहिए। तो क्या होता है यदि कोड में if-else जैसी एक सशर्त शाखा है, और शाखा की स्थिति का सत्य या असत्य वॉर्प में थ्रेड्स के बीच विभाजित है?
इस घटना को वॉर्प डाइवर्जेंस (Warp Divergence) कहा जाता है।
जब वॉर्प डाइवर्जेंस होता है, तो हार्डवेयर निम्न चरणों में प्रक्रिया करता है:
- सबसे पहले, यह निर्देश को केवल उन थ्रेड्स (सक्रिय थ्रेड्स) पर निष्पादित करता है जिनके लिए
ifशर्त सत्य है। इस समय, जिन थ्रेड्स के लिए शर्त गलत थी उन्हें “मास्क (अमान्य)” कर दिया जाता है, और गणना परिणाम नहीं लिखा जाता है। - इसके बाद, यह
elseस्थिति में परिवर्तित होता है (या वह पथ जहां स्थिति गलत है), और इस बार यह पहले से मास्क किए गए थ्रेड्स को सक्रिय करता है, सत्य थ्रेड्स को मास्क करता है, और निर्देश को निष्पादित करता है।
दूसरे शब्दों में, यदि कई शाखा पथ हैं, तो हार्डवेयर को उन पथों को समानांतर के बजाय क्रमिक (serial) रूप से निष्पादित करना होगा। एक चरम उदाहरण के रूप में, यदि एक वॉर्प में 32 थ्रेड 32 अलग-अलग शाखा पथ लेते हैं, तो निष्पादन का समय 32 गुना बढ़ जाएगा। वॉर्प डाइवर्जेंस GPU कम्प्यूटेशनल थ्रूपुट को भारी रूप से कम करने वाले सबसे बड़े कारकों में से एक है, और एल्गोरिथ्म डिज़ाइन में बचने के लिए यह सबसे महत्वपूर्ण एंटी-पैटर्न है। भौतिक रूप से, इसका अर्थ है कि “व्यर्थ चक्र” उत्पन्न हो रहे हैं जहाँ ALU शक्ति का उपभोग कर रहा है लेकिन मास्क किए जाने के कारण वैध गणना परिणाम नहीं बना रहा है।
अध्याय 3: स्ट्रीमिंग मल्टीप्रोसेसर (SM) की हार्डवेयर शारीरिक रचना
GPU कई स्ट्रीमिंग मल्टीप्रोसेसर (SM: Streaming Multiprocessor) का एक संयोजन है। SM GPU का सच्चा कंप्यूट इंजन है। नवीनतम आर्किटेक्चर (उदा., Hopper H100) में, एक एकल GPU डाई पर 100 से अधिक SM लगे होते हैं।
3.1 SM के भीतर पाइपलाइन विन्यास
SM को आंतरिक रूप से कई उप-विभाजनों (आमतौर पर 4) में विभाजित किया जाता है, जिनमें से प्रत्येक का अपना स्वतंत्र वॉर्प शेड्यूलर और डिस्पैच यूनिट होता है।
- वॉर्प शेड्यूलर (Warp Scheduler): एक निष्पादन योग्य स्थिति (रजिस्टर और मेमोरी तैयार) में वॉर्प का चयन करता है। GPU शेड्यूलर शून्य ओवरहेड के साथ वॉर्प के बीच स्विच कर सकते हैं, जो मेमोरी एक्सेस लेटेंसी को छिपाने की कुंजी है।
- डिस्पैच यूनिट (Dispatch Unit): निर्धारित वॉर्प्स को निर्देश जारी करता है।
- CUDA कोर (INT32 / FP32 / FP64 ALU): इकाइयां जो वास्तविक पूर्णांक और फ़्लोटिंग-पॉइंट गणना करती हैं।
- लोड/स्टोर यूनिट (LD/ST Unit): मेमोरी को पढ़ने और लिखने के लिए जिम्मेदार।
- स्पेशल फंक्शन यूनिट (SFU): sin, cos, exp, और रेसिप्रोकल जैसे ट्रांसेंडेंटल फंक्शन्स की तेज गणना के लिए समर्पित हार्डवेयर।
निर्देश पाइपलाइन बहुत गहरी डिज़ाइन की गई है, जिसमें फ़ेच, डिकोड, शेड्यूलिंग, रजिस्टर रीड, निष्पादन (एकाधिक चक्र), और राइट-बैक के चरण शामिल हैं। FP32 FMA (Fused Multiply-Add) गणनाओं की लेटेंसी आमतौर पर कई चक्रों से लेकर एक दर्जन से अधिक चक्रों तक होती है, लेकिन हर चक्र पर अलग-अलग वॉर्प से निर्देश जारी करके, पाइपलाइन को हमेशा भरा रखा जाता है।
3.2 विशाल रजिस्टर फ़ाइल और रजिस्टर दबाव
SM एक रजिस्टर फ़ाइल से सुसज्जित है जो CPU की तुलना में बहुत अधिक विशाल है (उदा., प्रति SM 64KB से 256KB SRAM)। ऐसा इसलिए है क्योंकि यह SM पर एक साथ चलने वाले हजारों थ्रेड्स के सभी संदर्भों को बनाए रखता है।
कंटेक्स्ट स्विच शून्य चक्र में पूरा हो जाता है क्योंकि थ्रेड की रजिस्टर अवस्था को मेमोरी में सहेजने (spill) की कोई आवश्यकता नहीं है। हालाँकि, यदि प्रति थ्रेड उपयोग किए जाने वाले रजिस्टरों की संख्या बढ़ जाती है, तो SM के भीतर एक साथ लॉन्च किए जा सकने वाले वॉर्प्स की संख्या (ऑक्यूपेंसी) कम हो जाती है। इसे रजिस्टर प्रेशर (Register Pressure) कहा जाता है। जब रजिस्टर समाप्त हो जाते हैं, तो डेटा धीमी स्थानीय मेमोरी (भौतिक रूप से ग्लोबल मेमोरी का हिस्सा) में फैल जाता है, जिससे विनाशकारी प्रदर्शन गिरावट आती है।
3.3 शेयर्ड मेमोरी और बैंक संघर्ष
SM में एक अल्ट्रा-फास्ट ऑन-चिप मेमोरी, शेयर्ड मेमोरी (Shared Memory) है जिसे प्रोग्रामर द्वारा स्पष्ट रूप से नियंत्रित किया जा सकता है। यद्यपि यह L1 कैश के समान भौतिक SRAM क्षेत्र को साझा करता है, यह एक स्पष्ट डेटा कैश के रूप में कार्य करता है और इसका उपयोग ब्लॉक के भीतर थ्रेड्स के बीच डेटा साझाकरण और सिंक्रनाइज़ेशन के लिए किया जाता है।
शेयर्ड मेमोरी की भौतिक संरचना को कई स्वतंत्र मॉड्यूल (आमतौर पर 32) में विभाजित किया जाता है जिसे मेमोरी बैंक (Memory Banks) कहा जाता है। सन्निहित 32-बिट पते विभिन्न बैंकों में इंटरलीव्ड (आवंटित) किए जाते हैं।
जब वॉर्प में 32 थ्रेड एक साथ विभिन्न बैंकों तक पहुंचते हैं, तो पहुंच पूरी तरह से समानांतर में (1 चक्र में) संसाधित होती है। इसे बैंक-कंफ्लिक्ट-फ्री कहा जाता है। हालाँकि, जब कई थ्रेड एक ही समय में एक ही बैंक में विभिन्न पतों तक पहुँचने का प्रयास करते हैं, तो अनुरोधों को क्रमबद्ध (serialized) किया जाता है और एक जुर्माना (देरी) होता है। इसे बैंक संघर्ष (Bank Conflict) कहा जाता है। उदाहरण के लिए, 2-तरफा बैंक संघर्ष के साथ एक्सेस का समय दोगुना हो जाता है, और सबसे खराब स्थिति में, 32-तरफा संघर्ष में 32 गुना देरी होगी। मैट्रिक्स ट्रांसपोज़ जैसे एल्गोरिदम में, स्ट्राइडेड एक्सेस के कारण गंभीर बैंक संघर्ष होते हैं, इसलिए अत्यधिक अनुकूलन आवश्यक है जो संघर्षों से बचने के लिए पैडिंग (मेमोरी एड्रेस को स्थानांतरित करने के लिए डमी डेटा सम्मिलित करना) का उपयोग करता है।
अध्याय 4: टेंसर कोर (Tensor Core) पाइपलाइन की गणना करें
Volta आर्किटेक्चर में पहली बार पेश किया गया, टेंसर कोर (Tensor Core) क्रांतिकारी हार्डवेयर है जिसने बाद के GPU के प्रदर्शन को काफी बढ़ा दिया। AI और डीप लर्निंग के विस्फोटक विकास की टेंसर कोर के बिना कल्पना नहीं की जा सकती।
4.1 मैट्रिक्स गुणा-संचय (MMA) का हार्डवेयर कार्यान्वयन
डीप लर्निंग गणनाओं का एक बड़ा हिस्सा न्यूरल नेटवर्क वेट मैट्रिक्स और इनपुट डेटा का मैट्रिक्स गुणन (GEMM: General Matrix Multiply) है। सूत्र को $D = A \times B + C$ के रूप में व्यक्त किया जाता है (जहाँ $A, B$ इनपुट मैट्रिक्स हैं और $C$ संचायक (accumulator) मैट्रिक्स है)।
पारंपरिक CUDA कोर में, इस मैट्रिक्स गुणन की गणना एक समय में एक तत्व में FMA (Fused Multiply-Add) निर्देशों का उपयोग करके की जाती थी। इसके विपरीत, एक टेंसर कोर एक समर्पित सर्किट है जो हार्डवेयर स्तर पर 1 चक्र (या कई चक्रों) में एक छोटे मैट्रिक्स (उदा., 4x4 या 16x16) के गुणन और जोड़ की गणना करता है।
भौतिक रूप से, दर्जनों से लेकर सैकड़ों गुणक (multipliers) और एक विशाल जोड़ पेड़ तारों से जुड़े हुए हैं, और मध्यवर्ती परिणामों को रजिस्टरों में वापस लिखे बिना गुणन-जोड़ एक ही बार में पूरा किया जाता है। परिणामस्वरूप, प्रति क्षेत्र (TFLOPS) गणना थ्रूपुट सामान्य CUDA कोर की तुलना में काफी अधिक है।
4.2 मिक्स्ड-प्रेसिजन (Mixed-Precision) का रहस्य
टेंसर कोर का एक और सार मिक्स्ड-प्रेसिजन गणना का समर्थन है। डीप लर्निंग में, कई स्थितियां ऐसी होती हैं जहां गणना प्रक्रिया के दौरान उच्च परिशुद्धता (FP32/FP64) की आवश्यकता नहीं होती है। टेंसर कोर में एक पाइपलाइन होती है जो इनपुट मैट्रिक्स $A$ और $B$ को कम सटीकता (FP16, BF16, या उससे भी कम FP8, INT8, INT4) में पढ़ती है, कम सटीकता में आंतरिक गुणन करती है, और फिर उच्च सटीकता (FP32 या INT32) में अतिरिक्त (संचय) प्रक्रिया करती है।
- FP16 / BF16: प्रशिक्षण के लिए मानक। BF16 (Bfloat16) में FP32 के समान 8 बिट्स का एक्सपोनेंट भाग होता है, और इसमें एक विस्तृत डायनामिक रेंज होती है, जिससे लुप्त हो रहे ग्रेडिएंट को रोकना आसान हो जाता है।
- FP8 / INT8 / INT4: अनुमान (Inference) में तेजी लाने के लिए ट्रम्प कार्ड। चूँकि डेटा ट्रांसफर मात्रा (मेमोरी बैंडविड्थ) भी कम हो जाती है, थ्रूपुट में नाटकीय रूप से सुधार होता है।
Hopper आर्किटेक्चर ने “FP8 Tensor Core” पेश किया, जो ट्रांसफार्मर मॉडल की गणना को नाटकीय रूप से गति देता है, सिद्धांत रूप में FP32 की तुलना में दसियों गुना थ्रूपुट प्राप्त करता है। सॉफ़्टवेयर की ओर से (CUDA), टेंसर कोर सीधे wmma (Warp-Level Matrix Multiply and Accumulate) API या mma.sync PTX निर्देश के माध्यम से संचालित होता है, और वॉर्प में थ्रेड्स मैट्रिक्स के टुकड़ों को लोड, गणना और रजिस्टर में स्टोर करने के लिए एक अत्यंत जटिल सामूहिक प्रसंस्करण करते हैं।
अध्याय 5: CUDA मेमोरी पदानुक्रम और अनुकूलन तकनीक
चाहे GPU की गणना क्षमता कितनी भी अधिक हो, यदि डेटा आपूर्ति एक अड़चन बन जाती है, तो प्रदर्शन प्राप्त नहीं किया जा सकता है (मेमोरी वॉल समस्या)। यह कहना अतिश्योक्ति नहीं है कि CUDA प्रोग्रामिंग में अनुकूलन का 90% “मेमोरी एक्सेस अनुकूलन” है।
5.1 ग्लोबल मेमोरी की कोलेसिंग एक्सेस
GPU की मुख्य मेमोरी (HBM या GDDR), ग्लोबल मेमोरी, की बैंडविड्थ बहुत विस्तृत (उदा., कई TB/s) है, लेकिन लेटेंसी भी सैकड़ों चक्रों में बहुत बड़ी है।
ग्लोबल मेमोरी तक पहुंच दक्षता को अधिकतम करने का पूर्ण सिद्धांत कोलेसिंग (Coalescing) है। GPU मेमोरी कंट्रोलर मेमोरी को 32-बाइट, 64-बाइट, या 128-बाइट लेनदेन में एक्सेस करता है। जब वॉर्प में 32 थ्रेड मेमोरी तक पहुंचते हैं, यदि उनके मेमोरी पते एक सन्निहित क्षेत्र (128-बाइट संरेखित सीमा के भीतर) में हैं, तो हार्डवेयर प्रसंस्करण के लिए इन अनुरोधों को एकल मेमोरी लेनदेन में जोड़ता (कोलेसेस) है।
इसके विपरीत, यदि थ्रेड्स यादृच्छिक पतों तक पहुंचते हैं, या यदि वे स्ट्राइडेड (अंतराल वाले) एक्सेस करते हैं, तो विलय नहीं होता है और कई लेनदेन होते हैं। इसे “नॉन-कोलेस्ड एक्सेस” कहा जाता है, जो एक घातक प्रदर्शन बग है जो प्रभावी मेमोरी बैंडविड्थ को इसके दसवें हिस्से या उससे कम तक कम कर देता है।
5.2 CUDA C++ कोड उदाहरण: मैट्रिक्स ट्रांसपोज़ेशन और शेयर्ड मेमोरी का अनुकूलन
नीचे मैट्रिक्स ट्रांसपोज़ के लिए एक अनुकूलित कर्नेल कोड का उदाहरण दिया गया है जो नॉन-कोलेस्ड एक्सेस से बचा जाता है और प्रदर्शन को नाटकीय रूप से बेहतर बनाने के लिए शेयर्ड मेमोरी का लाभ उठाता है।
| |
इस कोड के 3 मुख्य बिंदु हैं:
- पढ़ते समय कोलेसिंग:
idataसे पढ़ना X दिशा में किया जाता है जहाँthreadIdx.xसन्निहित है, इसलिए यह पूरी तरह से कोलेस्ड है। - लिखते समय कोलेसिंग:
odataपर लिखना भी ब्लॉक निर्देशांक की अदला-बदली करकेthreadIdx.xदिशा में सन्निहित होने के लिए डिज़ाइन किया गया है, और इसे कोलेस्ड किया जाता है। - शेयर्ड मेमोरी में पैडिंग: एक तत्व (
tile[TILE_DIM][TILE_DIM + 1]) द्वारा स्थानांतरित (पैडिंग) करके, लिखते समय कॉलम दिशा (tile[threadIdx.x][threadIdx.y + j]) में एक्सेस करते समय बैंक संघर्ष पूरी तरह से समाप्त हो जाते हैं।
5.3 कैश पदानुक्रम और विशेष मेमोरी
- L1/L2 कैश नीति: हाल के GPU आर्किटेक्चर में, प्रोग्रामर संकेत के रूप में PTX निर्देशों (
.ca,.cg,.cs, आदि) का उपयोग करके कैश व्यवहार को नियंत्रित कर सकते हैं। उदाहरण के लिए, डेटा जो केवल एक बार एक्सेस किया जाता है, L2 कैश (स्ट्रीमिंग एक्सेस) को बायपास कर सकता है, जिससे कैश प्रदूषण को रोका जा सकता है। - टेक्सचर मेमोरी / कॉन्स्टेंट मेमोरी: छवि प्रसंस्करण में विशेष टेक्सचर मेमोरी 2D स्थानिक स्थानीयता वाले एक्सेस के लिए एक समर्पित कैश का उपयोग करती है। कॉन्स्टेंट मेमोरी ब्रॉडकास्ट एक्सेस के लिए अत्यधिक कुशल है जहां सभी थ्रेड एक ही स्थिरांक पढ़ते हैं।
अध्याय 6: डीप लर्निंग युग में GPU का भविष्य
सिर्फ एक GPU के प्रदर्शन में सुधार करना ही नहीं, बल्कि संपूर्ण रूप से सिस्टम को स्केल करना वर्तमान कम्प्यूटेशनल विज्ञान की सीमा है।
6.1 NVLink और NVSwitch के साथ अल्ट्रा-फास्ट इंटरकनेक्शन
एक विशाल LLM (लार्ज लैंग्वेज मॉडल) एक ही GPU (जैसे 80GB या 144GB) की मेमोरी में फिट नहीं हो सकता है। मॉडल समानांतरकरण (टेंसर पैरेलल या पाइपलाइन पैरेलल) करने के लिए, GPU के बीच प्रति सेकंड टेराबाइट्स डेटा का आदान-प्रदान करना आवश्यक है। चूंकि पारंपरिक PCIe (PCI Express) बस इस बैंडविड्थ को कवर नहीं कर सकती है, NVIDIA ने NVLink नामक एक मालिकाना उच्च गति इंटरकनेक्ट विकसित किया। इसके अलावा, NVSwitch नामक स्विच चिप के माध्यम से, 8 या 256 जैसे GPU एक पूर्ण नॉन-ब्लॉकिंग क्रॉसबार स्विच से जुड़े होते हैं, जिससे ऐसे क्लस्टर बनाना संभव हो जाता है जो ऐसे व्यवहार करते हैं मानो वे एक विशाल GPU हों।
6.2 ट्रांसफार्मर इंजन और FP8 इकोसिस्टम
ट्रांसफार्मर आर्किटेक्चर को अनुकूलित करने के लिए, जो न केवल प्राकृतिक भाषा प्रसंस्करण के लिए बल्कि छवि और वाक् पहचान के लिए भी वास्तविक मानक बन गया है, Hopper आर्किटेक्चर एक समर्पित हार्डवेयर और सॉफ्टवेयर समन्वय तंत्र से सुसज्जित है जिसे Transformer Engine कहा जाता है। यह एक ऐसा तंत्र है जो गतिशील रूप से टेंसर आँकड़ों की निगरानी करता है और सटीकता में गिरावट को रोकते हुए चरम गणना गति और मेमोरी बैंडविड्थ बचत प्राप्त करने के लिए प्रत्येक परत (Dynamic Scaling) के लिए FP8 और FP16 गणना सटीकता के बीच स्वचालित रूप से स्विच करता है।
6.3 GPU क्लस्टर के स्केलिंग कानून और भविष्य की संभावनाएं
जैसा कि OpenAI का “Scaling Laws” दिखाता है, AI का प्रदर्शन तब तक बढ़ता रहता है जब तक मॉडल मापदंडों की संख्या और गणना की मात्रा बढ़ाई जाती है। इसके साथ ही, GPU एक साधारण प्रोसेसर से “डेटा सेंटर जो स्वयं एक विशाल GPU (सुपरकंप्यूटर) है” में विकसित हो रहे हैं, जिसमें ऑप्टिकल फाइबर के साथ हजारों इकाइयां जुड़ी हुई हैं।
भविष्य के आर्किटेक्चर का विकास सिलिकॉन फोटोनिक्स (ऑप्टिकल इंटरकनेक्ट), CPO (Co-Packaged Optics), और SRAM से HBM तक 3D स्टैकिंग तकनीक के और परिष्कृत होने की दिशा में आगे बढ़ेगा। हालाँकि, “समानांतर प्रसंस्करण द्वारा थ्रूपुट का अधिकतमकरण” का मूल DNA, जो कि GPU के जन्म के समय से नहीं बदला है, कम्प्यूटेशनल विज्ञान के मोर्चे को आगे बढ़ाता रहेगा।
[अतिरिक्त चर्चा] GPU में शेड्यूलिंग और ऑक्यूपेंसी का गणितीय विश्लेषण
title: “ग्राफिक्स कंप्यूटिंग प्रोसेसर का मैसिव पैरेलल आर्किटेक्चर और CUDA की भौतिकी: SIMT, वॉर्प और टेंसर कोर के कंप्यूटिंग सिद्धांत” description: “ग्राफिक्स कंप्यूटिंग प्रोसेसर की आंतरिक डिज़ाइन जो अधिकतम थ्रूपुट का प्रयास करती है। SM, वॉर्प शेड्यूलिंग, टेंसर कोर, और शेयर्ड मेमोरी ऑप्टिमाइज़ेशन का सार।” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
ग्राफिक्स कंप्यूटिंग प्रोसेसर का मैसिव पैरेलल आर्किटेक्चर और CUDA की भौतिकी: SIMT, वॉर्प और टेंसर कोर के कंप्यूटिंग सिद्धांत
आधुनिक उन्नत कम्प्यूटेशनल विज्ञान, आर्टिफिशियल इंटेलिजेंस, डीप लर्निंग और हाई-डेफिनिशन कंप्यूटर ग्राफिक्स का समर्थन करने वाली मुख्य तकनीक ग्राफिक्स कंप्यूटिंग प्रोसेसर (Graphics Processing Unit) है। इस लेख में, हम ग्राफिक्स कंप्यूटिंग प्रोसेसर आर्किटेक्चर और इसके ऊपर चलने वाले समानांतर कंप्यूटिंग बुनियादी ढांचे, CUDA (Compute Unified Device Architecture) के भौतिक और हार्डवेयर पहलुओं में गहराई से जाएंगे। केवल प्रोग्रामिंग सिंटैक्स के बजाय, हम स्ट्रीमिंग मल्टीप्रोसेसर (SM), SIMT निष्पादन मॉडल, वॉर्प शेड्यूलिंग, टेंसर कोर, और मेमोरी पदानुक्रम के दृष्टिकोण से हार्डवेयर को पूरी तरह से विच्छेदित करेंगे कि “इसे इस तरह क्यों डिज़ाइन किया गया है” और “यह कैसे चरम कम्प्यूटेशनल थ्रूपुट प्राप्त करता है”।
पूरक अध्याय 1 का परिशिष्ट: सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर और ग्राफिक्स कंप्यूटिंग प्रोसेसर के डिज़ाइन दर्शन का प्रस्थान बिंदु
1.1 कम लेटेंसी की खोज बनाम उच्च थ्रूपुट की खोज
एक सामान्य-उद्देश्य प्रोसेसर, सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर (Central Processing Unit) और समानांतर कंप्यूटिंग के लिए विशेषीकृत ग्राफिक्स कंप्यूटिंग प्रोसेसर के डिज़ाइन दर्शन उनके जन्म के इतिहास से मौलिक रूप से भिन्न हैं। सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर विकसित हुए हैं इस मुख्य उद्देश्य के साथ कि “एकल कार्य (थ्रेड) को कितनी जल्दी पूरा किया जा सकता है,” जिसे “कम लेटेंसी (देरी को कम करना)” कहा जाता है। दूसरी ओर, ग्राफिक्स कंप्यूटिंग प्रोसेसर “समानांतर कार्यों के एक बड़े बैच को बंडल करने और प्रति यूनिट समय में समग्र रूप से कितने प्रसंस्करण को पूरा करने” की खोज करता है, जिसे “उच्च थ्रूपुट (प्रसंस्करण मात्रा को अधिकतम करना)” कहा जाता है।
सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर को अप्रत्याशित प्रसंस्करण को जल्दी से संभालने की आवश्यकता होती है, जैसे ऑपरेटिंग सिस्टम को नियंत्रित करना, जटिल ब्रांचिंग स्थितियों वाले एप्लिकेशन चलाना, और उपयोगकर्ताओं से यादृच्छिक इंटरप्ट को संभालना। इस कारण से, यह एक उन्नत शाखा भविष्यवाणी सर्किट, आउट-ऑफ-ऑर्डर निष्पादन (निष्पादन के लिए निर्देशों के क्रम को बदलने के लिए एक तंत्र), और विशाल L1/L2/L3 कैश मेमोरी से लैस है, जो मेमोरी एक्सेस में देरी को छिपाता है और एकल-थ्रेड प्रदर्शन को अपनी सीमा तक बढ़ाता है।
इसके विपरीत, ग्राफिक्स कंप्यूटिंग प्रोसेसर मूल रूप से अत्यधिक समानांतर कार्यों को संसाधित करने के लिए बनाए गए थे, जैसे स्क्रीन पर लाखों पिक्सेल में समान शेडिंग संचालन लागू करना। जटिल नियंत्रण सर्किट और विशाल कैश पर डाई क्षेत्र खर्च करने के बजाय, उन्होंने साधारण गणना इकाइयों (ALU: Arithmetic Logic Unit) को अधिकतम सीमा तक पैक करने का विकल्प चुना।
1.2 डाई एरिया में कैश, कंट्रोल सर्किट और ALU का आवंटन अनुपात
सिलिकॉन डाई (सेमीकंडक्टर चिप) के सीमित क्षेत्र (ट्रांजिस्टर बजट) को कैसे आवंटित किया जाता है, यह दोनों आर्किटेक्चर के बीच का अंतर निर्धारित करता है।
- सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर का डाई क्षेत्र आवंटन: डाई के आधे से अधिक हिस्से पर बड़ी क्षमता वाली कैश मेमोरी (SRAM) और उन्नत नियंत्रण सर्किट (शाखा भविष्यवाणी, निर्देश फ़ेच, डिकोड, शेड्यूलिंग, आदि) का कब्ज़ा है। वास्तविक गणना करने वाले ALU का अनुपात अपेक्षाकृत छोटा होता है।
- ग्राफिक्स कंप्यूटिंग प्रोसेसर का डाई क्षेत्र आवंटन: कैश मेमोरी और नियंत्रण सर्किट को न्यूनतम आवश्यक तक रखा जाता है, और डाई का अधिकांश हिस्सा हजारों से लेकर दसियों हज़ार ALU (CUDA कोर) द्वारा लिया जाता है।
ग्राफिक्स कंप्यूटिंग प्रोसेसर कैश के साथ मेमोरी एक्सेस लेटेंसी को नहीं छिपाते, बल्कि वे “कंटेक्स्ट स्विचिंग” द्वारा इसे छिपाते हैं। जबकि थ्रेड्स का एक समूह मेमोरी से डेटा आने की प्रतीक्षा कर रहा है, यह तुरंत थ्रेड्स के दूसरे समूह के संचालन को निष्पादित करता है, गणना इकाइयों को हमेशा चालू (उच्च ऑक्यूपेंसी) रखता है। यह ग्राफिक्स कंप्यूटिंग प्रोसेसर में “उच्च थ्रूपुट की खोज” का भौतिक कार्यान्वयन है। क्योंकि हार्डवेयर-स्तरीय मल्टीथ्रेडिंग (Hardware Multithreading) बहुत हल्के ढंग से की जाती है, यह माना जाता है कि हजारों से लेकर दसियों हज़ार समवर्ती थ्रेड मौजूद हैं।
पूरक अध्याय 2 का परिशिष्ट: SIMT निष्पादन मॉडल का सार
2.1 SIMD और SIMT के बीच अंतर
समानांतर प्रसंस्करण के वर्गीकरण के रूप में फ्लिन की टैक्सोनॉमी (Flynn’s taxonomy) है, और ग्राफिक्स कंप्यूटिंग प्रोसेसर के निष्पादन मॉडल की तुलना अक्सर SIMD (Single Instruction, Multiple Data) से की जाती है। सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर का वेक्टर एक्सटेंशन निर्देश (जैसे AVX) एक शुद्ध SIMD है, और एक निर्देश एक ही समय में कई डेटा (उदाहरण के लिए, 256-बिट रजिस्टर में संग्रहीत 8 32-बिट फ़्लोटिंग-पॉइंट नंबर) को संसाधित करता है। SIMD में, प्रत्येक डेटा तत्व के लिए अलग-अलग शाखाएं (if-else) बनाना बहुत मुश्किल है।
दूसरी ओर, NVIDIA द्वारा वकालत किए गए CUDA निष्पादन मॉडल को SIMT (Single Instruction, Multiple Threads) कहा जाता है। SIMT में, कई स्वतंत्र “थ्रेड” एक समूह बनाते हैं (नीचे वर्णित “वॉर्प”), और एक ही निर्देश को साझा और निष्पादित करते हैं। हालाँकि, SIMD के विपरीत, SIMT में प्रत्येक थ्रेड में एक स्वतंत्र रजिस्टर अवस्था और निर्देश पता काउंटर (प्रोग्रामिंग मॉडल पर) होता है। यह प्रोग्रामर को कोड लिखने की अनुमति देता है जैसे कि प्रत्येक थ्रेड स्वतंत्र रूप से काम कर रहा हो।
2.2 32 थ्रेड्स की इकाई “वॉर्प (Warp)”
ग्राफिक्स कंप्यूटिंग प्रोसेसर हार्डवेयर थ्रेड्स को अलग-अलग शेड्यूल नहीं करता है, बल्कि 32 थ्रेड्स के “वॉर्प (Warp)” की इकाई में उनका प्रबंधन और निष्पादन करता है। (AMD ग्राफिक्स कंप्यूटिंग प्रोसेसर में, इसे वेवफ्रंट कहा जाता है, और 64-थ्रेड इकाइयों को भी अपनाया जा सकता है)।
स्ट्रीमिंग मल्टीप्रोसेसर (SM) में निर्देश फ़ेच और डिकोड यूनिट वॉर्प के आधार पर एक निर्देश फ़ेच करती है और वॉर्प में सभी 32 थ्रेड्स को समान निर्देश जारी (डिस्पैच) करती है। दूसरे शब्दों में, वॉर्प में 32 थ्रेड शारीरिक रूप से ठीक एक ही समय में उनके अलग-अलग डेटा पर समान निर्देश निष्पादित करते हैं। यह SIMT का मूल है।
2.3 वॉर्प डाइवर्जेंस (शाखा बेमेल) का भौतिक जुर्माना
भले ही प्रत्येक थ्रेड ऐसे व्यवहार कर सकता है जैसे उसके पास एक स्वतंत्र प्रोग्राम काउंटर हो, शारीरिक रूप से वॉर्प में सभी थ्रेड्स को एक ही निर्देश निष्पादित करना चाहिए। तो क्या होता है यदि कोड में if-else जैसी एक सशर्त शाखा है, और शाखा की स्थिति का सत्य या असत्य वॉर्प में थ्रेड्स के बीच विभाजित है?
इस घटना को वॉर्प डाइवर्जेंस (Warp Divergence) कहा जाता है।
जब वॉर्प डाइवर्जेंस होता है, तो हार्डवेयर निम्न चरणों में प्रक्रिया करता है:
- सबसे पहले, यह निर्देश को केवल उन थ्रेड्स (सक्रिय थ्रेड्स) पर निष्पादित करता है जिनके लिए
ifशर्त सत्य है। इस समय, जिन थ्रेड्स के लिए शर्त गलत थी उन्हें “मास्क (अमान्य)” कर दिया जाता है, और गणना परिणाम नहीं लिखा जाता है। - इसके बाद, यह
elseस्थिति में परिवर्तित होता है (या वह पथ जहां स्थिति गलत है), और इस बार यह पहले से मास्क किए गए थ्रेड्स को सक्रिय करता है, सत्य थ्रेड्स को मास्क करता है, और निर्देश को निष्पादित करता है।
दूसरे शब्दों में, यदि कई शाखा पथ हैं, तो हार्डवेयर को उन पथों को समानांतर के बजाय क्रमिक रूप से निष्पादित करना होगा। एक चरम उदाहरण के रूप में, यदि एक वॉर्प में 32 थ्रेड 32 अलग-अलग शाखा पथ लेते हैं, तो निष्पादन का समय 32 गुना बढ़ जाएगा। वॉर्प डाइवर्जेंस ग्राफिक्स कंप्यूटिंग प्रोसेसर के कम्प्यूटेशनल थ्रूपुट को भारी रूप से कम करने वाले सबसे बड़े कारकों में से एक है, और एल्गोरिथ्म डिज़ाइन में बचने के लिए यह सबसे महत्वपूर्ण एंटी-पैटर्न है। भौतिक रूप से, इसका अर्थ है कि “व्यर्थ चक्र” उत्पन्न हो रहे हैं जहाँ ALU शक्ति का उपभोग कर रहा है लेकिन मास्क किए जाने के कारण वैध गणना परिणाम नहीं बना रहा है।
पूरक अध्याय 3 का परिशिष्ट: स्ट्रीमिंग मल्टीप्रोसेसर (SM) की हार्डवेयर शारीरिक रचना
ग्राफिक्स कंप्यूटिंग प्रोसेसर कई स्ट्रीमिंग मल्टीप्रोसेसर (SM: Streaming Multiprocessor) का एक संयोजन है। SM ग्राफिक्स कंप्यूटिंग प्रोसेसर का सच्चा कंप्यूट इंजन है। नवीनतम आर्किटेक्चर (उदा., Hopper H100) में, एक एकल ग्राफिक्स कंप्यूटिंग प्रोसेसर डाई पर 100 से अधिक SM लगे होते हैं।
3.1 SM के भीतर पाइपलाइन विन्यास
SM को आंतरिक रूप से कई उप-विभाजनों (आमतौर पर 4) में विभाजित किया जाता है, जिनमें से प्रत्येक का अपना स्वतंत्र वॉर्प शेड्यूलर और डिस्पैच यूनिट होता है।
- वॉर्प शेड्यूलर (Warp Scheduler): एक निष्पादन योग्य स्थिति (रजिस्टर और मेमोरी तैयार) में वॉर्प का चयन करता है। ग्राफिक्स कंप्यूटिंग प्रोसेसर शेड्यूलर शून्य ओवरहेड के साथ वॉर्प के बीच स्विच कर सकते हैं, जो मेमोरी एक्सेस लेटेंसी को छिपाने की कुंजी है।
- डिस्पैच यूनिट (Dispatch Unit): निर्धारित वॉर्प्स को निर्देश जारी करता है।
- CUDA कोर (INT32 / FP32 / FP64 ALU): इकाइयां जो वास्तविक पूर्णांक और फ़्लोटिंग-पॉइंट गणना करती हैं।
- लोड/स्टोर यूनिट (LD/ST Unit): मेमोरी को पढ़ने और लिखने के लिए जिम्मेदार।
- स्पेशल फंक्शन यूनिट (SFU): sin, cos, exp, और रेसिप्रोकल जैसे ट्रांसेंडेंटल फंक्शन्स की तेज गणना के लिए समर्पित हार्डवेयर।
निर्देश पाइपलाइन बहुत गहरी डिज़ाइन की गई है, जिसमें फ़ेच, डिकोड, शेड्यूलिंग, रजिस्टर रीड, निष्पादन (एकाधिक चक्र), और राइट-बैक के चरण शामिल हैं। FP32 FMA (Fused Multiply-Add) गणनाओं की लेटेंसी आमतौर पर कई चक्रों से लेकर एक दर्जन से अधिक चक्रों तक होती है, लेकिन हर चक्र पर अलग-अलग वॉर्प से निर्देश जारी करके, पाइपलाइन को हमेशा भरा रखा जाता है।
3.2 विशाल रजिस्टर फ़ाइल और रजिस्टर दबाव
SM एक रजिस्टर फ़ाइल से सुसज्जित है जो सामान्य-उद्देश्य कंप्यूटिंग प्रोसेसर की तुलना में बहुत अधिक विशाल है (उदा., प्रति SM 64KB से 256KB SRAM)। ऐसा इसलिए है क्योंकि यह SM पर एक साथ चलने वाले हजारों थ्रेड्स के सभी संदर्भों को बनाए रखता है।
कंटेक्स्ट स्विच शून्य चक्र में पूरा हो जाता है क्योंकि थ्रेड की रजिस्टर अवस्था को मेमोरी में सहेजने की कोई आवश्यकता नहीं है। हालाँकि, यदि प्रति थ्रेड उपयोग किए जाने वाले रजिस्टरों की संख्या बढ़ जाती है, तो SM के भीतर एक साथ लॉन्च किए जा सकने वाले वॉर्प्स की संख्या (ऑक्यूपेंसी) कम हो जाती है। इसे रजिस्टर प्रेशर कहा जाता है। जब रजिस्टर समाप्त हो जाते हैं, तो डेटा धीमी स्थानीय मेमोरी (भौतिक रूप से ग्लोबल मेमोरी का हिस्सा) में फैल जाता है, जिससे विनाशकारी प्रदर्शन गिरावट आती है।
3.3 शेयर्ड मेमोरी और बैंक संघर्ष
SM में एक अल्ट्रा-फास्ट ऑन-चिप मेमोरी, शेयर्ड मेमोरी (Shared Memory) है जिसे प्रोग्रामर द्वारा स्पष्ट रूप से नियंत्रित किया जा सकता है। यद्यपि यह L1 कैश के समान भौतिक SRAM क्षेत्र को साझा करता है, यह एक स्पष्ट डेटा कैश के रूप में कार्य करता है और इसका उपयोग ब्लॉक के भीतर थ्रेड्स के बीच डेटा साझाकरण और सिंक्रनाइज़ेशन के लिए किया जाता है।
शेयर्ड मेमोरी की भौतिक संरचना को कई स्वतंत्र मॉड्यूल (आमतौर पर 32) में विभाजित किया जाता है जिसे मेमोरी बैंक (Memory Banks) कहा जाता है। सन्निहित 32-बिट पते विभिन्न बैंकों में इंटरलीव्ड (आवंटित) किए जाते हैं।
जब वॉर्प में 32 थ्रेड एक साथ विभिन्न बैंकों तक पहुंचते हैं, तो पहुंच पूरी तरह से समानांतर में (1 चक्र में) संसाधित होती है। इसे बैंक-कंफ्लिक्ट-फ्री कहा जाता है। हालाँकि, जब कई थ्रेड एक ही समय में एक ही बैंक में विभिन्न पतों तक पहुँचने का प्रयास करते हैं, तो अनुरोधों को क्रमबद्ध किया जाता है और एक जुर्माना (देरी) होता है। इसे बैंक संघर्ष (Bank Conflict) कहा जाता है। उदाहरण के लिए, 2-तरफा बैंक संघर्ष के साथ एक्सेस का समय दोगुना हो जाता है, और सबसे खराब स्थिति में, 32-तरफा संघर्ष में 32 गुना देरी होगी। मैट्रिक्स ट्रांसपोज़ जैसे एल्गोरिदम में, स्ट्राइडेड एक्सेस के कारण गंभीर बैंक संघर्ष होते हैं, इसलिए अत्यधिक अनुकूलन आवश्यक है जो संघर्षों से बचने के लिए पैडिंग (मेमोरी एड्रेस को स्थानांतरित करने के लिए डमी डेटा सम्मिलित करना) का उपयोग करता है।
पूरक अध्याय 4 का परिशिष्ट: टेंसर कोर (Tensor Core) पाइपलाइन की गणना करें
Volta आर्किटेक्चर में पहली बार पेश किया गया, टेंसर कोर (Tensor Core) क्रांतिकारी हार्डवेयर है जिसने बाद के ग्राफिक्स कंप्यूटिंग प्रोसेसर के प्रदर्शन को काफी बढ़ा दिया। AI और डीप लर्निंग के विस्फोटक विकास की टेंसर कोर के बिना कल्पना नहीं की जा सकती।
4.1 मैट्रिक्स गुणा-संचय (MMA) का हार्डवेयर कार्यान्वयन
डीप लर्निंग गणनाओं का एक बड़ा हिस्सा न्यूरल नेटवर्क वेट मैट्रिक्स और इनपुट डेटा का मैट्रिक्स गुणन (GEMM: General Matrix Multiply) है। सूत्र को $D = A \times B + C$ के रूप में व्यक्त किया जाता है (जहाँ $A, B$ इनपुट मैट्रिक्स हैं और $C$ संचायक मैट्रिक्स है)।
पारंपरिक CUDA कोर में, इस मैट्रिक्स गुणन की गणना एक समय में एक तत्व में FMA (Fused Multiply-Add) निर्देशों का उपयोग करके की जाती थी। इसके विपरीत, एक टेंसर कोर एक समर्पित सर्किट है जो हार्डवेयर स्तर पर 1 चक्र (या कई चक्रों) में एक छोटे मैट्रिक्स (उदा., 4x4 या 16x16) के गुणन और जोड़ की गणना करता है।
भौतिक रूप से, दर्जनों से लेकर सैकड़ों गुणक और एक विशाल जोड़ पेड़ तारों से जुड़े हुए हैं, और मध्यवर्ती परिणामों को रजिस्टरों में वापस लिखे बिना गुणन-जोड़ एक ही बार में पूरा किया जाता है। परिणामस्वरूप, प्रति क्षेत्र (TFLOPS) गणना थ्रूपुट सामान्य CUDA कोर की तुलना में काफी अधिक है।
4.2 मिक्स्ड-प्रेसिजन (Mixed-Precision) का रहस्य
टेंसर कोर का एक और सार मिक्स्ड-प्रेसिजन गणना का समर्थन है। डीप लर्निंग में, कई स्थितियां ऐसी होती हैं जहां गणना प्रक्रिया के दौरान उच्च परिशुद्धता (FP32/FP64) की आवश्यकता नहीं होती है। टेंसर कोर में एक पाइपलाइन होती है जो इनपुट मैट्रिक्स $A$ और $B$ को कम सटीकता (FP16, BF16, या उससे भी कम FP8, INT8, INT4) में पढ़ती है, कम सटीकता में आंतरिक गुणन करती है, और फिर उच्च सटीकता (FP32 या INT32) में अतिरिक्त (संचय) प्रक्रिया करती है।
- FP16 / BF16: प्रशिक्षण के लिए मानक। BF16 (Bfloat16) में FP32 के समान 8 बिट्स का एक्सपोनेंट भाग होता है, और इसमें एक विस्तृत डायनामिक रेंज होती है, जिससे लुप्त हो रहे ग्रेडिएंट को रोकना आसान हो जाता है।
- FP8 / INT8 / INT4: अनुमान (Inference) में तेजी लाने के लिए ट्रम्प कार्ड। चूँकि डेटा ट्रांसफर मात्रा (मेमोरी बैंडविड्थ) भी कम हो जाती है, थ्रूपुट में नाटकीय रूप से सुधार होता है।
Hopper आर्किटेक्चर ने “FP8 Tensor Core” पेश किया, जो ट्रांसफार्मर मॉडल की गणना को नाटकीय रूप से गति देता है, सिद्धांत रूप में FP32 की तुलना में दसियों गुना थ्रूपुट प्राप्त करता है। सॉफ़्टवेयर की ओर से (CUDA), टेंसर कोर सीधे wmma (Warp-Level Matrix Multiply and Accumulate) API या mma.sync PTX निर्देश के माध्यम से संचालित होता है, और वॉर्प में थ्रेड्स मैट्रिक्स के टुकड़ों को लोड, गणना और रजिस्टर में स्टोर करने के लिए एक अत्यंत जटिल सामूहिक प्रसंस्करण करते हैं।
पूरक अध्याय 5 का परिशिष्ट: CUDA मेमोरी पदानुक्रम और अनुकूलन तकनीक
चाहे ग्राफिक्स कंप्यूटिंग प्रोसेसर की गणना क्षमता कितनी भी अधिक हो, यदि डेटा आपूर्ति एक अड़चन बन जाती है, तो प्रदर्शन प्राप्त नहीं किया जा सकता है (मेमोरी वॉल समस्या)। यह कहना अतिश्योक्ति नहीं है कि CUDA प्रोग्रामिंग में अनुकूलन का 90% “मेमोरी एक्सेस अनुकूलन” है।
5.1 ग्लोबल मेमोरी की कोलेसिंग एक्सेस
ग्राफिक्स कंप्यूटिंग प्रोसेसर की मुख्य मेमोरी (HBM या GDDR), ग्लोबल मेमोरी, की बैंडविड्थ बहुत विस्तृत (उदा., कई TB/s) है, लेकिन लेटेंसी भी सैकड़ों चक्रों में बहुत बड़ी है।
ग्लोबल मेमोरी तक पहुंच दक्षता को अधिकतम करने का पूर्ण सिद्धांत कोलेसिंग (Coalescing) है। ग्राफिक्स कंप्यूटिंग प्रोसेसर मेमोरी कंट्रोलर मेमोरी को 32-बाइट, 64-बाइट, या 128-बाइट लेनदेन में एक्सेस करता है। जब वॉर्प में 32 थ्रेड मेमोरी तक पहुंचते हैं, यदि उनके मेमोरी पते एक सन्निहित क्षेत्र (128-बाइट संरेखित सीमा के भीतर) में हैं, तो हार्डवेयर प्रसंस्करण के लिए इन अनुरोधों को एकल मेमोरी लेनदेन में जोड़ता (कोलेसेस) है।
इसके विपरीत, यदि थ्रेड्स यादृच्छिक पतों तक पहुंचते हैं, या यदि वे स्ट्राइडेड (अंतराल वाले) एक्सेस करते हैं, तो विलय नहीं होता है और कई लेनदेन होते हैं। इसे “नॉन-कोलेस्ड एक्सेस” कहा जाता है, जो एक घातक प्रदर्शन बग है जो प्रभावी मेमोरी बैंडविड्थ को इसके दसवें हिस्से या उससे कम तक कम कर देता है।
5.2 CUDA C++ कोड उदाहरण: मैट्रिक्स ट्रांसपोज़ेशन और शेयर्ड मेमोरी का अनुकूलन
नीचे मैट्रिक्स ट्रांसपोज़ के लिए एक अनुकूलित कर्नेल कोड का उदाहरण दिया गया है जो नॉन-कोलेस्ड एक्सेस से बचा जाता है और प्रदर्शन को नाटकीय रूप से बेहतर बनाने के लिए शेयर्ड मेमोरी का लाभ उठाता है।
| |
इस कोड के 3 मुख्य बिंदु हैं:
- पढ़ते समय कोलेसिंग:
idataसे पढ़ना X दिशा में किया जाता है जहाँthreadIdx.xसन्निहित है, इसलिए यह पूरी तरह से कोलेस्ड है। - लिखते समय कोलेसिंग:
odataपर लिखना भी ब्लॉक निर्देशांक की अदला-बदली करकेthreadIdx.xदिशा में सन्निहित होने के लिए डिज़ाइन किया गया है, और इसे कोलेस्ड किया जाता है। - शेयर्ड मेमोरी में पैडिंग: एक तत्व (
tile[TILE_DIM][TILE_DIM + 1]) द्वारा स्थानांतरित (पैडिंग) करके, लिखते समय कॉलम दिशा (tile[threadIdx.x][threadIdx.y + j]) में एक्सेस करते समय बैंक संघर्ष पूरी तरह से समाप्त हो जाते हैं।
5.3 कैश पदानुक्रम और विशेष मेमोरी
- L1/L2 कैश नीति: हाल के ग्राफिक्स कंप्यूटिंग प्रोसेसर आर्किटेक्चर में, प्रोग्रामर संकेत के रूप में PTX निर्देशों (
.ca,.cg,.cs, आदि) का उपयोग करके कैश व्यवहार को नियंत्रित कर सकते हैं। उदाहरण के लिए, डेटा जो केवल एक बार एक्सेस किया जाता है, L2 कैश (स्ट्रीमिंग एक्सेस) को बायपास कर सकता है, जिससे कैश प्रदूषण को रोका जा सकता है। - टेक्सचर मेमोरी / कॉन्स्टेंट मेमोरी: छवि प्रसंस्करण में विशेष टेक्सचर मेमोरी 2D स्थानिक स्थानीयता वाले एक्सेस के लिए एक समर्पित कैश का उपयोग करती है। कॉन्स्टेंट मेमोरी ब्रॉडकास्ट एक्सेस के लिए अत्यधिक कुशल है जहां सभी थ्रेड एक ही स्थिरांक पढ़ते हैं।
पूरक अध्याय 6 का परिशिष्ट: डीप लर्निंग युग में ग्राफिक्स कंप्यूटिंग प्रोसेसर का भविष्य
सिर्फ एक ग्राफिक्स कंप्यूटिंग प्रोसेसर के प्रदर्शन में सुधार करना ही नहीं, बल्कि संपूर्ण रूप से सिस्टम को स्केल करना वर्तमान कम्प्यूटेशनल विज्ञान की सीमा है।
6.1 NVLink और NVSwitch के साथ अल्ट्रा-फास्ट इंटरकनेक्शन
एक विशाल LLM (लार्ज लैंग्वेज मॉडल) एक ही ग्राफिक्स कंप्यूटिंग प्रोसेसर (जैसे 80GB या 144GB) की मेमोरी में फिट नहीं हो सकता है। मॉडल समानांतरकरण (टेंसर पैरेलल या पाइपलाइन पैरेलल) करने के लिए, ग्राफिक्स कंप्यूटिंग प्रोसेसर के बीच प्रति सेकंड टेराबाइट्स डेटा का आदान-प्रदान करना आवश्यक है। चूंकि पारंपरिक PCIe (PCI Express) बस इस बैंडविड्थ को कवर नहीं कर सकती है, NVIDIA ने NVLink नामक एक मालिकाना उच्च गति इंटरकनेक्ट विकसित किया। इसके अलावा, NVSwitch नामक स्विच चिप के माध्यम से, 8 या 256 जैसे ग्राफिक्स कंप्यूटिंग प्रोसेसर एक पूर्ण नॉन-ब्लॉकिंग क्रॉसबार स्विच से जुड़े होते हैं, जिससे ऐसे क्लस्टर बनाना संभव हो जाता है जो ऐसे व्यवहार करते हैं मानो वे एक विशाल ग्राफिक्स कंप्यूटिंग प्रोसेसर हों।
6.2 ट्रांसफार्मर इंजन और FP8 इकोसिस्टम
ट्रांसफार्मर आर्किटेक्चर को अनुकूलित करने के लिए, जो न केवल प्राकृतिक भाषा प्रसंस्करण के लिए बल्कि छवि और वाक् पहचान के लिए भी वास्तविक मानक बन गया है, Hopper आर्किटेक्चर एक समर्पित हार्डवेयर और सॉफ्टवेयर समन्वय तंत्र से सुसज्जित है जिसे Transformer Engine कहा जाता है। यह एक ऐसा तंत्र है जो गतिशील रूप से टेंसर आँकड़ों की निगरानी करता है और सटीकता में गिरावट को रोकते हुए चरम गणना गति और मेमोरी बैंडविड्थ बचत प्राप्त करने के लिए प्रत्येक परत (Dynamic Scaling) के लिए FP8 और FP16 गणना सटीकता के बीच स्वचालित रूप से स्विच करता है।
6.3 ग्राफिक्स कंप्यूटिंग प्रोसेसर क्लस्टर के स्केलिंग कानून और भविष्य की संभावनाएं
जैसा कि OpenAI का “Scaling Laws” दिखाता है, AI का प्रदर्शन तब तक बढ़ता रहता है जब तक मॉडल मापदंडों की संख्या और गणना की मात्रा बढ़ाई जाती है। इसके साथ ही, ग्राफिक्स कंप्यूटिंग प्रोसेसर एक साधारण प्रोसेसर से “डेटा सेंटर जो स्वयं एक विशाल ग्राफिक्स कंप्यूटिंग प्रोसेसर (सुपरकंप्यूटर) है” में विकसित हो रहे हैं, जिसमें ऑप्टिकल फाइबर के साथ हजारों इकाइयां जुड़ी हुई हैं।
भविष्य के आर्किटेक्चर का विकास सिलिकॉन फोटोनिक्स (ऑप्टिकल इंटरकनेक्ट), CPO (Co-Packaged Optics), और SRAM से HBM तक 3D स्टैकिंग तकनीक के और परिष्कृत होने की दिशा में आगे बढ़ेगा। हालाँकि, “समानांतर प्रसंस्करण द्वारा थ्रूपुट का अधिकतमकरण” का मूल DNA, जो कि ग्राफिक्स कंप्यूटिंग प्रोसेसर के जन्म के समय से नहीं बदला है, कम्प्यूटेशनल विज्ञान के मोर्चे को आगे बढ़ाता रहेगा।
निष्कर्ष: कम्प्यूटेशनल साइंस की चरम सीमाओं तक
GPU आर्किटेक्चर मानव जाति द्वारा अब तक बनाया गया सबसे जटिल और थ्रूपुट-केंद्रित कंप्यूटिंग इंजन है। यदि एक CPU “एक अति-उच्च-प्रदर्शन F1 मशीन” है, तो एक GPU की तुलना “एक विशाल रसद प्रणाली से की जा सकती है जिसमें हजारों डंप ट्रक समन्वित आंदोलनों के साथ एक साथ सामग्री का परिवहन करते हैं।”
SIMT के साथ वॉर्प-स्तर निर्देश निष्पादन, हार्डवेयर शेड्यूलिंग जो शून्य चक्रों में हजारों थ्रेड्स को स्विच करता है, कोलेसिंग एक्सेस जो बैंडविड्थ को अपनी सीमा तक बढ़ाता है, और टेंसर कोर पाइपलाइन जिसने डीप लर्निंग में सफलताएं प्राप्त की हैं। ये सभी इंजीनियरों के जुनूनी दृढ़ संकल्प के क्रिस्टलीकरण हैं, जिन्हें लगभग पागलपन कहा जा सकता है, “भौतिक नियमों की सीमाओं (प्रकाश की गति, गर्मी, शक्ति, सिलिकॉन मिनिएचराइजेशन सीमा) के भीतर फ़्लोटिंग-पॉइंट गणना की कुल मात्रा को कैसे अधिकतम किया जाए”।
भविष्य के सॉफ्टवेयर इंजीनियरों, एआई शोधकर्ताओं और एचपीसी शोधकर्ताओं के लिए, GPU आर्किटेक्चर को समझना केवल एक सामान्य ज्ञान नहीं है। यह सहज रूप से समझने के लिए एक “आवश्यक विषय” है कि फ्रेमवर्क (जैसे PyTorch और TensorFlow) के पीछे क्या हो रहा है और हार्डवेयर की क्षमताओं को उसकी सीमा तक कैसे ले जाना है। मेमोरी बैंक संघर्षों से बचना, वॉर्प डाइवर्जेंस को खत्म करना, और टेंसर कोर पाइपलाइन को डेटा से भरा रखना। उस अनुकूलन के अंत में, एक ऐसा भविष्य जहां सुपर कंप्यूटरों पर गणना करने में महीनों लगते थे, अब आपके डेस्क पर कुछ GPU के साथ कुछ घंटों में पूरा किया जा सकता है, ठीक अभी एक वास्तविकता बन रहा है।
हम अब मानव इतिहास में कंप्यूटर आर्किटेक्चर के सबसे रोमांचक स्वर्ण युग में जी रहे हैं। CUDA की भौतिकी और GPU के मैसिव पैरेलल आर्किटेक्चर के सार को समझना और अगली पीढ़ी के नवाचारों को जन्म देना, वह आप ही हो सकते हैं जो इस लेख को पढ़ रहे हैं।
शब्दावली (Glossary)
- SM (Streaming Multiprocessor): GPU का मुख्य कंप्यूटिंग ब्लॉक। यह एक CPU कोर के बराबर है, लेकिन इसके भीतर कई CUDA कोर, वॉर्प शेड्यूलर, शेयर्ड मेमोरी आदि शामिल हैं।
- SIMT (Single Instruction, Multiple Threads): एक GPU-विशिष्ट निष्पादन मॉडल जिसमें वॉर्प में सभी थ्रेड स्वतंत्र डेटा पर संचालन करते हुए समान निर्देश साझा करते हैं।
- Warp (वॉर्प): 32 थ्रेड्स का एक संग्रह। हार्डवेयर शेड्यूलिंग और निर्देश जारी करने की न्यूनतम इकाई।
- Warp Divergence (वॉर्प डाइवर्जेंस): एक ऐसी घटना जिसमें वॉर्प में थ्रेड्स के बीच शाखा की स्थिति विभाजित हो जाती है, जिससे निष्पादन पथ क्रमबद्ध हो जाता है और थ्रूपुट कम हो जाता है।
- Tensor Core (टेंसर कोर): एक समर्पित सर्किट जो हार्डवेयर स्तर पर मैट्रिक्स गुणन और संचय (MMA) को एक ही बार में संसाधित करता है। डीप लर्निंग को गति देने में विशिष्ट।
- Coalesced Access (कोलेस्ड एक्सेस): एक तंत्र जिसके द्वारा हार्डवेयर एक लेनदेन में सन्निहित मेमोरी पतों तक पहुँचने पर उच्च बैंडविड्थ प्राप्त करने के लिए एक वॉर्प में थ्रेड्स के मेमोरी एक्सेस को जोड़ता है।
- Shared Memory (शेयर्ड मेमोरी): SM के भीतर स्थित प्रोग्रामर-नियंत्रणीय अल्ट्रा-फास्ट L1 स्क्रैचपैड मेमोरी।
- Bank Conflict (बैंक संघर्ष): शेयर्ड मेमोरी में एक जुर्माना जहां कई थ्रेड एक साथ एक ही बैंक में विभिन्न पतों तक पहुंचते हैं, जिसके परिणामस्वरूप एक्सेस का क्रमिकरण होता है।
- Occupancy (ऑक्यूपेंसी / अधिभोग): SM पर एक साथ सक्रिय किए जा सकने वाले वॉर्प्स की सैद्धांतिक अधिकतम संख्या के विरुद्ध वास्तविक वॉर्प्स का अनुपात। यह जितना अधिक होगा, मेमोरी एक्सेस लेटेंसी को छिपाना उतना ही आसान होगा।
- Register Spilling (रजिस्टर स्पिलिंग): एक ऐसी घटना जिसमें थ्रेड्स द्वारा उपयोग किए जाने वाले रजिस्टरों की संख्या हार्डवेयर सीमा से अधिक हो जाती है, और अतिप्रवाहित डेटा धीमी मेमोरी (स्थानीय मेमोरी) में सहेजा जाता है।
संदर्भ और अनुशंसित पठन सूची
- NVIDIA CUDA C++ Programming Guide: सभी CUDA प्रोग्रामरों के लिए पढ़ना आवश्यक आधिकारिक दस्तावेज़। मेमोरी एक्सेस पैटर्न और अनुकूलन के लिए सर्वोत्तम प्रथाओं को कवर करता है।
- NVIDIA Ampere / Hopper Architecture Whitepaper: आधिकारिक श्वेतपत्र जो टेंसर कोर पाइपलाइनों, अतुल्यकालिक मेमोरी ट्रांसफर, और ट्रांसफार्मर इंजन के हार्डवेयर कार्यान्वयन का विवरण देता है।
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): कंप्यूटर आर्किटेक्चर पर एक क्लासिक कृति। CPU और GPU के बीच डिज़ाइन दर्शन में अंतर, कैश पदानुक्रम और निर्देश-स्तर समानता के बारे में गहराई से जानें।
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): एल्गोरिथ्म डिज़ाइन के नजरिए से CUDA प्रोग्रामिंग की व्याख्या करने वाली एक पाठ्यपुस्तक। शेयर्ड मेमोरी टाइलिंग तकनीक, रिडक्शन, प्रीफिक्स सम और बहुत कुछ के कार्यान्वयन का विवरण देता है।
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: एक अकादमिक पेपर। एक मास्टरपीस जो माइक्रोबेंचमार्किंग के माध्यम से NVIDIA के अघोषित कैश लेटेंसी और सटीक टेंसर कोर थ्रूपुट को उजागर करता है।
इस लेख में बताए गए आर्किटेक्चरल ज्ञान का कुछ हिस्सा हार्डवेयर विकसित होने पर पुराना हो सकता है, लेकिन “बैंडविड्थ को अधिकतम करने, समानता निकालने और लेटेंसी को छिपाने” का मौलिक भौतिक सिद्धांत कंप्यूटर विज्ञान की सार्वभौमिक सच्चाई के रूप में बना रहेगा।