परिचय
कंप्यूटर विज्ञान में, यह पता लगाना बहुत महत्वपूर्ण है कि क्या डेटा संरचनाओं में कोई अप्रत्याशित “चक्र (साइकिल)” मौजूद है, ताकि अनंत लूप से बचा जा सके। इस समस्या को हल करने के लिए सबसे शानदार तरीकों में से एक रॉबर्ट फ्लॉयड का साइकिल-फाइंडिंग एल्गोरिदम (Floyd’s cycle-finding algorithm) है।
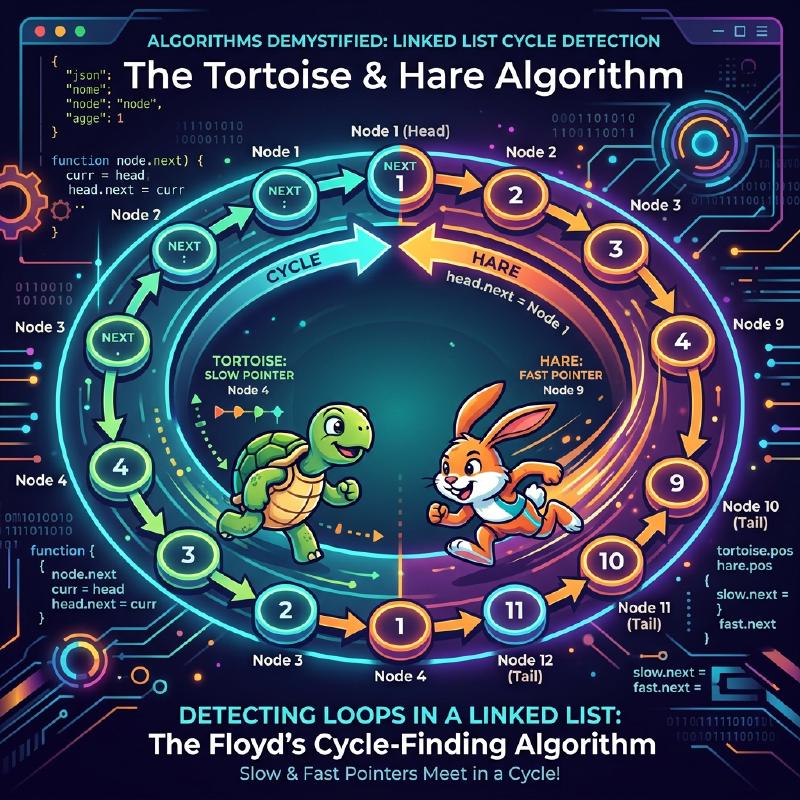
इस एल्गोरिदम को कछुआ और खरगोश एल्गोरिदम (Tortoise and Hare Algorithm) के रूप में भी जाना जाता है क्योंकि यह दो पॉइंटर्स का उपयोग करता है जो अलग-अलग गति (जिन्हें छद्म रूप से “खरगोश” और “कछुआ” कहा जाता है) से चलते हैं।
इस लेख में, हम इस एल्गोरिदम के तंत्र से लेकर इसके गणितीय पृष्ठभूमि, और C++ तथा Rust के उपयोग से विशिष्ट कार्यान्वयन उदाहरणों तक सब कुछ विस्तार से बताएंगे।
चक्र (साइकिल) का पता लगाना क्या है?
सिंगली लिंक्ड लिस्ट (Singly Linked List) या स्टेट ट्रांज़िशन ग्राफ़ में, यदि आप एक नोड से दूसरे नोड पर जाते हैं और एक ऐसी संरचना में पहुँच जाते हैं जहाँ आप पहले देखे गए नोड पर फिर से पहुँच जाते हैं, तो इसे चक्र (साइकिल) कहा जाता है।
उदाहरण के लिए, निम्नलिखित लिंक्ड लिस्ट पर विचार करें।
  graph LR
    subgraph "Linked List Loop"
        A["Node 1"] -->|"next"| B["Node 2"]
        B -->|"next"| C["Node 3"]
        C -->|"next"| D["Node 4"]
        D -->|"next"| E["Node 5"]
        E -->|"next"| C
    end
इस सूची में, Node 5 के बाद Node 3 आता है, जिससे 3 → 4 → 5 → 3 का एक लूप बनता है। जो प्रोग्राम केवल क्रम में चलता है वह इस लूप में फंस जाएगा और अनंत लूप का कारण बनेगा।
इससे निपटने का एक तरीका यह है कि देखे गए नोड्स को हैश सेट (जैसे std::unordered_set) में रिकॉर्ड किया जाए। हालाँकि, इस विधि के लिए $O(N)$ की अतिरिक्त मेमोरी स्पेस की आवश्यकता होती है, जो नोड्स की संख्या के समानुपाती होती है। फ्लॉयड का साइकिल-फाइंडिंग एल्गोरिदम मेमोरी स्पेस को $O(1)$ तक सीमित रखते हुए $O(N)$ समय में साइकिल का पता लगा सकता है।
कछुआ और खरगोश एल्गोरिदम कैसे काम करता है
एल्गोरिदम का विचार बहुत सहज है। एक ही ट्रैक पर अलग-अलग गति से दौड़ने वाले दो धावकों की कल्पना करें। यदि ट्रैक एक सीधी रेखा है, तो तेज़ धावक धीमे धावक को पीछे छोड़ देगा। हालाँकि, यदि ट्रैक में एक सर्किट (चक्र) शामिल है, तो तेज़ धावक अंततः धीमे धावक को एक “लैप” से पीछे छोड़ देगा और पीछे से उसके पास आ जाएगा।
विशेष रूप से, निम्नलिखित दो पॉइंटर्स का उपयोग किया जाता है।
- कछुआ (Tortoise) : प्रति चरण 1 नोड आगे बढ़ता है।
- खरगोश (Hare) : प्रति चरण 2 नोड आगे बढ़ता है।
दोनों एक ही समय में शुरू होते हैं, और यदि खरगोश अंत (null) तक पहुँच जाता है, तो कोई चक्र मौजूद नहीं है। यदि कोई चक्र मौजूद है, तो खरगोश और कछुआ निश्चित रूप से किसी बिंदु पर एक ही नोड को इंगित करेंगे।
क्रिया का चित्रण
आइए निम्नलिखित जैसे चक्र वाले ग्राफ पर विचार करें।
  graph LR
    subgraph "Cycle Detection"
        1((1)) -->|"step"| 2((2))
        2 -->|"step"| 3((3))
        3 -->|"step"| 4((4))
        4 -->|"step"| 5((5))
        5 -->|"step"| 6((6))
        6 -->|"loop"| 3
    end
प्रत्येक चरण के लिए पॉइंटर्स की गति इस प्रकार है। (※ कछुआ = $T$, खरगोश = $H$)
- Step 0: $T=1$, $H=1$
- Step 1: $T=2$, $H=3$
- Step 2: $T=3$, $H=5$
- Step 3: $T=4$, $H=3$
- Step 4: $T=5$, $H=5$ (यहाँ मेल खाता है, चक्र का पता चला!)
गणितीय प्रमाण और चक्र की शुरुआत की पहचान करना
आइए गणितीय सूत्रों का उपयोग करके साबित करें कि एल्गोरिदम हमेशा टकराएगा और हम यह कैसे पता लगा सकते हैं कि चक्र कहाँ से शुरू होता है (प्रतिच्छेदन)।
मान लें कि सूची की शुरुआत से चक्र की शुरुआत तक की दूरी $x$ है। चक्र की शुरुआत से उस बिंदु तक की दूरी जहां दो पॉइंटर्स टकराते हैं, उसे $y$ मान लें। टकराव के बिंदु से चक्र की शुरुआत में लौटने की दूरी $z$ मान लें। इसलिए, चक्र की कुल लंबाई $C = y + z$ है।
जब कछुआ और खरगोश टकराते हैं, तो उनकी संबंधित यात्रा की दूरियां इस प्रकार होती हैं:
- कछुए द्वारा तय की गई दूरी: $d_T = x + y$
- खरगोश द्वारा तय की गई दूरी: $d_H = x + y + kC$ ($k$ खरगोश द्वारा चक्र के चारों ओर लगाए गए चक्करों की संख्या है)
चूंकि खरगोश कछुए से दोगुनी गति से चलता है, इसलिए निम्नलिखित समीकरण सत्य है।
$$ 2 \cdot d_T = d_H $$$$ 2(x + y) = x + y + kC $$$$ x + y = kC $$$$ x = kC - y $$$$ x = k(y + z) - y $$$$ x = (k - 1)(y + z) + z $$$$ x = (k - 1)C + z $$यह समीकरण $x = (k - 1)C + z$ बहुत महत्वपूर्ण अर्थ रखता है। जहाँ $k - 1$, $0$ या उससे बड़ा पूर्णांक है। यह दर्शाता है कि “सूची की शुरुआत से चक्र की शुरुआत तक की दूरी $x$” “टकराव के बिंदु से चक्र की शुरुआत तक की शेष दूरी $z$” के बराबर है, जिसमें चक्र की लंबाई $C$ का एक पूर्णांक गुणक ($(k-1)C$) जोड़ा गया है।
दूसरे शब्दों में, इसके तुरंत बाद टकराव होता है, यदि आप एक पॉइंटर को सूची की शुरुआत में वापस कर देते हैं और दूसरे पॉइंटर को टकराव बिंदु पर छोड़ देते हैं, और दोनों को एक-एक कदम आगे बढ़ाते हैं, तो वे निश्चित रूप से चक्र के आरंभिक बिंदु पर मिलेंगे। ऐसा इसलिए है क्योंकि शुरुआत से शुरू होने वाले पॉइंटर को दूरी $x$ तय करके चक्र के शुरुआती बिंदु तक पहुंचने में जो समय लगता है, उसी दौरान टकराव बिंदु से शुरू होने वाला पॉइंटर दूरी $z$ तय करेगा और चक्र के शुरुआती बिंदु पर पहुंचेगा, और फिर चक्र के चारों ओर $(k-1)$ चक्कर लगाएगा। परिणामस्वरूप, दोनों ठीक एक ही समय में चक्र के शुरुआती बिंदु पर पहुंचेंगे और मिल जाएंगे।
कोड कार्यान्वयन
अब, आइए C++ और Rust में उपरोक्त सिद्धांत को लागू करें।
C++ कार्यान्वयन
यहाँ सिंगली लिंक्ड लिस्ट के लिए एक नोड स्ट्रक्चर, साइकिल की जाँच करने वाला फ़ंक्शन, और साइकिल का शुरुआती नोड खोजने वाले फ़ंक्शन का कार्यान्वयन दिया गया है।
| |
Rust कार्यान्वयन
Rust में, स्वामित्व (ownership) और उधार (borrowing) के नियमों के कारण लिंक्ड लिस्ट का कार्यान्वयन जटिल हो जाता है, लेकिन प्रतिस्पर्धी प्रोग्रामिंग आदि में इसे सरणी (या Vec) पर इंडेक्स संदर्भ समस्या के रूप में मॉडल करना आम है।
यहाँ एक कार्यान्वयन उदाहरण दिया गया है जो “अगले पॉइंटर” के बजाय “अगला इंडेक्स” रखने वाली सरणी का उपयोग करता है।
| |
जटिलता विश्लेषण (Complexity Analysis)
इस एल्गोरिदम में बहुत अच्छे प्रदर्शन लक्षण हैं।
- समय जटिलता: $O(N)$ खरगोश चक्र में प्रवेश करने तक अधिकतम $N$ कदम चलता है, और चक्र में प्रवेश करने के बाद, वह कछुए के पास पहुंचने तक अधिकतम $C$ (चक्र की लंबाई) कदम चलता है। चूँकि $C \le N$, कुल चरणों की संख्या रैखिक समय के भीतर रहती है।
- स्थान जटिलता: $O(1)$ देखे गए नोड्स को हैश सेट आदि में याद रखने की कोई आवश्यकता नहीं है, और केवल दो पॉइंटर चर बनाए रखना पर्याप्त है, इसलिए अतिरिक्त मेमोरी का उपयोग निरंतर स्थान (constant space) है।
अन्य अनुप्रयोग
फ्लॉयड के साइकिल-फाइंडिंग एल्गोरिदम को केवल लिंक्ड लिस्ट में साइकिल का पता लगाने के अलावा, विभिन्न एल्गोरिदम पर लागू किया गया है।
- पोलार्ड की $\rho$ (rho) फैक्टराइजेशन विधि: यह एक एल्गोरिदम है जो एक बड़ी समग्र संख्या के अभाज्य कारकों (prime factors) को कुशलतापूर्वक ढूंढता है, इस तथ्य का उपयोग करते हुए कि यादृच्छिक संख्या जनरेटर का आउटपुट अनुक्रम एक चक्र में प्रवेश करता है। यह एक शक्तिशाली फैक्टराइजेशन एल्गोरिदम है जिसका उपयोग क्रिप्टोग्राफी के क्षेत्र में भी किया जाता है।
- डुप्लिकेट संख्या ढूँढना (Find the Duplicate Number):
उदाहरण के लिए, मान लें कि आपके पास $N+1$ तत्वों के साथ एक सरणी है, और प्रत्येक तत्व का मान $1$ से $N$ की सीमा में है। पिजनहोल सिद्धांत (Pigeonhole principle) के अनुसार, कम से कम एक संख्या डुप्लिकेट है। सरणी में तत्वों को “अगले इंडेक्स के पॉइंटर्स” के रूप में मानकर, इसे डुप्लिकेट तत्वों को एक चक्र के शुरुआती बिंदु के रूप में खोजने की विधि पर लागू किया जा सकता है, जबकि सरणी स्थान को $O(1)$ पर रखा जाता है। यह LeetCode जैसी प्रसिद्ध कोडिंग साक्षात्कार समस्याओं में भी अक्सर प्रकट होता है।
विशेष रूप से, जब सरणी
numsदी जाती है, तो राज्य संक्रमण कोnext_node = nums[current_node]के रूप में परिभाषित किया जाता है। एक डुप्लिकेट मान के अस्तित्व का मतलब है कि कई अलग-अलग इंडेक्स से एक ही मान (यानी वही अगला नोड) में संक्रमण मौजूद है, जो एक चक्र का प्रवेश द्वार बनाता है। इसलिए, कछुआ और खरगोश एल्गोरिदम को सीधे लागू करके, आप $O(N)$ समय जटिलता और $O(1)$ स्थान जटिलता के साथ डुप्लिकेट मान (चक्र की शुरुआत) को इंगित कर सकते हैं।
  graph TD
    subgraph "Applications of Floyd's Algorithm"
        A["Applications"] -->|"Linked List"| B["Cycle Detection"]
        A -->|"Number Theory"| C["Pollard's rho"]
        A -->|"Array Problems"| D["Duplicate Detection"]
    end
निष्कर्ष
इस लेख में, हमने रॉबर्ट फ्लॉयड का साइकिल-फाइंडिंग एल्गोरिदम (कछुआ और खरगोश एल्गोरिदम) समझाया। यद्यपि यह अलग-अलग गति पर दो पॉइंटर्स चलाने का एक सरल विचार है, यह एक शानदार तरीका है जो $O(N)$ समय और $O(1)$ स्थान में चक्र का पता लगाने और शुरुआती बिंदु की पहचान को सक्षम बनाता है। गणितीय समर्थन को समझकर, यह स्पष्ट हो गया होगा कि टकराव के बाद एक पॉइंटर को शुरुआत में वापस करने और उसे उसी गति से आगे बढ़ाने से शुरुआती बिंदु का पता क्यों चल सकता है।
डेटा संरचनाओं को लागू करते समय या प्रतिस्पर्धी प्रोग्रामिंग में यह एल्गोरिदम एक बहुत शक्तिशाली उपकरण हो सकता है। इसे स्वयं आज़माएँ और इसे C++ या Rust में लागू करें।