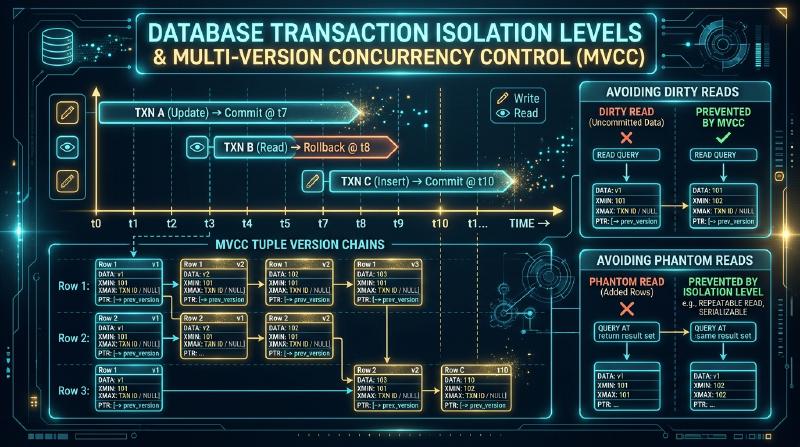
डेटाबेस ट्रांजेक्शन आइसोलेशन लेवल और MVCC: ACID की वास्तविकता और मल्टी-वर्ज़न कॉनकरेंसी कंट्रोल
आधुनिक सॉफ्टवेयर आर्किटेक्चर में, रिलेशनल डेटाबेस मैनेजमेंट सिस्टम (RDBMS) अभी भी डेटा पर्सिस्टेंस (डेटा को स्थायी रखने) का एक महत्वपूर्ण हिस्सा बना हुआ है। इसके मूल में “ट्रांजेक्शन” की अवधारणा है, और विशेष रूप से ACID गुण (Atomicity, Consistency, Isolation, Durability) मजबूत सिस्टम बनाने के लिए मूलभूत सिद्धांत के रूप में व्यापक रूप से पहचाने जाते हैं। हालांकि, ACID गुणों में “आइसोलेशन (Isolation - अलगाव)” एक ऐसा क्षेत्र है जहाँ सिद्धांत और व्यवहार के बीच सबसे बड़ी खाई मौजूद है।
इस लेख में, हम डेटाबेस ट्रांजेक्शन आइसोलेशन लेवल की ऐतिहासिक पृष्ठभूमि से लेकर ANSI SQL-92 मानक की सीमाओं और आधुनिक डेटाबेस इंजनों द्वारा अपनाए गए मल्टी-वर्ज़न कॉनकरेंसी कंट्रोल (MVCC) की आंतरिक संरचना तक, बहुत विस्तृत, शैक्षणिक और व्यावहारिक दृष्टिकोण से गहराई में जाएंगे। विशेष रूप से, हम दो प्रमुख ओपन-सोर्स RDBMS, PostgreSQL और MySQL (InnoDB) के MVCC कार्यान्वयन के महत्वपूर्ण अंतरों का विश्लेषण करेंगे, और डिस्ट्रीब्यूटेड डेटाबेस में सबसे आगे रहने वाले सीरियलाइज़ेबल स्नैपशॉट आइसोलेशन (SSI) को कवर करते हुए कुल 12,000 से अधिक अक्षरों वाली इस वृहद कृति के रूप में प्रस्तुत करेंगे।
अध्याय 1: ACID गुणों का मिथक और कॉनकरेंसी (समानांतर प्रसंस्करण) की दुविधा
1.1 सीरियलाइज़ेबिलिटी (Serializability - क्रमिक होने की क्षमता) का आदर्श
ट्रांजेक्शन के आइसोलेशन (अलगाव) का अंतिम आदर्श “सीरियलाइज़ेबिलिटी (Serializability)” है। यह उस गुण को संदर्भित करता है जहाँ भले ही कई ट्रांजेक्शन एक साथ समानांतर में निष्पादित होते हैं, उनका निष्पादन परिणाम “उस परिणाम के बराबर होता है यदि ट्रांजेक्शन को किसी क्रम में एक-एक करके क्रमिक रूप से (सीरियल तरीके से) निष्पादित किया गया हो।”
जब सिस्टम पर ट्रांजेक्शन $T_1$ और $T_2$ एक साथ निष्पादित होते हैं, तो समानांतर निष्पादन के कारण इंटरलीविंग (ऑपरेशंस का एक-दूसरे को काटना) चाहे कैसे भी हो, यदि अंतिम डेटाबेस अवस्था “$T_1 \rightarrow T_2$” या “$T_2 \rightarrow T_1$” के क्रम में निष्पादित होने वाले परिणाम के पूरी तरह से मेल खाती है, तो उस शेड्यूल को सीरियलाइज़ेबल के रूप में परिभाषित किया जाता है। यदि यह सीरियलाइज़ेबिलिटी सुनिश्चित की जाती है, तो एप्लिकेशन डेवलपर्स कॉनकरेंसी (समानांतर प्रसंस्करण) के कारण होने वाली डेटा विसंगतियों (रेस कंडीशन या अनुचित ओवरराइटिंग आदि) के बारे में चिंता किए बिना, पूरी तरह से व्यावसायिक लॉजिक (बिज़नेस लॉजिक) बनाने पर ध्यान केंद्रित कर सकते हैं।
1.2 लॉक के कारण सीरियलाइज़ेशन का प्रदर्शन पतन
शुरुआती डेटाबेस सिस्टम में, इस सीरियलाइज़ेबिलिटी को सुनिश्चित करने के लिए “टू-फेज़ लॉकिंग (2PL: Two-Phase Locking)” नामक एक सख्त लॉकिंग मैकेनिज़्म अपनाया गया था। 2PL में, एक ट्रांजेक्शन डेटा पढ़ने या लिखने से पहले हमेशा एक लॉक (शेयर्ड लॉक या एक्सक्लूसिव लॉक) प्राप्त करता है (चरण 1: ग्रोइंग फेज़), और ट्रांजेक्शन के अंत में (कमिट या रोलबैक के दौरान) सभी लॉक मुक्त कर देता है (चरण 2: श्रिंकिंग फेज़)।
हालाँकि, इस सख्त लॉकिंग मैकेनिज़्म में एक गंभीर खामी थी। वह था “प्रदर्शन का अत्यधिक क्षरण”।
- रीड ऑपरेशन (पढ़ने की क्रिया) राइट ऑपरेशन (लिखने की क्रिया) को ब्लॉक कर देता है।
- राइट ऑपरेशन रीड ऑपरेशन को ब्लॉक कर देता है।
- लॉक विवादों (कॉन्फ़्लिक्ट्स) के कारण प्रतीक्षा समय में वृद्धि, और डेडलॉक का अक्सर होना।
जब ट्रैफ़िक बढ़ गया और बहुत सारे उपयोगकर्ता एक साथ डेटाबेस तक पहुंचने लगे, तो 2PL द्वारा पूर्ण सीरियलाइज़ेशन सिस्टम के लिए एक अड़चन (बॉटलनेक) बन गया, और थ्रूपुट (throughput) में भारी गिरावट आई। सिस्टम को “डेटा कंसिस्टेंसी (संगतता)” और “कॉनकरेंसी परफॉरमेंस (समानांतर प्रसंस्करण प्रदर्शन/थ्रूपुट)” के बीच ट्रेड-ऑफ़ (समझौता) की दुविधा का सामना करना पड़ा।
1.3 कॉनकरेंसी कंट्रोल (मल्टी-वर्ज़न नियंत्रण) का इतिहास और समझौता
इस दुविधा को हल करने के लिए, डेटाबेस इंजीनियरिंग के शोधकर्ताओं ने “आइसोलेशन लेवल (Isolation Level)” की अवधारणा पेश की। यह पूर्ण सीरियलाइज़ेबिलिटी को कुछ हद तक शिथिल करने और विशिष्ट डेटा विसंगतियों (Anomaly - असामान्यता) को होने देने के बदले समानांतर प्रसंस्करण प्रदर्शन (कॉनकरेंसी परफॉरमेंस) को बढ़ाने का एक “समझौतापूर्ण उत्पाद” है। इसने एप्लिकेशन की आवश्यकताओं के अनुसार कंसिस्टेंसी (संगतता) और प्रदर्शन के बीच संतुलन चुनना संभव बना दिया।
अध्याय 2: ANSI SQL-92 मानक के आइसोलेशन लेवल और उनकी आलोचना
2.1 ANSI SQL-92 मानक द्वारा आइसोलेशन लेवल की परिभाषा
1992 में स्थापित SQL मानक “SQL-92” ने, समानांतर प्रसंस्करण (कॉनकरेंसी) के कारण हो सकने वाली 3 सामान्य असामान्यताओं (Phenomena) के आधार पर 4 आइसोलेशन लेवल को परिभाषित किया।
परिभाषित 3 असामान्यताएं (Phenomena)
- Dirty Read (डर्टी रीड): एक ऐसी घटना जिसमें ट्रांजेक्शन $T_1$ डेटा को अपडेट करता है और अभी तक कमिट नहीं हुआ है, और एक अन्य ट्रांजेक्शन $T_2$ उस अनकमिटेड (अप्रतिबद्ध) डेटा को पढ़ लेता है। यदि $T_1$ रोलबैक हो जाता है, तो इसका मतलब है कि $T_2$ ने ऐसे प्रेत (फ़ैंटम) डेटा को पढ़ा है जो अस्तित्व में नहीं है।
- Non-repeatable Read (नॉन-रिपीटेबल रीड / दोहराए न जा सकने वाली पढ़ाई): एक ऐसी घटना जिसमें ट्रांजेक्शन $T_1$ एक ही पंक्ति को दो बार पढ़ता है, और इस बीच एक अन्य ट्रांजेक्शन $T_2$ उस पंक्ति को अपडेट और कमिट कर देता है। $T_1$ के पहले और दूसरे रीडिंग के परिणाम अलग-अलग हो जाते हैं।
- Phantom Read (फैंटम रीड / प्रेत पढ़ाई): एक ऐसी घटना जिसमें ट्रांजेक्शन $T_1$ एक विशिष्ट खोज शर्त के साथ कई पंक्तियों को पढ़ता है, और इस बीच एक अन्य ट्रांजेक्शन $T_2$ उस शर्त को पूरा करने वाली एक नई पंक्ति सम्मिलित करता है (या हटाता है) और कमिट कर देता है। जब $T_1$ फिर से उसी शर्त के साथ खोजता है, तो पंक्तियों की संख्या बढ़ या घट जाती है।
SQL-92 द्वारा 4 आइसोलेशन लेवल
SQL-92 ने इन असामान्यताओं की रोकथाम के स्तर के आधार पर आइसोलेशन लेवल को परिभाषित किया।
- Read Uncommitted: डर्टी रीड (Dirty Read) की अनुमति देता है।
- Read Committed: डर्टी रीड को रोकता है, लेकिन नॉन-रिपीटेबल रीड और फैंटम रीड की अनुमति देता है।
- Repeatable Read: डर्टी रीड और नॉन-रिपीटेबल रीड को रोकता है, लेकिन फैंटम रीड की अनुमति देता है।
- Serializable: सभी असामान्यताओं को रोकता है और पूर्ण सीरियलाइज़ेबिलिटी की गारंटी देता है।
2.2 Berenson और अन्य लोगों का आलोचनात्मक शोध पत्र “A Critique of ANSI SQL Isolation Levels”
पहली नज़र में SQL-92 मानक की परिभाषा बहुत स्पष्ट और तार्किक लगती है। लेकिन 1995 में डेटाबेस की दुनिया के दिग्गजों, जैसे हैल बेरेनसन (Hal Berenson), जिम ग्रे (Jim Gray - ट्यूरिंग पुरस्कार विजेता), और फिल बर्नस्टीन (Phil Bernstein) द्वारा प्रकाशित शोध पत्र “A Critique of ANSI SQL Isolation Levels” ने इस ANSI मानक की परिभाषा पर विनाशकारी प्रहार किया।
इस शोध पत्र में इंगित SQL-92 मानक की मुख्य कमियां इस प्रकार हैं।
1. लॉक-आधारित अंतर्निहित धारणा
SQL-92 की परिभाषा में स्पष्ट रूप से यह माना गया था कि “डेटाबेस को लॉक-आधारित कॉनकरेंसी कंट्रोल (2PL) के साथ कार्यान्वित किया गया है”। हालाँकि, 1990 के दशक तक, ऐसे डेटाबेस पहले ही सामने आने लगे थे जो MVCC (बाद में वर्णित) या अन्य ऑप्टिमिस्टिक कॉनकरेंसी कंट्रोल (OCC) को अपनाते थे, और लॉक-आधारित असामान्यताओं की परिभाषा पुरानी होती जा रही थी।
2. परिभाषा की अस्पष्टता और अपूर्णता
यह बताया गया कि SQL-92 में परिभाषित केवल 3 असामान्यताएं (Dirty Read, Non-repeatable Read, Phantom Read) समानांतर प्रसंस्करण (कॉनकरेंसी) के कारण हो सकने वाली सभी असामान्यताओं को कवर करने के लिए पर्याप्त नहीं थीं। उदाहरण के लिए, एक घटना है जिसे “डर्टी राइट (Dirty Write)” कहा जाता है। यह एक ऐसी घटना है जहाँ एक अनकमिटेड ट्रांजेक्शन द्वारा लिखा गया डेटा एक अन्य अनकमिटेड ट्रांजेक्शन द्वारा अधिलेखित (overwrite) कर दिया जाता है, लेकिन SQL-92 मानक में डर्टी राइट का कोई उल्लेख नहीं है। हालाँकि सभी आइसोलेशन लेवल (Read Uncommitted सहित) को डर्टी राइट्स को रोकना चाहिए (अन्यथा डेटाबेस की आंतरिक कंसिस्टेंसी नष्ट हो जाएगी), मानक ने इस बिंदु को संबोधित नहीं किया।
3. नई असामान्यताओं की खोज
शोध पत्र ने कई नई असामान्यताओं को परिभाषित किया जो SQL-92 मानक में मौजूद नहीं थीं। दो मुख्य उदाहरण निम्नलिखित हैं:
- Lost Update (लॉस्ट अपडेट / अद्यतन का नुकसान): एक ऐसी घटना जिसमें दो ट्रांजेक्शन एक ही समय में एक ही डेटा को पढ़ते हैं, और जब प्रत्येक अपने गणना परिणामों को वापस लिखता है, तो एक का अपडेट दूसरे के अपडेट को अधिलेखित करके मिटा देता है।
- Write Skew (राइट स्क्यू): यह स्नैपशॉट आइसोलेशन (जिसका वर्णन बाद में किया गया है) से जुड़ी एक विशिष्ट घटना है।
बेरेनसन और उनके साथियों के शोध पत्र ने साबित किया कि SQL-92 मानक आइसोलेशन लेवल को गणितीय और कड़ाई से परिभाषित करने में विफल रहा है, जिससे डेटाबेस उद्योग को बड़ा झटका लगा। आधुनिक डेटाबेस सिद्धांत में, ANSI SQL-92 आइसोलेशन लेवल की परिभाषा को “ऐतिहासिक पृष्ठभूमि के रूप में सीखी जाने वाली चीज़” और “कठोर तकनीकी परिभाषा के रूप में अपर्याप्त चीज़” के रूप में माना जाता है।
अध्याय 3: स्नैपशॉट आइसोलेशन (Snapshot Isolation) और राइट स्क्यू (Write Skew)
3.1 Repeatable Read और स्नैपशॉट आइसोलेशन में अंतर
बेरेनसन के शोध पत्र में जिस बात पर विशेष ध्यान दिया गया था, वह एक नए आइसोलेशन लेवल “स्नैपशॉट आइसोलेशन (Snapshot Isolation: SI)” का प्रस्ताव था।
कई डेटाबेस जो MVCC अपनाते हैं (जैसे PostgreSQL और Oracle), उनमें “Repeatable Read” के रूप में दिए जाने वाले आइसोलेशन लेवल की वास्तविकता वास्तव में यही “स्नैपशॉट आइसोलेशन” है। स्नैपशॉट आइसोलेशन में, प्रत्येक ट्रांजेक्शन शुरुआत के समय डेटाबेस के एक सुसंगत “स्नैपशॉट (अतीत की स्थिर स्थिति)” के आधार पर पढ़ता है।
- ट्रांजेक्शन शुरू होने के बाद अन्य ट्रांजेक्शन द्वारा किए गए अपडेट बिल्कुल दिखाई नहीं देते (नॉन-रिपीटेबल रीड की रोकथाम)।
- चूंकि रिकॉर्ड के अस्तित्व को पिछले समय पर ही स्थिर (फिक्स) कर दिया जाता है, इसलिए अन्य ट्रांजेक्शन द्वारा किए गए INSERT भी दिखाई नहीं देते हैं (फैंटम रीड की रोकथाम)।
दूसरे शब्दों में, स्नैपशॉट आइसोलेशन न केवल SQL-92 द्वारा परिभाषित “Repeatable Read” की आवश्यकताओं को पूरा करता है, बल्कि अक्सर “फैंटम रीड” को भी रोकता है। तो क्या स्नैपशॉट आइसोलेशन “Serializable” के बराबर है? इसका उत्तर है “नहीं”। क्योंकि स्नैपशॉट आइसोलेशन में एक घातक असामान्यता होती है जिसे “राइट स्क्यू (Write Skew)” कहा जाता है, जो कि सीरियलाइज़ेबल नहीं है।
3.2 डॉक्टरों की ऑन-कॉल ड्यूटी समस्या और राइट स्क्यू (Write Skew)
राइट स्क्यू को समझने के लिए सबसे प्रसिद्ध उदाहरण “डॉक्टरों का ऑन-कॉल (ड्यूटी) सिस्टम” है।
【बिज़नेस रूल (व्यावसायिक नियम)】 मान लीजिए कि अस्पताल का एक शिफ्ट प्रबंधन सिस्टम है, और नियम यह है कि “कम से कम एक डॉक्टर को हमेशा ऑन-कॉल (स्टैंडबाय) स्थिति में होना चाहिए।”
वर्तमान में, एलिस (Alice) और बॉब (Bob) नामक दो डॉक्टर ऑन-कॉल स्थिति में हैं (on_call = true)।
इस समय, एलिस और बॉब दोनों एक ही समय में संयोग से सोचते हैं कि “मेरी तबीयत ठीक नहीं है, इसलिए मैं ऑन-कॉल से हटना चाहता/चाहती हूँ,” और दोनों ने अपने संबंधित टर्मिनलों से शिफ्ट बदलने का ट्रांजेक्शन शुरू किया।
【ट्रांजेक्शन का प्रवाह (स्नैपशॉट आइसोलेशन के तहत)】
- [Tx1: Alice] स्नैपशॉट प्राप्त करती है। पुष्टि करती है कि वर्तमान में ऑन-कॉल पर दो लोग हैं: एलिस और बॉब।
SELECT count(*) FROM doctors WHERE on_call = true;-> परिणाम: 2 - [Tx2: Bob] स्नैपशॉट प्राप्त करता है। यह भी पुष्टि करता है कि एलिस और बॉब दो लोग हैं।
SELECT count(*) FROM doctors WHERE on_call = true;-> परिणाम: 2 - [Tx1: Alice] यह मानती है कि नियम (1 या अधिक व्यक्ति ऑन-कॉल) पूरा हो रहा है, और खुद को ऑन-कॉल से हटा लेती है।
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] यह भी मानता है कि नियम पूरा हो रहा है, और खुद को ऑन-कॉल से हटा लेता है।
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] कमिट सफल हुआ।
- [Tx2: Bob] कमिट सफल हुआ। (चूंकि एलिस और बॉब अलग-अलग रिकॉर्ड अपडेट कर रहे हैं, इसलिए रो लॉक कॉन्फ़्लिक्ट - पंक्ति लॉक संघर्ष नहीं होगा)
【परिणाम】 Tx1 और Tx2 दोनों के कमिट होने के परिणामस्वरूप, ऑन-कॉल डॉक्टरों की संख्या “0” हो गई। बिज़नेस रूल टूट गया है।
यही राइट स्क्यू (Write Skew) है। यदि यह सीरियलाइज़ेबल (Serializable) होता, तो Tx1 और Tx2 में से कोई एक पहले क्रमिक रूप से निष्पादित होता, इसलिए बाद में निष्पादित ट्रांजेक्शन यह पता लगा लेता कि ऑन-कॉल लोगों की संख्या “1” है, और वह खुद को हटाने के ऑपरेशन को निरस्त (रोलबैक) कर सकता था। हालांकि, स्नैपशॉट आइसोलेशन में, चूंकि वे विभिन्न डेटा पंक्तियों (एलिस की पंक्ति और बॉब की पंक्ति) को अपडेट कर रहे हैं, इसलिए टकराव का पता नहीं चलता है और यह बिज़नेस रूल की असंगति का कारण बनता है।
3.3 ReadOnly Anomaly (रीड ओनली असामान्यता)
इसके अलावा, स्नैपशॉट आइसोलेशन में एक बहुत ही विशिष्ट असामान्यता भी है जिसे ReadOnly Anomaly कहा जाता है, जहाँ “रीड-ओनली ट्रांजेक्शन (केवल-पढ़ने वाले लेनदेन)” के हस्तक्षेप के कारण सीरियलाइज़ेबिलिटी भंग हो जाती है। बैंक खातों में जमा राशि और ब्याज देने के उदाहरण में दिखाई गई यह असामान्यता एक ऐसी घटना है जहाँ अपडेट ट्रांजेक्शन के बीच कोई संघर्ष (कॉन्फ़्लिक्ट) नहीं होने के बावजूद, एक रीड-ओनली ट्रांजेक्शन पिछले स्नैपशॉट को देखकर “तार्किक रूप से असंभव समयरेखा स्थिति” को पढ़ लेता है। इन असामान्यताओं की उपस्थिति के कारण, स्नैपशॉट आइसोलेशन को सख्त अर्थों में Serializable से अलग माना जाता है।
अध्याय 4: MVCC (Multi-Version Concurrency Control) का कार्य सिद्धांत
अब तक हमने आइसोलेशन लेवल के सिद्धांत और असामान्यताओं पर चर्चा की है, लेकिन आधुनिक डेटाबेस इन्हें कैसे नियंत्रित करते हैं? इसकी मुख्य तकनीक MVCC (Multi-Version Concurrency Control: मल्टी-वर्ज़न कॉनकरेंसी कंट्रोल) है।
4.1 “रीड ऑपरेशन राइट को ब्लॉक नहीं करता, और राइट ऑपरेशन रीड को ब्लॉक नहीं करता”
MVCC की सबसे बड़ी डिज़ाइन फिलॉसफी (विचारधारा), जो इसे लॉक-आधारित नियंत्रण (2PL) से अलग बनाती है, वह यह है कि “रीड और राइट (पढ़ना और लिखना) एक-दूसरे को ब्लॉक नहीं करते हैं।” रिकॉर्ड को अपडेट करते समय, MVCC डेटाबेस मौजूदा रिकॉर्ड को सीधे ओवरराइट (इन-प्लेस अपडेट) नहीं करता है। इसके बजाय, यह रिकॉर्ड का एक नया वर्ज़न (टपल) बनाता है और साथ ही पुराने वर्ज़न के रिकॉर्ड को भी बरकरार रखता है।
परिणामस्वरूप, डेटाबेस के भीतर एक ही रिकॉर्ड के कई वर्ज़न (अतीत से लेकर वर्तमान तक का इतिहास) एक साथ मौजूद होते हैं। जब कोई ट्रांजेक्शन डेटा पढ़ता है, तो वह अपने स्वयं के “ट्रांजेक्शन ID (XID)” या “प्रारंभ समय (टाइमस्टैम्प)” के आधार पर सिस्टम में मौजूद कई वर्ज़न में से “पढ़ने योग्य सही पिछले वर्ज़न” की गणना करता है और पढ़ता है।
इससे, भले ही कोई ट्रांजेक्शन किसी रिकॉर्ड को फिर से लिख रहा हो, अन्य ट्रांजेक्शन “फिर से लिखे जाने से पहले का पिछला वर्ज़न” पढ़ सकते हैं, और इस प्रकार लॉक के कारण होने वाले इंतज़ार से बच सकते हैं।
4.2 टपल की वर्ज़न प्रबंधन श्रृंखला और दृश्यता (Visibility) नियम
MVCC में सबसे महत्वपूर्ण एल्गोरिदम विज़िबिलिटी रूल (Visibility Rule - दृश्यता नियम) है जो यह निर्धारित करता है कि “कौन सा ट्रांजेक्शन डेटा का कौन सा वर्ज़न देख सकता है।”
प्रत्येक ट्रांजेक्शन को शुरू होने पर क्रमिक रूप से बढ़ने वाली एक अद्वितीय ट्रांजेक्शन ID (XID) दी जाती है। डेटाबेस में सहेजे गए प्रत्येक रिकॉर्ड वर्ज़न (टपल) में मेटाडेटा के रूप में निम्नलिखित जानकारी जुड़ी होती है:
- निर्माण XID: उस ट्रांजेक्शन की ID जिसने INSERT/UPDATE के माध्यम से यह वर्ज़न बनाया है।
- विलोपन (डिलीट) XID: उस ट्रांजेक्शन की ID जिसने UPDATE/DELETE के माध्यम से इस वर्ज़न को तार्किक रूप से हटा दिया (अमान्य कर दिया) है।
जब कोई ट्रांजेक्शन $T_i$ डेटा पंक्ति पढ़ता है, तो वह निम्नलिखित बुनियादी नियमों के आधार पर दृश्यता निर्धारित करता है:
- क्या कमिट किया गया है: क्या वह ट्रांजेक्शन जिसकी निर्माण XID है, पहले ही कमिट हो चुका है?
- क्या यह भविष्य नहीं है: क्या निर्माण XID वाला ट्रांजेक्शन, $T_i$ के शुरू होने के समय से पहले का ट्रांजेक्शन है?
- क्या इसे हटाया नहीं गया है: क्या विलोपन (डिलीट) XID सेट नहीं है, या विलोपन XID वाला ट्रांजेक्शन अभी तक कमिट नहीं हुआ है, या क्या यह $T_i$ के शुरू होने के समय के बाद (भविष्य) का ट्रांजेक्शन है?
इन शर्तों का कड़ाई से मूल्यांकन करके, प्रत्येक ट्रांजेक्शन को एक सुसंगत स्नैपशॉट प्रदान किया जाता है।
अध्याय 5: PostgreSQL बनाम MySQL (InnoDB) के MVCC कार्यान्वयन में निर्णायक अंतर
हालाँकि MVCC की मूल अवधारणा समान है, लेकिन इसका आंतरिक कार्यान्वयन डेटाबेस उत्पादों के बीच आश्चर्यजनक रूप से भिन्न होता है। यहाँ, हम ओपन-सोर्स दुनिया के दो मुख्य दिग्गजों, PostgreSQL और MySQL (InnoDB) के MVCC आर्किटेक्चर की तुलना और विश्लेषण करेंगे।
5.1 PostgreSQL का MVCC कार्यान्वयन: हीप के भीतर अपेंड (Append) और VACUUM की आवश्यकता
PostgreSQL का MVCC एक बहुत ही अनूठा और सहज “अपेंड-ओनली (Append-only - केवल-जोड़ने वाला) आर्किटेक्चर” अपनाता है।
5.1.1 xmin और xmax के माध्यम से बिट निर्णय लॉजिक
PostgreSQL तालिकाओं की वास्तविक इकाई यानी डेटा फ़ाइल (हीप) के भीतर, प्रत्येक पंक्ति (टपल) के हेडर में दो ट्रांजेक्शन ID, xmin और xmax दर्ज किए जाते हैं।
xmin(Transaction ID of Insert): उस ट्रांजेक्शन की XID जिसने यह टपल बनाया।xmax(Transaction ID of Delete): उस ट्रांजेक्शन की XID जिसने इस टपल को हटा दिया (या अपडेट के कारण पुराने वर्ज़न को तार्किक रूप से हटा दिया)।
【UPDATE ऑपरेशन का व्यवहार】
PostgreSQL में, UPDATE को तार्किक रूप से DELETE और INSERT के संयोजन के रूप में संसाधित किया जाता है।
- वर्तमान ट्रांजेक्शन XID को पुराने टपल के
xmaxमें लिखा जाता है। (तार्किक विलोपन/लॉजिकल डिलीशन) - हीप के खाली स्थान (फ्री स्पेस) में एक बिल्कुल नया टपल बनाया जाता है, नया डेटा लिखा जाता है, और
xminको वर्तमान ट्रांजेक्शन XID पर सेट किया जाता है। (नया जोड़ना)
दूसरे शब्दों में, नए और पुराने दोनों टपल एक ही टेबल डेटा फ़ाइल (हीप) में एक साथ सहेजे जाते हैं।
5.1.2 विशाल लाभ और एक गंभीर चुनौती: VACUUM का अस्तित्व
इस आर्किटेक्चर का सबसे बड़ा लाभ यह है कि रोलबैक अत्यधिक तेज़ है। यदि कोई ट्रांजेक्शन निरस्त (अबॉर्ट) हो जाता है, तो जोड़े गए टपल को केवल “अनकमिटेड” के रूप में माना जाता है, और डेटा को वापस लिखने की कोई आवश्यकता नहीं होती है।
हालाँकि, एक गंभीर चुनौती के रूप में “मृत टपल्स (Dead Tuples) का फूलना (Bloating)” है।
जैसे-जैसे UPDATE और DELETE को दोहराया जाता है, पुराने वर्ज़न के टपल जिन्हें अब किसी के द्वारा संदर्भित नहीं किया जाता है (वे टपल जिनका xmax पुराने, कमिट किए गए ट्रांजेक्शन ID में बदल गया है) हीप में अनिश्चित काल तक जमा होते रहते हैं। यदि इसे ऐसे ही छोड़ दिया जाए, तो टेबल का भौतिक आकार बहुत तेज़ी से बढ़ जाएगा, और अनुक्रमिक स्कैन (sequential scan) का प्रदर्शन विनाशकारी रूप से गिर जाएगा।
इन अवांछित मृत टपल्स को भौतिक रूप से हटाने और खाली स्थान को पुनः प्रयोज्य बनाने की सिस्टम प्रक्रिया को VACUUM (और स्वचालित रूप से चलने वाला autovacuum डेमन) कहा जाता है। PostgreSQL के संचालन में VACUUM की ट्यूनिंग को इतना महत्वपूर्ण मानने का कारण इस MVCC आर्किटेक्चर की जड़ है।
5.2 MySQL InnoDB का MVCC कार्यान्वयन: इन-प्लेस अपडेट और Undo लॉग का डायनामिक पुनर्निर्माण
दूसरी ओर, MySQL का डिफ़ॉल्ट स्टोरेज इंजन, InnoDB, Oracle Database के समान “इन-प्लेस अपडेट (In-place update) और Undo लॉग (रोलबैक सेगमेंट)” वाला आर्किटेक्चर अपनाता है।
5.2.1 क्लस्टर्ड इंडेक्स और इन-प्लेस अपडेट
InnoDB की तालिकाएँ B+Tree (क्लस्टर्ड इंडेक्स) के रूप में कॉन्फ़िगर की गई हैं जो प्राइमरी की (Primary Key) पर आधारित होती हैं।
जब InnoDB में UPDATE निष्पादित किया जाता है, तो यह PostgreSQL की तरह एक नई पंक्ति को जोड़ने के बजाय, सीधे B+Tree पर डेटा पंक्ति को ओवरराइट (इन-प्लेस अपडेट) कर देता है।
तो फिर, अगर अन्य ट्रांजेक्शन अतीत का स्नैपशॉट पढ़ना चाहें तो क्या होगा? इसके लिए, InnoDB ओवरराइट करने से पहले “पुराने डेटा” को एक समर्पित क्षेत्र, Undo लॉग (Undo Log Segment) में बचाकर (सेव करके) रखता है।
5.2.2 रोल पॉइंटर (Roll Pointer) के माध्यम से अतीत का डायनामिक पुनर्निर्माण
InnoDB में प्रत्येक डेटा पंक्ति के छिपे हुए कॉलम (Hidden Column) में निम्नलिखित दो शामिल हैं:
DB_TRX_ID: उस ट्रांजेक्शन की ID जिसने इस पंक्ति को अंतिम बार डाला या अपडेट किया था।DB_ROLL_PTR(Roll Pointer): एक पॉइंटर जो Undo लॉग में उस स्थान को इंगित करता है जहाँ इस पंक्ति का “एक पिछला पुराना वर्ज़न” सहेजा गया है।
एक ट्रांजेक्शन द्वारा पिछले स्नैपशॉट को पढ़ने की प्रक्रिया इस प्रकार है:
- B+Tree से नवीनतम डेटा पंक्ति पढ़ें।
DB_TRX_IDकी जाँच करें, यदि यह आपके अपने स्नैपशॉट से भविष्य के ट्रांजेक्शन द्वारा किया गया अपडेट है, तो निर्धारित करें कि इस नवीनतम पंक्ति को नहीं पढ़ा जाना चाहिए।DB_ROLL_PTRका पालन करें और Undo लॉग से पिछले वर्ज़न का डेटा प्राप्त करें।- Undo लॉग में मौजूद डेटा का उपयोग करके, मेमोरी में पिछले रिकॉर्ड की स्थिति को गतिशील रूप से पुनर्निर्माण (मेमोरी में रोलबैक/Rollback in memory) करें।
- यदि यह अभी भी भविष्य का अपडेट है, तो Undo लॉग श्रृंखला (चेन) में और पीछे अतीत की ओर जाएं।
5.2.3 InnoDB के लाभ और चुनौतियाँ
इस आर्किटेक्चर का लाभ यह है कि मुख्य टेबल क्षेत्र (टेबलस्पेस) के आसानी से फूलने/बड़ा होने (bloat) की संभावना कम होती है। नवीनतम डेटा हमेशा B+Tree में उचित स्थान पर रहता है, और पिछले वर्ज़न को एक अलग क्षेत्र (Undo लॉग) में अलग कर दिया जाता है, जिससे भौतिक स्कैनिंग (physical scanning) की दक्षता उच्च बनी रहती है (PostgreSQL जैसे बड़े पैमाने पर VACUUM की आवश्यकता नहीं होती है, और Undo लॉग को साफ़ करने की पर्ज (purge) प्रक्रिया बैकग्राउंड में हल्के से चलती है)।
दूसरी ओर, नुकसान यह है कि यदि ऐसे लंबे समय तक चलने वाले ट्रांजेक्शन (जैसे बैच प्रोसेसिंग या mysqldump) मौजूद हैं जो अतीत के बड़ी मात्रा में स्नैपशॉट पढ़ते हैं, तो डेटा को फिर से बनाने के लिए Undo लॉग में गहराई तक वापस जाने का ओवरहेड होता है, और पढ़ने का प्रदर्शन कम हो जाता है। इसके अलावा, स्वयं Undo लॉग के बड़ा होने और डिस्क स्थान (डिस्क स्पेस) को घेरने का जोखिम भी होता है।
अध्याय 6: सीरियलाइज़ेबल स्नैपशॉट आइसोलेशन (SSI) और डिस्ट्रीब्यूटेड डेटाबेस में सबसे आगे
MVCC का विकास यहीं समाप्त नहीं होता है। जैसा कि अध्याय 3 में बताया गया है, स्नैपशॉट आइसोलेशन (SI) में “राइट स्क्यू” जैसी असामान्यताएं मौजूद थीं, और यह पूरी तरह से Serializable नहीं था। हालाँकि, ताकि एप्लिकेशन डेवलपर्स को कॉनकरेंसी (समानांतर प्रसंस्करण) की जटिलता के बारे में चिंता न करनी पड़े, MVCC के उच्च प्रदर्शन को बनाए रखते हुए पूर्ण सीरियलाइज़ेबल को प्राप्त करना आवश्यक है।
6.1 सीरियलाइज़ेबल स्नैपशॉट आइसोलेशन (SSI) का जन्म
2008 में, माइकल काहिल (Michael Cahill) और अन्य के एक शोध पत्र ने “सीरियलाइज़ेबल स्नैपशॉट आइसोलेशन (Serializable Snapshot Isolation - SSI)” नामक एक अभूतपूर्व एल्गोरिदम प्रस्तुत किया। यह एक ऐसी तकनीक है जो MVCC आर्किटेक्चर पर आधारित होने के साथ-साथ पूर्ण सीरियलाइज़ेबिलिटी (Serializable) की गारंटी देती है। PostgreSQL ने वर्ज़न 9.1 से तुरंत इस SSI को “Serializable” आइसोलेशन लेवल के कार्यान्वयन के रूप में अपना लिया।
SSI का कार्य सिद्धांत: कॉन्फ़्लिक्ट ग्राफ़ (संघर्ष आलेख) और खतरनाक संरचना (rw-antidependency)
SSI लॉक के माध्यम से ब्लॉक नहीं करता है। इसके बजाय, यह ट्रांजेक्शन निष्पादन के दौरान बारीक नज़र (ट्रैकिंग) रखता है कि “कौन सा डेटा पढ़ा गया (Read), और कौन सा डेटा लिखा गया (Write)।”
SSI ट्रांजेक्शन के बीच टकराव के संबंधों की निगरानी करता है और “rw-antidependency (रीड-राइट एंटी-डिपेंडेंसी / पढ़ने-लिखने की प्रति-निर्भरता)” नामक एक विशिष्ट कॉन्फ़्लिक्ट पैटर्न की खोज करता है। विशेष रूप से, यह एक ऐसा संबंध है जहाँ ट्रांजेक्शन $T_1$ अतीत के वर्ज़न का डेटा पढ़ता है, और बाद में एक अन्य ट्रांजेक्शन $T_2$ उस डेटा को अधिलेखित (ओवरराइट) करके कमिट कर देता है। SSI आंतरिक रूप से ट्रांजेक्शन का एक कॉन्फ़्लिक्ट ग्राफ़ (संघर्ष आलेख) बनाता है, और जिस क्षण यह “लगातार दो rw-antidependency तीरों वाली संरचना (खतरनाक संरचना)” का पता लगाता है, यह तय करता है कि सीरियलाइज़ेबिलिटी टूटने की संभावना है, और एक ट्रांजेक्शन को जबरन निरस्त (रोलबैक) कर देता है।
इससे राइट स्क्यू (उदाहरण: डॉक्टरों की ऑन-कॉल समस्या) जैसी असामान्यताओं के होने से पहले ही ट्रांजेक्शन रोक दिए जाते हैं, और इसके परिणामस्वरूप यह पूर्ण सीरियलाइज़ेबल (Serializable) की गारंटी देता है। इसे ऑप्टिमिस्टिक कॉनकरेंसी कंट्रोल (OCC) का अंतिम रूप (ultimate form) कहा जा सकता है।
6.2 डिस्ट्रीब्यूटेड डेटाबेस में MVCC: Spanner, CockroachDB, TiDB
आधुनिक डेटाबेस तकनीक सिंगल सर्वर (एकल सर्वर) की सीमाओं को पार कर गई है और दुनिया भर के डेटा केंद्रों में डिस्ट्रीब्यूटेड (वितरित) SQL डेटाबेस (NewSQL) में विकसित हो गई है। डिस्ट्रीब्यूटेड वातावरण (Distributed Environment) में वैश्विक कंसिस्टेंसी (Global Consistency) के साथ MVCC प्राप्त करना भौतिकी के नियमों के लिए एक चुनौती थी।
Google Spanner और TrueTime API
Google के Spanner ने डिस्ट्रीब्यूटेड सिस्टम में ट्रांजेक्शन ऑर्डरिंग (क्रमबद्ध करने की) समस्या को हल करने के लिए TrueTime API विकसित किया। इस आधार पर कि प्रत्येक सर्वर की घड़ियाँ (भौतिक घड़ियाँ) निश्चित रूप से विचलित (क्लॉक स्क्यू) होंगी, यह GPS और परमाणु घड़ियों (atomic clocks) को जोड़ता है और वर्तमान समय को “अनिश्चितता की सीमा (टाइम विंडो)” के रूप में प्रदान करता है। Spanner का MVCC, ट्रांजेक्शन को कमिट करते समय इस TrueTime अनिश्चितता विंडो के गुज़रने की प्रतीक्षा करता है (Commit Wait), जिससे भौतिक रूप से यह गारंटी मिलती है कि “कारण-प्रभाव संबंध (causal relationship) वाले ट्रांजेक्शन का टाइमस्टैम्प क्रम हमेशा सही होगा (एक्सटर्नल कंसिस्टेंसी / बाहरी संगतता)।”
CockroachDB और HLC (Hybrid Logical Clock)
Spanner से प्रेरित एक ओपन-सोर्स डिस्ट्रीब्यूटेड डेटाबेस CockroachDB, महंगी परमाणु घड़ियों का उपयोग किए बिना इसके करीब कंसिस्टेंसी प्राप्त करने के लिए HLC (हाइब्रिड लॉजिकल क्लॉक) अपनाता है। NTP के माध्यम से भौतिक घड़ियों के सिंक्रोनाइज़ेशन (तुल्यकालन) और Lamport लॉजिकल क्लॉक (घटनाओं के बीच कारण-प्रभाव संबंधों पर आधारित एक काउंटर) को मिलाकर, यह डिस्ट्रीब्यूटेड नोड्स के बीच वैश्विक रूप से सुसंगत MVCC स्नैपशॉट टाइमस्टैम्प उत्पन्न करता है, और डिस्ट्रीब्यूटेड वातावरण में SSI (Serializable Snapshot Isolation) प्राप्त करता है।
TiDB और Percolator मॉडल
PingCAP द्वारा विकसित TiDB, Google Percolator के मॉडल पर आधारित एक डिस्ट्रीब्यूटेड ट्रांजेक्शन मॉडल अपनाता है। इसमें एक एकल घटक (प्लेसमेंट ड्राइवर: PD) है जो वैश्विक टाइमस्टैम्प जारी करता है, और एक आर्किटेक्चर है जहाँ प्रत्येक नोड का स्टोरेज इंजन (TiKV) स्थानीय स्तर पर MVCC को संसाधित करने के लिए उस टाइमस्टैम्प का उपयोग करता है। 2PC (Two-Phase Commit) पर आधारित होने के बावजूद, यह लॉक रखने की अवधि को कम करता है, और डिस्ट्रीब्यूटेड वातावरण में विशाल ट्रांजेक्शन और MVCC दोनों को एक साथ संतुलित करता है।
निष्कर्ष: ACID के उस पार
डेटाबेस ट्रांजेक्शन आइसोलेशन लेवल कोई ऐसी चीज़ नहीं है जिसे बस रट लिया जाए। यह कंप्यूटर विज्ञान के संघर्षों के दशकों लंबे इतिहास का प्रतिनिधित्व करता है, इस बारे में कि कैसे डेटा कंसिस्टेंसी और सिस्टम परफॉरमेंस की परस्पर विरोधी मांगों को संतुलित किया जाए।
ANSI SQL-92 की अपूर्ण परिभाषा से शुरू होकर, MVCC के कारण कॉनकरेंसी प्रोसेसिंग में नाटकीय सुधार, PostgreSQL और InnoDB के आर्किटेक्चर का विभाजन, और SSI और डिस्ट्रीब्यूटेड डेटाबेस द्वारा अंतिम कंसिस्टेंसी (संगतता) प्राप्त करने की चुनौती। इन आंतरिक संरचनाओं को गहराई से समझना, अधिक मजबूत और उच्च-प्रदर्शन वाले एप्लिकेशन को डिज़ाइन करने के लिए एक शक्तिशाली हथियार साबित होगा।
हम अब ऐसे युग में जी रहे हैं जहाँ ACID गुण केवल एक “मिथक” नहीं रह गए हैं, बल्कि उन्नत एल्गोरिदम और भौतिक घड़ियों के सिंक्रोनाइज़ेशन के माध्यम से उन्हें “वास्तविकता” के रूप में लागू किया गया है। डेटा के समुद्र में नेविगेट करने वाले इंजीनियरों के लिए, डेटाबेस इंजन की गहराइयों को जानना एक कभी न खत्म होने वाली बौद्धिक खोज की यात्रा है।