Nous expliquons en détail la procédure de développement et l'architecture interne pour l'inférence de petits modèles d'IA tels que TinyLLaMA dans un environnement local à l'aide de C++ et ggml. Couvre le mappage mémoire, les opérations tensorielles et l'optimisation SIMD.
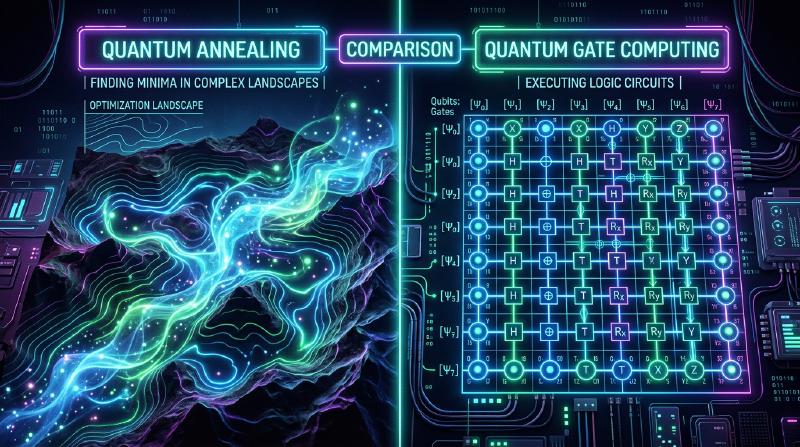
Une comparaison et explication approfondies de deux architectures d’ordinateurs quantiques : le recuit quantique et le modèle à portes. Nous aborderons les principes physiques et mathématiques tels que le modèle d’Ising, la formulation QUBO, les transformations unitaires et la correction d’erreurs, jusqu’aux cas d’utilisation spécifiques.
Un guide complet couvrant les bases de llama.cpp, la personnalisation avancée en C++, le contexte mathématique des Transformers et l'architecture ggml.
Découvrez comment les ordinateurs quantiques pourraient briser les technologies de chiffrement actuelles, à travers une explication détaillée allant du contexte mathématique de l'algorithme de Shor à son implémentation en Python.
Nous expliquons en détail la menace de la compromission cryptographique due à l'avènement des ordinateurs quantiques, et les algorithmes de la cryptographie post-quantique (PQC) du standard NIST tels que Kyber, Dilithium, FALCON, SPHINCS+ pour y faire face, allant des bases mathématiques de la cryptographie sur les réseaux (problème LWE) aux mécanismes détaillés et à la comparaison de leurs performances.
Un guide complet pour intégrer une IA de reconnaissance vocale de haute précision dans les appareils périphériques et les applications natives en utilisant C++ et whisper.cpp. Il couvre tout, des bases du traitement des signaux audio à l'optimisation de l'inférence en temps réel.
Des LLM locaux gratuits à utiliser tout en protégeant votre vie privée. Cet article compare et explique en détail avec une perspective technique les meilleurs LLM open source tels que Llama 3, Mistral, Gemma 2, Qwen 2.5 et Phi-3.
Le manque de VRAM (mémoire GPU) est le plus grand obstacle à l'apprentissage et à l'inférence des LLM. Cet article explique en détail les techniques pour le résoudre, telles que le déchargement CPU, la quantification du cache KV et les points de contrôle de gradient, à l'aide de formules mathématiques et de diagrammes d'architecture.
Une explication très détaillée, accompagnée de formules mathématiques et de diagrammes structurels, de la structure interne du format GGUF et de la technologie de quantification k-quants adoptés dans llama.cpp.
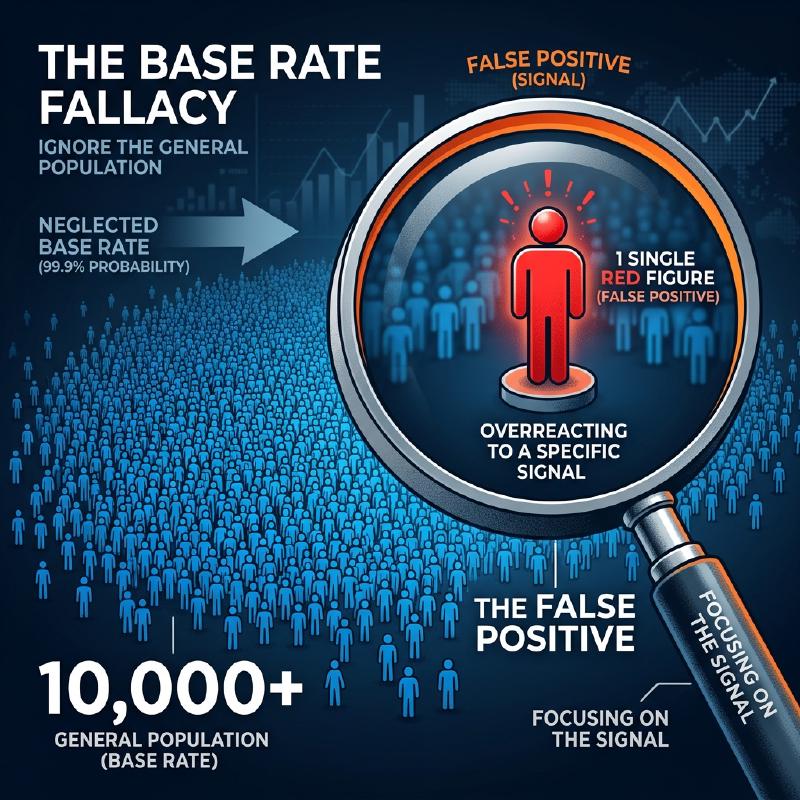
Même si un test précis à 99 % est positif, la probabilité d'être réellement malade n'est que de 9 % ? Explication de l'« erreur du taux de base », où l'intuition humaine est trompée par les données statistiques.