Anatomie complète de la mémoire virtuelle et de la pagination : de la MMU au TLB, HugePage et les abysses de la gestion de la mémoire
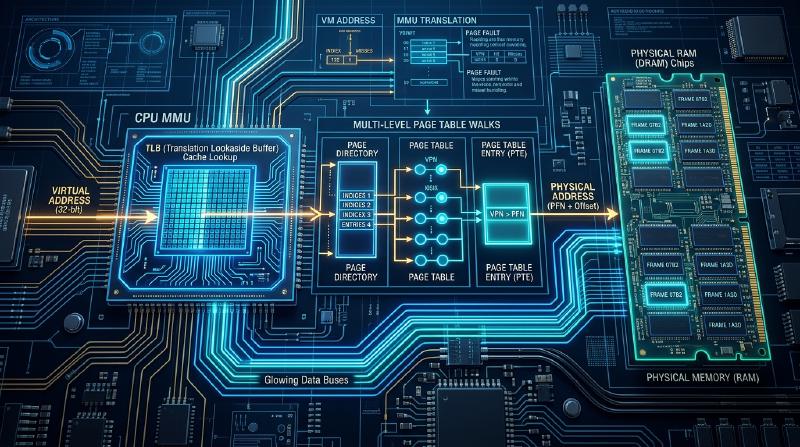
Dans les systèmes d’exploitation (OS) et les architectures de CPU modernes, l’un des mécanismes les plus complexes et pourtant les plus essentiels est la « mémoire virtuelle (Virtual Memory) » et la « pagination (Paging) ». Derrière l’espace mémoire dont les développeurs d’applications n’ont généralement pas conscience, la MMU (Memory Management Unit) matérielle et le noyau de l’OS collaborent étroitement pour effectuer des conversions d’adresses massives et gérer les exceptions dans un monde de nanosecondes.
Dans cet article, nous disséquerons les profondeurs du système de mémoire virtuelle du point de vue de la structure interne des systèmes d’exploitation et de l’architecture des ordinateurs. Depuis la disposition complète des bits de la structure de la table de pages de l’architecture x86-64, le protocole IPI de démontage du TLB (TLB shootdown), la trace complète des défauts de page dans le noyau Linux, le mécanisme physique du Copy-on-Write (CoW), les algorithmes de récupération de mémoire (Reclaim), jusqu’à la formule de calcul du score du OOM Killer, nous expliquerons en détail les mécanismes de bas niveau au niveau du code source et des registres.
Chapitre 1 : La raison d’être de la mémoire virtuelle et son contexte historique
Pourquoi les ordinateurs ont-ils besoin de mémoire virtuelle ? Dans les premiers systèmes informatiques, les programmes accédaient directement à des adresses spécifiques de la mémoire physique (RAM). Cependant, avec la popularisation des environnements multitâches, cette méthode de « spécification directe des adresses physiques » a atteint ses limites.
1.1 Protection de la mémoire et séparation complète de l’espace des processus
L’objectif principal de la mémoire virtuelle est de « garantir la sécurité et la stabilité ». Si le processus A écrase accidentellement (ou par malveillance) la mémoire du processus B, l’ensemble du système peut planter ou des informations confidentielles peuvent fuir. La mémoire virtuelle donne à chaque processus l’illusion qu’il « possède son propre espace mémoire continu et dédié ». Ainsi, la mémoire entre les processus est strictement isolée au niveau matériel (MMU), et tout accès illégal à la mémoire est immédiatement intercepté et traité comme un défaut de segmentation (segmentation fault). La séparation entre l’espace utilisateur et l’espace noyau est également réalisée par ce mécanisme, les transitions d’anneaux de privilèges (privilege rings) et les vérifications des droits d’accès à la mémoire étant effectuées par le matériel à chaque cycle.
1.2 Briser le mur de la capacité de la mémoire physique et le concept de pagination à la demande
Il n’est pas rare que la quantité de mémoire requise par une application dépasse la capacité de la RAM physique installée. La mémoire virtuelle fournit un espace d’adressage beaucoup plus grand que la mémoire physique en sauvegardant (swapping out) les zones de mémoire (pages) qui ne sont pas actuellement utilisées vers un périphérique de stockage secondaire (HDD/SSD) et en les rechargeant (swapping in) lorsqu’elles sont nécessaires. De plus, plutôt que de charger tout le code et les données en mémoire au début de l’exécution d’un programme, le concept de « pagination à la demande (demand paging) », qui ne charge les données en mémoire qu’au moment où l’accès se produit, permet d’économiser de la mémoire tout en accélérant le démarrage.
1.3 Le changement de paradigme de la segmentation à la pagination
Sur les premiers x86 (comme le 80286), la « segmentation » était utilisée pour gérer la mémoire sous forme de blocs de longueur variable. Cette méthode utilisait des registres tels que CS (Code Segment) et DS (Data Segment) pour calculer l’adresse logique en tant qu’adresse de base + décalage (offset). Cependant, la segmentation provoquait facilement une « fragmentation externe » et sa gestion était extrêmement complexe. Plus tard, avec l’arrivée du 80386, la « pagination », qui gère la mémoire en blocs de longueur fixe (généralement 4 Ko), a été introduite et est devenue la norme. Les OS 64 bits modernes (Linux et Windows) ont de facto invalidé la segmentation en tant que modèle de mémoire plat (flat memory model : adresse de base 0, limite maximale) et gèrent la mémoire uniquement via la pagination. La segmentation n’est actuellement utilisée que pour un très petit nombre d’applications, comme le référencement du Thread Local Storage (TLS) (registres FS/GS).
Chapitre 2 : Anatomie complète de la structure à plusieurs niveaux et de la disposition des bits des tables de pages sur x86-64
Dans l’architecture 64 bits (x86-64/AMD64), l’espace d’adressage virtuel est vaste. Dans « l’espace d’adressage virtuel 48 bits » actuellement dominant, la MMU matérielle parcourt 4 niveaux de tables de pages.
2.1 Espace d’adressage virtuel 48 bits/57 bits et la contrainte de la forme canonique (Canonical Form)
Bien que les registres 64 bits puissent représenter un vaste espace d’adressage de 16 exaoctets, les implémentations matérielles actuelles ne l’utilisent pas entièrement pour des raisons de coût et de complexité. Dans l’implémentation 48 bits, il existe une contrainte selon laquelle les bits 47 à 63 de l’adresse virtuelle doivent tous avoir la même valeur (extension de signe). Les adresses satisfaisant à cette contrainte sont appelées « adresses canoniques (Canonical Addresses) ».
En conséquence, l’espace mémoire a une structure avec un énorme trou inutilisé (Non-canonical hole) au centre, se divisant proprement en deux : l’espace utilisateur dans la moitié inférieure (0x0000000000000000 à 0x00007FFFFFFFFFFF) et l’espace noyau dans la moitié supérieure (0xFFFF800000000000 à 0xFFFFFFFFFFFFFFFF). Si vous déférencez un pointeur non valide (par exemple, un pointeur avec des métadonnées intégrées dans les bits de poids fort), la MMU génère immédiatement une exception de protection générale (#GP) en tant que violation canonique. Récemment, à partir des processeurs Intel Ice Lake, l’espace virtuel 57 bits (table de pages à 5 niveaux), qui étend cela davantage, a commencé à être pris en charge, servant de base à l’infrastructure cloud manipulant des pétaoctets de mémoire.
2.2 Détails de la structure hiérarchique de la table de pages à 4 niveaux (PML4, PDPT, PD, PT)
Pour traduire une adresse virtuelle 48 bits en une adresse physique, le x86-64 utilise une table de pages à 4 niveaux (une structure de données en forme d’arbre Radix). Chaque table a une taille de 4 Ko et stocke 512 entrées de 64 bits (8 octets) (2^9 = 512). L’adresse virtuelle est divisée comme suit et sert d’index pour chaque niveau :
- Bits 39-47 (9 bits) : Index PML4 (Page Map Level 4) - Le plus haut niveau. Le registre CR3 pointe vers son adresse de base physique.
- Bits 30-38 (9 bits) : Index PDPT (Page Directory Pointer Table)
- Bits 21-29 (9 bits) : Index PD (Page Directory) - C’est la fin dans le cas d’une HugePage de 2 Mo.
- Bits 12-20 (9 bits) : Index PT (Page Table) - La table finale pour les pages normales de 4 Ko.
- Bits 0-11 (12 bits) : Page Offset - Le décalage au sein d’une page de 4 Ko (4096 octets).
2.3 Tableau complet de la disposition 64 bits de l’entrée de table de pages (PTE)
Chaque entrée 64 bits de la table de pages n’est pas seulement un pointeur d’adresse physique, mais un ensemble de métadonnées qui régit le contrôle d’accès et le contrôle de cache puissants. Voici la disposition complète des bits d’une PTE x86-64 et leurs fonctions détaillées.
- Bit 0 [P] Present : 1 s’il est présent dans la mémoire physique. 0 s’il a été swappé ou non alloué. L’accès lorsqu’il est à 0 déclenche une exception de défaut de page (#PF).
- Bit 1 [R/W] Read/Write : 0 pour Read-Only (non inscriptible), 1 pour Read/Write possible. Joue un rôle crucial dans l’implémentation du CoW (Copy-on-Write).
- Bit 2 [U/S] User/Supervisor : 0 si accessible uniquement en mode privilégié (noyau). 1 si accessible également depuis le mode utilisateur (Ring 3). Strictement géré par KPTI, SMAP, etc.
- Bit 3 [PWT] Page-level Write-Through : 1 pour définir la politique d’écriture du cache pour cette page sur Write-Through. 0 pour Write-Back.
- Bit 4 [PCD] Page-level Cache Disable : 1 pour désactiver le cache de cette page (Uncacheable). Utilisé pour accéder directement aux registres des périphériques PCIe via les E/S mappées en mémoire (MMIO), etc.
- Bit 5 [A] Accessed : Automatiquement mis à 1 par le matériel lorsque la MMU accède (Read ou Write) à cette page. Utilisé comme bit de référence par l’algorithme LRU (récupération de pages) de l’OS.
- Bit 6 [D] Dirty : Automatiquement mis à 1 par le matériel lorsque la MMU effectue une « écriture » sur cette page. Un bit essentiel pour que l’OS détermine si une réécriture sur le disque (swap out) est nécessaire.
- Bit 7 [PAT] Page Attribute Table : Combiné avec PWT/PCD, un index pour spécifier des types de cache mémoire plus détaillés (WC : Write-Combining, etc.). Utilisé pour les transferts en bloc à grande vitesse vers la mémoire graphique (VRAM), etc.
- Bit 8 [G] Global : Si 1, n’efface pas cette entrée du TLB même si le registre CR3 change (même si un changement de contexte se produit). Principalement utilisé pour les pages de l’espace noyau pour éviter la pénalité des échecs de TLB lors des appels système.
- Bits 9-11 [AVL] Available : 3 bits librement utilisables par l’OS (noyau). Sous Linux, ils sont parfois utilisés pour les métadonnées des entrées de swap ou l’identification des nœuds NUMA.
- Bits 12-51 [PFN] Physical Frame Number : L’adresse de base (numéro de trame physique) de la page physique de destination. Les 12 bits inférieurs sont toujours traités comme 0 car ils sont alignés sur 4 Ko.
- Bits 52-62 [AVL/PKU] Available/Ignored : Réservé en fonction de la génération du CPU et des extensions de fonctionnalités (Intel MPK : Memory Protection Keys, etc.), ou zone utilisable par l’OS.
- Bit 63 [XD/NX] Execute-Disable / No-eXecute : Si 1, rend les données sur cette page « non exécutables en tant qu’instructions ». Un mécanisme de sécurité puissant (DEP : Data Execution Prevention) pour empêcher les attaques d’injection de code dans les zones de données en raison de dépassements de tampon, etc.
Ainsi, chaque bit de la PTE est étroitement lié aux algorithmes de gestion de la mémoire de l’OS (en particulier le traitement du swap, la protection de la sécurité et le contrôle des E/S), ce qui en fait une interface extrêmement sophistiquée à la frontière entre le matériel et le logiciel.
Chapitre 3 : Parcours de la table de pages matérielle par la MMU et le mur de la latence
La conversion de l’adresse virtuelle en adresse physique est effectuée par un circuit matériel dédié appelé MMU (Memory Management Unit), situé à l’intérieur du cœur du CPU.
3.1 Le mécanisme de parcours de table (table walk) à partir du registre CR3
Le registre de contrôle CR3 du processeur contient l’adresse physique de la table de pages de niveau supérieur (PML4) du processus en cours d’exécution. Les systèmes d’exploitation comme Linux, lors d’un changement de contexte pour céder les droits d’exécution du CPU à un autre processus, réécrivent ce registre CR3 avec l’adresse PML4 du nouveau processus. Cela permet de basculer instantanément l’ensemble de l’espace mémoire du processus.
Voici le flux conceptuel :
- Extraire l’index de poids fort de l’adresse virtuelle et lire l’entrée correspondante de la table PML4 pointée par CR3.
- Extraire le PFN de l’entrée PML4 et calculer l’adresse physique de la table PDPT suivante.
- Lire l’entrée correspondante de la table PDPT.
- Parcourir de même la table PD et la table PT pour obtenir l’adresse de base de la page physique finale de 4 Ko.
- Enfin, ajouter le décalage de page de 12 bits pour construire l’adresse physique complète.
3.2 L’accès au bus mémoire et la latence : le plus grand mur
La plus grande faiblesse de ce parcours de table de pages à 4 niveaux est la « latence d’accès à la mémoire ». Pour convertir une seule adresse virtuelle, dans le pire des cas, 4 accès à la mémoire physique (lecture de PML4, PDPT, PD, PT) se produisent. La latence d’accès de la DRAM moderne est d’environ 50 à 100 nanosecondes. Si les 4 accès à la mémoire manquent tous le cache du CPU (L1/L2/L3) et atteignent la DRAM, cela entraîne un blocage (stall) de plusieurs centaines de nanosecondes à lui seul. Considérant que le cycle d’horloge du CPU est d’environ 0,3 nanoseconde (3 GHz), cela représente un retard fatal équivalent à des milliers de cycles, et le pipeline du CPU se tarira et s’arrêtera complètement. C’est pour franchir ce mur de performances extrêmement critique qu’a été conçu le TLB, expliqué ensuite.
Chapitre 4 : Architecture TLB dans les environnements multicœurs et les tourments du TLB Shootdown
Le TLB (Translation Lookaside Buffer) est un « cache des résultats de conversion des adresses virtuelles en adresses physiques » intégré dans la MMU, et se compose de SRAM (ou CAM : Content Addressable Memory) ultra-rapide.
4.1 Structure hiérarchique du TLB et optimisation via le PCID (Process-Context Identifier)
Dans les CPU les plus récents, le TLB a également une structure hiérarchique L1/L2. Les L1 D-TLB (pour les données) et L1 I-TLB (pour les instructions) ont une très petite capacité (des dizaines d’entrées) mais répondent en 1 cycle. Le L2 TLB a des centaines à des milliers d’entrées et répond en quelques cycles. Si l’entrée n’existe pas dans le TLB (TLB miss), le parcours de table matériel (page walk) mentionné ci-dessus se produit. Pour faciliter cela, un cache dédié au parcours de page (PWC : Page Walk Cache) est également implémenté.
Puisque la signification des adresses virtuelles change lorsqu’un processus bascule, traditionnellement (aux débuts du x86), le TLB était entièrement effacé (Flush) lors de la réécriture de CR3. Cependant, cela entraînait de fréquents échecs de TLB immédiatement après un changement de contexte, ce qui réduisait considérablement les performances. La technologie introduite pour résoudre ce problème est le PCID (Process-Context Identifier) (appelé ASID dans l’architecture ARM). En attachant un identifiant (balise) de 12 bits identifiant de manière unique un processus aux entrées du TLB, il est devenu possible de conserver les entrées TLB du processus précédent même après un changement de contexte, améliorant considérablement les performances dans les environnements multiprocessus tels que les serveurs Web et les bases de données.
4.2 Le protocole d’interruption interprocesseur (IPI) du TLB Shootdown (Démontage du TLB)
Dans un environnement multicœur, le système de mémoire virtuelle fait face à un problème de synchronisation très complexe. Par exemple, supposons qu’un processus s’exécutant sur le cœur 0 (CPU0) libère une zone mémoire spécifique avec munmap() et invalide la PTE de la table de pages (Present = 0). Cependant, dans le TLB local du cœur 1 (CPU1), les « anciennes informations de conversion (Stale TLB Entry) » de cette adresse virtuelle vers l’adresse physique peuvent encore rester en tant que cache.
Si tel est le cas, le cœur 1 accèdera à la mémoire déjà libérée, ce qui entraînera une faille de sécurité majeure pouvant détruire les données allouées à d’autres processus ou lire des informations confidentielles. Pour éviter cela, l’OS doit forcer la suppression de l’entrée correspondante du TLB du cœur 1. C’est ce qu’on appelle le TLB Shootdown.
Le TLB Shootdown est strictement exécuté par les étapes suivantes (protocole IPI) :
- Initiateur (Cœur 0) : Après avoir mis à jour la table de pages (effacement de la PTE), il émet une barrière mémoire (comme
mfence) et envoie une IPI (Inter-Processor Interrupt : Interruption Inter-Processeur) au contrôleur APIC local (Advanced Programmable Interrupt Controller) des autres cœurs cibles (cœur 1). - Attente (Busy wait) : Le cœur 0 attend via un spinlock (verrouillage actif) que tous les autres cœurs cibles aient fini de traiter l’interruption.
- Cible (Cœur 1) : Lorsqu’il reçoit l’IPI, il interrompt immédiatement le code utilisateur en cours d’exécution et passe au gestionnaire d’interruptions du noyau (comme
flush_tlb_funcviasmp_call_functionsous Linux). - Exécution du flush : Le cœur 1 invalide l’entrée de l’adresse virtuelle spécifiée de son TLB local (le x86 utilise l’instruction
INVLPG, recharge CR3 dans le cas d’un flush complet). - Notification d’achèvement : Le cœur 1 écrit l’achèvement du flush dans un drapeau en mémoire, libérant l’attente du cœur 0. Ensuite, il retourne au traitement interrompu (
iret).
Goulots d’étranglement des performances et limites d’évolutivité (Scalability) : Le TLB Shootdown est une opération extrêmement coûteuse qui consomme de milliers à des dizaines de milliers de cycles, car elle implique l’émission matérielle d’IPI, le changement de contexte d’interruption, le vidage du pipeline et l’attente de spinlock entre plusieurs cœurs. À mesure que le nombre de cœurs passe à 16, 64, 128, ce coût de synchronisation augmente de manière exponentielle, devenant un obstacle majeur à la mise à l’échelle pour les applications multithreads (en particulier celles qui répètent fréquemment l’allocation et la libération de mémoire) sur les serveurs cloud et le HPC.
Chapitre 5 : Trace complète du traitement des défauts de page dans le noyau Linux
Lorsqu’un programme accède à une zone où le bit Present de la table de pages est à 0, ou à une zone sans privilèges (tentative d’écriture dans une zone Read-Only, accès à la zone noyau depuis le mode utilisateur, etc.), la MMU émet une exception de défaut de page (Exception 14, #PF sur x86). De là commence un voyage dans la profonde gestion des exceptions du noyau Linux.
5.1 Flux de contrôle des défauts de page et trace de la partie dépendante de l’architecture
Dans le noyau Linux x86-64, le graphe d’appel de fonctions (call trace) lorsqu’un défaut de page se produit est le suivant. Le contrôle passe du gestionnaire de bas niveau dépendant de l’architecture au sous-système de gestion de mémoire générique indépendant de l’architecture.
asm_exc_page_fault(Langage assembleur : arch/x86/entry/entry_64.S)- Le CPU détecte l’exception, le matériel définit l’adresse virtuelle où la faute s’est produite dans le registre
CR2, sauvegarde l’état des registres sur la pile d’interruptions et saute au point d’entrée du noyau.
- Le CPU détecte l’exception, le matériel définit l’adresse virtuelle où la faute s’est produite dans le registre
exc_page_fault()(Langage C : arch/x86/mm/fault.c)- C’est le gestionnaire de fautes dépendant de l’architecture. Il analyse le code d’erreur (Read/Write, User/Kernel, PF, etc.) et vérifie le contexte de l’interruption, etc.
do_page_fault()/do_user_addr_fault()- Détermine si la faute s’est produite dans l’espace noyau (bug, zone vmalloc, etc.) ou dans l’espace utilisateur. Dans le cas de l’espace utilisateur, il recherche la carte mémoire du processus cible (l’arbre rouge-noir et la liste VMA de
vm_area_struct) et vérifie si cette adresse appartient à une zone valide (si ce n’est pas un défaut de segmentation).
- Détermine si la faute s’est produite dans l’espace noyau (bug, zone vmalloc, etc.) ou dans l’espace utilisateur. Dans le cas de l’espace utilisateur, il recherche la carte mémoire du processus cible (l’arbre rouge-noir et la liste VMA de
handle_mm_fault()(Langage C : mm/memory.c)- À partir d’ici se trouvent les fonctions centrales indépendantes de l’architecture. Elle parcourt chaque niveau de la table de pages (PGD -> P4D -> PUD -> PMD -> PTE), et si la table n’a pas encore été allouée, elle alloue de nouveaux répertoires intermédiaires (
pmd_alloc, etc.) tout en identifiant l’adresse finale de la PTE.
- À partir d’ici se trouvent les fonctions centrales indépendantes de l’architecture. Elle parcourt chaque niveau de la table de pages (PGD -> P4D -> PUD -> PMD -> PTE), et si la table n’a pas encore été allouée, elle alloue de nouveaux répertoires intermédiaires (
5.2 L’essence de l’allocation de mémoire : les bifurcations à partir de handle_mm_fault
handle_mm_fault() divise le processus d’allocation de page réel en fonction de l’état de la PTE identifiée (si la PTE est vide, si elle est swappée, ou s’il s’agit d’une erreur de permission).
do_anonymous_page()(Le summum de la pagination à la demande) : Appelé lorsque la PTE est complètement vide (zéro). C’est le premier accès à une page anonyme (Anonymous Page) qui n’est pas liée à un fichier, comme l’expansion du tas (lebrkoummapderrièremalloc) ou de la pile. Le noyau sécurise ici pour la première fois la mémoire physique (trame) à partir du système de compagnons (Buddy System), l’efface à zéro et la mappe à la PTE. Cela permet d’économiser la mémoire inutilisée.do_fault()/__do_fault()(Pagination soutenue par un fichier) : Appelé lors du premier accès à un fichier viammap, etc. Il lit les données du fichier à partir du cache de page, ou appelle le pilote du système de fichiers (ext4 ou xfs) pour charger les données à partir du disque et les mapper à la table de pages.do_swap_page()(La douleur du swap in) : Appelé lorsque le bit Present de la PTE est à 0, mais que les informations de décalage de la zone de swap sont enregistrées dans un autre bit d’indicateur. Il recharge les données du disque (partition de swap ou fichier de swap) vers la mémoire physique. Comme cela implique des E/S disque, le processus entre dans un long état de sommeil (blocage) ici.do_wp_page()(Copy-on-Write) : C’est le processus CoW décrit ci-dessous. Appelé lorsque vous essayez d’écrire sur une page où Present=1 mais sans droits d’écriture.
5.3 Mécanisme physique du Copy-on-Write (CoW) et la magie du comptage de références
L’appel système fork(), qui est la pierre angulaire de la création de processus Linux, fonctionne extrêmement rapidement grâce à un mécanisme d’évaluation paresseuse appelé CoW (Copy-on-Write). Nous expliquons le mécanisme physique qui permet à fork() de se terminer instantanément même si le processus parent utilise plusieurs Go de mémoire.
- Partage des tables de pages :
Lorsque
fork()est appelé, le noyau copie la table de pages du processus parent telle quelle dans le processus enfant. Cependant, il ne copie aucune mémoire physique en soi. Les PTE du parent et de l’enfant pointent exactement vers la même mémoire physique (trame). - Configuration forcée du bit Read-Only (Write-Protect) :
À ce moment-là, le noyau réécrit de force le bit
R/Wde toutes les PTE des pages partagées à0(Read-Only) (y compris toutes les zones de données qui étaient initialement inscriptibles). - Incrémentation du compteur de références (Reference Count) :
Il incrémente la structure du noyau gérant la page physique cible (
_refcountdestruct page), la mettant dans l’état « référencée par 2 processus ». - Écriture et défaut de page (déclenchement de do_wp_page) :
Lorsque le parent ou l’enfant tente d’écrire (Write) dans une variable ou une zone de tas partagée, la MMU matérielle détecte
R/W=0et génère immédiatement un défaut de page. - Duplication de page (Duplication) :
do_wp_page()est appelé depuis le gestionnaire de défauts de page. Le noyau vérifie les indicateurs du VMA et détermine que « ce n’est pas un accès illégal, mais un défaut légitime dû au CoW ». Il alloue une nouvelle page physique du système Buddy et copie l’intégralité des données de la page d’origine (copy_page). - Mise à jour de la PTE et décrémentation du compteur de références :
Il redirige la PTE du processus ayant effectué l’écriture vers la nouvelle page physique et définit le bit
R/Wà1(Read/Write possible). Ensuite, le compteur de références de la page physique d’origine est décrémenté. Si le compteur de références tombe à 1, cela signifie que l’autre processus détient cette page de manière exclusive. Ainsi, la prochaine fois que ce processus provoquera un défaut, il suffira de remettre le bit R/W à 1 sans copier la mémoire (réutilisation de page).
De cette façon, le CoW est un algorithme artistique où la fonction de protection matérielle de la MMU (interception Read-Only) et le contrôle logiciel du noyau sont magnifiquement intégrés, réalisant des économies de mémoire spectaculaires et un démarrage rapide des processus.
Chapitre 6 : Les abysses de l’algorithme de récupération de la mémoire (Reclaim) et la condamnation du OOM Killer
La mémoire physique est limitée. Lorsque le système fonctionne pendant une longue période et que le cache des fichiers ou le tas des processus épuisent la mémoire, l’OS doit libérer et récupérer (Reclaim) les zones mémoire existantes pour allouer de la nouvelle mémoire. Ce sous-système de récupération de la mémoire est l’un des domaines les plus complexes et difficiles du noyau Linux.
6.1 Listes LRU actives/inactives et algorithme pseudo-LRU
Le noyau Linux utilise des listes LRU (Least Recently Used) pour gérer et suivre les pages physiques. Cependant, il est impossible de gérer toutes les pages avec un LRU strict en termes de conflits de verrouillage et de coûts de parcours. Par conséquent, il adopte un algorithme pseudo-LRU (un dérivé de l’algorithme Clock) utilisant deux files d’attente (listes) : la « liste Active » et la « liste Inactive ».
- Liste Active : Un ensemble de pages « chaudes (hot) » fréquemment consultées récemment. Celles-ci ne sont pas cibles de la récupération.
- Liste Inactive : Un ensemble de pages « froides (cold) » qui n’ont pas été consultées depuis un certain temps. Elles deviennent des candidates à la récupération dans l’ordre, à partir des pages situées à la fin (tail).
Comment le noyau sait-il si une page a été consultée ? C’est ici que le bit Accessed (bit A) de la PTE, expliqué au chapitre 2, entre en jeu. Le noyau (kswapd) parcourt régulièrement la table de pages, lit le bit A de la PTE, enregistre l’historique d’accès du côté logiciel, puis efface le bit A à 0. Si le bit A est de nouveau mis à 1 par le matériel, la page reste dans la liste Active, ou est promue depuis Inactive. S’il n’est pas mis à 1, il est progressivement rétrogradé vers la fin de la liste Inactive.
6.2 Le démon kswapd et la terreur du Direct Reclaim
Lorsque la capacité de mémoire libre (Free Pages) tombe en dessous d’un seuil spécifique (watermark : low), kswapd, un thread d’arrière-plan du noyau (existant pour chaque nœud NUMA), se réveille.
kswapd extrait les pages de la fin de la liste Inactive.
- S’il s’agit d’un cache de fichier propre (clean) (données de fichier non modifiées), il le supprime (Drop) simplement pour libérer de la mémoire.
- S’il s’agit d’un cache de fichier sale (dirty) (modifié), il l’écrit sur le disque (Writeback) avant de le supprimer.
- S’il s’agit d’une page anonyme (le tas ou la pile du processus), il l’écrit dans la zone de swap (swap out).
Ce travail en arrière-plan se poursuit jusqu’à ce que la capacité libre atteigne le watermark
high.
Cependant, si la vitesse d’allocation de mémoire de l’application (pression sur la mémoire) est extrêmement élevée et que la vitesse de récupération de kswapd ne peut pas suivre, entraînant la mémoire libre sous la limite extrême (watermark min), le Direct Reclaim (Récupération directe) se déclenche.
Le Direct Reclaim est un mécanisme qui exécute directement et de manière synchrone le processus de récupération de mémoire (suppression du cache et swap out) dans le contexte du processus qui a demandé la mémoire (l’application elle-même). Lors de l’entrée dans le Direct Reclaim, l’exécution de l’application (l’achèvement de malloc ou du défaut de page) est complètement bloquée (stall), ce qui est la cause directe d’une baisse sévère des performances (pics de latence) allant de plusieurs centaines de millisecondes à quelques secondes. Pour les bases de données et les systèmes en temps réel, un ajustement pour éviter cela (ajustement de vm.swappiness et des watermarks) est essentiel.
6.3 La formule de calcul du score du OOM Killer et la condamnation des processus
Si, même après un Direct Reclaim, la zone de swap est épuisée, le cache est complètement rogné et la mémoire ne peut toujours pas être sécurisée, le noyau Linux invoque l’OOM (Out Of Memory) Killer en dernier recours.
Pour éviter que l’ensemble du système ne panique par manque de mémoire (plantage du noyau ou blocage complet), l’OOM Killer « tue de force (SIGKILL) » les processus consommant une grande quantité de mémoire pour la récupérer. Il existe un algorithme impitoyable pour déterminer la victime.
La décision de savoir quel processus tuer est prise sur la base d’une valeur d’évaluation appelée oom_score (calculée par la fonction oom_badness() dans mm/oom_kill.c du noyau).
Logique de calcul de base de l’OOM Score (concept) :
- Score de base : Le ratio de la quantité de mémoire actuellement utilisée par le processus (RSS : Resident Set Size + taille de la table de pages + utilisation du swap) par rapport à la mémoire totale. Maximum de 1000 points. En d’autres termes, les processus qui consomment beaucoup de mémoire (comme les processus causant des fuites de mémoire) sont plus susceptibles d’être tués.
- Atténuation de la pénalité pour les privilèges root : Les processus s’exécutant avec les privilèges de l’utilisateur root (tels que les démons centraux du système) ont une forte probabilité d’être essentiels à la maintenance du système, leur score est donc légèrement réduit (négatif), ce qui les rend moins susceptibles d’être tués.
- Valeur d’ajustement utilisateur (OOM Score Adj) : La valeur de
/proc/[pid]/oom_score_adj(de -1000 à +1000) est ajoutée. L’administrateur système peut l’utiliser pour contrôler le comportement de l’OOM Killer. Un processus dont cette valeur est fixée à -1000 (ex. : sshd, kubelet, processus maître d’une base de données, etc.) est « exempté de l’OOM Killer (invincible) ».
Lorsque l’OOM Killer est déclenché, avec un message tel que « Out of memory: Killed process 1234 (java) » dans le journal du noyau (dmesg ou /var/log/messages), un vidage détaillé de la liste des processus, de chaque score et de l’état de la mémoire à ce moment-là est affiché. En comprenant ces journaux et le mécanisme de calcul du score, les administrateurs système peuvent enquêter sur la cause des arrêts de processus inattendus et définir des limites de ressources appropriées (cgroups ou ulimit).
Chapitre 7 : Les dernières techniques de mémoire ultra-rapides et la sécurité matérielle
7.1 La puissance des HugePages 2 Mo/1 Go et les avantages et inconvénients de THP
Un moyen puissant de résoudre les défauts de TLB et les retards de parcours de table mentionnés aux chapitres 3 et 4 est la « HugePage ». Au lieu de la page normale de 4 Ko, elle utilise de gigantesques pages de 2 Mo (pointant directement vers l’adresse physique à l’étape du Page Directory, c’est-à-dire en sautant la hiérarchie PT) ou de 1 Go (pointant directement à l’étape PDPT).
Grâce à cela, une seule entrée TLB peut couvrir une vaste zone mémoire (512 fois ou 260 000 fois celle de 4 Ko), ce qui réduit considérablement les échecs de TLB. Pour les bases de données accédant de manière aléatoire à de grandes quantités de mémoire (Oracle, PostgreSQL) et les environnements de virtualisation (KVM/QEMU), l’utilisation des HugePages est un élément essentiel de l’optimisation des performances.
Le THP (Transparent Huge Pages) de Linux est un mécanisme par lequel le thread d’arrière-plan du noyau (khugepaged) intègre (défragmente) automatiquement des pages consécutives de 4 Ko en HugePages de 2 Mo, sans que l’application n’en ait conscience. Cependant, dans un environnement où la fragmentation de la mémoire a progressé, ce processus d’intégration lui-même (compaction de la mémoire) consomme beaucoup de CPU et provoque des pics de latence. Il est donc recommandé de désactiver le THP (never ou madvise) dans les KVS en mémoire comme Redis.
7.2 L’isolation des tables de pages du noyau (KPTI) et le coût des contre-mesures Meltdown
La faille d’exécution spéculative du CPU « Meltdown (CVE-2017-5754) », découverte en 2018, était un défaut fatal ébranlant les fondements du matériel, permettant la lecture illégale de l’espace mémoire du noyau (cache) depuis un processus utilisateur.
Pour contrer cela, le système d’exploitation a introduit le KPTI (Kernel Page-Table Isolation) (initialement appelé KAISER).
Auparavant, pour réduire la surcharge (overhead) du changement de contexte, l’ensemble de la zone du noyau était mappé dans la moitié supérieure de la table de pages, même lors de l’exécution dans l’espace utilisateur (en supposant que les vérifications des privilèges étaient effectuées via le bit U/S de la PTE et que l’accès serait refusé). Cependant, l’exécution spéculative a contourné cette vérification des privilèges.
Après l’introduction de KPTI, lors de l’exécution par l’utilisateur, une « table de pages fantôme minimale (User PGD) » qui ne mappe pas la majorité du noyau est utilisée. Lors de la transition vers l’espace noyau via un appel système ou une interruption, le registre CR3 doit toujours être commuté et rechargé avec la table de pages complète du noyau (Kernel PGD).
Cela a complètement garanti la sécurité, mais parce qu’il provoque un basculement coûteux de CR3 (ainsi que la gestion du vidage PCID/TLB) à chaque appel système et interruption, cela a entraîné une surcharge de performances non négligeable de plusieurs pour cent à plus de 10 % dans les applications gourmandes en E/S (serveurs Web et bases de données utilisant fortement les Syscalls).
7.3 L’évolution du Direct I/O et des technologies Zéro-Copie
Afin d’optimiser les E/S de fichiers, l’OS applique le mécanisme de la mémoire virtuelle à ses limites.
L’utilisation de l’appel système mmap() mappe directement le contenu d’un fichier dans l’espace d’adressage virtuel. Lors de l’accès, un défaut de page se produit, les données du fichier sont chargées dans le cache de page et deviennent directement accessibles depuis l’espace utilisateur sous forme de pointeur.
De plus, dans la transmission/réception réseau et les E/S de stockage, la technologie zéro-copie (zero-copy) est utilisée pour éliminer la copie de données (copie accompagnant les changements de contexte) par le CPU entre l’espace noyau (cache de page) et le tampon de l’espace utilisateur. L’appel système sendfile() ou les récents io_uring et AF_XDP coopèrent avec le contrôleur DMA (Direct Memory Access) de la carte réseau ou du lecteur NVMe, manipulent la PTE de la table de pages et « réattachent (remappent) » directement la page du noyau dans l’espace utilisateur, réduisant ainsi la surcharge de copie de la mémoire à zéro. Ici aussi, la manipulation habile des tables de pages est effectuée comme mécanisme sous-jacent.
Conclusion
La mémoire virtuelle et le mécanisme de pagination sont une symphonie extrêmement avancée jouée par le noyau de l’OS et le CPU (matériel). Depuis la configuration du drapeau d’un seul bit dans la table de pages, l’angoisse du spinlock concernant le TLB Shootdown, la magie de la mémoire grâce au compteur de références du CoW, jusqu’aux heuristiques impitoyables du OOM Killer, ces profondeurs regorgent de la sagesse de l’informatique : « comment abstraire des ressources physiques limitées de manière sûre et rapide, et donner aux processus l’illusion de l’infini ».
Comprendre les mécanismes de bas niveau est indispensable non seulement pour l’optimisation dans les langages de programmation système tels que C/C++ et Rust (conception de structures de données tenant compte des lignes de cache, utilisation efficace de mmap), mais aussi pour comprendre en profondeur les temps de pause (STW) du ramasse-miettes (GC) et le comportement des allocateurs de mémoire (jemalloc ou tcmalloc) dans des langages de haut niveau tels que Go et Java. En levant le voile sur la « magie » du système et en ressentant directement le battement de cœur du matériel et du noyau, la voie s’ouvrira pour devenir un architecte d’excellence capable de concevoir des logiciels plus raffinés et plus évolutifs.