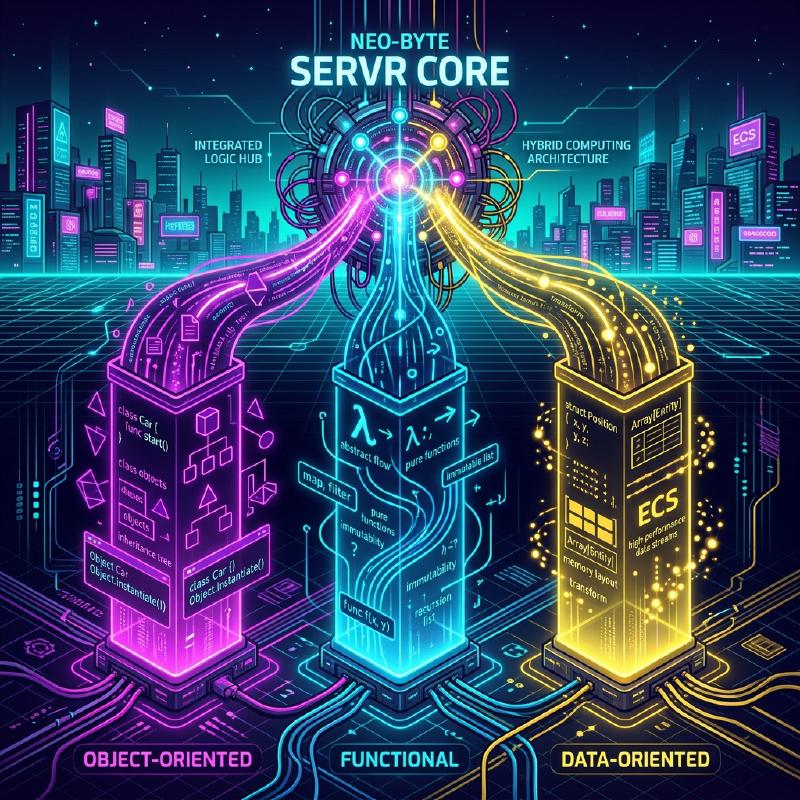
L’histoire de l’évolution des langages de programmation est aussi l’histoire de la lutte contre la complexité. À mesure que les logiciels deviennent plus vastes, ils se heurtent aux murs de la gestion de l’état, des performances et de la maintenabilité, et divers paradigmes de programmation ont été proposés pour les surmonter.
Dans cet article, nous approfondirons les philosophies, les forces et les limites de la programmation orientée objet (POO) dominante dans le développement de logiciels modernes, de la programmation fonctionnelle (PF) avec sa robustesse mathématique, et de la programmation orientée données (POD / DOD) axée sur les performances et la séparation des données. De plus, nous expliquerons comment les langages puissants modernes (tels que Rust et TypeScript) fusionnent ces approches.
1. L’essor et la chute de la programmation orientée objet (POO)
La programmation orientée objet (POO) a régné en maître absolu du développement de logiciels des années 1990 aux années 2010. Des langages comme Java, C++ et C# ont conduit ce paradigme, et l’approche intuitive de modélisation du monde réel a été acceptée.
1.1 Concepts fondamentaux de la POO
Le but de la POO est d’encapsuler les « données » et le « comportement » qui manipule ces données dans un seul objet.
- Encapsulation : Masque l’état interne et n’autorise la manipulation de l’extérieur que par le biais de méthodes publiques.
- Héritage : Étend les classes existantes pour améliorer la réutilisabilité du code.
- Polymorphisme : Permet de basculer entre différentes implémentations avec la même interface.
| |
1.2 Limites de la POO et le « problème du gorille et de la banane »
À première vue, la POO semble être une méthode de modélisation parfaite, mais à mesure que les systèmes se développent, elle a causé des problèmes fatals : l’abus d’héritage et la gestion implicite de l’état.
Une citation célèbre de Joe Armstrong (le créateur d’Erlang) dit ce qui suit.
“Le problème avec les langages orientés objet est qu’ils emportent tout leur environnement implicite avec eux. Vous vouliez une banane, mais vous vous retrouvez avec un gorille tenant la banane et toute la jungle avec.”
  classDiagram
    class "GameObject" {
        +Transform transform
        +update()
    }
    class "Character" {
        +Health health
        +move()
    }
    class "Player" {
        +Inventory inventory
        +handleInput()
    }
    class "Enemy" {
        +AIController ai
        +attack()
    }
    "GameObject" <|-- "Character"
    "Character" <|-- "Player"
    "Character" <|-- "Enemy"
Les arbres d’héritage profonds compliquent les dépendances du code et rendent extrêmement difficile l’extraction et la réutilisation de fonctionnalités spécifiques seules. De plus, avec plusieurs objets se référençant et modifiant leurs états mutuellement, la prévisibilité globale du système diminue considérablement.
2. L’approche mathématique de la programmation fonctionnelle (PF)
La programmation fonctionnelle (PF) est sous les feux des projecteurs comme une antithèse à la complexité causée par la « mutation d’état » de la POO. Elle a fortement influencé non seulement des langages comme Haskell, Scala et Clojure, mais aussi JavaScript et TypeScript de nos jours.
2.1 Concepts fondamentaux de la PF
La PF construit des programmes comme une combinaison de fonctions pures.
- Fonctions pures : Renvoient toujours la même sortie pour la même entrée et ne modifient pas l’état externe (sans effets secondaires).
- Immuabilité (Immutability) : Une fois créées, les données ne sont pas modifiées. Si des modifications sont nécessaires, de nouvelles structures de données sont générées.
- Fonctions d’ordre supérieur et composition de fonctions : Traitent les fonctions comme des données et les combinent pour construire un traitement complexe.
| |
Les transitions d’état en PF sont exprimées de la même manière qu’une fonction mathématique $f(x) = y$. Étant donné un état du système $S$ et une action $A$, le nouvel état $S'$ peut être exprimé comme suit.
$ S' = f(S, A) $
Écrire de cette façon rend le test du code extrêmement facile et élimine fondamentalement les conditions de concurrence (data races) dans le traitement parallèle (multithreading).
2.2 Limites de la PF : Désaccord avec le « monde réel »
Le paradigme fonctionnel a également ses limites. Un ordinateur est par nature une machine avec un état (architecture de von Neumann), et la PF pure s’écarte du principe de fonctionnement du processeur.
L’allocation de mémoire pour maintenir l’immuabilité (charge sur le ramasse-miettes) et les monades pour gérer les « effets secondaires inévitables » comme les E/S (sortie écran, écriture dans la base de données) ont un coût d’apprentissage conceptuel élevé et deviennent parfois des goulots d’étranglement des performances.
3. Retour à la programmation orientée données (POD/DOD)
La conception orientée données (Data-Oriented Design) ou programmation orientée données est un paradigme né sur le terrain du développement de jeux (en particulier C++ et Rust), et qui s’est ensuite propagé au domaine des entreprises (comme la philosophie de Clojure).
3.1 Concepts fondamentaux de la POD
La POD considère la « séparation des données et de la logique » comme un impératif absolu. Alors que la POO regroupe les données et la logique dans des classes, la POD les sépare.
- Séparation des données : Les données sont définies comme de simples structures de données (enregistrements, structs) et n’ont aucun comportement.
- ECS (Entity Component System) : Au lieu de l’héritage, les données sont divisées en composants, et le système (fonction) les traite par lots.
- Efficacité du cache (Disposition de la mémoire) : Les données sont placées en mémoire contiguë (SoA : Structure of Arrays) afin qu’elles se trouvent sur la ligne de cache du processeur.
| |
  graph TD
    subgraph "Data (Components)"
        "P"["Positions Array"]
        "V"["Velocities Array"]
        "H"["Healths Array"]
    end

    subgraph "Logic (Systems)"
        "PhysicsSystem"["PhysicsSystem"]
        "DamageSystem"["DamageSystem"]
    end

    "PhysicsSystem" -->|"Reads"| "V"
    "PhysicsSystem" -->|"Mutates"| "P"
    "DamageSystem" -->|"Mutates"| "H"
3.2 Limites de la POD : Difficulté d’application à la logique métier
Dans les domaines où les performances sont absolues, comme les moteurs de jeu, la POD (ECS) est invincible, mais dans la construction d’applications Web générales ou de logique métier, elle présente l’inconvénient que le code devient trop procédural et que les relations de données deviennent dispersées (réduisant la cohésion).
4. Comparaison et compromis des paradigmes
Chaque paradigme a ses propres forces et faiblesses claires.
| Paradigme | Avantages | Inconvénients | Cas d’utilisation optimaux |
|---|---|---|---|
| POO | Modélisation intuitive, masquage par encapsulation | Complexité de l’héritage, bugs dus à la mutation implicite de l’état | Frameworks GUI, modélisation du domaine métier |
| PF | Tolérance à la concurrence, facilité de test, prévisibilité | Courbe d’apprentissage abrupte, performances (charge du GC) | Pipelines de transformation de données, systèmes concurrents |
| POD | Performances exceptionnelles, transparence de l’état | Diminution de la cohésion des données, tendance à devenir procédural | Développement de jeux, opérations intensives, systèmes embarqués |
5. La solution optimale moderne : La « fusion » des paradigmes
Aujourd’hui, il est considéré comme absurde de choisir une « seule bonne réponse » parmi ces derniers. Les langages de programmation modernes (Rust, TypeScript, Scala, Go, etc.) prennent le meilleur de ces paradigmes.
5.1 Rust démontre la fusion ultime
Rust fusionne ces trois paradigmes à un niveau étonnant.
- Orienté données : Représentation efficace des données en mémoire en utilisant
structetenum. - Fonctionnel : API d’itérateur riche, filtrage par motif (pattern matching), immuabilité par défaut.
- Orienté objet : Polymorphisme via
traitet encapsulation des données.
| |
Dans ce code, tout en utilisant des types sommes (une caractéristique fonctionnelle) avec enum, l’état est géré de manière centralisée et orientée données.
5.2 Architecture pratique en TypeScript
Même dans le développement front-end avec TypeScript (comme React), la fusion des paradigmes est devenue la norme.
- Le rendu de l’UI des composants est fonctionnel (renvoie l’UI en tant que fonction pure).
- La récupération des données et la gestion du cache sont orientées données (arbres d’état normalisés avec Redux ou Zustand).
- Certaines parties de la logique de domaine complexe sont orientées objet (couche de service basée sur des classes).
6. Conclusion
Orienté objet , Fonctionnel , Orienté données . Ce ne sont pas des religions mutuellement exclusives.
L’important est de discerner la nature du domaine que nous essayons de résoudre. Si les performances sont la priorité absolue, renforcez les éléments orientés données. Si le flux de traitement concurrentiel ou de transformation des données est central, adoptez l’approche fonctionnelle. Et utilisez des techniques orientées objet pour des domaines localisés qui nécessitent des règles métier complexes ou de l’encapsulation.
“Les paradigmes de programmation ne nous disent pas ce qu’il faut faire, mais ce sont des contraintes qui nous disent ce qu’il ne faut pas faire.” — Robert C. Martin
Dépasser les barrières des paradigmes et utiliser plusieurs armes de manière appropriée selon le contexte est peut-être la compétence la plus importante requise des ingénieurs logiciels de la prochaine génération.