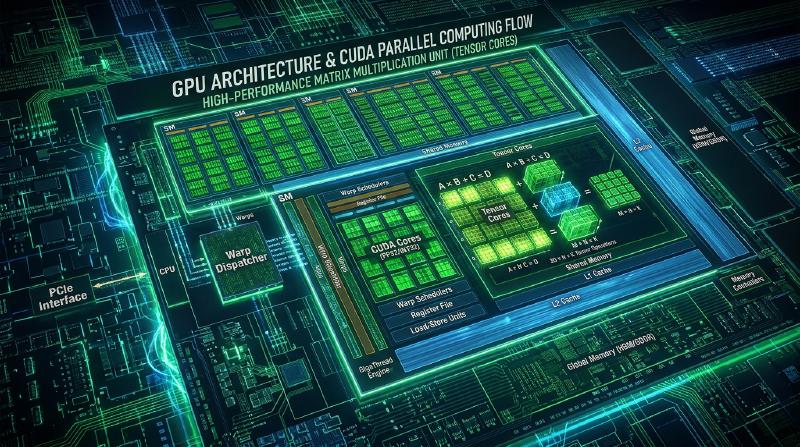
L’architecture massivement parallèle des GPU et la physique de CUDA : Les principes de calcul du SIMT, des Warps et des Tensor Cores
La technologie fondamentale qui soutient la science informatique avancée moderne, l’intelligence artificielle, l’apprentissage profond (deep learning) et l’infographie haute définition, c’est le GPU (Graphics Processing Unit). Dans cet article, nous allons examiner en profondeur les aspects physiques et matériels de l’architecture des GPU et de CUDA (Compute Unified Device Architecture), la plateforme de calcul parallèle qui s’exécute dessus. Plutôt que de s’attarder sur la simple grammaire de programmation, nous allons disséquer de manière exhaustive “pourquoi le matériel est conçu ainsi” et “comment il parvient à extraire un débit de calcul extrême”, sous l’angle des Streaming Multiprocessors (SM), du modèle d’exécution SIMT, de l’ordonnancement des warps, des Tensor Cores et de la hiérarchie de la mémoire.
Chapitre 1 : Le point de divergence entre les philosophies de conception du CPU et du GPU
1.1 Recherche d’une faible latence vs Recherche d’un débit élevé
Le CPU (Central Processing Unit), qui est un processeur polyvalent, et le GPU, spécialisé dans le calcul parallèle, ont des philosophies de conception fondamentalement différentes en raison de leur origine. Le CPU a évolué avec comme mission suprême la “faible latence” (minimisation du retard), c’est-à-dire “comment terminer une seule tâche (thread) le plus rapidement possible”. D’un autre côté, le GPU poursuit un “débit élevé” (maximisation du volume de traitement), à savoir “comment regrouper une quantité massive de tâches et déterminer combien de traitements peuvent être accomplis par unité de temps dans leur ensemble”.
Les CPU doivent exécuter rapidement des traitements imprévisibles, tels que le contrôle du système d’exploitation, l’exécution d’applications avec des conditions de branchement complexes et la gestion des interruptions aléatoires des utilisateurs. Pour cette raison, ils sont équipés de circuits de prédiction de branchement avancés, d’une exécution dans le désordre (out-of-order execution) et d’immenses mémoires cache L1/L2/L3, maximisant les performances d’un seul thread tout en masquant la latence d’accès à la mémoire.
En revanche, les GPU ont été créés à l’origine pour traiter des tâches hautement parallélisables, comme appliquer la même opération d’ombrage (shading) à des millions de pixels à l’écran. Au lieu de consacrer de la surface de puce (die area) à des circuits de contrôle complexes ou d’énormes caches, le choix a été fait de compacter un maximum d’unités arithmétiques simples (ALU : Arithmetic Logic Unit) jusqu’à la limite.
1.2 Répartition de la surface de puce entre le cache, les circuits de contrôle et l’ALU
La manière dont est répartie la surface limitée d’une puce de silicium (die) (le budget en transistors) détermine les différences d’architecture entre les deux.
- Répartition de la surface de puce du CPU : Plus de la moitié du die est occupée par une grande mémoire cache (SRAM) et des circuits de contrôle avancés (prédiction de branchement, fetch d’instructions, décodage, ordonnancement, etc.). La proportion occupée par les ALU qui effectuent les calculs réels est relativement faible.
- Répartition de la surface de puce du GPU : La mémoire cache et les circuits de contrôle sont réduits au strict minimum, et la majeure partie du die est occupée par des milliers voire des dizaines de milliers d’ALU (CUDA cores).
Le GPU ne masque pas la latence d’accès à la mémoire avec un cache, mais avec le “changement de contexte (context switching)”. Pendant qu’un groupe de threads attend l’arrivée des données de la mémoire, les calculs d’un autre groupe de threads sont exécutés immédiatement, maintenant ainsi les unités de calcul constamment actives (un taux d’occupation élevé : occupancy). C’est l’implémentation physique de la “recherche de débit élevé” dans les GPU. Étant donné que le multithreading au niveau matériel (Hardware Multithreading) est effectué de manière extrêmement légère, cela présuppose l’existence de milliers à des dizaines de milliers de threads concurrents.
Chapitre 2 : L’essence du modèle d’exécution SIMT
2.1 La différence entre SIMD et SIMT
La taxonomie de Flynn (Flynn’s taxonomy) sert de classification pour le traitement parallèle, mais le modèle d’exécution des GPU est souvent comparé au SIMD (Single Instruction, Multiple Data). Les instructions d’extension vectorielle des CPU (comme AVX) sont du pur SIMD, traitant simultanément plusieurs données avec une seule instruction (par exemple, 8 nombres à virgule flottante de 32 bits stockés dans un registre de 256 bits). En SIMD, il est très difficile d’effectuer des branchements différents (if-else) pour chaque élément de données.
D’autre part, le modèle d’exécution de CUDA proposé par NVIDIA est appelé SIMT (Single Instruction, Multiple Threads). En SIMT, plusieurs “threads” indépendants forment un groupe (appelé “warp”, détaillé ci-dessous) et exécutent la même instruction en la partageant. Cependant, contrairement au SIMD, chaque thread en SIMT possède un état de registre et un compteur d’adresse d’instruction indépendants (dans le modèle de programmation). Cela permet au programmeur d’écrire du code comme si chaque thread fonctionnait de manière indépendante.
2.2 Le “Warp”, l’unité de 32 threads
Le matériel GPU ne planifie pas les threads individuellement, mais les gère et les exécute en unités de 32 threads appelées “Warp”. (Dans les GPU AMD, cela s’appelle Wavefront, et des unités de 64 threads sont parfois utilisées).
L’unité de fetch et de décodage des instructions à l’intérieur du Streaming Multiprocessor (SM) récupère une instruction par warp, et émet (dispatch) la même instruction à l’ensemble des 32 threads du warp. Autrement dit, les 32 threads d’un warp exécutent physiquement exactement en même temps, la même instruction, sur des données différentes qui leur sont propres. C’est le cœur du SIMT.
2.3 La pénalité physique de la divergence de warp (Warp Divergence)
Bien que chaque thread puisse se comporter comme s’il possédait un compteur de programme indépendant, physiquement, tous les threads du warp doivent exécuter la même instruction. Que se passe-t-il donc s’il y a un branchement conditionnel tel que if-else dans le code, et que la vérité ou la fausseté de la condition varie selon les threads du warp ?
Ce phénomène est appelé divergence de warp (Warp Divergence).
Lorsqu’une divergence de warp se produit, le matériel procède selon les étapes suivantes :
- Tout d’abord, il exécute l’instruction uniquement pour les threads où la condition
ifest vraie (threads actifs). À ce moment-là, les threads où la condition est fausse sont “masqués” (désactivés), et leurs résultats de calcul ne sont pas écrits. - Ensuite, il passe au chemin de la condition
else(ou le chemin lorsque la condition est fausse), activant cette fois les threads précédemment masqués et masquant les threads qui étaient vrais pour exécuter l’instruction.
En d’autres termes, s’il y a plusieurs chemins de branchement, le matériel est obligé de les exécuter en série plutôt qu’en parallèle. À l’extrême, si 32 threads dans un warp suivent 32 chemins de branchement différents, le temps d’exécution sera multiplié par 32. La divergence de warp est l’un des principaux facteurs de réduction drastique du débit de calcul du GPU, et l’anti-pattern à éviter en priorité lors de la conception d’algorithmes. Physiquement, cela signifie que bien que les ALU consomment de l’énergie, un “cycle inutile” se produit car elles sont masquées et ne génèrent pas de résultats de calcul valides.
Chapitre 3 : Anatomie matérielle du Streaming Multiprocessor (SM)
Le GPU est structuré comme un ensemble de nombreux Streaming Multiprocessors (SM). Le SM est le véritable moteur de calcul du GPU. Dans les architectures récentes (ex. Hopper H100), une seule puce GPU intègre plus de 100 SM.
3.1 La structure du pipeline à l’intérieur du SM
Un SM est subdivisé en plusieurs sous-partitions (généralement 4), chacune possédant un ordonnanceur de warp (warp scheduler) et une unité de dispatch indépendants.
- Warp Scheduler (Ordonnanceur de Warp) : Il sélectionne les warps qui sont dans un état exécutable (les registres et la mémoire sont prêts). L’ordonnanceur du GPU peut basculer entre les warps avec un overhead de zéro, ce qui est la clé pour masquer la latence d’accès à la mémoire.
- Dispatch Unit (Unité de Dispatch) : Elle émet les instructions aux warps planifiés.
- CUDA Cores (INT32 / FP32 / FP64 ALU) : Les unités qui effectuent les opérations réelles sur les nombres entiers et à virgule flottante.
- Load/Store Unit (Unité LD/ST) : En charge de la lecture et de l’écriture en mémoire.
- Special Function Unit (SFU) : Matériel dédié au calcul rapide des fonctions transcendantes comme sin, cos, exp et l’inverse.
Le pipeline d’instructions est conçu pour être très profond, avec des étapes pour le fetch, le décodage, l’ordonnancement, la lecture des registres, l’exécution (sur plusieurs cycles) et l’écriture des résultats (write-back). La latence d’une opération FMA (Fused Multiply-Add) FP32 prend généralement de quelques cycles à une dizaine de cycles, mais en émettant des instructions provenant de warps différents à chaque cycle, le pipeline est maintenu constamment plein.
3.2 L’immense fichier de registres et la pression sur les registres
Le SM est équipé d’un fichier de registres gigantesque, incomparable à celui d’un CPU (ex : 64 Ko à 256 Ko de SRAM par SM). C’est parce qu’il doit conserver tous les contextes des milliers de threads exécutés simultanément sur le SM.
Le changement de contexte se termine en zéro cycle parce qu’il n’est pas nécessaire de sauvegarder (spill) l’état des registres d’un thread dans la mémoire. Cependant, à mesure que le nombre de registres utilisés par thread augmente, le nombre de warps qui peuvent être lancés simultanément dans le SM (l’occupancy) diminue. C’est ce qu’on appelle la pression sur les registres (register pressure). Lorsque les registres s’épuisent, les données sont déversées (spilled) dans la mémoire locale plus lente (physiquement une partie de la mémoire globale), ce qui entraîne une dégradation catastrophique des performances.
3.3 La mémoire partagée (Shared Memory) et les conflits de banques
Le SM dispose d’une mémoire sur puce ultra-rapide et contrôlable explicitement par le programmeur : la mémoire partagée (Shared Memory). Bien qu’elle partage la même région physique de SRAM que le cache L1, elle fonctionne comme un cache de données explicite et est utilisée pour le partage de données et la synchronisation entre les threads d’un bloc.
La structure physique de la mémoire partagée est divisée en plusieurs modules indépendants (généralement 32) appelés banques de mémoire (Memory Banks). Les adresses consécutives de 32 bits sont entrelacées (attribuées) sur différentes banques.
Si les 32 threads d’un warp accèdent simultanément à des banques différentes, l’accès est traité de manière totalement parallèle (en 1 cycle). C’est ce qu’on appelle un accès sans conflit de banque (bank-conflict free). Cependant, si plusieurs threads tentent d’accéder simultanément à des adresses différentes dans la même banque, les requêtes sont sérialisées et une pénalité (latence) se produit. C’est ce qu’on appelle un conflit de banques (Bank Conflict). Par exemple, avec un conflit à 2 voies, le temps d’accès est doublé, et dans le pire des cas, avec un conflit à 32 voies, il est multiplié par 32. Dans des algorithmes tels que la transposition de matrices, l’accès par pas (stride access) provoque de graves conflits de banques, d’où la nécessité d’une optimisation avancée utilisant le “padding” (une technique qui consiste à insérer des données factices pour décaler les adresses mémoire) afin d’éviter ces conflits.
Chapitre 4 : Le pipeline d’opérations de multiplication et d’accumulation (MAC) des Tensor Cores
Introduits pour la première fois avec l’architecture Volta, les Tensor Cores sont le matériel révolutionnaire qui a considérablement boosté les performances des GPU par la suite. Le développement explosif de l’IA et du deep learning ne peut être raconté sans mentionner les Tensor Cores.
4.1 Implémentation matérielle de la multiplication matricielle (MMA)
La majorité des calculs en apprentissage profond (deep learning) consiste en des multiplications matricielles (GEMM : General Matrix Multiply) entre les matrices de poids des réseaux de neurones et les données d’entrée. La formule de calcul est $D = A \times B + C$ (où $A, B$ sont les matrices d’entrée et $C$ est la matrice d’accumulation).
Dans les cœurs CUDA traditionnels, cette multiplication matricielle était calculée élément par élément à l’aide de l’instruction FMA (Fused Multiply-Add). En revanche, le Tensor Core est un circuit dédié qui exécute l’opération de multiplication et d’accumulation sur de petites matrices (par exemple 4x4 ou 16x16) au niveau matériel en 1 cycle (ou quelques cycles).
Physiquement, des dizaines à des centaines de multiplicateurs et un gigantesque arbre d’additionneurs sont directement connectés par des fils, réalisant la multiplication et l’accumulation d’un seul coup sans avoir à réécrire les résultats intermédiaires dans les registres. Par conséquent, le débit de calcul par unité de surface (TFLOPS) est infiniment supérieur à celui des cœurs CUDA standard.
4.2 Le secret de la précision mixte (Mixed-Precision)
L’autre grande caractéristique des Tensor Cores est le support du calcul en précision mixte (Mixed-Precision). En apprentissage profond, il y a de nombreuses situations où une précision élevée (FP32/FP64) n’est pas nécessaire pendant le processus de calcul. Les Tensor Cores possèdent un pipeline qui lit les matrices d’entrée $A$ et $B$ en basse précision (FP16, BF16, ou encore plus basse FP8, INT8, INT4), effectue la multiplication interne en basse précision, puis réalise le processus d’addition (accumulation) avec une précision plus élevée (FP32 ou INT32).
- FP16 / BF16 : Le standard pour l’entraînement. BF16 (Bfloat16) possède une partie exposant de 8 bits, identique au FP32, ce qui offre une plage dynamique plus large et permet de prévenir plus facilement la disparition du gradient.
- FP8 / INT8 / INT4 : L’atout maître pour l’accélération de l’inférence (Inference). Étant donné que la quantité de données transférées (bande passante mémoire) est également réduite, le débit est considérablement amélioré.
Dans l’architecture Hopper, le “FP8 Tensor Core” a été introduit, accélérant drastiquement les calculs des modèles Transformer, réalisant théoriquement un débit des dizaines de fois supérieur à celui du FP32. Du côté logiciel (CUDA), les Tensor Cores sont pilotés directement via l’API wmma (Warp-Level Matrix Multiply and Accumulate) et les instructions PTX mma.sync, où les threads d’un warp collaborent pour charger, calculer et stocker des fragments de matrices dans des registres lors d’un traitement collectif extrêmement complexe.
Chapitre 5 : Hiérarchie de la mémoire CUDA et techniques d’optimisation
Quelle que soit la puissance de calcul du GPU, si l’approvisionnement en données devient un goulot d’étranglement, les performances ne suivront pas (le problème du mur de la mémoire - memory wall). Il n’est pas exagéré de dire que 90 % de l’optimisation en programmation CUDA consiste à “optimiser les accès mémoire”.
5.1 Accès coalescé à la mémoire globale
La mémoire globale, qui est la mémoire principale du GPU (HBM ou GDDR), possède une bande passante très large (par exemple plusieurs To/s), mais sa latence est également très élevée, s’élevant à des centaines de cycles.
Le principe absolu pour maximiser l’efficacité de l’accès à la mémoire globale est le coalescing (fusion). Le contrôleur de mémoire du GPU accède à la mémoire par transactions de 32 octets, 64 octets ou 128 octets. Lorsque les 32 threads d’un warp accèdent à la mémoire, si leurs adresses mémoire se situent dans une région contiguë (dans une limite alignée de 128 octets), le matériel fusionne (coalesce) ces requêtes en une seule transaction mémoire pour les traiter.
Inversement, si les threads accèdent à des adresses aléatoires ou effectuent des accès espacés (avec un pas - stride), la fusion ne se produit pas et plusieurs transactions sont générées. C’est ce qu’on appelle un “accès non-coalescé”, qui constitue un bug de performance fatal pouvant réduire la bande passante mémoire effective à un dixième ou moins.
5.2 Exemple de code CUDA C++ : Optimisation de la transposition de matrice et mémoire partagée
Voici un exemple de code de kernel optimisé pour la transposition de matrice (Matrix Transpose), qui évite les accès non-coalescés et utilise la mémoire partagée pour améliorer considérablement les performances.
| |
Il y a 3 points clés dans ce code :
- Coalescing lors de la lecture : La lecture depuis
idatas’effectuant avecthreadIdx.xen direction X, elle est continue et donc parfaitement coalescée. - Coalescing lors de l’écriture : L’écriture vers
odataest également conçue pour être continue en directionthreadIdx.xen inversant les coordonnées du bloc, ce qui assure le coalescing. - Padding dans la mémoire partagée : En décalant d’un élément (padding) avec
tile[TILE_DIM][TILE_DIM + 1], les conflits de banques sont totalement éliminés lors de l’accès en direction des colonnes (tile[threadIdx.x][threadIdx.y + j]) au moment de l’écriture.
5.3 Hiérarchie de cache et mémoires spéciales
- Politiques de cache L1/L2 : Dans les architectures GPU récentes, le programmeur peut contrôler le comportement du cache à l’aide d’instructions PTX (comme
.ca,.cg,.cs) fournissant des indices. Par exemple, pour les données qui ne seront accédées qu’une seule fois, il est possible de contourner le cache L2 (streaming access) afin d’éviter la pollution du cache. - Mémoire de texture / Mémoire constante : La mémoire de texture, spécialisée dans le traitement d’images, utilise un cache dédié pour les accès présentant une localité spatiale 2D. La mémoire constante offre une efficacité extrêmement élevée pour les accès par diffusion (broadcast access), où tous les threads lisent la même constante.
Chapitre 6 : L’avenir des GPU à l’ère du Deep Learning
La frontière actuelle de la science informatique ne réside pas seulement dans l’amélioration des performances d’un seul GPU, mais dans la mise à l’échelle (scaling) du système dans son ensemble.
6.1 Interconnexion ultra-rapide avec NVLink et NVSwitch
Les immenses LLM (Grands Modèles de Langage) ne peuvent plus tenir dans la mémoire d’un seul GPU (par exemple 80 Go ou 144 Go). Pour effectuer un parallélisme de modèles (Tensor Parallel ou Pipeline Parallel), il est nécessaire d’échanger des téraoctets de données par seconde entre les GPU. Étant donné que le bus PCIe (PCI Express) traditionnel ne peut fournir cette bande passante, NVIDIA a développé sa propre interconnexion haut débit appelée NVLink. De plus, en utilisant une puce de commutation appelée NVSwitch, il est devenu possible de construire des clusters où 8 ou 256 GPU sont connectés par un commutateur crossbar totalement non bloquant, se comportant ainsi comme un seul gigantesque GPU.
6.2 Transformer Engine et l’écosystème FP8
Afin d’optimiser l’architecture Transformer, qui est devenue la norme de facto non seulement pour le traitement du langage naturel, mais aussi pour la reconnaissance d’images et vocale, l’architecture Hopper a intégré un mécanisme de coordination matérielle et logicielle dédié appelé Transformer Engine. Ce système surveille dynamiquement les statistiques des tenseurs et bascule automatiquement la précision des calculs entre FP8 et FP16 couche par couche (Dynamic Scaling). Cela permet d’obtenir des vitesses de calcul extrêmes et de réaliser des économies de bande passante mémoire tout en prévenant la dégradation de la précision.
6.3 Lois d’échelle (Scaling Laws) des clusters GPU et perspectives d’avenir
Comme le démontrent les “Scaling Laws” (Lois d’échelle) d’OpenAI, les performances de l’IA continuent de s’améliorer à mesure que l’on augmente le nombre de paramètres et la quantité de calculs d’un modèle. Par conséquent, les GPU sont passés du statut de simples processeurs à celui de centres de données entiers interconnectés par des milliers de fibres optiques, fonctionnant comme “un seul gigantesque GPU (superordinateur)”.
Les évolutions futures de l’architecture s’orienteront très probablement vers l’introduction de la photonique sur silicium (interconnexions optiques), du CPO (Co-Packaged Optics) et vers des niveaux plus avancés de technologie d’empilement 3D (de SRAM à HBM). Cependant, “la maximisation du débit par le traitement parallèle”, cet ADN immuable des GPU depuis leur naissance, continuera à ouvrir la voie à l’avant-garde de la science informatique.
【Réflexion additionnelle】Analyse mathématique de l’ordonnancement et de l’occupancy sur les GPU
title: “L’architecture massivement parallèle des processeurs de calcul graphique et la physique de CUDA : Les principes de calcul du SIMT, des Warps et des Tensor Cores” description: “La conception interne des processeurs de calcul graphique qui pousse le haut débit à son paroxysme. L’essence des SM, de l’ordonnancement des warps, des Tensor Cores et de l’optimisation de la mémoire partagée.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
L’architecture massivement parallèle des processeurs de calcul graphique et la physique de CUDA : Les principes de calcul du SIMT, des Warps et des Tensor Cores
La technologie fondamentale qui soutient la science informatique avancée moderne, l’intelligence artificielle, l’apprentissage profond (deep learning) et l’infographie haute définition, c’est le processeur de calcul graphique (Graphics Processing Unit). Dans cet article, nous allons examiner en profondeur les aspects physiques et matériels de l’architecture des processeurs de calcul graphique et de CUDA (Compute Unified Device Architecture), la plateforme de calcul parallèle qui s’exécute dessus. Plutôt que de s’attarder sur la simple grammaire de programmation, nous allons disséquer de manière exhaustive “pourquoi le matériel est conçu ainsi” et “comment il parvient à extraire un débit de calcul extrême”, sous l’angle des Streaming Multiprocessors (SM), du modèle d’exécution SIMT, de l’ordonnancement des warps, des Tensor Cores et de la hiérarchie de la mémoire.
Supplément du Chapitre 1 : Le point de divergence entre les philosophies de conception du processeur de calcul polyvalent et du processeur de calcul graphique
1.1 Recherche d’une faible latence vs Recherche d’un débit élevé
Le processeur de calcul polyvalent (Central Processing Unit) et le processeur de calcul graphique, spécialisé dans le calcul parallèle, ont des philosophies de conception fondamentalement différentes en raison de leur origine. Le processeur de calcul polyvalent a évolué avec comme mission suprême la “faible latence” (minimisation du retard), c’est-à-dire “comment terminer une seule tâche (thread) le plus rapidement possible”. D’un autre côté, le processeur de calcul graphique poursuit un “débit élevé” (maximisation du volume de traitement), à savoir “comment regrouper une quantité massive de tâches et déterminer combien de traitements peuvent être accomplis par unité de temps dans leur ensemble”.
Les processeurs de calcul polyvalents doivent exécuter rapidement des traitements imprévisibles, tels que le contrôle du système d’exploitation, l’exécution d’applications avec des conditions de branchement complexes et la gestion des interruptions aléatoires des utilisateurs. Pour cette raison, ils sont équipés de circuits de prédiction de branchement avancés, d’une exécution dans le désordre (out-of-order execution) et d’immenses mémoires cache L1/L2/L3, maximisant les performances d’un seul thread tout en masquant la latence d’accès à la mémoire.
En revanche, les processeurs de calcul graphiques ont été créés à l’origine pour traiter des tâches hautement parallélisables, comme appliquer la même opération d’ombrage à des millions de pixels à l’écran. Au lieu de consacrer de la surface de puce à des circuits de contrôle complexes ou d’énormes caches, le choix a été fait de compacter un maximum d’unités arithmétiques simples (ALU: Arithmetic Logic Unit) jusqu’à la limite.
1.2 Répartition de la surface de puce entre le cache, les circuits de contrôle et l’ALU
La manière dont est répartie la surface limitée d’une puce de silicium (die) détermine les différences d’architecture entre les deux.
- Répartition de la surface de puce du processeur de calcul polyvalent : Plus de la moitié du die est occupée par une grande mémoire cache (SRAM) et des circuits de contrôle avancés (prédiction de branchement, fetch d’instructions, décodage, ordonnancement, etc.). La proportion occupée par les ALU qui effectuent les calculs réels est relativement faible.
- Répartition de la surface de puce du processeur de calcul graphique : La mémoire cache et les circuits de contrôle sont réduits au strict minimum, et la majeure partie du die est occupée par des milliers voire des dizaines de milliers d’ALU (CUDA cores).
Le processeur de calcul graphique ne masque pas la latence d’accès à la mémoire avec un cache, mais avec le “changement de contexte (context switching)”. Pendant qu’un groupe de threads attend l’arrivée des données de la mémoire, les calculs d’un autre groupe de threads sont exécutés immédiatement, maintenant ainsi les unités de calcul constamment actives (taux d’occupation élevé : occupancy). C’est l’implémentation physique de la “recherche de débit élevé” dans les processeurs de calcul graphiques. Étant donné que le multithreading au niveau matériel (Hardware Multithreading) est effectué de manière extrêmement légère, cela présuppose l’existence de milliers à des dizaines de milliers de threads concurrents.
Supplément du Chapitre 2 : L’essence du modèle d’exécution SIMT
2.1 La différence entre SIMD et SIMT
La taxonomie de Flynn (Flynn’s taxonomy) sert de classification pour le traitement parallèle, mais le modèle d’exécution des processeurs de calcul graphiques est souvent comparé au SIMD (Single Instruction, Multiple Data). Les instructions d’extension vectorielle des processeurs de calcul polyvalents (comme AVX) sont du pur SIMD, traitant simultanément plusieurs données avec une seule instruction (par exemple, 8 nombres à virgule flottante de 32 bits stockés dans un registre de 256 bits). En SIMD, il est très difficile d’effectuer des branchements différents (if-else) pour chaque élément de données.
D’autre part, le modèle d’exécution de CUDA proposé par NVIDIA est appelé SIMT (Single Instruction, Multiple Threads). En SIMT, plusieurs “threads” indépendants forment un groupe (appelé “warp”, détaillé ci-dessous) et exécutent la même instruction en la partageant. Cependant, contrairement au SIMD, chaque thread en SIMT possède un état de registre et un compteur d’adresse d’instruction indépendants (dans le modèle de programmation). Cela permet au programmeur d’écrire du code comme si chaque thread fonctionnait de manière indépendante.
2.2 Le “Warp”, l’unité de 32 threads
Le matériel des processeurs de calcul graphiques ne planifie pas les threads individuellement, mais les gère et les exécute en unités de 32 threads appelées “Warp”. (Dans les processeurs de calcul graphiques AMD, cela s’appelle Wavefront, et des unités de 64 threads sont parfois adoptées).
L’unité de fetch et de décodage des instructions à l’intérieur du Streaming Multiprocessor (SM) récupère une instruction par warp, et émet (dispatch) la même instruction à l’ensemble des 32 threads du warp. Autrement dit, les 32 threads d’un warp exécutent physiquement exactement en même temps, la même instruction, sur des données différentes qui leur sont propres. C’est le cœur du SIMT.
2.3 La pénalité physique de la divergence de warp (Warp Divergence)
Bien que chaque thread puisse se comporter comme s’il possédait un compteur de programme indépendant, physiquement, tous les threads du warp doivent exécuter la même instruction. Que se passe-t-il donc s’il y a un branchement conditionnel tel que if-else dans le code, et que la vérité ou la fausseté de la condition varie selon les threads du warp ?
Ce phénomène est appelé divergence de warp (Warp Divergence).
Lorsqu’une divergence de warp se produit, le matériel procède selon les étapes suivantes :
- Tout d’abord, il exécute l’instruction uniquement pour les threads où la condition
ifest vraie (threads actifs). À ce moment-là, les threads où la condition est fausse sont “masqués” (désactivés), et leurs résultats de calcul ne sont pas écrits. - Ensuite, il passe au chemin de la condition
else(ou le chemin lorsque la condition est fausse), activant cette fois les threads précédemment masqués et masquant les threads qui étaient vrais pour exécuter l’instruction.
En d’autres termes, s’il y a plusieurs chemins de branchement, le matériel est obligé de les exécuter en série plutôt qu’en parallèle. À l’extrême, si 32 threads dans un warp suivent 32 chemins de branchement différents, le temps d’exécution sera multiplié par 32. La divergence de warp est l’un des principaux facteurs de réduction drastique du débit de calcul des processeurs de calcul graphiques, et l’anti-pattern à éviter en priorité lors de la conception d’algorithmes. Physiquement, cela signifie que bien que les ALU consomment de l’énergie, un “cycle inutile” se produit car elles sont masquées et ne génèrent pas de résultats de calcul valides.
Supplément du Chapitre 3 : Anatomie matérielle du Streaming Multiprocessor (SM)
Le processeur de calcul graphique est structuré comme un ensemble de nombreux Streaming Multiprocessors (SM). Le SM est le véritable moteur de calcul du processeur de calcul graphique. Dans les architectures récentes (ex. Hopper H100), une seule puce (die) de processeur de calcul graphique intègre plus de 100 SM.
3.1 La structure du pipeline à l’intérieur du SM
Un SM est subdivisé en plusieurs sous-partitions (généralement 4), chacune possédant un ordonnanceur de warp (warp scheduler) et une unité de dispatch indépendants.
- Warp Scheduler (Ordonnanceur de Warp) : Il sélectionne les warps qui sont dans un état exécutable (les registres et la mémoire sont prêts). L’ordonnanceur du processeur de calcul graphique peut basculer entre les warps avec un overhead de zéro, ce qui est la clé pour masquer la latence d’accès à la mémoire.
- Dispatch Unit (Unité de Dispatch) : Elle émet les instructions aux warps planifiés.
- CUDA Cores (INT32 / FP32 / FP64 ALU) : Les unités qui effectuent les opérations réelles sur les nombres entiers et à virgule flottante.
- Load/Store Unit (Unité LD/ST) : En charge de la lecture et de l’écriture en mémoire.
- Special Function Unit (SFU) : Matériel dédié au calcul rapide des fonctions transcendantes comme sin, cos, exp et l’inverse.
Le pipeline d’instructions est conçu pour être très profond, avec des étapes pour le fetch, le décodage, l’ordonnancement, la lecture des registres, l’exécution (sur plusieurs cycles) et l’écriture des résultats. La latence d’une opération FMA (Fused Multiply-Add) FP32 prend généralement de quelques cycles à une dizaine de cycles, mais en émettant des instructions provenant de warps différents à chaque cycle, le pipeline est maintenu constamment plein.
3.2 L’immense fichier de registres et la pression sur les registres
Le SM est équipé d’un fichier de registres gigantesque, incomparable à celui d’un processeur de calcul polyvalent (ex : 64 Ko à 256 Ko de SRAM par SM). C’est parce qu’il doit conserver tous les contextes des milliers de threads exécutés simultanément sur le SM.
Le changement de contexte se termine en zéro cycle parce qu’il n’est pas nécessaire de sauvegarder (spill) l’état des registres d’un thread dans la mémoire. Cependant, à mesure que le nombre de registres utilisés par thread augmente, le nombre de warps qui peuvent être lancés simultanément dans le SM (l’occupancy) diminue. C’est ce qu’on appelle la pression sur les registres (register pressure). Lorsque les registres s’épuisent, les données sont déversées (spilled) dans la mémoire locale plus lente (physiquement une partie de la mémoire globale), ce qui entraîne une dégradation catastrophique des performances.
3.3 La mémoire partagée (Shared Memory) et les conflits de banques
Le SM dispose d’une mémoire sur puce ultra-rapide et contrôlable explicitement par le programmeur : la mémoire partagée (Shared Memory). Bien qu’elle partage la même région physique de SRAM que le cache L1, elle fonctionne comme un cache de données explicite et est utilisée pour le partage de données et la synchronisation entre les threads d’un bloc.
La structure physique de la mémoire partagée est divisée en plusieurs modules indépendants (généralement 32) appelés banques de mémoire (Memory Banks). Les adresses consécutives de 32 bits sont entrelacées (attribuées) sur différentes banques.
Si les 32 threads d’un warp accèdent simultanément à des banques différentes, l’accès est traité de manière totalement parallèle (en 1 cycle). C’est ce qu’on appelle un accès sans conflit de banque (bank-conflict free). Cependant, si plusieurs threads tentent d’accéder simultanément à des adresses différentes dans la même banque, les requêtes sont sérialisées et une pénalité (latence) se produit. C’est ce qu’on appelle un conflit de banques (Bank Conflict). Par exemple, avec un conflit à 2 voies, le temps d’accès est doublé, et dans le pire des cas, avec un conflit à 32 voies, il est multiplié par 32. Dans des algorithmes tels que la transposition de matrices, l’accès par pas (stride access) provoque de graves conflits de banques, d’où la nécessité d’une optimisation avancée utilisant le “padding” (une technique qui consiste à insérer des données factices pour décaler les adresses mémoire) afin d’éviter ces conflits.
Supplément du Chapitre 4 : Le pipeline d’opérations de multiplication et d’accumulation (MAC) des Tensor Cores
Introduits pour la première fois avec l’architecture Volta, les Tensor Cores sont le matériel révolutionnaire qui a considérablement boosté les performances des processeurs de calcul graphiques par la suite. Le développement explosif de l’IA et du deep learning ne peut être raconté sans mentionner les Tensor Cores.
4.1 Implémentation matérielle de la multiplication matricielle (MMA)
La majorité des calculs en apprentissage profond consiste en des multiplications matricielles (GEMM : General Matrix Multiply) entre les matrices de poids des réseaux de neurones et les données d’entrée. La formule de calcul est $D = A \times B + C$ (où $A, B$ sont les matrices d’entrée et $C$ est la matrice d’accumulation).
Dans les cœurs CUDA traditionnels, cette multiplication matricielle était calculée élément par élément à l’aide de l’instruction FMA (Fused Multiply-Add). En revanche, le Tensor Core est un circuit dédié qui exécute l’opération de multiplication et d’accumulation sur de petites matrices (par exemple 4x4 ou 16x16) au niveau matériel en 1 cycle (ou quelques cycles).
Physiquement, des dizaines à des centaines de multiplicateurs et un gigantesque arbre d’additionneurs sont directement connectés par des fils, réalisant la multiplication et l’accumulation d’un seul coup sans avoir à réécrire les résultats intermédiaires dans les registres. Par conséquent, le débit de calcul par unité de surface (TFLOPS) est infiniment supérieur à celui des cœurs CUDA standard.
4.2 Le secret de la précision mixte (Mixed-Precision)
L’autre grande caractéristique des Tensor Cores est le support du calcul en précision mixte (Mixed-Precision). En apprentissage profond, il y a de nombreuses situations où une précision élevée (FP32/FP64) n’est pas nécessaire pendant le processus de calcul. Les Tensor Cores possèdent un pipeline qui lit les matrices d’entrée $A$ et $B$ en basse précision (FP16, BF16, ou encore plus basse FP8, INT8, INT4), effectue la multiplication interne en basse précision, puis réalise le processus d’addition (accumulation) avec une précision plus élevée (FP32 ou INT32).
- FP16 / BF16 : Le standard pour l’entraînement. BF16 (Bfloat16) possède une partie exposant de 8 bits, identique au FP32, ce qui offre une plage dynamique plus large et permet de prévenir plus facilement la disparition du gradient.
- FP8 / INT8 / INT4 : L’atout maître pour l’accélération de l’inférence (Inference). Étant donné que la quantité de données transférées (bande passante mémoire) est également réduite, le débit est considérablement amélioré.
Dans l’architecture Hopper, le “FP8 Tensor Core” a été introduit, accélérant drastiquement les calculs des modèles Transformer, réalisant théoriquement un débit des dizaines de fois supérieur à celui du FP32. Du côté logiciel (CUDA), les Tensor Cores sont pilotés directement via l’API wmma (Warp-Level Matrix Multiply and Accumulate) et les instructions PTX mma.sync, où les threads d’un warp collaborent pour charger, calculer et stocker des fragments de matrices dans des registres lors d’un traitement collectif extrêmement complexe.
Supplément du Chapitre 5 : Hiérarchie de la mémoire CUDA et techniques d’optimisation
Quelle que soit la puissance de calcul d’un processeur de calcul graphique, si l’approvisionnement en données devient un goulot d’étranglement, les performances ne suivront pas (le problème du mur de la mémoire). Il n’est pas exagéré de dire que 90 % de l’optimisation en programmation CUDA consiste à “optimiser les accès mémoire”.
5.1 Accès coalescé à la mémoire globale
La mémoire globale, qui est la mémoire principale des processeurs de calcul graphiques (HBM ou GDDR), possède une bande passante très large (par exemple plusieurs To/s), mais sa latence est également très élevée, s’élevant à des centaines de cycles.
Le principe absolu pour maximiser l’efficacité de l’accès à la mémoire globale est le coalescing (fusion). Le contrôleur de mémoire du processeur de calcul graphique accède à la mémoire par transactions de 32 octets, 64 octets ou 128 octets. Lorsque les 32 threads d’un warp accèdent à la mémoire, si leurs adresses mémoire se situent dans une région contiguë (dans une limite alignée de 128 octets), le matériel fusionne (coalesce) ces requêtes en une seule transaction mémoire pour les traiter.
Inversement, si les threads accèdent à des adresses aléatoires ou effectuent des accès espacés (avec un pas - stride), la fusion ne se produit pas et plusieurs transactions sont générées. C’est ce qu’on appelle un “accès non-coalescé”, qui constitue un bug de performance fatal pouvant réduire la bande passante mémoire effective à un dixième ou moins.
5.2 Exemple de code CUDA C++ : Optimisation de la transposition de matrice et mémoire partagée
Voici un exemple de code de kernel optimisé pour la transposition de matrice (Matrix Transpose), qui évite les accès non-coalescés et utilise la mémoire partagée pour améliorer considérablement les performances.
| |
Il y a 3 points clés dans ce code :
- Coalescing lors de la lecture : La lecture depuis
idatas’effectuant avecthreadIdx.xen direction X, elle est continue et donc parfaitement coalescée. - Coalescing lors de l’écriture : L’écriture vers
odataest également conçue pour être continue en directionthreadIdx.xen inversant les coordonnées du bloc, ce qui assure le coalescing. - Padding dans la mémoire partagée : En décalant d’un élément (padding) avec
tile[TILE_DIM][TILE_DIM + 1], les conflits de banques sont totalement éliminés lors de l’accès en direction des colonnes (tile[threadIdx.x][threadIdx.y + j]) au moment de l’écriture.
5.3 Hiérarchie de cache et mémoires spéciales
- Politiques de cache L1/L2 : Dans les architectures récentes de processeurs de calcul graphiques, le programmeur peut contrôler le comportement du cache à l’aide d’instructions PTX (comme
.ca,.cg,.cs) fournissant des indices. Par exemple, pour les données qui ne seront accédées qu’une seule fois, il est possible de contourner le cache L2 (streaming access) afin d’éviter la pollution du cache. - Mémoire de texture / Mémoire constante : La mémoire de texture, spécialisée dans le traitement d’images, utilise un cache dédié pour les accès présentant une localité spatiale 2D. La mémoire constante offre une efficacité extrêmement élevée pour les accès par diffusion (broadcast access), où tous les threads lisent la même constante.
Supplément du Chapitre 6 : L’avenir des processeurs de calcul graphiques à l’ère du Deep Learning
La frontière actuelle de la science informatique ne réside pas seulement dans l’amélioration des performances d’un seul processeur de calcul graphique, mais dans la mise à l’échelle (scaling) du système dans son ensemble.
6.1 Interconnexion ultra-rapide avec NVLink et NVSwitch
Les immenses LLM (Grands Modèles de Langage) ne peuvent plus tenir dans la mémoire d’un seul processeur de calcul graphique (par exemple 80 Go ou 144 Go). Pour effectuer un parallélisme de modèles (Tensor Parallel ou Pipeline Parallel), il est nécessaire d’échanger des téraoctets de données par seconde entre les processeurs de calcul graphiques. Étant donné que le bus PCIe (PCI Express) traditionnel ne peut fournir cette bande passante, NVIDIA a développé sa propre interconnexion haut débit appelée NVLink. De plus, en utilisant une puce de commutation appelée NVSwitch, il est devenu possible de construire des clusters où 8 ou 256 processeurs de calcul graphiques sont connectés par un commutateur crossbar totalement non bloquant, se comportant ainsi comme un seul gigantesque processeur de calcul graphique.
6.2 Transformer Engine et l’écosystème FP8
Afin d’optimiser l’architecture Transformer, qui est devenue la norme de facto non seulement pour le traitement du langage naturel, mais aussi pour la reconnaissance d’images et vocale, l’architecture Hopper a intégré un mécanisme de coordination matérielle et logicielle dédié appelé Transformer Engine. Ce système surveille dynamiquement les statistiques des tenseurs et bascule automatiquement la précision des calculs entre FP8 et FP16 couche par couche (Dynamic Scaling). Cela permet d’obtenir des vitesses de calcul extrêmes et de réaliser des économies de bande passante mémoire tout en prévenant la dégradation de la précision.
6.3 Lois d’échelle (Scaling Laws) des clusters de processeurs de calcul graphiques et perspectives d’avenir
Comme le démontrent les “Scaling Laws” (Lois d’échelle) d’OpenAI, les performances de l’IA continuent de s’améliorer à mesure que l’on augmente le nombre de paramètres et la quantité de calculs d’un modèle. Par conséquent, les processeurs de calcul graphiques sont passés du statut de simples processeurs à celui de centres de données entiers interconnectés par des milliers de fibres optiques, fonctionnant comme “un seul gigantesque processeur de calcul graphique (superordinateur)”.
Les évolutions futures de l’architecture s’orienteront très probablement vers l’introduction de la photonique sur silicium (interconnexions optiques), du CPO (Co-Packaged Optics) et vers des niveaux plus avancés de technologie d’empilement 3D (de SRAM à HBM). Cependant, “la maximisation du débit par le traitement parallèle”, cet ADN immuable des processeurs de calcul graphiques depuis leur naissance, continuera à ouvrir la voie à l’avant-garde de la science informatique.
Conclusion : Vers le pôle nord de la science informatique
L’architecture du GPU est le moteur de calcul le plus complexe jamais créé par l’humanité, et le plus spécialisé dans le débit (throughput). Si le CPU est comparable à “une seule voiture de Formule 1 ultra-performante”, le GPU peut être comparé à “un gigantesque système logistique où des dizaines de milliers de camions-bennes transportent des marchandises simultanément de manière coordonnée”.
L’exécution des instructions par warp via le SIMT, l’ordonnancement matériel qui bascule entre des milliers de threads en zéro cycle, l’accès coalescé qui exploite la bande passante jusqu’à ses limites, et le pipeline des Tensor Cores qui a conduit aux percées du deep learning. Tout cela est le fruit de la détermination, presque folle, des ingénieurs pour répondre à la question : “Comment maximiser le volume total d’opérations en virgule flottante dans le cadre des limites des lois physiques (vitesse de la lumière, chaleur, électricité, limites de miniaturisation du silicium)”.
Pour les futurs ingénieurs logiciels, chercheurs en IA et en calcul haute performance (HPC), comprendre l’architecture des GPU n’est pas qu’une simple culture générale. C’est une “matière obligatoire” pour saisir intuitivement ce qui se passe derrière les frameworks (comme PyTorch ou TensorFlow) et pour exploiter au maximum les capacités du matériel. Éviter les conflits de banques mémoire, éliminer la divergence de warp, et maintenir le pipeline des Tensor Cores rempli de données. Au bout de cette optimisation, le futur où des calculs qui prenaient des mois sur des superordinateurs se terminent en quelques heures sur quelques GPU sur un bureau, devient maintenant réalité.
Nous vivons actuellement l’âge d’or de l’architecture informatique la plus passionnante de l’histoire de l’humanité. Comprendre l’essence de la physique de CUDA et de l’architecture massivement parallèle des GPU, et donner naissance aux innovations de la prochaine génération, ce pourrait être vous, en lisant cet article.
Glossaire des termes techniques (Glossary)
- SM (Streaming Multiprocessor) : Le principal bloc de calcul du GPU. Équivalent d’un cœur dans un CPU, mais il contient en interne de nombreux cœurs CUDA, un ordonnanceur de warp, de la mémoire partagée, etc.
- SIMT (Single Instruction, Multiple Threads) : Modèle d’exécution spécifique au GPU où tous les threads d’un warp partagent la même instruction tout en effectuant des calculs sur des données indépendantes.
- Warp : Un ensemble de 32 threads. L’unité minimale d’ordonnancement matériel et d’émission d’instructions.
- Warp Divergence (Divergence de warp) : Phénomène où les conditions de branchement diffèrent entre les threads d’un warp, entraînant une sérialisation des chemins d’exécution et une baisse du débit.
- Tensor Core (Cœur Tenseur) : Circuit dédié qui traite d’un coup, au niveau matériel, les opérations de multiplication et d’accumulation (MMA). Spécialisé pour l’accélération de l’apprentissage profond.
- Coalesced Access (Accès coalescé) : Mécanisme où le matériel combine les accès en une seule transaction lorsque les threads d’un warp accèdent à des adresses mémoire contiguës, permettant d’obtenir une bande passante élevée.
- Shared Memory (Mémoire partagée) : Mémoire de travail L1 ultra-rapide, contrôlable par le programmeur, intégrée à l’intérieur du SM.
- Bank Conflict (Conflit de banques) : Pénalité dans la mémoire partagée où plusieurs threads accèdent simultanément à des adresses différentes de la même banque, entraînant une sérialisation de l’accès.
- Occupancy (Taux d’occupation) : Le rapport réel par rapport au nombre maximal théorique de warps pouvant être actifs simultanément sur un SM. Plus il est élevé, plus il est facile de masquer la latence d’accès à la mémoire.
- Register Spilling (Débordement de registres) : Phénomène où le nombre de registres utilisés par un thread dépasse la limite matérielle, et où les données excédentaires sont sauvegardées dans une mémoire plus lente (mémoire locale).
Références et liste de lecture recommandée
- NVIDIA CUDA C++ Programming Guide : Le document officiel que tout programmeur CUDA doit impérativement lire. Il couvre les modèles d’accès mémoire et les meilleures pratiques d’optimisation.
- NVIDIA Ampere / Hopper Architecture Whitepaper : Livre blanc officiel décrivant les détails du pipeline des Tensor Cores, des transferts de mémoire asynchrones et de l’implémentation matérielle du Transformer Engine.
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson) : Un chef-d’œuvre classique de l’architecture informatique. Il permet d’apprendre en profondeur les différences de philosophie de conception entre le CPU et le GPU, la hiérarchie des caches et le parallélisme au niveau des instructions.
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu) : Un manuel expliquant la programmation CUDA sous l’angle de la conception d’algorithmes. Il détaille l’implémentation de techniques de tuilage (tiling) avec la mémoire partagée, les réductions et les préfixes sommes (prefix sum).
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking : Un article académique. Un chef-d’œuvre qui a révélé, par des microbenchmarks, les latences des caches et le débit précis des Tensor Cores non divulgués par NVIDIA.
Bien que certaines des connaissances architecturales expliquées dans cet article puissent devenir obsolètes avec l’évolution du matériel, le principe physique fondamental de “maximiser la bande passante, extraire le parallélisme et masquer la latence” continuera de perdurer comme une vérité universelle de l’informatique.