Introduction
En informatique, il est extrêmement important de détecter la présence d’un éventuel « cycle » inattendu dans une structure de données afin d’éviter les boucles infinies. L’une des méthodes les plus élégantes pour résoudre ce problème est l’algorithme de détection de cycle de Robert Floyd (Floyd’s cycle-finding algorithm).
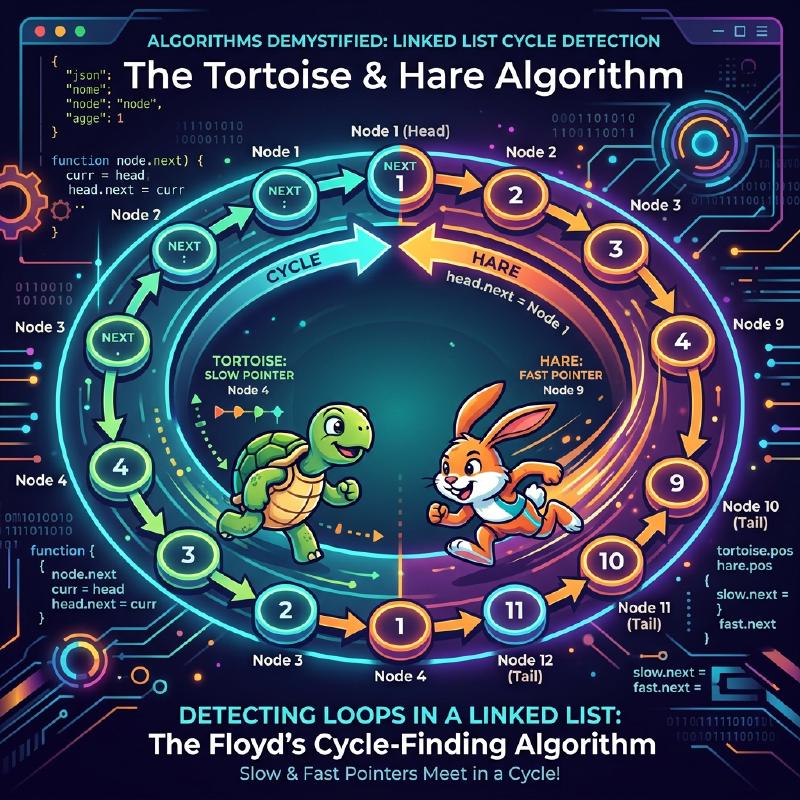
Cet algorithme utilise deux pointeurs qui se déplacent à des vitesses différentes (souvent appelés le « lièvre » et la « tortue ») et est donc largement connu sous le nom d’algorithme du lièvre et de la tortue (Tortoise and Hare Algorithm).
Cet article explique en détail le fonctionnement de cet algorithme, ses fondements mathématiques, ainsi que des exemples concrets d’implémentation en C++ et en Rust.
Qu’est-ce que la détection de cycle ?
Dans une liste chaînée simple (Singly Linked List) ou un graphe de transition d’états, si l’on parcourt les nœuds à partir d’un certain point et que l’on atteint de nouveau un nœud déjà visité, cette structure forme ce qu’on appelle un cycle.
Prenons l’exemple de la liste chaînée ci-dessous.
  graph LR
    subgraph "Boucle de liste chaînée"
        A["Node 1"] -->|"next"| B["Node 2"]
        B -->|"next"| C["Node 3"]
        C -->|"next"| D["Node 4"]
        D -->|"next"| E["Node 5"]
        E -->|"next"| C
    end
Dans cette liste, le nœud qui suit Node 5 est Node 3, formant ainsi une boucle : 3 → 4 → 5 → 3. Un programme qui se contenterait de parcourir séquentiellement cette liste s’enliserait dans cette boucle, provoquant une boucle infinie.
Une façon de résoudre ce problème serait d’enregistrer les nœuds visités dans un ensemble de hachage (par exemple, std::unordered_set). Cependant, cette méthode nécessite un espace mémoire supplémentaire de $O(N)$, proportionnel au nombre de nœuds. L’algorithme de détection de cycle de Floyd permet, lui, de détecter un cycle en un temps de $O(N)$ tout en maintenant l’espace mémoire à $O(1)$.
Le fonctionnement de l’algorithme du lièvre et de la tortue
L’idée de l’algorithme est très intuitive. Imaginez deux coureurs sur la même piste qui courent à des vitesses différentes. Si la piste est une ligne droite, le coureur rapide laissera le coureur lent derrière lui. En revanche, si la piste comporte un circuit fermé (un cycle), le coureur rapide finira par avoir « un tour d’avance » et rattrapera le coureur lent par derrière.
Plus précisément, on utilise les deux pointeurs suivants :
- La tortue (Tortoise) : Avance d’un nœud à chaque étape.
- Le lièvre (Hare) : Avance de deux nœuds à chaque étape.
Si on les fait démarrer en même temps, et que le lièvre atteint la fin (null), il n’y a pas de cycle. S’il existe un cycle, le lièvre et la tortue finiront inévitablement par pointer sur le même nœud à un moment donné.
Schéma du fonctionnement
Considérons le graphe suivant avec un cycle.
  graph LR
    subgraph "Détection de cycle"
        1((1)) -->|"step"| 2((2))
        2 -->|"step"| 3((3))
        3 -->|"step"| 4((4))
        4 -->|"step"| 5((5))
        5 -->|"step"| 6((6))
        6 -->|"loop"| 3
    end
Le déplacement des pointeurs à chaque étape se déroule ainsi : (* Tortue = $T$, Lièvre = $H$)
- Étape 0 : $T=1$, $H=1$
- Étape 1 : $T=2$, $H=3$
- Étape 2 : $T=3$, $H=5$
- Étape 3 : $T=4$, $H=3$
- Étape 4 : $T=5$, $H=5$ (Ici ils coïncident, cycle détecté !)
Preuve mathématique et détermination du point de départ du cycle
Nous allons prouver mathématiquement que l’algorithme provoque inévitablement une collision, et expliquer comment déterminer le point de départ du cycle (l’intersection).
Soit $x$ la distance entre le début de la liste et le point de départ du cycle. Soit $y$ la distance entre le point de départ du cycle et le point où les deux pointeurs entrent en collision. Soit $z$ la distance du point de collision pour revenir au point de départ du cycle. Par conséquent, la longueur totale du cycle est $C = y + z$.
Lorsque la tortue et le lièvre entrent en collision, leurs distances parcourues sont les suivantes :
- Distance de la tortue : $d_T = x + y$
- Distance du lièvre : $d_H = x + y + kC$ ($k$ étant le nombre de tours de cycle effectués par le lièvre)
Puisque le lièvre se déplace deux fois plus vite que la tortue, l’équation suivante est vérifiée :
$$ 2 \cdot d_T = d_H $$$$ 2(x + y) = x + y + kC $$$$ x + y = kC $$$$ x = kC - y $$$$ x = k(y + z) - y $$$$ x = (k - 1)(y + z) + z $$$$ x = (k - 1)C + z $$Cette équation $x = (k - 1)C + z$ a une signification très importante. Ici, $k - 1$ est un entier positif ou nul. Elle indique que « la distance $x$ du début de la liste au point de départ du cycle » est égale à « la distance restante $z$ du point de collision au point de départ du cycle », plus un multiple entier de la longueur du cycle $C$ (soit $(k-1)C$).
En d’autres termes, juste après la collision, si vous replacez un pointeur au début de la liste, et laissez l’autre au point de collision, puis que vous avancez les deux pointeurs d’un seul pas à la fois, ils se rencontreront obligatoirement au point de départ du cycle. Pourquoi ? Parce que pendant que le pointeur partant du début parcourt la distance $x$ pour atteindre le point de départ du cycle, le pointeur partant du point de collision parcourt la distance $z$ pour y arriver, et fait ensuite $(k-1)$ tours complets de cycle. En fin de compte, ils arrivent exactement au même moment au point de départ du cycle et se rejoignent.
Implémentation du code
Implémentons maintenant la théorie ci-dessus en C++ et en Rust.
Implémentation en C++
Voici la structure du nœud d’une liste chaînée simple, ainsi que la fonction permettant de détecter s’il y a un cycle, et celle pour trouver le nœud de départ du cycle.
| |
Implémentation en Rust
En Rust, les règles de possession (ownership) et d’emprunt (borrowing) rendent souvent l’implémentation de listes chaînées complexe. Cependant, il est fréquent en programmation compétitive de modéliser cela comme un problème de référence d’indices sur un tableau (ou Vec).
Voici un exemple d’implémentation utilisant un tableau dont les valeurs représentent l’« indice suivant » plutôt qu’un pointeur vers le nœud suivant.
| |
Analyse de la complexité
Cet algorithme présente de très bonnes caractéristiques de performance.
- Complexité temporelle : $O(N)$ Le lièvre se déplace au maximum de $N$ étapes avant d’entrer dans le cycle, et une fois dans le cycle, il effectue au maximum $C$ (la longueur du cycle) étapes avant de rattraper la tortue. Comme $C \le N$, le nombre total d’étapes reste en temps linéaire.
- Complexité spatiale : $O(1)$ Il n’est pas nécessaire de stocker les nœuds visités dans une structure comme un ensemble de hachage. Seuls deux pointeurs doivent être maintenus, ce qui limite l’utilisation de mémoire supplémentaire à un espace constant.
Autres applications
L’algorithme de détection de cycle de Floyd ne se limite pas aux listes chaînées, mais est également appliqué à d’autres algorithmes.
- L’algorithme de factorisation rho ($\rho$) de Pollard : C’est un algorithme pour trouver efficacement les facteurs premiers d’un grand nombre composite, en exploitant le fait que la séquence de sortie d’un générateur de nombres aléatoires finit par entrer dans un cycle. Il s’agit d’un puissant algorithme de factorisation, très utilisé en cryptographie.
- Détection du nombre dupliqué (Find the Duplicate Number) :
Supposons par exemple qu’il existe un tableau de taille $N+1$ dont les éléments sont compris entre $1$ et $N$. D’après le principe des tiroirs de Dirichlet (ou principe des pigeons), au moins un nombre est dupliqué en double. En considérant les éléments du tableau comme des « pointeurs vers l’indice suivant », on peut conserver une complexité spatiale de $O(1)$ et détecter le doublon en cherchant le point de départ du cycle. C’est un exercice fréquent dans les entretiens de programmation sur LeetCode, etc.
Concrètement, si on a un tableau
nums, la transition d’état est définie parnext_node = nums[current_node]. La présence d’une valeur dupliquée signifie qu’il y a des transitions menant à la même valeur (donc au même nœud suivant) à partir d’indices différents, formant l’entrée du cycle. Ainsi, en appliquant directement l’algorithme du lièvre et de la tortue, on peut déterminer la valeur dupliquée (le point de départ du cycle) avec une complexité temporelle $O(N)$ et spatiale $O(1)$.
  graph TD
    subgraph "Applications de l'algorithme de Floyd"
        A["Applications"] -->|"Liste chaînée"| B["Détection de cycle"]
        A -->|"Théorie des nombres"| C["Rho de Pollard"]
        A -->|"Problèmes de tableau"| D["Détection de doublons"]
    end
Résumé
Dans cet article, nous avons expliqué l’Algorithme de détection de cycle de Robert Floyd (Algorithme du lièvre et de la tortue). C’est une méthode élégante qui permet la détection d’un cycle et l’identification de son point de départ en un temps $O(N)$ et avec un espace $O(1)$, grâce à l’idée simple de faire courir deux pointeurs à des vitesses différentes. La démonstration mathématique permet de comprendre clairement pourquoi en replaçant un pointeur au début après la collision, et en les faisant avancer à la même vitesse, on peut trouver le point de départ.
Lors de la mise en œuvre de structures de données et lors de la programmation compétitive, cet algorithme est une arme très puissante. N’hésitez pas à vous exercer à l’implémenter en C++ ou en Rust.