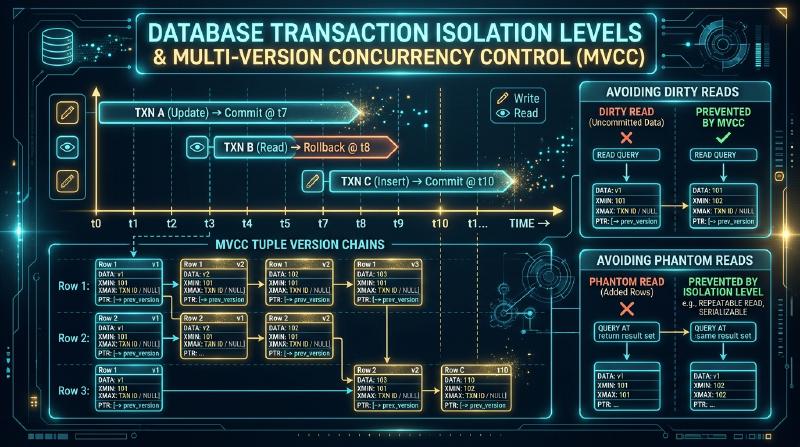
Niveaux d’isolement des transactions de base de données et MVCC : la réalité d’ACID et le contrôle de concurrence multiversion
Dans l’architecture logicielle moderne, les systèmes de gestion de bases de données relationnelles (SGBDR) continuent d’être la pierre angulaire de la persistance des données. Au cœur de ceux-ci se trouve le concept de « transaction », et en particulier les propriétés ACID (Atomicité, Cohérence, Isolement, Durabilité) qui sont largement reconnues comme la théorie fondamentale pour la construction de systèmes robustes. Cependant, parmi les propriétés ACID, l’« Isolement » (Isolation) est le domaine où la divergence entre la théorie et la pratique est la plus grande.
Dans cet article, nous explorerons en profondeur, d’un point de vue extrêmement détaillé, académique et pratique, le contexte historique des niveaux d’isolement des transactions de base de données, les limites de la norme ANSI SQL-92, et la structure interne du Multi-Version Concurrency Control (MVCC : Contrôle de concurrence multiversion) adopté par les moteurs de bases de données modernes. En particulier, nous décortiquerons les différences décisives dans l’implémentation du MVCC entre les deux principaux SGBDR open source, PostgreSQL et MySQL (InnoDB), et nous couvrirons l’avant-garde des bases de données distribuées jusqu’à l’isolement de snapshot sérialisable (SSI), dans cette œuvre monumentale de plus de 12 000 caractères.
Chapitre 1 : Le mythe des propriétés ACID et le dilemme du traitement concurrent
1.1 L’idéal de la sérialisabilité (Serializability)
L’idéal ultime visé par l’isolement des transactions est la « sérialisabilité » (Serializability). Il s’agit de la propriété selon laquelle, même si plusieurs transactions sont exécutées simultanément et en parallèle, le résultat de leur exécution « équivaut au résultat si les transactions avaient été exécutées en série (l’une après l’autre) dans un certain ordre ».
Lorsque les transactions $T_1$ et $T_2$ s’exécutent simultanément sur un système, peu importe l’entrelacement (le croisement des opérations) qui se produit en raison de l’exécution concurrente, si l’état final de la base de données correspond parfaitement au résultat d’une exécution dans l’ordre « $T_1 \rightarrow T_2$ » ou « $T_2 \rightarrow T_1$ », alors cette planification est définie comme sérialisable. Si cette sérialisabilité est garantie, les développeurs d’applications peuvent se concentrer sur la construction de la logique métier sans se soucier des incohérences de données (conditions de concurrence, écrasements inappropriés, etc.) causées par le traitement concurrent.
1.2 L’effondrement des performances dû à la sérialisation par verrouillage
Dans les premiers systèmes de base de données, un mécanisme de verrouillage strict appelé « verrouillage en deux phases » (2PL : Two-Phase Locking) a été adopté pour garantir cette sérialisabilité. Dans le 2PL, une transaction doit toujours acquérir un verrou (verrou partagé ou verrou exclusif) avant de lire ou d’écrire des données (Phase 1 : Growing Phase), et libère tous les verrous à la fin de la transaction (lors du commit ou du rollback) (Phase 2 : Shrinking Phase).
Cependant, ce mécanisme de verrouillage strict présentait un défaut fatal : une « dégradation extrême des performances ».
- Les opérations de lecture bloquent les opérations d’écriture.
- Les opérations d’écriture bloquent les opérations de lecture.
- Une augmentation des temps d’attente due à la contention des verrous et une fréquence élevée d’interblocages (deadlocks).
À mesure que le trafic augmentait et qu’un grand nombre d’utilisateurs accédaient simultanément à la base de données, la sérialisation complète par le 2PL devenait un goulot d’étranglement pour le système, et le débit chutait de façon spectaculaire. Le système était confronté au dilemme d’un compromis entre l’« intégrité des données » et les « performances de traitement concurrent (débit) ».
1.3 L’histoire et les compromis du contrôle de concurrence
Pour résoudre ce dilemme, les chercheurs en ingénierie des bases de données ont introduit le concept de « niveau d’isolement » (Isolation Level). Il s’agit d’un « produit de compromis » qui assouplit partiellement la garantie de sérialisabilité complète et tolère l’occurrence de certaines incohérences de données (anomalies) en échange d’une amélioration des performances de traitement concurrent. Ils ont permis de choisir un équilibre entre l’intégrité et les performances en fonction des exigences de l’application.
Chapitre 2 : Les niveaux d’isolement de la norme ANSI SQL-92 et leurs critiques
2.1 Définition des niveaux d’isolement selon la norme ANSI SQL-92
Dans la norme SQL « SQL-92 » établie en 1992, 4 niveaux d’isolement ont été définis sur la base de 3 anomalies représentatives (Phenomena) susceptibles de se produire en raison du traitement concurrent.
Les 3 anomalies définies (Phenomena)
- Dirty Read (Lecture sale) : Phénomène où une transaction $T_1$ met à jour des données et, avant même qu’elle ne soit validée (commit), une autre transaction $T_2$ lit ces données non validées. Si $T_1$ est annulée (rollback), $T_2$ aura lu des données fantômes qui n’existent pas.
- Non-repeatable Read (Lecture non répétable) : Phénomène où, pendant qu’une transaction $T_1$ lit la même ligne deux fois, une autre transaction $T_2$ met à jour cette ligne et valide. Le résultat de la première et de la deuxième lecture de $T_1$ sera différent.
- Phantom Read (Lecture fantôme) : Phénomène où, pendant qu’une transaction $T_1$ lit plusieurs lignes avec une condition de recherche spécifique, une autre transaction $T_2$ insère (ou supprime) une nouvelle ligne qui correspond à cette condition et valide. Si $T_1$ effectue à nouveau la recherche avec la même condition, le nombre de lignes augmentera ou diminuera.
Les 4 niveaux d’isolement selon SQL-92
SQL-92 a défini les niveaux d’isolement en fonction du degré de prévention de l’apparition de ces anomalies.
- Read Uncommitted : Tolère les lectures sales.
- Read Committed : Empêche les lectures sales, mais tolère les lectures non répétables et les lectures fantômes.
- Repeatable Read : Empêche les lectures sales et les lectures non répétables, mais tolère les lectures fantômes.
- Serializable : Empêche toutes les anomalies et garantit une sérialisabilité complète.
2.2 L’article critique « A Critique of ANSI SQL Isolation Levels » de Berenson et al.
La définition de la norme SQL-92 semble à première vue très claire et logique. Cependant, l’article « A Critique of ANSI SQL Isolation Levels » publié en 1995 par des géants du monde des bases de données tels que Hal Berenson, Jim Gray (lauréat du prix Turing) et Phil Bernstein, a porté un coup dévastateur à cette définition de la norme ANSI.
Les principales failles de la norme SQL-92 signalées dans cet article sont les suivantes :
1. Prémisse implicite basée sur les verrous
La définition de SQL-92 supposait implicitement que « la base de données est implémentée avec un contrôle de concurrence basé sur les verrous (2PL) ». Cependant, dans les années 1990, des bases de données adoptant le MVCC (décrit ci-dessous) et d’autres contrôles de concurrence optimistes (OCC) commençaient déjà à apparaître, et la définition des anomalies basée sur les verrous devenait obsolète.
2. Ambiguïté et incomplétude de la définition
Il a été souligné que les 3 anomalies définies dans SQL-92 (Dirty Read, Non-repeatable Read, Phantom Read) ne couvraient pas à elles seules toutes les anomalies pouvant survenir lors du traitement concurrent. Par exemple, il y a le phénomène de « Dirty Write » (Écriture sale). C’est un phénomène où les données écrites par une transaction non validée sont écrasées par une autre transaction non validée, mais la norme SQL-92 ne mentionne pas le Dirty Write. Bien que tous les niveaux d’isolement (y compris Read Uncommitted) doivent empêcher le Dirty Write (sinon l’intégrité interne de la base de données s’effondre), la norme ne l’a pas abordé.
3. Découverte de nouvelles anomalies
L’article a défini plusieurs nouvelles anomalies qui n’existent pas dans la norme SQL-92. Les deux plus représentatives sont les suivantes :
- Lost Update (Mise à jour perdue) : Phénomène où deux transactions lisent simultanément les mêmes données, et lorsque chacune écrit son résultat de calcul, une mise à jour écrase et efface l’autre mise à jour.
- Write Skew (Asymétrie d’écriture) : Un phénomène spécifique à l’isolement de snapshot décrit ci-dessous.
L’article de Berenson et al. a prouvé que la norme SQL-92 n’a pas réussi à définir mathématiquement et rigoureusement les niveaux d’isolement, et a eu un impact énorme sur l’industrie des bases de données. Dans la théorie actuelle des bases de données, la définition des niveaux d’isolement de la norme ANSI SQL-92 est traitée comme « quelque chose à apprendre en tant que contexte historique » et « insuffisante en tant que définition technique stricte ».
Chapitre 3 : L’isolement de snapshot (Snapshot Isolation) et le Write Skew
3.1 Différence entre Repeatable Read et l’isolement de snapshot
Ce qui a particulièrement attiré l’attention dans l’article de Berenson et al. est la proposition d’un nouveau niveau d’isolement appelé « Isolement de snapshot » (Snapshot Isolation : SI).
Dans de nombreuses bases de données qui adoptent le MVCC (comme PostgreSQL ou Oracle), la réalité du niveau d’isolement fourni sous le nom de « Repeatable Read » est en fait cet « isolement de snapshot ». Dans l’isolement de snapshot, chaque transaction lit depuis un « snapshot » (un état statique passé) cohérent de la base de données au moment du début de la transaction.
- Les mises à jour effectuées par d’autres transactions après le début de la transaction ne sont pas du tout visibles (prévention des lectures non répétables).
- Comme l’existence même des enregistrements est fixée à un point du passé, les INSERT effectués par d’autres transactions ne sont pas non plus visibles (prévention des lectures fantômes).
En d’autres termes, l’isolement de snapshot ne satisfait pas seulement aux exigences de « Repeatable Read » définies par SQL-92, mais dans de nombreux cas, il empêche même les « lectures fantômes ». Alors, l’isolement de snapshot est-il équivalent à « Serializable » ? La réponse est « Non ». Car l’isolement de snapshot présente une anomalie fatale non sérialisable appelée « Write Skew » (Asymétrie d’écriture).
3.2 Le problème du médecin de garde et le Write Skew
L’exemple le plus célèbre pour comprendre le Write Skew est le « système de garde (on-call) des médecins ».
【Règle métier】 Supposons qu’il y ait un système de gestion des gardes dans un hôpital avec la règle suivante : « Au moins un médecin doit toujours être en état de garde (on-call) ».
Actuellement, deux médecins, Alice et Bob, sont de garde (on_call = true).
À ce moment, Alice et Bob pensent par coïncidence au même moment « Je ne me sens pas bien, je veux me retirer de la garde », et lancent chacun une transaction de changement de garde depuis leur terminal.
【Déroulement de la transaction (sous isolement de snapshot)】
- [Tx1: Alice] Obtient un snapshot. Confirme qu’actuellement, il y a 2 personnes de garde : Alice et Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Résultat : 2 - [Tx2: Bob] Obtient un snapshot. Confirme également qu’il y a 2 personnes : Alice et Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Résultat : 2 - [Tx1: Alice] Juge que la règle (au moins 1 personne de garde) est remplie, et se retire elle-même de la garde.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] Juge également que la règle est remplie, et se retire lui-même de la garde.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] Commit réussi.
- [Tx2: Bob] Commit réussi. (Puisqu’Alice et Bob mettent à jour des enregistrements différents, les verrous de ligne n’entrent pas en conflit)
【Résultat】 À la suite de la validation de Tx1 et Tx2, le nombre de médecins de garde est passé à « 0 ». La règle métier s’est effondrée.
C’est ce qu’on appelle le Write Skew. S’il était sérialisable (Serializable), soit Tx1 soit Tx2 aurait été exécuté en série en premier, la transaction exécutée ultérieurement aurait détecté que le nombre de personnes de garde était de « 1 », et aurait dû avorter (rollback) l’opération de retrait. Cependant, dans l’isolement de snapshot, comme ils mettent à jour des lignes de données différentes (la ligne d’Alice et la ligne de Bob), le conflit n’est pas détecté, ce qui entraîne une incohérence de la règle métier.
3.3 ReadOnly Anomaly (Anomalie en lecture seule)
De plus, l’isolement de snapshot présente également une anomalie extrêmement particulière appelée ReadOnly Anomaly, où la sérialisabilité est brisée par l’intervention d’une « transaction en lecture seule ».
Cette anomalie, démontrée par des exemples tels que le solde d’un compte bancaire et l’ajout d’intérêts, est un phénomène où, bien qu’il n’y ait pas de conflit entre les transactions de mise à jour, une transaction en lecture seule regardant un snapshot passé lit un « état de la ligne temporelle logiquement impossible ». En raison de la présence de ces anomalies, l’isolement de snapshot se distingue du Serializable au sens strict.
Chapitre 4 : Le principe de fonctionnement du MVCC (Multi-Version Concurrency Control)
Jusqu’à présent, nous avons décrit la théorie et les anomalies des niveaux d’isolement, mais comment les bases de données modernes les contrôlent-elles ? La technologie de base est le MVCC (Multi-Version Concurrency Control : Contrôle de concurrence multiversion).
4.1 « La lecture ne bloque pas l’écriture, et l’écriture ne bloque pas la lecture »
La plus grande philosophie de conception du MVCC, et ce qui diffère de manière décisive du contrôle basé sur les verrous (2PL), est que « la lecture et l’écriture ne se bloquent pas mutuellement ». Lors de la mise à jour d’un enregistrement, la base de données MVCC n’écrase pas directement l’enregistrement existant (In-place update). Au lieu de cela, elle crée une nouvelle version de l’enregistrement (version / tuple) et conserve l’ancienne version de l’enregistrement en même temps.
Il y aura plusieurs versions du même enregistrement (un historique du passé au présent) existant simultanément dans la base de données. Lorsqu’une transaction lit des données, elle calcule et lit la « bonne version passée qu’elle doit lire » parmi les nombreuses versions existant dans le système, sur la base de son propre « ID de transaction (XID) » ou de son « heure de début (horodatage) ».
Ainsi, même si une transaction est en train de réécrire un enregistrement, les autres transactions peuvent lire la « version passée avant réécriture », évitant ainsi l’attente causée par les verrous.
4.2 Chaîne de gestion des versions des tuples et règles de visibilité (Visibility)
L’algorithme le plus important du MVCC est la règle de visibilité (Visibility Rule), qui détermine « quelle transaction peut voir quelle version des données ».
Chaque transaction se voit attribuer un ID de transaction (XID) unique et croissant de façon monotone à son démarrage. Chaque version (tuple) d’un enregistrement stocké dans la base de données se voit attribuer les informations suivantes en tant que métadonnées :
- XID de création : L’ID de la transaction qui a créé cette version via un INSERT/UPDATE.
- XID de suppression : L’ID de la transaction qui a supprimé (invalidé) logiquement cette version via un UPDATE/DELETE.
Lorsqu’une transaction $T_i$ lit une ligne de données, elle évalue la visibilité en fonction des règles de base suivantes :
- Est-ce validé (commit) ? : La transaction du XID de création a-t-elle déjà été validée ?
- N’est-ce pas dans le futur ? : Le XID de création appartient-il à une transaction antérieure au démarrage de $T_i$ ?
- N’a-t-il pas été supprimé ? : Aucun XID de suppression n’est défini, ou la transaction du XID de suppression n’a pas encore été validée, ou elle appartient à une transaction dans le futur par rapport au démarrage de $T_i$ ?
En évaluant rigoureusement ces conditions, un snapshot cohérent est fourni à chaque transaction.
Chapitre 5 : La différence décisive dans l’implémentation MVCC entre PostgreSQL et MySQL (InnoDB)
Bien que la philosophie de base du MVCC soit la même, son implémentation interne varie considérablement d’un produit de base de données à l’autre. Nous comparerons et décortiquerons ici l’architecture MVCC de PostgreSQL et de MySQL (InnoDB), les deux piliers du monde de l’open source.
5.1 L’implémentation MVCC de PostgreSQL : L’ajout en fin de tas (Heap) et l’inévitabilité de VACUUM
Le MVCC de PostgreSQL adopte une « architecture d’ajout uniquement (Append-only) » très unique et intuitive.
5.1.1 Logique de détermination des bits via xmin et xmax
Dans le fichier de données (heap) qui constitue l’entité de la table dans PostgreSQL, deux ID de transaction, xmin et xmax, sont enregistrés dans l’en-tête de chaque ligne (tuple).
xmin(Transaction ID of Insert) : Le XID de la transaction qui a créé ce tuple.xmax(Transaction ID of Delete) : Le XID de la transaction qui a supprimé (ou supprimé logiquement une ancienne version par mise à jour) ce tuple.
【Comportement de l’opération UPDATE】
Dans PostgreSQL, UPDATE est logiquement traité comme une combinaison de DELETE et de INSERT.
- Écrit le XID de la transaction en cours dans le
xmaxde l’ancien tuple. (Suppression logique) - Crée un tout nouveau tuple dans l’espace libre du heap, y écrit les nouvelles données, et définit le XID de la transaction en cours dans
xmin. (Nouvel ajout)
En d’autres termes, les anciens et les nouveaux tuples sont mélangés et stockés dans le même fichier de données de table (heap).
5.1.2 Un énorme avantage et un problème fatal : L’existence de VACUUM
Le plus grand avantage de cette architecture est que le rollback est extrêmement rapide. Si une transaction est avortée, il suffit de traiter les tuples ajoutés comme « non validés », ce qui rend inutile le processus de réécriture des données.
Cependant, le problème fatal est le « gonflement des tuples inutiles (Dead Tuples) ».
Si vous répétez les UPDATE et les DELETE, les anciennes versions des tuples qui ne sont plus référencées par personne (tuples dont le xmax est devenu l’ID d’une ancienne transaction validée) s’accumuleront à l’infini dans le heap. Si on les laisse tels quels, la taille physique de la table augmentera de façon explosive, et les performances des analyses séquentielles chuteront de façon catastrophique.
Le processus système visant à supprimer physiquement ces tuples inutiles et à rendre l’espace libre réutilisable est VACUUM (ainsi que le démon autovacuum exécuté automatiquement). La raison pour laquelle le réglage de VACUUM est considéré comme extrêmement important dans l’exploitation de PostgreSQL provient du cœur de cette architecture MVCC.
5.2 L’implémentation MVCC de MySQL InnoDB : Mise à jour sur place (In-place update) et reconstruction dynamique via Undo log
D’un autre côté, InnoDB, le moteur de stockage par défaut de MySQL, adopte une architecture similaire à celle d’Oracle Database, basée sur « la mise à jour sur place (In-place update) et les journaux Undo (Undo logs / Rollback segments) ».
5.2.1 Index clusterisé et mise à jour sur place
Une table InnoDB est structurée comme un B+Tree basé sur la clé primaire (Index clusterisé).
Lorsqu’un UPDATE est exécuté dans InnoDB, il n’ajoute pas une nouvelle ligne comme PostgreSQL, mais écrase directement la ligne de données sur le B+Tree (In-place update).
Alors, comment faire si une autre transaction veut lire un snapshot passé ? Pour ce faire, InnoDB déplace les « anciennes données » avant écrasement vers une zone dédiée appelée Undo log (Undo Log Segment).
5.2.2 Reconstruction dynamique du passé via le pointeur de retour (Roll Pointer)
La colonne cachée de chaque ligne de données InnoDB contient les deux éléments suivants :
DB_TRX_ID: L’ID de la transaction qui a inséré ou mis à jour cette ligne en dernier.DB_ROLL_PTR(Roll Pointer) : Un pointeur indiquant l’emplacement dans l’Undo log où est stockée « la version précédente » de cette ligne.
Le processus par lequel une transaction lit un snapshot passé se déroule comme suit :
- Lit la ligne de données la plus récente à partir du B+Tree.
- Vérifie le
DB_TRX_ID, et s’il s’agit d’une mise à jour effectuée par une transaction future par rapport à son propre snapshot, juge qu’elle ne doit pas lire cette ligne la plus récente. - Suit le
DB_ROLL_PTRet récupère les données de la version précédente à partir de l’Undo log. - En utilisant les données sur l’Undo log, reconstruit dynamiquement (Rollback in memory) l’état passé de l’enregistrement en mémoire.
- S’il s’agit encore d’une mise à jour future, remonte davantage la chaîne de l’Undo log dans le passé.
5.2.3 Avantages et défis d’InnoDB
L’avantage de cette architecture est que la zone principale de la table (tablespace) gonfle difficilement. Les données les plus récentes se trouvent toujours à la position appropriée dans le B+Tree, et les versions passées sont isolées dans une autre zone (Undo log), ce qui permet de maintenir une efficacité de parcours physique élevée (il ne nécessite pas de VACUUM massif comme PostgreSQL, et le processus de purge du journal Undo fonctionne légèrement en arrière-plan).
L’inconvénient est que s’il existe des transactions de longue durée (telles qu’un traitement par lots ou mysqldump) qui lisent de grandes quantités de snapshots passés, une surcharge (overhead) se produit pour remonter profondément dans l’Undo log et reconstruire les données, ce qui dégrade les performances de lecture. De plus, il y a un risque que l’Undo log lui-même gonfle et encombre l’espace disque.
Chapitre 6 : L’isolement de snapshot sérialisable (SSI) et l’avant-garde des bases de données distribuées
L’évolution du MVCC ne s’arrête pas là. Comme expliqué au chapitre 3, l’isolement de snapshot (SI) présentait des anomalies telles que le « Write Skew », et n’était pas un Serializable complet. Cependant, pour éviter que les développeurs d’applications ne soient conscients de la complexité du traitement concurrent, il est nécessaire de réaliser un Serializable complet tout en maintenant les hautes performances du MVCC.
6.1 Naissance de l’isolement de snapshot sérialisable (SSI)
En 2008, un algorithme révolutionnaire appelé « Serializable Snapshot Isolation (SSI) » a été présenté dans un article de Michael Cahill et al. Il s’agit d’une technologie qui garantit une sérialisabilité complète (Serializable) tout en étant basée sur l’architecture MVCC. À partir de la version 9.1, PostgreSQL a rapidement adopté ce SSI en tant qu’implémentation du niveau d’isolement « Serializable ».
Principe de fonctionnement du SSI : Graphe des conflits et structure dangereuse (rw-antidependency)
Le SSI ne bloque pas à l’aide de verrous. Au lieu de cela, il suit (track) précisément « quelles données ont été lues (Read) et quelles données ont été écrites (Write) » pendant l’exécution de la transaction.
Le SSI surveille les relations de conflit entre les transactions et recherche un modèle de conflit spécifique appelé « rw-antidependency (anti-dépendance de lecture-écriture) ». Concrètement, il s’agit d’une relation où une transaction $T_1$ lit des données d’une version passée, et ces données sont ensuite écrasées et validées par une autre transaction $T_2$. Le SSI construit en interne un graphe des conflits des transactions, et au moment où il détecte « une structure avec deux flèches successives de rw-antidependency (structure dangereuse) », il juge que la sérialisabilité risque de s’effondrer et force l’une des transactions à avorter (rollback).
Grâce à cela, il arrête la transaction avant qu’une anomalie telle que le Write Skew (exemple : le problème du médecin de garde) ne se produise, garantissant ainsi un Serializable complet. On peut dire que c’est la forme ultime du contrôle de concurrence optimiste (OCC).
6.2 MVCC dans les bases de données distribuées : Spanner, CockroachDB, TiDB
La technologie des bases de données modernes dépasse les limites des serveurs uniques et évolue vers les bases de données SQL distribuées (NewSQL) déployées dans les centres de données du monde entier. Dans un environnement distribué, réaliser un MVCC avec une cohérence globale était également un défi aux lois de la physique.
Google Spanner et l’API TrueTime
Google Spanner a développé l’API TrueTime pour résoudre le problème du séquencement des transactions dans les systèmes distribués. Sous la prémisse que les horloges (horloges physiques) de chaque serveur finiront toujours par se décaler (clock skew), il combine le GPS et des horloges atomiques pour fournir l’heure actuelle en tant que « plage d’incertitude (fenêtre temporelle) ». Le MVCC de Spanner, en attendant que la fenêtre d’incertitude de TrueTime passe lors de la validation d’une transaction (Commit Wait), garantit physiquement que « l’ordre des horodatages des transactions ayant une relation de cause à effet sera toujours correct (Cohérence externe / External Consistency) ».
CockroachDB et HLC (Hybrid Logical Clock)
CockroachDB, une base de données distribuée open source inspirée de Spanner, utilise une HLC (Horloge logique hybride) pour obtenir une cohérence proche de cela sans utiliser d’horloges atomiques coûteuses. En combinant la synchronisation des horloges physiques par NTP et les horloges logiques de Lamport (compteurs basés sur les relations de cause à effet entre les événements), il génère des horodatages de snapshot MVCC globalement cohérents entre les nœuds distribués, et réalise le SSI (Serializable Snapshot Isolation) dans un environnement distribué.
TiDB et le modèle Percolator
TiDB, développé par PingCAP, adopte un modèle de transaction distribuée basé sur le modèle Google Percolator. Il s’agit d’une architecture qui prépare un composant unique (Placement Driver : PD) qui délivre des horodatages globaux, et le moteur de stockage de chaque nœud (TiKV) traite le MVCC localement à l’aide de cet horodatage. Bien que basé sur le 2PC (Two-Phase Commit), il minimise la période de maintien des verrous, conciliant ainsi les transactions massives dans un environnement distribué et le MVCC.
Conclusion : Au-delà d’ACID
Les niveaux d’isolement des transactions de bases de données ne sont en aucun cas de simples éléments à mémoriser. C’est l’histoire même de décennies de lutte en informatique pour concilier les exigences contradictoires de la cohérence des données et des performances du système.
À commencer par la définition incomplète de la norme ANSI SQL-92, en passant par l’amélioration spectaculaire du traitement concurrent grâce au MVCC, la bifurcation de l’architecture entre PostgreSQL et InnoDB, et le défi de la cohérence ultime avec le SSI et les bases de données distribuées. Comprendre en profondeur ces structures internes devrait être une arme puissante pour concevoir des applications plus robustes et plus performantes.
Nous vivons aujourd’hui à une époque où les propriétés ACID ne sont pas un simple « mythe », mais sont implémentées comme une « réalité » grâce à des algorithmes avancés et à la synchronisation des horloges physiques. Pour l’ingénieur naviguant dans l’océan des données, connaître les abysses des moteurs de bases de données est un voyage d’exploration intellectuelle qui ne s’achèvera jamais.