Desde el antiguo cifrado César hasta Enigma, la criptografía de clave pública y la criptografía poscuántica (PQC) que nos prepara para la amenaza futura de las computadoras cuánticas, explicamos en detalle la épica historia y evolución técnica de la criptografía.
Explicación detallada del proceso de desarrollo y la arquitectura interna para la inferencia de modelos de IA a pequeña escala como TinyLLaMA en entornos locales, utilizando C++ y ggml. Cubre el mapeo de memoria, operaciones tensoriales y optimización SIMD.
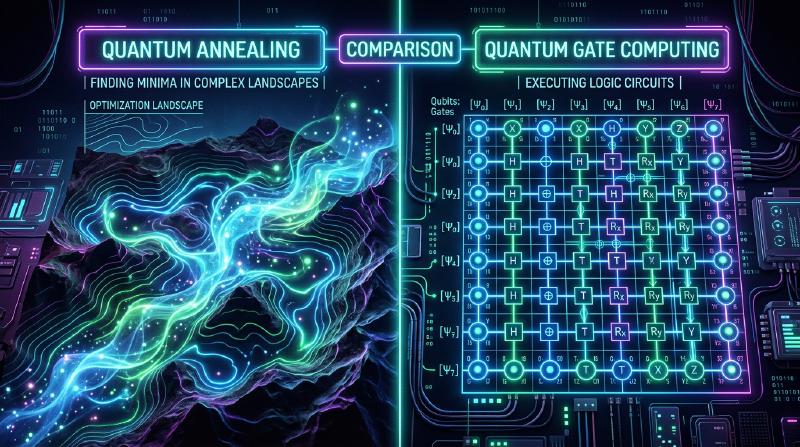
Comparación y explicación exhaustiva de dos arquitecturas de computadoras cuánticas: recocido cuántico y modelo de puertas, desde modelos matemáticos y fundamentos físicos como el modelo de Ising, formulación QUBO, transformación unitaria y corrección de errores, hasta casos de uso específicos.
Guía completa que abarca desde los conceptos básicos de llama.cpp hasta la personalización avanzada con C++, el trasfondo matemático de los Transformers y la explicación de la arquitectura ggml.
Se explica detalladamente cómo las computadoras cuánticas podrían destruir la criptografía actual, desde los fundamentos matemáticos del algoritmo de Shor hasta su implementación en Python.
Se explica detalladamente la amenaza de vulnerabilidad criptográfica por el auge de las computadoras cuánticas y los algoritmos como Kyber, Dilithium, FALCON y SPHINCS+, que son estándares de criptografía poscuántica (PQC) del NIST para contrarrestarlo, desde los fundamentos matemáticos de la criptografía basada en retículos (problema LWE) hasta su funcionamiento interno y la comparación de rendimiento.
Una guía completa para integrar la IA de reconocimiento de voz de alta precisión en dispositivos edge o aplicaciones nativas utilizando C++ y whisper.cpp. Abarca desde los fundamentos del procesamiento de señales de audio hasta la optimización de la inferencia en tiempo real.
LLMs locales que puedes usar gratis mientras proteges tu privacidad. En este artículo, comparamos y explicamos en detalle los mejores LLMs de código abierto como Llama 3, Mistral, Gemma 2, Qwen 2.5 y Phi-3 desde una perspectiva técnica.
La escasez de VRAM (memoria de GPU) es la mayor barrera en el entrenamiento e inferencia de LLMs. En este artículo, explicamos detalladamente técnicas de resolución como la descarga de CPU, la cuantización de la caché KV y los puntos de control de gradientes mediante fórmulas matemáticas y diagramas de arquitectura.