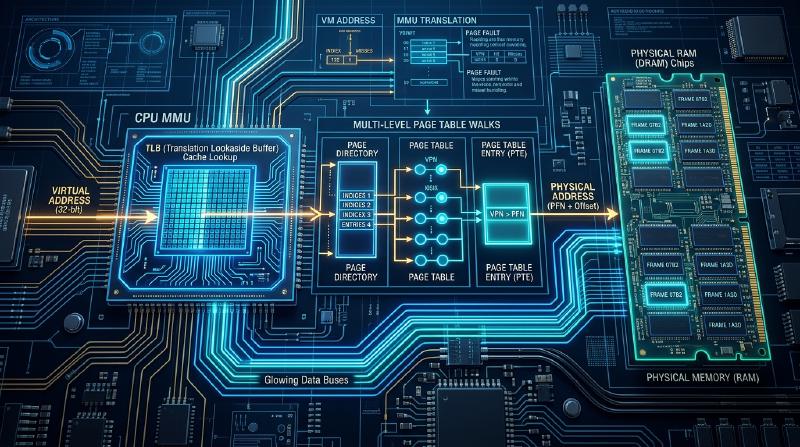
Anatomía completa de la memoria virtual y el mecanismo de paginación: De la MMU a la TLB, HugePage y las profundidades de la gestión de memoria
En los sistemas operativos (SO) modernos y la arquitectura de CPU, uno de los sistemas más complejos pero más importantes es el mecanismo de “Memoria Virtual (Virtual Memory)” y “Paginación (Paging)”. Detrás del espacio de memoria, del cual los desarrolladores de aplicaciones normalmente no son conscientes, la MMU (Memory Management Unit) del hardware y el kernel del SO trabajan en estrecha colaboración, realizando enormes cantidades de conversiones de direcciones y manejo de excepciones en un mundo de nanosegundos.
En este artículo, analizaremos las partes más profundas del sistema de memoria virtual desde la perspectiva de la estructura interna del sistema operativo y la arquitectura de computadoras. Explicaremos exhaustivamente los mecanismos de bajo nivel a nivel de código fuente y registro, abarcando desde la disposición completa de bits de la estructura de la tabla de páginas de la arquitectura x86-64, el protocolo IPI del derribo (shootdown) de la TLB, el rastro completo de los fallos de página en el kernel de Linux, el mecanismo físico de Copy-on-Write (CoW), los algoritmos de recuperación (Reclaim) de memoria, hasta la fórmula de cálculo de la puntuación del OOM Killer.
Capítulo 1: La razón de ser de la memoria virtual y su contexto histórico
¿Por qué las computadoras necesitan memoria virtual? En los primeros sistemas informáticos, los programas accedían directamente a direcciones específicas de la memoria física (RAM). Sin embargo, a medida que los entornos multitarea se popularizaron, este “método de especificación directa de direcciones físicas” alcanzó su límite.
1.1 Protección de la memoria y separación completa del espacio de procesos
El mayor propósito de la memoria virtual es “garantizar la seguridad y la estabilidad”. Si el proceso A sobrescribe la memoria del proceso B por error (o con malas intenciones), todo el sistema podría colapsar o se podría filtrar información confidencial. La memoria virtual da a cada proceso la ilusión de “tener su propio espacio de memoria continuo dedicado”. Con esto, la memoria entre procesos se separa estrictamente a nivel de hardware (MMU), y los accesos inválidos a la memoria son capturados inmediatamente y tratados como errores de segmentación (segmentation fault). La separación entre el espacio de usuario y el espacio del kernel también se logra a través de este mecanismo, y el hardware realiza las transiciones de anillos de privilegios y las verificaciones de permisos de acceso a la memoria en cada ciclo.
1.2 Rompiendo la barrera de la capacidad de la memoria física y la filosofía de la paginación bajo demanda
No es raro que la cantidad de memoria solicitada por una aplicación exceda la capacidad de la RAM física instalada. La memoria virtual proporciona un espacio de direcciones mucho más amplio que la memoria física, guardando áreas de memoria (páginas) que no se utilizan actualmente en un dispositivo de almacenamiento secundario (HDD/SSD) (swap out) y volviéndolas a leer cuando se necesitan (swap in). Además, mediante la filosofía de la “paginación bajo demanda (demand paging)”, en lugar de cargar todos los códigos y datos en la memoria al inicio de la ejecución del programa, se cargan en la memoria solo cuando se produce un acceso por primera vez, logrando así tanto el ahorro de memoria como un inicio rápido.
1.3 Cambio de paradigma de la segmentación a la paginación
En los primeros x86 (como el 80286), se utilizaba la “segmentación”, que gestionaba la memoria en bloques de longitud variable. Este método calculaba la dirección lógica usando registros como CS (segmento de código) y DS (segmento de datos) sumando una dirección base y un desplazamiento (offset). Sin embargo, la segmentación era propensa a causar “fragmentación externa (fragmentación de memoria)” y su gestión era extremadamente engorrosa. Más tarde, con la aparición del 80386, se introdujo y se popularizó la “paginación”, que gestiona la memoria en bloques de longitud fija (usualmente de 4KB). Los sistemas operativos de 64 bits modernos (Linux y Windows) invalidan de hecho la segmentación tratándola como un modelo de memoria plano (dirección base 0, límite máximo) y utilizan únicamente la paginación para la gestión de la memoria. En la actualidad, la segmentación se utiliza solo para un número muy limitado de propósitos, como la referencia al almacenamiento local de hilos (TLS) (registros FS/GS).
Capítulo 2: La estructura multinivel de las tablas de páginas en x86-64 y el análisis completo del diseño de bits
En la arquitectura de 64 bits (x86-64/AMD64), el espacio de direcciones virtuales es inmenso. En el “espacio de direcciones virtuales de 48 bits” actualmente predominante, la MMU del hardware recorre una tabla de páginas de 4 niveles.
2.1 Espacio de direcciones virtuales de 48 bits/57 bits y la restricción de forma canónica (Canonical Form)
Aunque los registros de 64 bits pueden representar un vasto espacio de direcciones de 16 exabytes, las implementaciones de hardware actuales no los utilizan todos por cuestiones de costo y complejidad. En la implementación de 48 bits, existe la restricción de que los bits 47 a 63 de la dirección virtual deben tener todos el mismo valor (extensión de signo). Una dirección que cumple con esta restricción se denomina “dirección canónica (Canonical Address)”.
Debido a esto, el espacio de memoria tiene una estructura con una enorme área no utilizada en el centro (Non-canonical hole), y se divide claramente en la mitad inferior para el espacio de usuario (0x0000000000000000 a 0x00007FFFFFFFFFFF) y la mitad superior para el espacio del kernel (0xFFFF800000000000 a 0xFFFFFFFFFFFFFFFF). Cuando se desreferencia un puntero inválido (por ejemplo, un puntero con metadatos incrustados en sus bits más significativos), la MMU genera inmediatamente una excepción de protección general (#GP) como una violación canónica. Recientemente, en procesadores posteriores a Intel Ice Lake, también se ha comenzado a soportar el espacio virtual de 57 bits (tabla de páginas de 5 niveles) que extiende esto, convirtiéndose en la base de las infraestructuras en la nube que manejan memoria a escala de petabytes.
2.2 Detalles de la estructura jerárquica de la tabla de páginas de 4 niveles (PML4, PDPT, PD, PT)
Para convertir una dirección virtual de 48 bits en una dirección física, x86-64 utiliza una tabla de páginas de 4 niveles (una estructura de datos en forma de Radix Tree). Cada tabla tiene un tamaño de 4KB y almacena 512 entradas de 64 bits (8 bytes) (2^9 = 512). La dirección virtual se divide de la siguiente manera, funcionando cada parte como índice de cada nivel:
- Bits 39-47 (9 bits): Índice PML4 (Page Map Level 4) - El nivel superior. El registro CR3 apunta a su dirección base física.
- Bits 30-38 (9 bits): Índice PDPT (Page Directory Pointer Table)
- Bits 21-29 (9 bits): Índice PD (Page Directory) - Aquí termina en caso de usar HugePage de 2MB.
- Bits 12-20 (9 bits): Índice PT (Page Table) - La tabla final en páginas normales de 4KB.
- Bits 0-11 (12 bits): Desplazamiento de página (Page Offset) - El desplazamiento dentro de una página de 4KB (4096 bytes).
2.3 Tabla completa del diseño de 64 bits de la entrada de la tabla de páginas (PTE)
Cada entrada de 64 bits en la tabla de páginas no es un simple puntero a una dirección física, sino una colección de metadatos que controla el acceso de forma estricta y gestiona la caché. A continuación, se muestra el diseño de bits completo de una PTE en x86-64 y sus funciones detalladas.
- Bit 0 [P] Present: Si es 1, existe en la memoria física. Si es 0, ha sido enviado a swap (swap-out) o no está asignado. Acceder cuando es 0 genera una excepción de fallo de página (#PF).
- Bit 1 [R/W] Read/Write: Si es 0, es de solo lectura (Read-Only). Si es 1, permite lectura y escritura (Read/Write). Juega un papel crucial en la implementación de CoW (Copy-on-Write).
- Bit 2 [U/S] User/Supervisor: Si es 0, solo es accesible en modo privilegiado (kernel). Si es 1, también es accesible desde el modo de usuario (Ring 3). Se gestiona estrictamente por mecanismos como KPTI y SMAP.
- Bit 3 [PWT] Page-level Write-Through: Si es 1, establece la política de escritura en caché para esta página como Write-Through. Si es 0, es Write-Back.
- Bit 4 [PCD] Page-level Cache Disable: Si es 1, deshabilita la caché para esta página (Uncacheable). Se utiliza para acceder directamente a los registros de dispositivos PCIe en memoria mapeada I/O (MMIO), etc.
- Bit 5 [A] Accessed: Se establece automáticamente a 1 por el hardware cuando la MMU accede (lee o escribe) a esta página. Es utilizado como bit de referencia en el algoritmo LRU (recuperación de páginas) del SO.
- Bit 6 [D] Dirty: Se establece automáticamente a 1 por el hardware cuando la MMU realiza una “escritura” en esta página. Es un bit esencial para que el SO determine si es necesario volver a escribir al disco (swap-out).
- Bit 7 [PAT] Page Attribute Table: Combinado con PWT/PCD, es un índice para especificar tipos de caché de memoria más detallados (como WC: Write-Combining). Se utiliza en transferencias masivas rápidas a la memoria de video (VRAM), etc.
- Bit 8 [G] Global: Si es 1, no se limpia (flush) esta entrada de la TLB incluso si se cambia el registro CR3 (ocurre un cambio de contexto). Se utiliza principalmente para páginas del espacio del kernel, evitando la penalización por fallos de TLB en llamadas al sistema.
- Bits 9-11 [AVL] Available: 3 bits disponibles libremente para el SO (kernel). En Linux, a veces se usan para metadatos de entradas swap o identificación de nodos NUMA.
- Bits 12-51 [PFN] Physical Frame Number: La dirección base (número de marco físico) de la página física de destino. Como está alineado a 4KB, los 12 bits inferiores se tratan siempre como 0.
- Bits 52-62 [AVL/PKU] Available/Ignored: Reservado según la generación de la CPU o expansiones funcionales (como Intel MPK: Memory Protection Keys), o áreas utilizables por el SO.
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: Si es 1, hace que los datos en esta página “no sean ejecutables como instrucciones”. Es un fuerte mecanismo de seguridad para prevenir ataques de inyección de código en áreas de datos mediante desbordamiento de búfer, etc. (DEP: Data Execution Prevention).
De esta manera, cada bit de la PTE está estrechamente acoplado con los algoritmos de gestión de memoria del SO (especialmente el procesamiento de swap, protección de seguridad y control de E/S), lo que la convierte en una interfaz exquisitamente diseñada en la frontera entre el hardware y el software.
Capítulo 3: Recorrido de tabla de páginas por hardware mediante la MMU y la barrera de latencia
La conversión de una dirección virtual a una dirección física se lleva a cabo mediante un circuito de hardware dedicado llamado MMU (Memory Management Unit), que se encuentra dentro del núcleo de la CPU.
3.1 El mecanismo del recorrido de la tabla con el registro CR3 como punto de partida
El registro de control CR3 del procesador almacena la dirección física de la tabla de páginas de nivel superior (PML4) del proceso actualmente en ejecución. Cuando un sistema operativo como Linux realiza un cambio de contexto (context switch) y cede el control de la CPU a otro proceso, sobrescribe este registro CR3 con la dirección PML4 del nuevo proceso. Como resultado, todo el espacio de memoria del proceso cambia instantáneamente.
A continuación, se muestra un flujo conceptual:
- Se extrae el índice de nivel superior de la dirección virtual y se lee la entrada correspondiente en la tabla PML4 señalada por el CR3.
- Se extrae el PFN de la entrada PML4 para calcular la dirección física de la siguiente tabla PDPT.
- Se lee la entrada correspondiente en la tabla PDPT.
- De manera similar, se rastrean la tabla PD y la tabla PT, obteniendo la dirección base de la página física final de 4KB.
- Finalmente, se suma el desplazamiento de página de 12 bits para construir la dirección física completa.
3.2 Acceso al bus de memoria y latencia: La mayor barrera
La mayor debilidad de este recorrido de tabla de páginas de 4 niveles es la “latencia de acceso a la memoria”. Por la simple conversión de una dirección virtual, en el peor de los casos, se producen 4 accesos a la memoria física (lecturas de PML4, PDPT, PD, PT). La latencia de acceso de la DRAM moderna es de aproximadamente 50 a 100 nanosegundos. Si los 4 accesos a la memoria fallan en la caché de la CPU (L1/L2/L3) y llegan a la DRAM, se produce un estancamiento (stall) de cientos de nanosegundos solo con eso. Considerando que un ciclo de reloj de la CPU es de aproximadamente 0.3 nanosegundos (3GHz), esto equivale a miles de ciclos y supone un retraso fatal, causando que el pipeline de la CPU se agote por completo y se detenga. Para romper esta barrera de rendimiento extremadamente grave, se diseñó la TLB, que se explicará a continuación.
Capítulo 4: La arquitectura de la TLB en entornos multinúcleo y el sufrimiento del Shootdown
La TLB (Translation Lookaside Buffer) es una “caché del resultado de la conversión de direcciones virtuales a direcciones físicas” incorporada en la MMU y está formada por memoria SRAM súper rápida (o CAM: Content Addressable Memory).
4.1 Estructura jerárquica de la TLB y la optimización mediante PCID (Process-Context Identifier)
En las CPUs modernas, la TLB también tiene una estructura jerárquica de L1/L2. La L1 D-TLB (para datos) y la L1 I-TLB (para instrucciones) tienen una capacidad muy pequeña (decenas de entradas) pero responden en 1 ciclo. La L2 TLB tiene de cientos a miles de entradas y responde en varios ciclos. Cuando no existe una entrada en la TLB (fallo de TLB, TLB miss), ocurre el recorrido de tabla por hardware (recorrido de página) mencionado anteriormente. Para apoyar esto, también se ha implementado una caché exclusiva para el recorrido de página (PWC: Page Walk Cache).
Dado que el significado de una dirección virtual cambia cuando un proceso cambia, anteriormente (en los primeros x86) se borraba por completo (Flush) la TLB al reescribir el CR3. Sin embargo, esto causaba muchos fallos de TLB inmediatamente después del cambio de contexto, reduciendo significativamente el rendimiento. Para resolver esto, se introdujo una tecnología llamada PCID (Process-Context Identifier) (llamada ASID en la arquitectura ARM). Al agregar una etiqueta de ID de 12 bits a las entradas de la TLB que identifica de manera única a un proceso, fue posible seguir reteniendo las entradas TLB del proceso anterior incluso después de un cambio de contexto, mejorando drásticamente el rendimiento en entornos multiproceso, como servidores web y bases de datos.
4.2 El protocolo de interrupción entre procesadores (IPI) del derribo de TLB (TLB Shootdown)
En un entorno multinúcleo, el sistema de memoria virtual se enfrenta a un problema de sincronización muy complicado. Por ejemplo, supongamos que un proceso ejecutándose en el núcleo 0 (CPU0) libera un área de memoria específica con munmap() e invalida el PTE de la tabla de páginas (Present = 0). Sin embargo, en la TLB local del núcleo 1 (CPU1), aún podría quedar como caché la “información de conversión antigua (Stale TLB Entry)” de esa dirección virtual a la dirección física.
Si se deja así, el núcleo 1 accedería a la memoria ya liberada, lo que podría destruir los datos asignados a otro proceso o leer información confidencial, lo cual es una grave falla de seguridad. Para evitar esto, el sistema operativo debe obligar al núcleo 1 a eliminar esa entrada de su TLB. Esto es el derribo de TLB (TLB Shootdown).
El TLB Shootdown se ejecuta estrictamente en los siguientes pasos (Protocolo IPI):
- Iniciador (Núcleo 0): Después de actualizar la tabla de páginas (borrar el PTE), emite una barrera de memoria (como
mfence) y envía un IPI (Inter-Processor Interrupt: Interrupción entre procesadores) al APIC local (Advanced Programmable Interrupt Controller) de los otros núcleos objetivo (Núcleo 1). - Espera (Busy Wait): El núcleo 0 espera en un spinlock hasta que todos los demás núcleos objetivo terminen de procesar la interrupción.
- Objetivo (Núcleo 1): Al recibir el IPI, interrumpe inmediatamente el código de usuario que se está ejecutando y salta al manejador de interrupciones del kernel (en Linux, algo como
flush_tlb_funca través desmp_call_function). - Ejecución del Flush: El núcleo 1 invalida la entrada de la dirección virtual especificada de su propia TLB local (en x86 se usa la instrucción
INVLPG; para un flush completo, se recarga el CR3). - Notificación de finalización: El núcleo 1 escribe en una bandera en la memoria indicando que el flush ha terminado y libera al núcleo 0 de su espera. Luego, regresa al proceso interrumpido (
iret).
Cuello de botella de rendimiento y límite de escalabilidad: Dado que el TLB Shootdown implica la emisión de IPI del hardware, el cambio de contexto de la interrupción, el flush del pipeline y la espera del spinlock entre varios núcleos, es una operación de muy alto costo que consume desde miles hasta decenas de miles de ciclos. A medida que aumenta el número de núcleos a 16, 64 o 128, este costo de sincronización aumenta exponencialmente, convirtiéndose en un grave obstáculo para la escalabilidad de aplicaciones multihilo (especialmente aquellas que reservan y liberan memoria frecuentemente) en servidores en la nube y HPC.
Capítulo 5: Rastro completo del procesamiento de fallos de página en el kernel de Linux
Cuando un programa accede a un área donde el bit Present de la tabla de páginas es 0 o un área sin privilegios (intentó escribir en solo lectura, intentó acceder al área del kernel desde el modo usuario, etc.), la MMU emite una excepción de fallo de página (Exception 14, #PF en x86). A partir de aquí comienza un profundo viaje hacia el procesamiento de excepciones del kernel de Linux.
5.1 Flujo de control del fallo de página y rastro de las partes dependientes de la arquitectura
En el kernel de Linux para x86-64, el gráfico de llamadas de funciones (call trace) cuando ocurre un fallo de página es el siguiente. El control pasa de un manejador de bajo nivel dependiente de la arquitectura al subsistema de gestión de memoria genérico independiente de la arquitectura.
asm_exc_page_fault(Lenguaje Ensamblador: arch/x86/entry/entry_64.S)- La CPU detecta la excepción, el hardware coloca la dirección virtual donde ocurrió el fallo en el registro
CR2, guarda el estado de los registros en la pila de interrupciones y salta al punto de entrada del kernel.
- La CPU detecta la excepción, el hardware coloca la dirección virtual donde ocurrió el fallo en el registro
exc_page_fault()(Lenguaje C: arch/x86/mm/fault.c)- Es un manejador de fallos dependiente de la arquitectura. Analiza el código de error (Lectura/Escritura, Usuario/Kernel, PF, etc.) y verifica el contexto de interrupción.
do_page_fault()/do_user_addr_fault()- Determina si el fallo ocurrió en el espacio del kernel (bug, área vmalloc, etc.) o en el espacio de usuario. Si es en el espacio de usuario, busca en el mapa de memoria del proceso objetivo (el árbol rojo-negro y la lista de VMA de
vm_area_struct) y verifica si la dirección pertenece a un área válida (y que no sea un fallo de segmentación).
- Determina si el fallo ocurrió en el espacio del kernel (bug, área vmalloc, etc.) o en el espacio de usuario. Si es en el espacio de usuario, busca en el mapa de memoria del proceso objetivo (el árbol rojo-negro y la lista de VMA de
handle_mm_fault()(Lenguaje C: mm/memory.c)- A partir de aquí está la función principal independiente de la arquitectura. Recorre cada nivel de la tabla de páginas (PGD -> P4D -> PUD -> PMD -> PTE), asignando nuevos directorios intermedios (
pmd_alloc, etc.) si las tablas aún no están asignadas, y determina la dirección final del PTE.
- A partir de aquí está la función principal independiente de la arquitectura. Recorre cada nivel de la tabla de páginas (PGD -> P4D -> PUD -> PMD -> PTE), asignando nuevos directorios intermedios (
5.2 La esencia de la asignación de memoria: Las ramas desde handle_mm_fault
handle_mm_fault() ramifica el proceso de asignación de página real en función del estado del PTE identificado (si el PTE está vacío, enviado al swap o si hay un error de permisos).
do_anonymous_page()(El pináculo de la paginación bajo demanda): Se llama cuando el PTE está completamente vacío (cero). Es el primer acceso a una página anónima (Anonymous Page) que no está vinculada a un archivo, como en el montón (heap, elbrkommapdetrás delmalloc) o la expansión de la pila (stack). El kernel asegura aquí, por primera vez, memoria física (un marco) del sistema de compañeros (Buddy System), la inicializa con ceros y la mapea en el PTE. Esto ahorra memoria que no se utiliza.do_fault()/__do_fault()(Paginación respaldada por archivos): Se llama durante el primer acceso a un archivo mapeado conmmap, etc. Lee los datos del archivo desde la caché de la página, o llama al controlador del sistema de archivos (ext4 o xfs) para cargar los datos desde el disco y los mapea en la tabla de páginas.do_swap_page()(El dolor del swap-in): Se llama cuando el bit Present del PTE es 0, pero el desplazamiento del área de swap está registrado en otros bits de bandera. Carga los datos del disco (partición de swap o archivo de swap) nuevamente en la memoria física. Al implicar E/S de disco, el proceso entra en un estado de reposo (bloqueo) prolongado.do_wp_page()(Copy-on-Write): El proceso CoW que se explicará más adelante. Se llama cuando se intenta escribir en una página donde Present=1 pero no hay permiso de escritura.
5.3 Mecanismo físico de Copy-on-Write (CoW) y la magia del recuento de referencias
La llamada al sistema fork(), que es el pilar de la creación de procesos en Linux, funciona de manera extremadamente rápida debido a un mecanismo de evaluación perezosa llamado CoW (Copy-on-Write). Se explicará el mecanismo físico detrás del porqué fork() se completa en un instante incluso si el proceso padre está usando varios GB de memoria.
- Compartición de la tabla de páginas:
Cuando se llama a
fork(), el kernel simplemente copia la tabla de páginas del proceso padre al proceso hijo. Sin embargo, no copia en absoluto la memoria física en sí. Los PTE del padre y del hijo apuntan exactamente a la misma memoria física (marcos). - Configuración forzada del bit de solo lectura (Write-Protect):
En ese momento, el kernel reescribe forzosamente el bit
R/Wde todos los PTE de las páginas compartidas a0(Read-Only) (incluyendo las áreas de datos en las que originalmente se podía escribir). - Incremento del recuento de referencias (Reference Count):
Incrementa la estructura de datos del kernel que gestiona la página física en cuestión (
_refcountenstruct page), indicando el estado de “está siendo referenciada por 2 procesos”. - Escritura y fallo de página (Desencadenante de do_wp_page):
Si el padre o el hijo intenta escribir (Write) en un área compartida como una variable o en el montón (heap), la MMU de hardware detectará
R/W=0y emitirá inmediatamente un fallo de página. - Duplicación de página (Duplication):
Desde el manejador de fallos de página, se llamará a
do_wp_page(). El kernel verificará los indicadores de la VMA y determinará que “no se trata de un acceso no válido, sino de un fallo por un CoW legítimo”. Se asignará una nueva página física del Buddy System, y copiará todos los datos de la página original a la nueva página (copy_page). - Actualización de PTE y decremento del recuento de referencias:
El PTE del proceso que realizó la escritura apuntará ahora a la nueva página física, y el bit
R/Wse establecerá en1(Read/Write permitido). Luego, se decrementa el contador de referencias de la página física original. Si el contador de referencias llega a 1, el proceso restante monopolizará la página, de modo que la próxima vez que genere un fallo en dicha página, no habrá necesidad de hacer copias de memoria; simplemente se cambiará de nuevo el bit R/W a 1 (Reutilización de la página).
De esta forma, CoW es un elegante algoritmo artístico en el cual se combinan de manera brillante la función de protección por hardware de la MMU (trampa de Read-Only) y el control de software del kernel, logrando así un dramático ahorro de memoria y una inicialización rápida de los procesos.
Capítulo 6: El abismo de los algoritmos de recuperación de memoria (Reclaim) y la condena del OOM Killer
La memoria física es finita. A medida que un sistema funciona durante un largo período de tiempo y la caché de archivos y la memoria dinámica de procesos acaparan toda la memoria, el sistema operativo debe liberar y recuperar (Reclaim) el espacio de memoria existente para reservar memoria nueva. Este subsistema de recuperación de memoria es uno de los ámbitos más complejos y oscuros dentro del kernel de Linux.
6.1 Lista LRU Activa/Inactiva y algoritmo pseudo-LRU
El kernel de Linux utiliza listas LRU (Least Recently Used) para gestionar y rastrear las páginas físicas. Sin embargo, resulta inviable manejar todas las páginas usando un algoritmo LRU estricto debido a los conflictos de bloqueos y a los costes de escaneo. En lugar de ello, emplea un algoritmo pseudo-LRU (una derivación del Algoritmo del Reloj) usando dos colas (listas): “Lista activa” y “Lista inactiva”.
- Lista Activa: Conjunto de páginas “calientes (hot)” a las que se accede con frecuencia recientemente. Estas no son objeto de recuperación.
- Lista Inactiva: Conjunto de páginas “frías (cold)” a las que no se ha accedido durante un tiempo. Se convierten en candidatas a recuperación de forma secuencial empezando por la parte final (tail).
¿Cómo sabe el kernel cuándo se ha accedido a una página? Aquí es donde entra en acción el Bit Accessed (bit A) de la PTE explicado en el Capítulo 2. El kernel (kswapd) escanea periódicamente las tablas de páginas, lee el bit A de la PTE, graba el historial de acceso por software y a continuación borra a cero el bit A. Si el hardware ha vuelto a poner el bit A a 1, la página permanece en la lista activa, o sube de categoría desde la inactiva. Si no ha sido modificado, irá degradándose progresivamente hacia la parte final de la lista Inactiva.
6.2 El demonio kswapd y el terror de la Recuperación Directa (Direct Reclaim)
Cuando la capacidad de memoria libre (Free Pages) cae por debajo de un umbral específico (marca de agua: low), el subproceso en segundo plano del kernel kswapd (existente en cada nodo NUMA) se despierta.
kswapd va tomando páginas desde el final de la lista Inactiva.
- Si es una caché de archivos limpia (datos de archivos inalterados), simplemente se desecha (Drop) para liberar espacio.
- Si es una caché de archivos sucia (datos que se han modificado), se escriben de vuelta al disco (Writeback) antes de eliminarlos.
- Si es una página anónima (como de la memoria dinámica (heap) o pila de procesos), se enviará al espacio swap (Swap-out).
Continúa con su tarea en segundo plano hasta que la memoria libre llegue al umbral (marca de agua)
high.
Sin embargo, si la presión por reservar nueva memoria (memory pressure) desde las aplicaciones es excesivamente alta y la velocidad a la que kswapd recupera memoria no puede seguir el ritmo, de forma que el espacio libre descienda al límite crítico inferior (marca de agua min), se disparará la Recuperación Directa (Direct Reclaim).
El Direct Reclaim es un mecanismo en el que el proceso que solicitó la memoria (la propia aplicación) ejecutará síncronamente los procesos de recuperación (desecho de cachés y operaciones de swap-out). Cuando se entra en Recuperación Directa, la ejecución de la aplicación (como malloc y la terminación de un fallo de página) quedará totalmente paralizada (stall), lo que será una causa inmediata y directa de una grave caída de rendimiento (pico de latencia) que puede ir de cientos de milisegundos a varios segundos. En las bases de datos y en los sistemas en tiempo real, es absolutamente esencial su optimización (ajustes en vm.swappiness y marcas de agua) para evitar esto.
6.3 La fórmula de puntuación del OOM Killer y la condena de los procesos
Incluso ejecutando Recuperación Directa, cuando todo el espacio swap se haya acabado, las cachés agotadas por completo y no quede manera posible de asegurar memoria, el kernel de Linux convocará a su último recurso: OOM (Out Of Memory) Killer.
Para prevenir un colapso en todo el sistema debido a la falta de memoria y su consecuente pánico (kernel crash o un bloqueo completo del sistema), el OOM Killer “cierra forzosamente (SIGKILL)” aquellos procesos que consumen gran cantidad de memoria para recuperar recursos. Para determinar a su víctima entra en juego un despiadado algoritmo.
La elección sobre qué proceso matar se toma basándose en la puntuación llamada oom_score (se calcula usando la función oom_badness() del kernel, ubicada en mm/oom_kill.c).
La lógica de cálculo básico de la puntuación OOM (Concepto):
- Puntuación Base: La proporción de consumo en relación con la memoria total utilizada actualmente por un proceso (RSS: Resident Set Size + Tamaño de tablas de páginas + Consumo de swap). Máximo 1000 puntos. Es decir, mientras un proceso gaste más memoria (como aquéllos causando fugas (Memory leaks)), su probabilidad de ser cerrado es mayor.
- Reducción de penalización en procesos con permisos root: Los procesos que operan como root (como los demonios (daemons) principales del sistema) suelen ser indispensables para mantener el sistema vivo, por lo que su puntuación se reduce un poco, dificultando que el OOM Killer los asesine.
- Valor ajustado de usuario (OOM Score Adj): Se suma al valor de la variable ubicada en
/proc/[pid]/oom_score_adj(-1000 a +1000). Esto lo pueden usar los administradores del sistema para influir o controlar el comportamiento de la toma de decisiones por el OOM Killer. A todo proceso al que le esté asignado un valor de -1000 (ej. sshd, kubelet, el demonio maestro de base de datos) entra en el rango de exclusión y se volverá “inmune al OOM Killer”.
En el momento que interviene un evento del OOM Killer, los registros logísticos del kernel (dmesg o /var/log/messages) imprimirán notificaciones tales como “Out of memory: Killed process 1234 (java)”, conjuntamente a todos los listados de procesos vigentes de dicho instante, los informes y la memoria volcadas al detalle. Entendiendo bien esto en su totalidad y el cálculo, los administradores logran desvelar la fuente de cierre inesperado y aplican límites (ulimit y cgroups) con el fin de evitar un problema indeseable de sistema.
Capítulo 7: Las modernas e innovadoras tecnologías ultrarrápidas de gestión de memoria y seguridad de hardware
7.1 El poder de 2MB/1GB HugePages y los pros y contras de THP
Para resolver los retrasos (latencias) ocasionados por el fallo de la TLB y los recorridos de páginas mencionados en los Capítulos 3 y 4, la “HugePage” (Páginas Enormes) juega un rol fundamental y sumamente eficaz. A cambio de las habituales de 4KB, las páginas adquieren proporciones inmensas como las de 2MB (en el nivel Page Directory indica de forma directa a la ubicación física de direcciones, esquivando el uso y gestión escalonada de tablas PT) y 1GB (apuntando directamente desde un estado y categoría en PDPT).
Esto hace posible cubrir con una sola entrada en el TLB espacios inmensos en el entorno de memoria (512 o 260.000 veces el valor usual estándar de 4KB) por medio de lo cual los fallos de TLB se reducen drásticamente. Debido a esto, los HugePages constituyen un elemento de optimización indispensable del rendimiento de bases de datos que acceden de forma aleatoria a enormes cantidades de memoria (Oracle, PostgreSQL) o en entornos de virtualización (KVM/QEMU).
En adición a lo previamente mencionado, los THP (Transparent Huge Pages) de Linux conforman un mecanismo que, de modo subyacente y en segundo plano (khugepaged), sin que las aplicaciones sean conscientes, acopla, fusiona y desfragmenta continua y automáticamente agrupaciones y páginas individuales de 4KB en páginas HugePage de 2MB. Sin embargo, en entornos donde la fragmentación de la memoria ha avanzado, este proceso de integración (compactación de memoria) consume en sí mismo gran cantidad de CPU y provoca picos de latencia, por lo que para KVS en memoria como Redis se recomienda deshabilitar THP ajustándolo a never o empleando madvise.
7.2 El Aislamiento de Tabla de Páginas del Kernel (KPTI) y el costo de prevención sobre Meltdown
Descubierta en 2018, la vulnerabilidad de ejecución especulativa de la CPU “Meltdown (CVE-2017-5754)” resultó ser un defecto fatal que sacudió los cimientos del hardware, al permitir que los procesos de usuario leyeran ilícitamente el espacio de memoria (caché) del kernel.
Como contramedida introducida en el lado del sistema operativo se encuentra el KPTI (Kernel Page-Table Isolation) (inicialmente conocido como KAISER).
Tradicionalmente, para reducir la sobrecarga de los cambios de contexto, toda el área del kernel se asignaba en la mitad superior de la tabla de páginas incluso durante la ejecución del espacio de usuario (se asumía que la verificación de privilegios se realizaría con el bit U/S del PTE y se denegaría el acceso). Sin embargo, la ejecución especulativa logró eludir esta verificación de privilegios.
Tras la introducción de KPTI, durante la ejecución del usuario se utiliza una “tabla de páginas en la sombra mínima (User PGD)” que no mapea la mayor parte del kernel. Al realizar la transición al espacio del kernel debido a llamadas al sistema o interrupciones, es obligatorio cambiar el registro CR3 y recargar la tabla de páginas del kernel completa (Kernel PGD).
Si bien esto garantizó completamente la seguridad, cada llamada al sistema e interrupción genera ahora un cambio costoso del CR3 (además de la gestión de PCID/TLB flush), por lo que en aplicaciones de E/S intensivas (servidores web y de bases de datos que utilizan fuertemente llamadas al sistema) provocó una innegable sobrecarga en el rendimiento del orden de un pequeño porcentaje hasta más del 10%.
7.3 Direct I/O y el avance de la tecnología Zero Copy
Para optimizar la E/S de archivos, el sistema operativo aplica al máximo los mecanismos de memoria virtual.
Al usar la llamada al sistema mmap(), el contenido de un archivo se mapea directamente al espacio de direcciones virtuales. Cuando se accede, se produce un fallo de página, los datos del archivo se leen en la caché de páginas y quedan disponibles como puntero de acceso directo desde el espacio de usuario.
Aún más, en la transmisión y recepción de red y en las E/S de almacenamiento, para omitir la copia de datos mediante la CPU entre los búferes del espacio del kernel (caché de páginas) y el espacio de usuario (copias asociadas con cambios de contexto), se utilizan tecnologías Zero Copy. Mediante llamadas al sistema como sendfile() o las más recientes io_uring y AF_XDP, cooperando con controladores DMA (Direct Memory Access) de NICs y unidades NVMe, se operan directamente los PTE de las tablas de páginas para “volver a adjuntar (remapear)” páginas del kernel directamente al espacio de usuario, reduciendo completamente a cero la sobrecarga de copiado de memoria. Aquí también, la manipulación hábil de la tabla de páginas actúa como un mecanismo fundamental.
Conclusión
La memoria virtual y el mecanismo de paginación son una sinfonía extremadamente avanzada tocada por el kernel del sistema operativo y la CPU (hardware). Desde la configuración de un simple bit indicador en la tabla de páginas, la agonía del spinlock por el shootdown del TLB, la magia de la memoria mediante el recuento de referencias en CoW, hasta la despiadada heurística del OOM Killer, en lo más profundo se esconde la sabiduría de las ciencias de la computación sobre “cómo abstraer los limitados recursos físicos de manera segura y veloz, brindando a los procesos una ilusión infinita”.
Comprender los mecanismos de bajo nivel es indispensable no solo para la optimización en lenguajes de programación de sistemas como C/C++ y Rust (diseño de estructuras de datos conscientes de las líneas de caché y el uso efectivo de mmap), sino también para entender profundamente el tiempo de inactividad (STW) del recolector de basura (GC) y el comportamiento de los asignadores de memoria (jemalloc, tcmalloc) en lenguajes de alto nivel como Go y Java. Quitar el velo de “magia” a los sistemas y sentir directamente los latidos del hardware y del kernel abrirá seguramente el camino para convertirse en un arquitecto destacado, capaz de diseñar software más refinado y escalable.