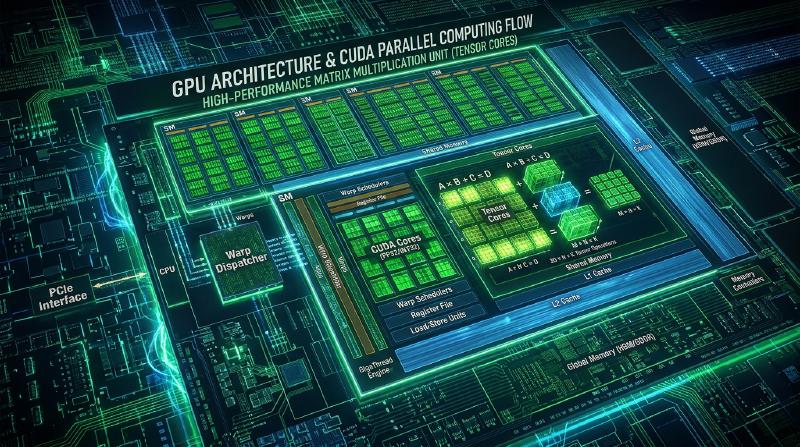
Arquitectura masivamente paralela de la GPU y la física de CUDA: Principios de cálculo de SIMT, Warps y Tensor Cores
La tecnología fundamental que respalda la ciencia computacional avanzada moderna, la inteligencia artificial, el aprendizaje profundo (Deep Learning) y los gráficos por computadora de alta definición es la GPU (Graphics Processing Unit). En este artículo, analizaremos profundamente la arquitectura de la GPU y los aspectos físicos y de hardware de CUDA (Compute Unified Device Architecture), la plataforma de computación paralela que opera sobre ella. En lugar de una simple sintaxis de programación, desglosaremos a fondo “por qué el hardware está diseñado de esta manera” y “cómo logra un rendimiento de cálculo extremo” desde la perspectiva de los multiprocesadores de transmisión (SM), el modelo de ejecución SIMT, la programación de warps, los Tensor Cores y la jerarquía de memoria.
Capítulo 1: El punto de divergencia en la filosofía de diseño entre CPU y GPU
1.1 Búsqueda de baja latencia vs Búsqueda de alto rendimiento (throughput)
Las CPU (Central Processing Unit), que son procesadores de propósito general, y las GPU, especializadas en el procesamiento paralelo, tienen filosofías de diseño fundamentalmente diferentes debido a su historia. La CPU ha evolucionado bajo la premisa suprema de la “baja latencia (minimización del retraso)”, es decir, “cómo terminar una sola tarea (hilo) lo más rápido posible”. Por otro lado, la GPU busca el “alto rendimiento (maximización del volumen de procesamiento)”, es decir, “cuántas tareas pueden agruparse para completarse por unidad de tiempo en su conjunto”.
Las CPU deben realizar rápidamente tareas impredecibles como el control del sistema operativo, la ejecución de aplicaciones con complejas condiciones de bifurcación y el procesamiento de interrupciones aleatorias del usuario. Por esto, están equipadas con circuitos avanzados de predicción de saltos, ejecución fuera de orden (un mecanismo que ejecuta instrucciones cambiando su orden) y enormes cachés L1/L2/L3, ocultando así la latencia de acceso a la memoria mientras maximizan el rendimiento de un solo hilo al extremo.
En contraste, la GPU nació para procesar tareas altamente paralelizables, como aplicar la misma operación de sombreado a millones de píxeles en la pantalla al mismo tiempo. En lugar de dedicar el área del chip (die) a circuitos de control complejos o cachés enormes, se optó por empacar tantas unidades aritméticas simples (ALU: Arithmetic Logic Unit) como fuera posible.
1.2 Distribución del área del chip entre caché, circuitos de control y ALU
La manera en que se distribuye el área limitada (presupuesto de transistores) del chip de silicio (die) determina las diferencias en la arquitectura de ambos.
- Distribución del área del chip de la CPU: Más de la mitad del chip está ocupado por una gran memoria caché (SRAM) y circuitos de control avanzados (predicción de saltos, obtención de instrucciones, decodificación, programación, etc.). La proporción ocupada por las ALU que realizan las operaciones reales es relativamente pequeña.
- Distribución del área del chip de la GPU: La memoria caché y los circuitos de control se mantienen al mínimo necesario, y la mayor parte del chip está ocupada por miles o decenas de miles de ALU (núcleos CUDA).
La GPU no oculta la latencia de acceso a la memoria mediante cachés, sino mediante el “cambio de contexto” (context switching). Mientras un grupo de hilos espera la llegada de datos de la memoria, ejecuta inmediatamente las operaciones de otro grupo de hilos, manteniendo así a las unidades de procesamiento siempre activas (alta ocupación). Esta es la implementación física de la “búsqueda de alto rendimiento” en la GPU. Dado que el multihilo a nivel de hardware (Hardware Multithreading) se realiza de forma extremadamente ligera, se asume la existencia de miles a decenas de miles de hilos concurrentes.
Capítulo 2: La esencia del modelo de ejecución SIMT
2.1 Diferencias entre SIMD y SIMT
Como clasificación del procesamiento paralelo existe la taxonomía de Flynn, y el modelo de ejecución de la GPU a menudo se compara con SIMD (Single Instruction, Multiple Data). Las instrucciones de extensión vectorial de la CPU (como AVX) son puramente SIMD, procesando múltiples datos con una sola instrucción (por ejemplo, ocho números de coma flotante de 32 bits almacenados en un registro de 256 bits). En SIMD, es extremadamente difícil ejecutar diferentes bifurcaciones (if-else) para cada elemento de los datos.
Por otro lado, el modelo de ejecución de CUDA propuesto por NVIDIA se denomina SIMT (Single Instruction, Multiple Threads). En SIMT, varios “hilos” independientes forman grupos (llamados “warps”, de los que hablaremos más adelante) y comparten y ejecutan la misma instrucción. Sin embargo, a diferencia de SIMD, cada hilo en SIMT tiene su estado de registro independiente y un contador de dirección de instrucción (en el modelo de programación). Esto permite a los programadores escribir código como si cada hilo funcionara de manera independiente.
2.2 El “Warp” como unidad de 32 hilos
El hardware de la GPU no programa los hilos individualmente, sino que los gestiona y ejecuta en unidades de 32 hilos agrupados llamados “Warp”. (En las GPU de AMD, esto se conoce como Wavefront y a veces se utilizan unidades de 64 hilos).
La unidad de obtención y decodificación de instrucciones dentro del multiprocesador de transmisión (SM) obtiene una instrucción por warp y emite (despacha) la misma instrucción a los 32 hilos del warp. Es decir, los 32 hilos dentro de un warp ejecutan físicamente y al mismo tiempo la misma instrucción sobre sus propios datos diferentes. Este es el núcleo de SIMT.
2.3 La penalización física de la divergencia de warp (Warp Divergence)
Aunque cada hilo puede comportarse como si tuviera su propio contador de programa independiente, físicamente todos los hilos del warp deben ejecutar la misma instrucción. Entonces, ¿qué sucede si hay una bifurcación condicional como if-else en el código, y la condición resulta verdadera para algunos hilos y falsa para otros dentro del mismo warp?
Este fenómeno se denomina divergencia de warp (Warp Divergence).
Cuando ocurre una divergencia de warp, el hardware procesa los siguientes pasos:
- Primero, ejecuta la instrucción solo para los hilos en los que la condición
iffue verdadera (hilos activos). Durante este tiempo, los hilos en los que la condición fue falsa son “enmascarados” (desactivados) y no se escriben sus resultados de cálculo. - Luego, pasa a la condición
else(o la ruta para cuando la condición es falsa), activando ahora los hilos que antes estaban enmascarados y enmascarando a los que fueron verdaderos para ejecutar la instrucción.
En otras palabras, cuando hay múltiples rutas de bifurcación, el hardware se ve obligado a ejecutarlas de manera serial (secuencial) en lugar de paralela. Como ejemplo extremo, si los 32 hilos de un warp siguen 32 rutas de bifurcación diferentes, el tiempo de ejecución se multiplicará por 32. La divergencia de warp es una de las principales causas de la drástica caída en el rendimiento de cálculo de la GPU y es el antipatrón que más debe evitarse en el diseño de algoritmos. Físicamente, significa que ocurren “ciclos inútiles” en los que la ALU consume energía, pero al estar enmascarada, no genera resultados de cálculo válidos.
Capítulo 3: Anatomía del hardware del Multiprocesador de Transmisión (SM)
La GPU está compuesta por un conjunto de numerosos Multiprocesadores de Transmisión (SM: Streaming Multiprocessor). El SM es el verdadero motor de cálculo de la GPU. En arquitecturas modernas (ej: Hopper H100), hay más de 100 SM integrados en un solo chip de GPU.
3.1 Estructura del pipeline dentro del SM
El SM se divide internamente en varias subparticiones (generalmente 4), cada una con su propio programador de warps (Warp Scheduler) y unidad de despacho (Dispatch Unit).
- Programador de Warps (Warp Scheduler): Selecciona un warp que esté listo para ejecutarse (cuando sus registros y memoria estén preparados). El programador de la GPU puede cambiar de warp sin coste (zero overhead), lo que es clave para ocultar la latencia de acceso a la memoria.
- Unidad de Despacho (Dispatch Unit): Emite instrucciones a los warps programados.
- Núcleo CUDA (CUDA Core - INT32 / FP32 / FP64 ALU): La unidad que realiza las operaciones matemáticas de enteros y de punto flotante reales.
- Unidad de Carga/Almacenamiento (LD/ST Unit): Se encarga de leer y escribir en la memoria.
- Unidad de Funciones Especiales (SFU): Hardware dedicado a calcular rápidamente funciones trascendentales como seno, coseno, exponencial y recíprocos.
El pipeline de instrucciones está diseñado con mucha profundidad e incluye etapas de obtención, decodificación, programación, lectura de registros, ejecución (varios ciclos) y escritura. La latencia de una operación FMA (Fused Multiply-Add) en FP32 suele tomar desde varios hasta más de diez ciclos, pero al emitir instrucciones de un warp diferente en cada ciclo, el pipeline se mantiene siempre lleno.
3.2 El archivo de registros masivo y la presión de registros
El SM incluye un archivo de registros (Register File) masivamente grande, sin comparación con la CPU (ej: 64KB a 256KB de SRAM por SM). Esto es para retener los contextos de los miles de hilos que se ejecutan simultáneamente en el SM.
Los cambios de contexto se completan en cero ciclos porque no es necesario guardar (spill) el estado de los registros de un hilo en la memoria. Sin embargo, a medida que aumenta la cantidad de registros utilizados por hilo, la cantidad de warps que se pueden lanzar simultáneamente dentro del SM (ocupación) disminuye. Esto se conoce como presión de registros (Register Pressure). Si los registros se agotan, los datos se vierten en la memoria local lenta (físicamente parte de la memoria global), causando una caída desastrosa en el rendimiento.
3.3 Memoria Compartida (Shared Memory) y conflictos de banco
El SM contiene la memoria compartida (Shared Memory), una memoria en el chip ultrarrápida que el programador puede controlar explícitamente. Comparte la misma área física de SRAM que la caché L1, pero funciona como un caché de datos explícito, utilizado para compartir datos y sincronizar hilos dentro de un bloque.
La estructura física de la memoria compartida se divide en múltiples módulos independientes (generalmente 32) llamados bancos de memoria (Memory Banks). Las direcciones consecutivas de 32 bits se intercalan (asignan) en diferentes bancos.
Si los 32 hilos de un warp acceden a diferentes bancos simultáneamente, los accesos se procesan completamente en paralelo (en 1 ciclo). Esto se denomina acceso libre de conflictos de banco. Sin embargo, si múltiples hilos intentan acceder a diferentes direcciones del mismo banco simultáneamente, las solicitudes se serializan y se incurre en una penalización (retraso). Esto se conoce como conflicto de banco (Bank Conflict). Por ejemplo, en un conflicto de banco de 2 vías, el tiempo de acceso se duplica, y en el peor de los casos, en un conflicto de 32 vías, se retrasa 32 veces. En algoritmos como la transposición de matrices, el acceso con saltos (stride access) causa graves conflictos de banco, por lo que es esencial emplear técnicas de optimización avanzadas usando “padding” (relleno con datos ficticios para desplazar las direcciones de memoria) para evitarlos.
Capítulo 4: El pipeline de operaciones de multiplicación y suma de los Tensor Cores
Introducido por primera vez en la arquitectura Volta, el hardware revolucionario que impulsó exponencialmente el rendimiento de las GPUs subsecuentes es el Tensor Core. El desarrollo explosivo de la IA y el aprendizaje profundo no se podría explicar sin los Tensor Cores.
4.1 Implementación en hardware de la multiplicación y suma de matrices (MMA)
Gran parte de los cálculos del aprendizaje profundo consiste en la multiplicación de matrices (GEMM: General Matrix Multiply) entre las matrices de pesos de las redes neuronales y los datos de entrada. La fórmula es $D = A \times B + C$ (donde $A, B$ son matrices de entrada, y $C$ es la matriz acumuladora).
En los núcleos CUDA tradicionales, esta multiplicación de matrices se calculaba elemento por elemento usando instrucciones FMA (Fused Multiply-Add). En contraste, el Tensor Core es un circuito dedicado que ejecuta la multiplicación y suma de matrices pequeñas (ej: 4x4 o 16x16) a nivel de hardware en 1 ciclo (o unos pocos ciclos).
Físicamente, decenas a cientos de multiplicadores y un enorme árbol de suma están conectados directamente por cables, completando la operación de multiplicación y acumulación de una vez sin tener que escribir resultados intermedios en los registros. Esto permite un rendimiento computacional por unidad de área (TFLOPS) órdenes de magnitud más alto en comparación con los núcleos CUDA normales.
4.2 El secreto de la precisión mixta (Mixed-Precision)
Otra esencia de los Tensor Cores es el soporte para operaciones de Precisión Mixta (Mixed-Precision). En el aprendizaje profundo, hay muchas situaciones durante el proceso de cálculo que no requieren alta precisión (FP32/FP64). Los Tensor Cores tienen un pipeline en el que cargan las matrices de entrada $A$ y $B$ en baja precisión (FP16, BF16 o incluso inferior como FP8, INT8, INT4), realizan la multiplicación interna en baja precisión y luego realizan el proceso de suma (acumulación) en una precisión más alta (FP32 o INT32).
- FP16 / BF16: El estándar para entrenamiento. BF16 (Bfloat16) tiene la misma parte exponente de 8 bits que FP32, por lo que su amplio rango dinámico ayuda a prevenir la desaparición del gradiente.
- FP8 / INT8 / INT4: El as en la manga para acelerar la inferencia. Dado que también se reduce la cantidad de transferencia de datos (ancho de banda de memoria), el rendimiento mejora drásticamente.
En la arquitectura Hopper, se introdujeron los “FP8 Tensor Core” que aceleran espectacularmente los cálculos de los modelos Transformer, logrando teóricamente docenas de veces más rendimiento en comparación con FP32. Desde el lado del software (CUDA), a través de la API wmma (Warp-Level Matrix Multiply and Accumulate) o la instrucción PTX mma.sync, se conducen directamente los Tensor Cores, y los hilos dentro del warp colaboran en un procesamiento colectivo extremadamente complejo para cargar, calcular y almacenar fragmentos de la matriz en los registros.
Capítulo 5: Jerarquía de memoria en CUDA y técnicas de optimización
No importa cuán alta sea la capacidad de cálculo de la GPU, si el suministro de datos se convierte en un cuello de botella, el rendimiento no será óptimo (problema del muro de memoria). No es exagerado decir que el 90% de la optimización en la programación de CUDA es la “optimización del acceso a la memoria”.
5.1 Acceso coalescente en la memoria global
La memoria global, que es la memoria principal de la GPU (HBM o GDDR), tiene un ancho de banda muy amplio (por ejemplo, varios TB/s), pero su latencia también es muy alta, de varios cientos de ciclos.
El principio absoluto para maximizar la eficiencia de acceso a la memoria global es el acceso coalescente (Coalescing). El controlador de memoria de la GPU accede a la memoria en transacciones de 32 bytes, 64 bytes o 128 bytes. Cuando los 32 hilos de un warp acceden a la memoria, si sus direcciones de memoria caen dentro de un área continua (dentro de un límite alineado de 128 bytes), el hardware combina (coalesce) estas solicitudes en una sola transacción de memoria para procesarlas.
Por el contrario, si los hilos acceden a direcciones aleatorias o realizan accesos espaciados (con saltos), no se agrupan y se generan múltiples transacciones. Esto se denomina “acceso no coalescente”, y es un error de rendimiento fatal que puede reducir el ancho de banda efectivo de la memoria a una décima parte o menos.
5.2 Ejemplo de código en CUDA C++: Optimización de la transposición de matrices y memoria compartida
A continuación, se muestra un ejemplo de código kernel optimizado para la transposición de matrices (Matrix Transpose), que evita los accesos no coalescentes y utiliza la memoria compartida para mejorar drásticamente el rendimiento.
| |
Los 3 puntos clave de este código son:
- Coalescencia en la lectura: La lectura desde
idatase realiza en la dirección X dondethreadIdx.xes continuo, logrando un acceso completamente coalescente. - Coalescencia en la escritura: La escritura en
odatatambién está diseñada para ser continua en la dirección dethreadIdx.xal intercambiar las coordenadas del bloque, logrando la coalescencia. - Padding en la memoria compartida: Al desplazar por un elemento (
tile[TILE_DIM][TILE_DIM + 1]) (padding), se eliminan por completo los conflictos de banco cuando se accede en la dirección de la columna (tile[threadIdx.x][threadIdx.y + j]) durante la escritura.
5.3 Jerarquía de cachés y memorias especiales
- Política de caché L1/L2: En arquitecturas de GPU recientes, los programadores pueden controlar el comportamiento de la caché mediante pistas utilizando instrucciones PTX (como
.ca,.cg,.cs). Por ejemplo, los datos que solo se acceden una vez pueden omitir la caché L2 (acceso de flujo o streaming) para evitar contaminar la caché. - Memoria de texturas / Memoria constante: La memoria de texturas, especializada en el procesamiento de imágenes, aprovecha un caché dedicado para accesos que tienen localidad espacial en 2D. La memoria constante cuenta con una eficiencia extremadamente alta para accesos de transmisión (broadcast) donde todos los hilos leen la misma constante.
Capítulo 6: El futuro de la GPU en la era del aprendizaje profundo
La frontera actual de la ciencia computacional no es solo el aumento de rendimiento de una única GPU, sino la escalabilidad de todo el sistema en su conjunto.
6.1 Interconexión ultrarrápida con NVLink y NVSwitch
Los enormes modelos de lenguaje a gran escala (LLM) no pueden caber en la memoria de una sola GPU (por ejemplo, 80 GB o 144 GB). Para realizar la paralelización de modelos (Tensor Parallel o Pipeline Parallel), es necesario intercambiar terabytes de datos por segundo entre las GPU. Dado que el bus PCIe (PCI Express) tradicional no puede cubrir este ancho de banda, NVIDIA desarrolló su propia interconexión de alta velocidad llamada NVLink. Además, a través de chips de conmutación llamados NVSwitch, es posible conectar 8 o hasta 256 GPUs en un clúster utilizando conmutadores de barra cruzada (crossbar switches) sin bloqueo, comportándose como si fueran una sola GPU gigante.
6.2 Transformer Engine y el ecosistema FP8
Para optimizar la arquitectura Transformer, que se ha convertido en el estándar de facto no solo en el procesamiento del lenguaje natural, sino también en el reconocimiento de imágenes y voz, la arquitectura Hopper incorpora un mecanismo de colaboración de hardware y software dedicado llamado Transformer Engine. Este mecanismo monitoriza dinámicamente las estadísticas de los tensores y cambia automáticamente la precisión del cálculo entre FP8 y FP16 para cada capa (Dynamic Scaling). Así, previene la degradación de la precisión mientras logra velocidades de cálculo extremas y ahorro de ancho de banda de memoria.
6.3 Leyes de escala de los clústeres de GPU y perspectivas futuras
Como indican las “Scaling Laws (Leyes de escala)” de OpenAI, la IA continúa mejorando su rendimiento a medida que se aumenta el número de parámetros del modelo y la cantidad de cálculo. Junto con esto, la GPU ha evolucionado de ser un simple procesador a que “el centro de datos en sí se convierta en una sola GPU gigante (supercomputadora)” al conectar decenas de miles de unidades mediante fibra óptica.
El futuro de la evolución de la arquitectura se dirigirá probablemente hacia la introducción de la fotónica de silicio (interconexiones ópticas), CPO (Co-Packaged Optics) y la sofisticación adicional de las tecnologías de apilamiento 3D, pasando de SRAM a HBM. Sin embargo, el ADN inmutable de la GPU desde su nacimiento, que es la “maximización del rendimiento mediante el procesamiento paralelo”, seguirá abriendo el camino hacia las fronteras de la ciencia computacional.
【Análisis Adicional】 Análisis matemático de la programación y la ocupación en la GPU
title: “Arquitectura masivamente paralela de los procesadores de cálculo gráfico y la física de CUDA: Principios de cálculo de SIMT, Warps y Tensor Cores” description: “Diseño interno de los procesadores de cálculo gráfico que persiguen el máximo rendimiento. La esencia de SM, la programación de warps, Tensor Cores y la optimización de la memoria compartida.” slug: “gpu-architecture-cuda-parallel-computing” date: “2026-10-03T05:00:00+09:00” categories: [“architecture”, “technology”] tags: [“gpu”, “cuda”, “parallel-computing”, “hardware”] image: “eyecatch.jpg”
Arquitectura masivamente paralela de los procesadores de cálculo gráfico y la física de CUDA: Principios de cálculo de SIMT, Warps y Tensor Cores
La tecnología fundamental que respalda la ciencia computacional avanzada moderna, la inteligencia artificial, el aprendizaje profundo (Deep Learning) y los gráficos por computadora de alta definición es el procesador de cálculo gráfico (Graphics Processing Unit). En este artículo, analizaremos profundamente la arquitectura de los procesadores de cálculo gráfico y los aspectos físicos y de hardware de CUDA (Compute Unified Device Architecture), la plataforma de computación paralela que opera sobre ella. En lugar de una simple sintaxis de programación, desglosaremos a fondo “por qué el hardware está diseñado de esta manera” y “cómo logra un rendimiento de cálculo extremo” desde la perspectiva de los multiprocesadores de transmisión (SM), el modelo de ejecución SIMT, la programación de warps, los Tensor Cores y la jerarquía de memoria.
Suplemento al Capítulo 1: El punto de divergencia en la filosofía de diseño entre procesadores de propósito general y procesadores de cálculo gráfico
1.1 Búsqueda de baja latencia vs Búsqueda de alto rendimiento (throughput)
Los procesadores de cálculo de propósito general (Central Processing Unit) y los procesadores de cálculo gráfico, especializados en el procesamiento paralelo, tienen filosofías de diseño fundamentalmente diferentes debido a su historia. El procesador de propósito general ha evolucionado bajo la premisa suprema de la “baja latencia (minimización del retraso)”, es decir, “cómo terminar una sola tarea (hilo) lo más rápido posible”. Por otro lado, el procesador de cálculo gráfico busca el “alto rendimiento (maximización del volumen de procesamiento)”, es decir, “cuántas tareas pueden agruparse para completarse por unidad de tiempo en su conjunto”.
Los procesadores de propósito general deben realizar rápidamente tareas impredecibles como el control del sistema operativo, la ejecución de aplicaciones con complejas condiciones de bifurcación y el procesamiento de interrupciones aleatorias del usuario. Por esto, están equipados con circuitos avanzados de predicción de saltos, ejecución fuera de orden (un mecanismo que ejecuta instrucciones cambiando su orden) y enormes cachés L1/L2/L3, ocultando así la latencia de acceso a la memoria mientras maximizan el rendimiento de un solo hilo al extremo.
En contraste, el procesador de cálculo gráfico nació para procesar tareas altamente paralelizables, como aplicar la misma operación de sombreado a millones de píxeles en la pantalla al mismo tiempo. En lugar de dedicar el área del chip (die) a circuitos de control complejos o cachés enormes, se optó por empacar tantas unidades aritméticas simples (ALU: Arithmetic Logic Unit) como fuera posible.
1.2 Distribución del área del chip entre caché, circuitos de control y ALU
La manera en que se distribuye el área limitada (presupuesto de transistores) del chip de silicio (die) determina las diferencias en la arquitectura de ambos.
- Distribución del área del chip del procesador de propósito general: Más de la mitad del chip está ocupado por una gran memoria caché (SRAM) y circuitos de control avanzados (predicción de saltos, obtención de instrucciones, decodificación, programación, etc.). La proporción ocupada por las ALU que realizan las operaciones reales es relativamente pequeña.
- Distribución del área del chip del procesador de cálculo gráfico: La memoria caché y los circuitos de control se mantienen al mínimo necesario, y la mayor parte del chip está ocupada por miles o decenas de miles de ALU (núcleos CUDA).
El procesador de cálculo gráfico no oculta la latencia de acceso a la memoria mediante cachés, sino mediante el “cambio de contexto” (context switching). Mientras un grupo de hilos espera la llegada de datos de la memoria, ejecuta inmediatamente las operaciones de otro grupo de hilos, manteniendo así a las unidades de procesamiento siempre activas (alta ocupación). Esta es la implementación física de la “búsqueda de alto rendimiento” en el procesador de cálculo gráfico. Dado que el multihilo a nivel de hardware (Hardware Multithreading) se realiza de forma extremadamente ligera, se asume la existencia de miles a decenas de miles de hilos concurrentes.
Suplemento al Capítulo 2: La esencia del modelo de ejecución SIMT
2.1 Diferencias entre SIMD y SIMT
Como clasificación del procesamiento paralelo existe la taxonomía de Flynn, y el modelo de ejecución del procesador de cálculo gráfico a menudo se compara con SIMD (Single Instruction, Multiple Data). Las instrucciones de extensión vectorial del procesador de propósito general (como AVX) son puramente SIMD, procesando múltiples datos con una sola instrucción (por ejemplo, ocho números de coma flotante de 32 bits almacenados en un registro de 256 bits). En SIMD, es extremadamente difícil ejecutar diferentes bifurcaciones (if-else) para cada elemento de los datos.
Por otro lado, el modelo de ejecución de CUDA propuesto por NVIDIA se denomina SIMT (Single Instruction, Multiple Threads). En SIMT, varios “hilos” independientes forman grupos (llamados “warps”, de los que hablaremos más adelante) y comparten y ejecutan la misma instrucción. Sin embargo, a diferencia de SIMD, cada hilo en SIMT tiene su estado de registro independiente y un contador de dirección de instrucción (en el modelo de programación). Esto permite a los programadores escribir código como si cada hilo funcionara de manera independiente.
2.2 El “Warp” como unidad de 32 hilos
El hardware del procesador de cálculo gráfico no programa los hilos individualmente, sino que los gestiona y ejecuta en unidades de 32 hilos agrupados llamados “Warp”. (En los procesadores de cálculo gráfico de AMD, esto se conoce como Wavefront y a veces se utilizan unidades de 64 hilos).
La unidad de obtención y decodificación de instrucciones dentro del multiprocesador de transmisión (SM) obtiene una instrucción por warp y emite (despacha) la misma instrucción a los 32 hilos del warp. Es decir, los 32 hilos dentro de un warp ejecutan físicamente y al mismo tiempo la misma instrucción sobre sus propios datos diferentes. Este es el núcleo de SIMT.
2.3 La penalización física de la divergencia de warp (Warp Divergence)
Aunque cada hilo puede comportarse como si tuviera su propio contador de programa independiente, físicamente todos los hilos del warp deben ejecutar la misma instrucción. Entonces, ¿qué sucede si hay una bifurcación condicional como if-else en el código, y la condición resulta verdadera para algunos hilos y falsa para otros dentro del mismo warp?
Este fenómeno se denomina divergencia de warp (Warp Divergence).
Cuando ocurre una divergencia de warp, el hardware procesa los siguientes pasos:
- Primero, ejecuta la instrucción solo para los hilos en los que la condición
iffue verdadera (hilos activos). Durante este tiempo, los hilos en los que la condición fue falsa son “enmascarados” (desactivados) y no se escriben sus resultados de cálculo. - Luego, pasa a la condición
else(o la ruta para cuando la condición es falsa), activando ahora los hilos que antes estaban enmascarados y enmascarando a los que fueron verdaderos para ejecutar la instrucción.
En otras palabras, cuando hay múltiples rutas de bifurcación, el hardware se ve obligado a ejecutarlas de manera serial (secuencial) en lugar de paralela. Como ejemplo extremo, si los 32 hilos de un warp siguen 32 rutas de bifurcación diferentes, el tiempo de ejecución se multiplicará por 32. La divergencia de warp es una de las principales causas de la drástica caída en el rendimiento de cálculo del procesador de cálculo gráfico y es el antipatrón que más debe evitarse en el diseño de algoritmos. Físicamente, significa que ocurren “ciclos inútiles” en los que la ALU consume energía, pero al estar enmascarada, no genera resultados de cálculo válidos.
Suplemento al Capítulo 3: Anatomía del hardware del Multiprocesador de Transmisión (SM)
El procesador de cálculo gráfico está compuesto por un conjunto de numerosos Multiprocesadores de Transmisión (SM: Streaming Multiprocessor). El SM es el verdadero motor de cálculo del procesador de cálculo gráfico. En arquitecturas modernas (ej: Hopper H100), hay más de 100 SM integrados en un solo chip de procesador de cálculo gráfico.
3.1 Estructura del pipeline dentro del SM
El SM se divide internamente en varias subparticiones (generalmente 4), cada una con su propio programador de warps (Warp Scheduler) y unidad de despacho (Dispatch Unit).
- Programador de Warps (Warp Scheduler): Selecciona un warp que esté listo para ejecutarse (cuando sus registros y memoria estén preparados). El programador del procesador de cálculo gráfico puede cambiar de warp sin coste (zero overhead), lo que es clave para ocultar la latencia de acceso a la memoria.
- Unidad de Despacho (Dispatch Unit): Emite instrucciones a los warps programados.
- Núcleo CUDA (CUDA Core - INT32 / FP32 / FP64 ALU): La unidad que realiza las operaciones matemáticas de enteros y de punto flotante reales.
- Unidad de Carga/Almacenamiento (LD/ST Unit): Se encarga de leer y escribir en la memoria.
- Unidad de Funciones Especiales (SFU): Hardware dedicado a calcular rápidamente funciones trascendentales como seno, coseno, exponencial y recíprocos.
El pipeline de instrucciones está diseñado con mucha profundidad e incluye etapas de obtención, decodificación, programación, lectura de registros, ejecución (varios ciclos) y escritura. La latencia de una operación FMA (Fused Multiply-Add) en FP32 suele tomar desde varios hasta más de diez ciclos, pero al emitir instrucciones de un warp diferente en cada ciclo, el pipeline se mantiene siempre lleno.
3.2 El archivo de registros masivo y la presión de registros
El SM incluye un archivo de registros (Register File) masivamente grande, sin comparación con un procesador de propósito general (ej: 64KB a 256KB de SRAM por SM). Esto es para retener los contextos de los miles de hilos que se ejecutan simultáneamente en el SM.
Los cambios de contexto se completan en cero ciclos porque no es necesario guardar (spill) el estado de los registros de un hilo en la memoria. Sin embargo, a medida que aumenta la cantidad de registros utilizados por hilo, la cantidad de warps que se pueden lanzar simultáneamente dentro del SM (ocupación) disminuye. Esto se conoce como presión de registros (Register Pressure). Si los registros se agotan, los datos se vierten en la memoria local lenta (físicamente parte de la memoria global), causando una caída desastrosa en el rendimiento.
3.3 Memoria Compartida (Shared Memory) y conflictos de banco
El SM contiene la memoria compartida (Shared Memory), una memoria en el chip ultrarrápida que el programador puede controlar explícitamente. Comparte la misma área física de SRAM que la caché L1, pero funciona como un caché de datos explícito, utilizado para compartir datos y sincronizar hilos dentro de un bloque.
La estructura física de la memoria compartida se divide en múltiples módulos independientes (generalmente 32) llamados bancos de memoria (Memory Banks). Las direcciones consecutivas de 32 bits se intercalan (asignan) en diferentes bancos.
Si los 32 hilos de un warp acceden a diferentes bancos simultáneamente, los accesos se procesan completamente en paralelo (en 1 ciclo). Esto se denomina acceso libre de conflictos de banco. Sin embargo, si múltiples hilos intentan acceder a diferentes direcciones del mismo banco simultáneamente, las solicitudes se serializan y se incurre en una penalización (retraso). Esto se conoce como conflicto de banco (Bank Conflict). Por ejemplo, en un conflicto de banco de 2 vías, el tiempo de acceso se duplica, y en el peor de los casos, en un conflicto de 32 vías, se retrasa 32 veces. En algoritmos como la transposición de matrices, el acceso con saltos (stride access) causa graves conflictos de banco, por lo que es esencial emplear técnicas de optimización avanzadas usando “padding” (relleno con datos ficticios para desplazar las direcciones de memoria) para evitarlos.
Suplemento al Capítulo 4: El pipeline de operaciones de multiplicación y suma de los Tensor Cores
Introducido por primera vez en la arquitectura Volta, el hardware revolucionario que impulsó exponencialmente el rendimiento de los procesadores de cálculo gráfico subsecuentes es el Tensor Core. El desarrollo explosivo de la IA y el aprendizaje profundo no se podría explicar sin los Tensor Cores.
4.1 Implementación en hardware de la multiplicación y suma de matrices (MMA)
Gran parte de los cálculos del aprendizaje profundo consiste en la multiplicación de matrices (GEMM: General Matrix Multiply) entre las matrices de pesos de las redes neuronales y los datos de entrada. La fórmula es $D = A \times B + C$ (donde $A, B$ son matrices de entrada, y $C$ es la matriz acumuladora).
En los núcleos CUDA tradicionales, esta multiplicación de matrices se calculaba elemento por elemento usando instrucciones FMA (Fused Multiply-Add). En contraste, el Tensor Core es un circuito dedicado que ejecuta la multiplicación y suma de matrices pequeñas (ej: 4x4 o 16x16) a nivel de hardware en 1 ciclo (o unos pocos ciclos).
Físicamente, decenas a cientos de multiplicadores y un enorme árbol de suma están conectados directamente por cables, completando la operación de multiplicación y acumulación de una vez sin tener que escribir resultados intermedios en los registros. Esto permite un rendimiento computacional por unidad de área (TFLOPS) órdenes de magnitud más alto en comparación con los núcleos CUDA normales.
4.2 El secreto de la precisión mixta (Mixed-Precision)
Otra esencia de los Tensor Cores es el soporte para operaciones de Precisión Mixta (Mixed-Precision). En el aprendizaje profundo, hay muchas situaciones durante el proceso de cálculo que no requieren alta precisión (FP32/FP64). Los Tensor Cores tienen un pipeline en el que cargan las matrices de entrada $A$ y $B$ en baja precisión (FP16, BF16 o incluso inferior como FP8, INT8, INT4), realizan la multiplicación interna en baja precisión y luego realizan el proceso de suma (acumulación) en una precisión más alta (FP32 o INT32).
- FP16 / BF16: El estándar para entrenamiento. BF16 (Bfloat16) tiene la misma parte exponente de 8 bits que FP32, por lo que su amplio rango dinámico ayuda a prevenir la desaparición del gradiente.
- FP8 / INT8 / INT4: El as en la manga para acelerar la inferencia. Dado que también se reduce la cantidad de transferencia de datos (ancho de banda de memoria), el rendimiento mejora drásticamente.
En la arquitectura Hopper, se introdujeron los “FP8 Tensor Core” que aceleran espectacularmente los cálculos de los modelos Transformer, logrando teóricamente docenas de veces más rendimiento en comparación con FP32. Desde el lado del software (CUDA), a través de la API wmma (Warp-Level Matrix Multiply and Accumulate) o la instrucción PTX mma.sync, se conducen directamente los Tensor Cores, y los hilos dentro del warp colaboran en un procesamiento colectivo extremadamente complejo para cargar, calcular y almacenar fragmentos de la matriz en los registros.
Suplemento al Capítulo 5: Jerarquía de memoria en CUDA y técnicas de optimización
No importa cuán alta sea la capacidad de cálculo del procesador de cálculo gráfico, si el suministro de datos se convierte en un cuello de botella, el rendimiento no será óptimo (problema del muro de memoria). No es exagerado decir que el 90% de la optimización en la programación de CUDA es la “optimización del acceso a la memoria”.
5.1 Acceso coalescente en la memoria global
La memoria global, que es la memoria principal del procesador de cálculo gráfico (HBM o GDDR), tiene un ancho de banda muy amplio (por ejemplo, varios TB/s), pero su latencia también es muy alta, de varios cientos de ciclos.
El principio absoluto para maximizar la eficiencia de acceso a la memoria global es el acceso coalescente (Coalescing). El controlador de memoria del procesador de cálculo gráfico accede a la memoria en transacciones de 32 bytes, 64 bytes o 128 bytes. Cuando los 32 hilos de un warp acceden a la memoria, si sus direcciones de memoria caen dentro de un área continua (dentro de un límite alineado de 128 bytes), el hardware combina (coalesce) estas solicitudes en una sola transacción de memoria para procesarlas.
Por el contrario, si los hilos acceden a direcciones aleatorias o realizan accesos espaciados (con saltos), no se agrupan y se generan múltiples transacciones. Esto se denomina “acceso no coalescente”, y es un error de rendimiento fatal que puede reducir el ancho de banda efectivo de la memoria a una décima parte o menos.
5.2 Ejemplo de código en CUDA C++: Optimización de la transposición de matrices y memoria compartida
A continuación, se muestra un ejemplo de código kernel optimizado para la transposición de matrices (Matrix Transpose), que evita los accesos no coalescentes y utiliza la memoria compartida para mejorar drásticamente el rendimiento.
| |
Los 3 puntos clave de este código son:
- Coalescencia en la lectura: La lectura desde
idatase realiza en la dirección X dondethreadIdx.xes continuo, logrando un acceso completamente coalescente. - Coalescencia en la escritura: La escritura en
odatatambién está diseñada para ser continua en la dirección dethreadIdx.xal intercambiar las coordenadas del bloque, logrando la coalescencia. - Padding en la memoria compartida: Al desplazar por un elemento (
tile[TILE_DIM][TILE_DIM + 1]) (padding), se eliminan por completo los conflictos de banco cuando se accede en la dirección de la columna (tile[threadIdx.x][threadIdx.y + j]) durante la escritura.
5.3 Jerarquía de cachés y memorias especiales
- Política de caché L1/L2: En arquitecturas de procesadores de cálculo gráfico recientes, los programadores pueden controlar el comportamiento de la caché mediante pistas utilizando instrucciones PTX (como
.ca,.cg,.cs). Por ejemplo, los datos que solo se acceden una vez pueden omitir la caché L2 (acceso de flujo o streaming) para evitar contaminar la caché. - Memoria de texturas / Memoria constante: La memoria de texturas, especializada en el procesamiento de imágenes, aprovecha un caché dedicado para accesos que tienen localidad espacial en 2D. La memoria constante cuenta con una eficiencia extremadamente alta para accesos de transmisión (broadcast) donde todos los hilos leen la misma constante.
Suplemento al Capítulo 6: El futuro de los procesadores de cálculo gráfico en la era del aprendizaje profundo
La frontera actual de la ciencia computacional no es solo el aumento de rendimiento de un único procesador de cálculo gráfico, sino la escalabilidad de todo el sistema en su conjunto.
6.1 Interconexión ultrarrápida con NVLink y NVSwitch
Los enormes modelos de lenguaje a gran escala (LLM) no pueden caber en la memoria de un solo procesador de cálculo gráfico (por ejemplo, 80 GB o 144 GB). Para realizar la paralelización de modelos (Tensor Parallel o Pipeline Parallel), es necesario intercambiar terabytes de datos por segundo entre los procesadores de cálculo gráfico. Dado que el bus PCIe (PCI Express) tradicional no puede cubrir este ancho de banda, NVIDIA desarrolló su propia interconexión de alta velocidad llamada NVLink. Además, a través de chips de conmutación llamados NVSwitch, es posible conectar 8 o hasta 256 procesadores de cálculo gráfico en un clúster utilizando conmutadores de barra cruzada (crossbar switches) sin bloqueo, comportándose como si fueran un solo procesador de cálculo gráfico gigante.
6.2 Transformer Engine y el ecosistema FP8
Para optimizar la arquitectura Transformer, que se ha convertido en el estándar de facto no solo en el procesamiento del lenguaje natural, sino también en el reconocimiento de imágenes y voz, la arquitectura Hopper incorpora un mecanismo de colaboración de hardware y software dedicado llamado Transformer Engine. Este mecanismo monitoriza dinámicamente las estadísticas de los tensores y cambia automáticamente la precisión del cálculo entre FP8 y FP16 para cada capa (Dynamic Scaling). Así, previene la degradación de la precisión mientras logra velocidades de cálculo extremas y ahorro de ancho de banda de memoria.
6.3 Leyes de escala de los clústeres de procesadores de cálculo gráfico y perspectivas futuras
Como indican las “Scaling Laws (Leyes de escala)” de OpenAI, la IA continúa mejorando su rendimiento a medida que se aumenta el número de parámetros del modelo y la cantidad de cálculo. Junto con esto, el procesador de cálculo gráfico ha evolucionado de ser un simple procesador a que “el centro de datos en sí se convierta en un solo procesador de cálculo gráfico gigante (supercomputadora)” al conectar decenas de miles de unidades mediante fibra óptica.
El futuro de la evolución de la arquitectura se dirigirá probablemente hacia la introducción de la fotónica de silicio (interconexiones ópticas), CPO (Co-Packaged Optics) y la sofisticación adicional de las tecnologías de apilamiento 3D, pasando de SRAM a HBM. Sin embargo, el ADN inmutable del procesador de cálculo gráfico desde su nacimiento, que es la “maximización del rendimiento mediante el procesamiento paralelo”, seguirá abriendo el camino hacia las fronteras de la ciencia computacional.
Conclusión: Hacia el extremo de la ciencia computacional
La arquitectura de la GPU es el motor de cálculo más complejo y enfocado en el rendimiento que la humanidad haya creado jamás. Si una CPU es como “un auto de Fórmula 1 de ultra alto rendimiento”, la GPU se puede comparar con “un enorme sistema logístico de decenas de miles de camiones volquete que transportan materiales simultáneamente con movimientos coordinados”.
La ejecución de instrucciones por warp a través de SIMT, la programación de hardware que cambia entre miles de hilos en cero ciclos, el acceso coalescente que extrae el ancho de banda al máximo, y el pipeline de los Tensor Cores que ha impulsado los avances del aprendizaje profundo. Todo esto es la cristalización de la obsesión, casi locura, de los ingenieros por “cómo maximizar la cantidad total de operaciones de punto flotante dentro de los límites de las leyes de la física (velocidad de la luz, calor, energía, límites de miniaturización del silicio)”.
Para los futuros ingenieros de software, investigadores de IA y de HPC (computación de alto rendimiento), comprender la arquitectura de la GPU no es simplemente cultura general. Es una “asignatura obligatoria” para intuir qué está ocurriendo detrás de los frameworks (PyTorch o TensorFlow) y exprimir al máximo las capacidades del hardware. Evitar los conflictos de banco de memoria, eliminar la divergencia de warp y mantener el pipeline de los Tensor Cores lleno de datos. Al final de esa optimización, el futuro en el que un cálculo que antes tomaba meses en una supercomputadora, ahora se completa en unas pocas horas con un puñado de GPUs sobre un escritorio, ya es una realidad en este momento.
Ahora vivimos en la era dorada más emocionante de la arquitectura de computadoras en la historia humana. Comprender la física de CUDA y la esencia de la arquitectura masivamente paralela de la GPU para generar la próxima generación de innovación podría depender de ti, que estás leyendo este artículo.
Glosario (Glossary)
- SM (Streaming Multiprocessor): Bloque de cálculo principal de la GPU. Equivale al núcleo en una CPU, pero contiene en su interior numerosos núcleos CUDA, un programador de warps, memoria compartida, entre otros.
- SIMT (Single Instruction, Multiple Threads): Modelo de ejecución específico de la GPU donde todos los hilos dentro de un warp comparten la misma instrucción mientras operan sobre datos independientes.
- Warp: Conjunto de 32 hilos. Unidad mínima de programación y emisión de instrucciones por hardware.
- Warp Divergence (Divergencia de Warp): Fenómeno en el que las condiciones de bifurcación difieren entre los hilos dentro de un warp, causando que las rutas de ejecución se serialicen y el rendimiento disminuya.
- Tensor Core: Circuito dedicado que procesa operaciones de multiplicación y acumulación de matrices (MMA) de una vez a nivel de hardware. Especializado en acelerar el aprendizaje profundo.
- Coalesced Access (Acceso coalescente): Mecanismo en el que, cuando los hilos de un warp acceden a direcciones de memoria continuas, el hardware los combina en una sola transacción para lograr un alto ancho de banda.
- Shared Memory (Memoria compartida): Memoria ultrarrápida L1 “scratchpad” controlable por el programador integrada dentro del SM.
- Bank Conflict (Conflicto de banco): Penalización en la memoria compartida donde múltiples hilos acceden simultáneamente a diferentes direcciones del mismo banco, lo que causa la serialización de los accesos.
- Occupancy (Ocupación): Proporción real de warps que pueden estar activos simultáneamente en el SM frente a su valor máximo teórico. Cuanto mayor sea, más fácil será ocultar la latencia de acceso a la memoria.
- Register Spilling (Derrame de registros): Fenómeno donde la cantidad de registros utilizados por un hilo excede el límite del hardware, y los datos sobrantes se guardan en una memoria más lenta (memoria local).
Referencias y lista de lectura recomendada
- NVIDIA CUDA C++ Programming Guide: Documentación oficial que todo programador de CUDA debe leer. Cubre patrones de acceso a la memoria y mejores prácticas de optimización.
- NVIDIA Ampere / Hopper Architecture Whitepaper: Libro blanco oficial que detalla la implementación en hardware del pipeline de Tensor Cores, las transferencias asíncronas de memoria y el Transformer Engine.
- Computer Architecture: A Quantitative Approach (John L. Hennessy, David A. Patterson): Una obra maestra clásica sobre la arquitectura de computadoras. Permite profundizar en las diferencias de diseño entre CPU y GPU, la jerarquía de cachés y el paralelismo a nivel de instrucción.
- Programming Massively Parallel Processors: A Hands-on Approach (David B. Kirk, Wen-mei W. Hwu): Un libro de texto que explica la programación CUDA desde la perspectiva del diseño de algoritmos. Detalla implementaciones de técnicas de tiling en memoria compartida, reducción y suma de prefijos.
- Dissecting the NVIDIA Volta GPU Architecture via Microbenchmarking: Artículo académico. Una obra maestra que reveló mediante microbenchmarks las latencias de caché y el rendimiento exacto de los Tensor Cores que NVIDIA no hizo públicos.
El conocimiento de arquitectura explicado en este artículo puede volverse obsoleto en parte con la evolución del hardware, pero el principio físico fundamental de “maximizar el ancho de banda, extraer paralelismo y ocultar la latencia” seguirá perdurando como una verdad universal en la ciencia computacional.