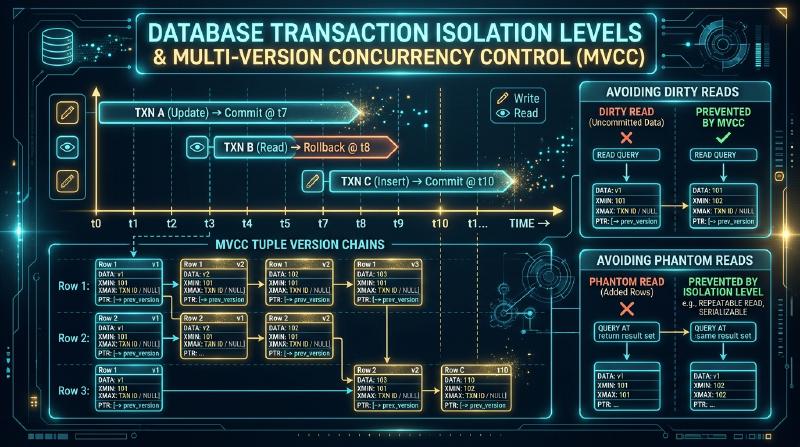
Niveles de Aislamiento de Transacciones de Bases de Datos y MVCC: La Realidad de ACID y el Control de Concurrencia Multiversión
En la arquitectura de software moderna, los sistemas de gestión de bases de datos relacionales (RDBMS) continúan siendo la piedra angular de la persistencia de datos. En su núcleo se encuentra el concepto de “transacción”, y especialmente las propiedades ACID (Atomicity, Consistency, Isolation, Durability) son ampliamente reconocidas como la teoría fundamental para construir sistemas robustos. Sin embargo, entre las propiedades ACID, la “Isolation (Aislamiento)” es el área donde existe la mayor divergencia entre la teoría y la práctica.
En este artículo, profundizaremos desde una perspectiva sumamente detallada, tanto académica como práctica, desde los antecedentes históricos de los niveles de aislamiento de transacciones de bases de datos, pasando por las limitaciones del estándar ANSI SQL-92, hasta llegar a la estructura interna del Multi-Version Concurrency Control (MVCC: Control de Concurrencia Multiversión) adoptado por los motores de bases de datos modernos. En particular, diseccionaremos las diferencias decisivas en la implementación de MVCC de los dos grandes RDBMS de código abierto, PostgreSQL y MySQL (InnoDB), y cubriremos hasta el Aislamiento de Instantáneas Serializables (SSI), que es la vanguardia de las bases de datos distribuidas, en una obra maestra de más de 12,000 caracteres en total.
Capítulo 1: El Mito de las Propiedades ACID y el Dilema del Procesamiento Concurrente
1.1 El Ideal de la Serializabilidad (Serializability)
El ideal supremo al que aspira la Isolation (Aislamiento) de las transacciones es la “Serializabilidad (Serializability)”. Esto se refiere a la propiedad de que, incluso cuando múltiples transacciones se ejecutan en paralelo de manera concurrente, el resultado de su ejecución es “equivalente al resultado que se obtendría si las transacciones se ejecutaran en serie (serial), una tras otra en algún orden”.
Cuando las transacciones $T_1$ y $T_2$ se ejecutan simultáneamente en el sistema, sin importar cómo se produzca el entrelazado (cruce de operaciones) debido a la ejecución concurrente, si el estado final de la base de datos coincide completamente con el resultado de ejecutarlas en el orden de “$T_1 \rightarrow T_2$” o “$T_2 \rightarrow T_1$”, se define que esa programación es serializable. Si se garantiza esta serializabilidad, los desarrolladores de aplicaciones pueden concentrarse en construir la lógica de negocio sin tener que preocuparse en absoluto por las inconsistencias de datos (como condiciones de carrera o sobreescrituras inadecuadas) causadas por el procesamiento concurrente.
1.2 El Colapso del Rendimiento debido a la Serialización por Bloqueo
En los primeros sistemas de bases de datos, para garantizar esta serializabilidad se adoptó un estricto mecanismo de bloqueo llamado “Bloqueo de Dos Fases (2PL: Two-Phase Locking)”. En 2PL, una transacción siempre adquiere un bloqueo (compartido o exclusivo) antes de leer o escribir datos (Fase 1: Growing Phase), y libera todos los bloqueos al final de la transacción (en el momento de confirmación o reversión) (Fase 2: Shrinking Phase).
Sin embargo, este estricto mecanismo de bloqueo tenía un defecto fatal. Era la “degradación extrema del rendimiento”.
- Las operaciones de lectura bloquean a las operaciones de escritura.
- Las operaciones de escritura bloquean a las operaciones de lectura.
- Aumento de los tiempos de espera y frecuente aparición de interbloqueos (deadlocks) debido a la contención de bloqueos.
A medida que aumentaba el tráfico y muchos usuarios accedían simultáneamente a la base de datos, la serialización completa mediante 2PL se convirtió en el cuello de botella del sistema, y el rendimiento (throughput) cayó drásticamente. Los sistemas se enfrentaron al dilema del equilibrio (trade-off) entre la “consistencia de los datos” y el “rendimiento del procesamiento concurrente (throughput)”.
1.3 Historia y Compromisos del Control de Concurrencia
Para resolver este dilema, los investigadores de ingeniería de bases de datos introdujeron el concepto de “Niveles de Aislamiento (Isolation Level)”. Esto es un “producto de compromiso” que relaja parcialmente la serializabilidad completa y permite la ocurrencia de inconsistencias de datos específicas (anomalías: Anomaly) a cambio de mejorar el rendimiento del procesamiento concurrente. Se hizo posible elegir el equilibrio entre consistencia y rendimiento de acuerdo a los requisitos de la aplicación.
Capítulo 2: Los Niveles de Aislamiento del Estándar ANSI SQL-92 y sus Críticas
2.1 Definición de los Niveles de Aislamiento por el Estándar ANSI SQL-92
En el estándar SQL “SQL-92” promulgado en 1992, se definieron 4 niveles de aislamiento basándose en 3 anomalías representativas (Phenomena) que podrían ocurrir debido al procesamiento concurrente.
Las 3 Anomalías (Phenomena) Definidas
- Dirty Read (Lectura Sucia): Fenómeno en el que la transacción $T_1$ actualiza los datos y, mientras aún no se han confirmado, otra transacción $T_2$ lee esos datos no confirmados. Si $T_1$ se revierte, $T_2$ habrá leído datos fantasma que no existen.
- Non-repeatable Read (Lectura No Repetible): Fenómeno en el que, entre que la transacción $T_1$ lee la misma fila dos veces, otra transacción $T_2$ actualiza y confirma esa fila. Los resultados de la primera y segunda lectura de $T_1$ serán diferentes.
- Phantom Read (Lectura Fantasma): Fenómeno en el que, mientras la transacción $T_1$ lee varias filas bajo una condición de búsqueda específica, otra transacción $T_2$ inserta (o elimina) y confirma nuevas filas que cumplen con esa condición. Si $T_1$ vuelve a buscar con la misma condición, el número de filas aumentará o disminuirá.
4 Niveles de Aislamiento según SQL-92
SQL-92 definió los niveles de aislamiento según el grado en que previenen la ocurrencia de estas anomalías.
- Read Uncommitted: Permite lecturas sucias (Dirty Read).
- Read Committed: Previene las lecturas sucias, pero permite las lecturas no repetibles (Non-repeatable Read) y las lecturas fantasma (Phantom Read).
- Repeatable Read: Previene las lecturas sucias y las lecturas no repetibles, pero permite las lecturas fantasma.
- Serializable: Previene todas las anomalías y garantiza la serializabilidad completa.
2.2 El Documento de Crítica de Berenson y otros: “A Critique of ANSI SQL Isolation Levels”
A primera vista, la definición del estándar SQL-92 parece muy clara y lógica. Sin embargo, el artículo de investigación “A Critique of ANSI SQL Isolation Levels” publicado en 1995 por los maestros del mundo de las bases de datos como Hal Berenson, Jim Gray (ganador del Premio Turing) y Phil Bernstein, asestó un golpe devastador a las definiciones de este estándar ANSI.
Las principales fallas del estándar SQL-92 señaladas en este artículo son las siguientes:
1. Premisa Implícita Basada en Bloqueos
La definición de SQL-92 asumía implícitamente que “la base de datos estaba implementada con un control de concurrencia basado en bloqueos (2PL)”. Sin embargo, en la década de 1990 ya estaban empezando a aparecer bases de datos que adoptaban MVCC (que se describe más adelante) y otros controles de concurrencia optimista (OCC), y la definición de anomalías basada en bloqueos se estaba quedando obsoleta.
2. Ambigüedad e Incompletitud de las Definiciones
Se señaló que las 3 anomalías definidas en SQL-92 (Dirty Read, Non-repeatable Read, Phantom Read) no eran suficientes para abarcar todas las anomalías que podrían ocurrir en el procesamiento concurrente. Por ejemplo, existe el fenómeno de la “Escritura Sucia (Dirty Write)”. Este es el fenómeno en el que los datos escritos por una transacción no confirmada son sobrescritos por otra transacción no confirmada, pero el estándar SQL-92 no menciona la escritura sucia. Aunque todos los niveles de aislamiento (incluyendo Read Uncommitted) deben prevenir la escritura sucia (de lo contrario, la consistencia interna de la base de datos colapsaría), el estándar no tocaba ese punto.
3. Descubrimiento de Nuevas Anomalías
En el artículo, se definieron varias anomalías nuevas que no existían en el estándar SQL-92. Las dos representativas son las siguientes:
- Lost Update (Actualización Perdida): Fenómeno en el que dos transacciones leen los mismos datos al mismo tiempo, y cuando cada una escribe el resultado de su cálculo, la actualización de una sobrescribe y borra la actualización de la otra.
- Write Skew (Sesgo de Escritura): Fenómeno específico del aislamiento de instantáneas que se describe más adelante.
El artículo de Berenson y otros demostró que el estándar SQL-92 no definía matemática y rigurosamente los niveles de aislamiento, causando un gran impacto en la industria de las bases de datos. En la teoría actual de bases de datos, la definición de los niveles de aislamiento de ANSI SQL-92 se trata como “algo que debe aprenderse como contexto histórico” y “como algo insuficiente como definición técnica rigurosa”.
Capítulo 3: Aislamiento de Instantáneas (Snapshot Isolation) y Sesgo de Escritura (Write Skew)
3.1 La Diferencia entre Repeatable Read y el Aislamiento de Instantáneas
Lo que atrajo especial atención en el artículo de Berenson y otros fue la propuesta de un nuevo nivel de aislamiento llamado “Aislamiento de Instantáneas (Snapshot Isolation: SI)”.
En muchas bases de datos que adoptan MVCC (como PostgreSQL y Oracle), la realidad del nivel de aislamiento proporcionado como “Repeatable Read” es, de hecho, este “Aislamiento de Instantáneas”. En el aislamiento de instantáneas, cada transacción lee desde una “instantánea (estado estático pasado)” consistente de la base de datos en el momento en que comenzó.
- No se ven en absoluto las actualizaciones realizadas por otras transacciones desde el momento en que se inició la transacción (prevención de lecturas no repetibles).
- Dado que la existencia misma de los registros se fija en el pasado, las inserciones (INSERT) realizadas por otras transacciones tampoco son visibles (prevención de lecturas fantasma).
Es decir, el aislamiento de instantáneas no solo cumple con los requisitos de “Repeatable Read” definidos por SQL-92, sino que en muchos casos también previene las “lecturas fantasma”. Entonces, ¿es el aislamiento de instantáneas equivalente a “Serializable”? La respuesta es “No”. Esto se debe a que el aislamiento de instantáneas tiene una anomalía fatal, que no es serializable, llamada “Sesgo de Escritura (Write Skew)”.
3.2 El Problema de la Guardia Médica y el Sesgo de Escritura (Write Skew)
El ejemplo más famoso para entender el sesgo de escritura es el “sistema de guardia (on-call) médica”.
【Regla de Negocio】 Supongamos que hay un sistema de gestión de turnos de un hospital con la regla de que “al menos un médico debe estar siempre de guardia (on-call)”.
Actualmente, dos médicos, Alice y Bob, están de guardia (on_call = true).
En ese momento, Alice y Bob por casualidad deciden al mismo tiempo que “no se sienten bien y quieren salir de la guardia”, e inician una transacción de cambio de turno desde sus respectivos terminales.
【Flujo de la Transacción (Bajo Aislamiento de Instantáneas)】
- [Tx1: Alice] Obtiene la instantánea. Confirma que actualmente son dos, Alice y Bob, los que están de guardia.
SELECT count(*) FROM doctors WHERE on_call = true;-> Resultado: 2 - [Tx2: Bob] Obtiene la instantánea. De igual manera, confirma que son dos, Alice y Bob.
SELECT count(*) FROM doctors WHERE on_call = true;-> Resultado: 2 - [Tx1: Alice] Juzga que se cumple la regla (1 o más de guardia), y se quita a sí misma de la guardia.
UPDATE doctors SET on_call = false WHERE name = 'Alice'; - [Tx2: Bob] Igualmente juzga que se cumple la regla, y se quita a sí mismo de la guardia.
UPDATE doctors SET on_call = false WHERE name = 'Bob'; - [Tx1: Alice] Confirmación (Commit) exitosa.
- [Tx2: Bob] Confirmación (Commit) exitosa. (Como Alice y Bob actualizan diferentes registros, los bloqueos de fila no compiten)
【Resultado】 Como resultado de que tanto Tx1 como Tx2 se confirmaron, el número de médicos de guardia se convirtió en “0”. La regla de negocio ha colapsado.
Esto es el Sesgo de Escritura (Write Skew). Si fuera serializable (Serializable), ya sea Tx1 o Tx2 se habría ejecutado en serie primero, por lo que la transacción ejecutada después habría detectado que el número de personas en guardia era “1”, y podría haber abortado (revertido) la operación de eliminarse a sí mismo. Sin embargo, en el aislamiento de instantáneas, dado que se actualizan filas de datos diferentes (la fila de Alice y la fila de Bob), no se detecta la colisión, provocando una inconsistencia en las reglas de negocio.
3.3 Anomalía de Solo Lectura (ReadOnly Anomaly)
Además, el aislamiento de instantáneas tiene una anomalía extremadamente particular llamada ReadOnly Anomaly, en la que la serializabilidad se rompe por la intervención de una “transacción de solo lectura”. Esta anomalía, ilustrada en ejemplos como el saldo de depósitos bancarios y el abono de intereses, es un fenómeno en el que, a pesar de que no se produce contención entre transacciones de actualización, una transacción de solo lectura, al mirar una instantánea del pasado, lee un “estado en una línea de tiempo lógicamente imposible”. Debido a la existencia de estas anomalías, el aislamiento de instantáneas se distingue del Serializable en sentido estricto.
Capítulo 4: Principios de Funcionamiento del MVCC (Multi-Version Concurrency Control)
Hasta aquí hemos hablado de la teoría de los niveles de aislamiento y las anomalías, pero, ¿cómo controlan las bases de datos modernas estos aspectos? La tecnología principal para esto es el MVCC (Multi-Version Concurrency Control: Control de Concurrencia Multiversión).
4.1 “La Lectura no Bloquea la Escritura, y la Escritura no Bloquea la Lectura”
El mayor concepto de diseño del MVCC, y la diferencia decisiva con el control basado en bloqueos (2PL), es el hecho de que “la lectura y la escritura no se bloquean mutuamente”. Al actualizar un registro, las bases de datos MVCC no sobrescriben directamente el registro existente (In-place update). En su lugar, crean una nueva versión del registro (versión, tupla) y mantienen la versión antigua al mismo tiempo.
Dentro de la base de datos, existirán múltiples versiones (un historial desde el pasado hasta el presente) del mismo registro simultáneamente. Cuando una transacción lee los datos, calcula y lee “la versión pasada correcta que debe leer” entre las numerosas versiones existentes en el sistema, basándose en su propio “ID de transacción (XID)” y “hora de inicio (marca de tiempo)”.
Gracias a esto, incluso mientras una transacción está modificando un registro, otras transacciones pueden leer “la versión pasada antes de ser modificada”, evitando las esperas por bloqueos.
4.2 Cadena de Gestión de Versiones de Tuplas y Reglas de Visibilidad (Visibility)
El algoritmo más importante en MVCC es la Regla de Visibilidad (Visibility Rule), que determina “qué transacción puede ver qué versión de los datos”.
A cada transacción se le asigna un ID de transacción (XID) único y monótonamente creciente en el momento de su inicio. A cada versión de los registros (tuplas) guardadas en la base de datos se le añade la siguiente información como metadatos:
- XID de creación: El ID de la transacción que creó esta versión mediante INSERT/UPDATE.
- XID de eliminación: El ID de la transacción que eliminó lógicamente (invalidó) esta versión mediante UPDATE/DELETE.
Cuando una transacción $T_i$ lee una fila de datos, evalúa la visibilidad basándose en las siguientes reglas básicas:
- ¿Está confirmada?: ¿La transacción del XID de creación ya ha sido confirmada (commit)?
- ¿No es del futuro?: ¿El XID de creación corresponde a una transacción pasada en relación al momento en que comenzó $T_i$?
- ¿No está eliminada?: ¿El XID de eliminación no está establecido, o la transacción del XID de eliminación aún no ha sido confirmada, o corresponde a una transacción futura respecto al momento en que comenzó $T_i$?
Evaluando estrictamente estas condiciones, se proporciona una instantánea consistente a cada transacción.
Capítulo 5: Las Diferencias Decisivas en la Implementación de MVCC entre PostgreSQL y MySQL (InnoDB)
Aunque la filosofía básica de MVCC es la misma, su implementación interna varía sorprendentemente dependiendo del producto de base de datos. Aquí, diseccionaremos y compararemos la arquitectura MVCC de PostgreSQL y MySQL (InnoDB), los dos gigantes del mundo del código abierto.
5.1 Implementación de MVCC en PostgreSQL: Añadido en Heap y la Necesidad de VACUUM
El MVCC de PostgreSQL adopta una “Arquitectura de solo adición (Append-only)” muy única e intuitiva.
5.1.1 Lógica de Evaluación de Bits con xmin y xmax
Dentro del archivo de datos (Heap) que es la entidad de la tabla de PostgreSQL, en la cabecera de cada fila (tupla) se registran dos ID de transacción: xmin y xmax.
xmin(Transaction ID of Insert): El XID de la transacción que creó esta tupla.xmax(Transaction ID of Delete): El XID de la transacción que eliminó esta tupla (o que la eliminó lógicamente mediante una actualización).
【Comportamiento de la Operación UPDATE】
En PostgreSQL, un UPDATE se procesa lógicamente como una combinación de DELETE e INSERT.
- Escribe el XID de la transacción actual en el
xmaxde la tupla antigua. (Eliminación lógica) - Crea una tupla completamente nueva en el espacio libre del Heap, escribe los nuevos datos y establece el
xmincon el XID de la transacción actual. (Nueva adición)
En otras palabras, tanto la tupla antigua como la nueva se guardan mezcladas dentro del mismo archivo de datos de la tabla (Heap).
5.1.2 Enorme Ventaja y Problema Fatal: La Existencia de VACUUM
La mayor ventaja de esta arquitectura es que el Rollback es extremadamente rápido. Si una transacción aborta, basta con tratar la tupla añadida como “no confirmada”, sin necesidad de deshacer los datos.
Sin embargo, como problema fatal, está el “hinchamiento por tuplas muertas (Dead Tuples)”.
Al repetir UPDATE y DELETE, las versiones antiguas de tuplas (tuplas cuyo xmax tiene un ID de transacción antigua confirmada) a las que ya nadie hace referencia se acumulan infinitamente en el Heap. Si se dejara esto así, el tamaño físico de la tabla se hincharía explosivamente y el rendimiento de los escaneos secuenciales se degradaría drásticamente.
El proceso del sistema para eliminar físicamente estas tuplas muertas y hacer reutilizable el espacio libre es VACUUM (y el demonio autovacuum que se ejecuta automáticamente). La razón por la que la optimización de VACUUM se considera extremadamente importante en la operación de PostgreSQL se debe a la raíz de esta arquitectura MVCC.
5.2 Implementación de MVCC en MySQL InnoDB: Actualización In-place y Reconstrucción Dinámica de Undo Logs
Por otro lado, InnoDB, que es el motor de almacenamiento predeterminado de MySQL, adopta una arquitectura basada en “Actualización in situ (In-place update) y Registro de Deshacer (Undo Log / Rollback Segment)”, que se acerca a la de Oracle Database.
5.2.1 Índice Agrupado y Actualización In-place
Las tablas de InnoDB están estructuradas como un B+Tree (índice agrupado / Clustered Index) basado en la clave primaria.
Cuando se ejecuta un UPDATE en InnoDB, en lugar de agregar una nueva fila como PostgreSQL, sobrescribe directamente la fila de datos en el B+Tree (In-place update).
Entonces, ¿qué sucede si otras transacciones quieren leer una instantánea del pasado? Para eso, InnoDB guarda los “datos antiguos” de antes de la sobrescritura en un área dedicada, el Undo Log (Segmento del Registro de Deshacer).
5.2.2 Reconstrucción Dinámica del Pasado mediante Roll Pointer
En las columnas ocultas de cada fila de datos de InnoDB se incluyen las dos siguientes:
DB_TRX_ID: El ID de la última transacción que insertó o actualizó esta fila.DB_ROLL_PTR(Roll Pointer): Un puntero que señala a la ubicación en el Undo Log donde se guarda la “versión un paso más antigua” de esta fila.
El proceso por el que una transacción lee una instantánea pasada es el siguiente:
- Lee la fila de datos más reciente del B+Tree.
- Comprueba el
DB_TRX_ID, y si es una actualización realizada por una transacción futura en relación a su instantánea, juzga que no debe leer esta fila más reciente. - Sigue el
DB_ROLL_PTRy obtiene los datos de la versión anterior del Undo Log. - Utilizando los datos en el Undo Log, reconstruye dinámicamente (Rollback in memory) el estado del registro pasado en la memoria.
- Si sigue siendo una actualización futura, retrocede aún más hacia el pasado en la cadena del Undo Log.
5.2.3 Ventajas y Problemas de InnoDB
La ventaja de esta arquitectura es que el área de la tabla principal (espacio de tabla / tablespace) no se hincha fácilmente. Dado que los últimos datos están siempre en la posición adecuada del B+Tree y las versiones pasadas están aisladas en otra área (Undo Log), la eficiencia del escaneo físico se mantiene alta (no se requiere un VACUUM a gran escala como en PostgreSQL, y el proceso de purgado del Undo Log funciona de forma ligera en segundo plano).
Por otro lado, la desventaja es que, si existen transacciones de larga duración (procesamiento por lotes o mysqldump, etc.) que leen grandes cantidades de instantáneas del pasado, se produce una sobrecarga al retroceder profundamente en los Undo Logs para reconstruir los datos, lo que degrada el rendimiento de lectura. Además, existe el riesgo de que el propio Undo Log se hinche y presione el espacio en disco.
Capítulo 6: Aislamiento de Instantáneas Serializables (SSI) y la Vanguardia de las Bases de Datos Distribuidas
La evolución de MVCC no termina aquí. Como se explicó en el Capítulo 3, el Aislamiento de Instantáneas (SI) tenía anomalías como el “Sesgo de Escritura” y no era un Serializable perfecto. Sin embargo, para no hacer conscientes a los desarrolladores de aplicaciones de la complejidad del procesamiento concurrente, es necesario lograr un Serializable perfecto manteniendo el alto rendimiento de MVCC.
6.1 El Nacimiento del Aislamiento de Instantáneas Serializables (SSI)
En 2008, en un artículo de Michael Cahill y otros, se publicó un algoritmo revolucionario llamado “Serializable Snapshot Isolation (SSI)”. Esta es una tecnología que, basándose en la arquitectura MVCC, garantiza la serializabilidad completa (Serializable). PostgreSQL, a partir de la versión 9.1, fue de los primeros en adoptar rápidamente este SSI como la implementación del nivel de aislamiento “Serializable”.
Principios de Funcionamiento de SSI: Grafo de Conflictos y Estructura Peligrosa (rw-antidependency)
SSI no bloquea usando cerrojos (locks). En su lugar, durante la ejecución de las transacciones, rastrea (track) detalladamente “qué datos se leyeron (Read) y qué datos se escribieron (Write)”.
SSI supervisa las relaciones de conflicto entre transacciones y busca un patrón de conflicto específico llamado “rw-antidependency (antidependencia lectura-escritura)”. Específicamente, es la relación donde la transacción $T_1$ lee datos de una versión anterior, y otra transacción $T_2$ sobrescribe y confirma esos datos posteriormente. SSI construye internamente un grafo de conflictos de las transacciones, y en el instante en que detecta una “estructura donde se suceden dos flechas de rw-antidependency (estructura peligrosa)”, determina que la serializabilidad puede colapsar y obliga a abortar (revertir) una de las transacciones.
Con esto, se detienen las transacciones antes de que ocurran anomalías como el sesgo de escritura (ejemplo: el problema de los médicos de guardia), garantizando como resultado un Serializable perfecto. Se podría decir que es la forma definitiva del control de concurrencia optimista (OCC).
6.2 MVCC en Bases de Datos Distribuidas: Spanner, CockroachDB, TiDB
La tecnología moderna de bases de datos ha superado los límites de un servidor único y está evolucionando hacia bases de datos SQL distribuidas (NewSQL) desplegadas en centros de datos de todo el mundo. En entornos distribuidos, lograr MVCC con consistencia global fue también un desafío contra las leyes de la física.
Google Spanner y TrueTime API
Spanner de Google desarrolló la TrueTime API para resolver el problema del ordenamiento de transacciones en sistemas distribuidos. Bajo la premisa de que los relojes (relojes físicos) de cada servidor siempre se desvían (desviación del reloj / clock skew), combinando GPS y relojes atómicos, proporciona la hora actual como un “rango de incertidumbre (ventana de tiempo)”. El MVCC de Spanner espera a que pase la ventana de incertidumbre de este TrueTime en el momento de la confirmación de la transacción (Commit Wait), garantizando así físicamente que “las transacciones con relaciones causales siempre tendrán el orden correcto de las marcas de tiempo (Consistencia Externa / External Consistency)”.
CockroachDB y HLC (Hybrid Logical Clock)
CockroachDB, que es una base de datos distribuida de código abierto inspirada en Spanner, para lograr una consistencia cercana a esto sin utilizar costosos relojes atómicos, adopta HLC (Reloj Lógico Híbrido). Al combinarse la sincronización del reloj físico mediante NTP y el Reloj Lógico de Lamport (un contador basado en relaciones causales entre eventos), genera marcas de tiempo de instantáneas MVCC globalmente consistentes entre nodos distribuidos, y realiza SSI (Serializable Snapshot Isolation) en un entorno distribuido.
TiDB y el Modelo Percolator
TiDB, desarrollado por la empresa PingCAP, adopta un modelo de transacciones distribuidas basado en el modelo Percolator de Google. Es una arquitectura en la que se prepara un componente único (Placement Driver: PD) que expide marcas de tiempo globales, y el motor de almacenamiento de cada nodo (TiKV) utiliza esa marca de tiempo para procesar el MVCC localmente. Aunque se basa en 2PC (Two-Phase Commit), minimiza el período de retención del bloqueo, logrando compatibilizar transacciones gigantes en entornos distribuidos con MVCC.
Conclusión: Más Allá de ACID
Los niveles de aislamiento de transacciones de bases de datos no son de ninguna manera un simple elemento para memorizar. Son, de hecho, la historia misma de la lucha de la informática de varias décadas sobre cómo armonizar las demandas contradictorias de la consistencia de los datos y el rendimiento del sistema.
Desde las definiciones incompletas de ANSI SQL-92, pasando por el salto exponencial en el procesamiento concurrente mediante MVCC, la bifurcación de las arquitecturas de PostgreSQL e InnoDB, hasta el desafío de la consistencia definitiva mediante SSI y bases de datos distribuidas. Comprender profundamente estas estructuras internas debería convertirse en un arma poderosa para diseñar aplicaciones más robustas y de alto rendimiento.
Ahora vivimos en una era en la que las propiedades ACID no son solo un “mito”, sino que se implementan como una “realidad” a través de algoritmos avanzados y sincronización de relojes físicos. Para los ingenieros que navegan por el mar de datos, conocer el abismo de los motores de bases de datos es un viaje de exploración intelectual verdaderamente inagotable.