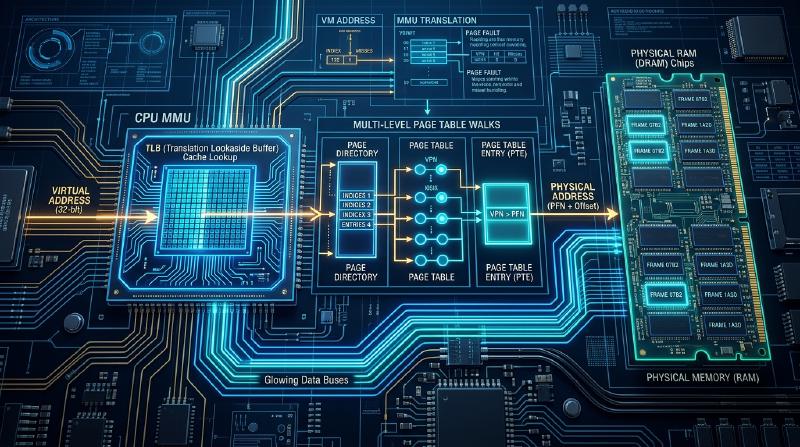
Vollständige Anatomie von virtuellem Speicher und Paging: Von MMU zu TLB, HugePage und den Tiefen der Speicherverwaltung
Eines der komplexesten, aber auch wichtigsten Systeme in modernen Betriebssystemen (OS) und CPU-Architekturen ist der Mechanismus des “virtuellen Speichers” (Virtual Memory) und des “Pagings” (Paging). Hinter dem Speicherplatz, den Anwendungsentwickler normalerweise nicht wahrnehmen, arbeiten die hardwareseitige MMU (Memory Management Unit) und der OS-Kernel eng zusammen und führen im Nanosekundenbereich gewaltige Adressübersetzungen und Ausnahmebehandlungen durch.
In diesem Artikel werden wir das virtuelle Speichersystem aus der Perspektive der internen Strukturen von Betriebssystemen und der Computerarchitektur bis in seine tiefsten Schichten analysieren. Vom vollständigen Bit-Layout der 4-stufigen Page-Table-Struktur der x86-64-Architektur über das IPI-Protokoll des TLB-Shootdowns, den vollständigen Trace von Page Faults im Linux-Kernel, den physikalischen Mechanismus von Copy-on-Write (CoW), Speicher-Reclaim-Algorithmen (Reclaim) bis hin zur Score-Berechnungsformel des OOM Killers werden die Low-Level-Mechanismen auf Quellcode- und Registerebene detailliert erklärt.
Kapitel 1: Der Grund für die Existenz von virtuellem Speicher und historischer Hintergrund
Warum benötigen Computer virtuellen Speicher? In frühen Computersystemen griffen Programme direkt auf bestimmte Adressen im physikalischen Speicher (RAM) zu. Mit der Verbreitung von Multitasking-Umgebungen stieß diese “direkte physikalische Adressierung” jedoch an ihre Grenzen.
1.1 Speicherschutz und vollständige Trennung von Prozessräumen
Der Hauptzweck des virtuellen Speichers ist die “Gewährleistung von Sicherheit und Stabilität”. Wenn Prozess A versehentlich (oder böswillig) den Speicher von Prozess B überschreibt, kann das gesamte System abstürzen oder vertrauliche Informationen können durchsickern. Der virtuelle Speicher vermittelt jedem Prozess die Illusion, “einen eigenen, kontinuierlichen Speicherraum zu haben”. Dadurch wird der Speicher zwischen den Prozessen auf Hardwareebene (MMU) strikt getrennt, und unzulässige Speicherzugriffe werden sofort abgefangen und als Segmentation Fault behandelt. Auch die Trennung von User-Space und Kernel-Space wird durch diesen Mechanismus realisiert, wobei der Übergang zwischen Privilegringen und die Überprüfung von Speicherzugriffsrechten in jedem Taktzyklus von der Hardware durchgeführt werden.
1.2 Überwindung der Grenzen der physikalischen Speicherkapazität und das Konzept des Demand Paging
Es ist nicht ungewöhnlich, dass die von Anwendungen benötigte Speichermenge die Kapazität des installierten physikalischen RAMs übersteigt. Der virtuelle Speicher bietet einen riesigen Adressraum, der größer ist als der physikalische Speicher, indem er derzeit nicht genutzte Speicherbereiche (Pages) auf sekundäre Speichergeräte (HDD/SSD) auslagert (Swap-Out) und bei Bedarf wieder einlädt (Swap-In). Außerdem werden nicht alle Codes und Daten beim Start des Programms in den Speicher geladen, sondern erst dann, wenn ein Zugriff erfolgt. Dieses Konzept des “Demand Paging” (Paging bei Bedarf) ermöglicht es, Speicherplatz zu sparen und gleichzeitig den Startvorgang zu beschleunigen.
1.3 Paradigmenwechsel von Segmentation zu Paging
In frühen x86-Prozessoren (wie dem 80286) wurde die “Segmentation” verwendet, bei der der Speicher in Blöcken variabler Länge verwaltet wurde. Bei dieser Methode wurden Register wie CS (Code Segment) und DS (Data Segment) verwendet, um die logische Adresse durch Basisadresse + Offset zu berechnen. Die Segmentation führte jedoch leicht zu “externer Fragmentierung” (Zersplitterung des Speichers) und die Verwaltung war äußerst komplex. Mit dem Erscheinen des 80386 wurde das “Paging” eingeführt, das den Speicher in Blöcken fester Länge (normalerweise 4KB) verwaltet und sich zum Standard entwickelte. Moderne 64-Bit-Betriebssysteme (Linux und Windows) haben die Segmentation als Flat-Memory-Modell (Basisadresse 0, maximales Limit) de facto deaktiviert und verwalten den Speicher ausschließlich über Paging. Die Segmentation wird heute nur noch für sehr wenige Zwecke verwendet, wie z.B. für Referenzen auf Thread Local Storage (TLS) (FS/GS-Register).
Kapitel 2: Vollständige Anatomie der mehrstufigen Page-Table-Struktur und des Bit-Layouts in x86-64
In 64-Bit-Architekturen (x86-64/AMD64) ist der virtuelle Adressraum riesig. Im derzeit vorherrschenden “48-Bit virtuellen Adressraum” durchläuft die Hardware-MMU 4 Stufen von Page Tables.
2.1 48-Bit/57-Bit virtueller Adressraum und die Einschränkung der kanonischen Form (Canonical Form)
Obwohl 64-Bit-Register einen gewaltigen Adressraum von 16 Exabyte darstellen können, wird dieser in aktuellen Hardware-Implementierungen aus Kosten- und Komplexitätsgründen nicht vollständig genutzt. Bei 48-Bit-Implementierungen besteht die Einschränkung, dass die Bits 47 bis 63 der virtuellen Adresse alle denselben Wert (Vorzeichenerweiterung) haben müssen. Adressen, die diese Bedingung erfüllen, werden als “kanonische Adressen” (Canonical Address) bezeichnet.
Dadurch entsteht eine Speicherstruktur mit einem riesigen ungenutzten Bereich (Non-canonical Hole) in der Mitte, der sauber in die untere Hälfte des User-Spaces (0x0000000000000000 - 0x00007FFFFFFFFFFF) und die obere Hälfte des Kernel-Spaces (0xFFFF800000000000 - 0xFFFFFFFFFFFFFFFF) unterteilt wird. Wenn ein ungültiger Zeiger dereferenziert wird (z. B. ein Zeiger, bei dem in den höchsten Bits Metadaten eingebettet sind), generiert die MMU sofort eine General Protection Exception (#GP) als Canonical Violation. In letzter Zeit wird ab Intel Ice Lake-Prozessoren auch ein noch weiter ausgedehnter 57-Bit virtueller Raum (5-stufige Page Tables) unterstützt, der die Grundlage für Cloud-Infrastrukturen zur Verwaltung von Speicher im Petabyte-Bereich bildet.
2.2 Details der 4-stufigen Page-Table-Hierarchie (PML4, PDPT, PD, PT)
Um eine 48-Bit virtuelle Adresse in eine physikalische Adresse zu übersetzen, verwendet x86-64 eine 4-stufige Page-Table-Struktur (Radix Tree). Jede Tabelle ist 4KB groß und enthält 512 64-Bit (8 Byte) Einträge (2^9 = 512). Die virtuelle Adresse wird wie folgt unterteilt und dient als Index für jede Ebene:
- Bits 39-47 (9 bits): PML4 (Page Map Level 4) Index - Höchste Ebene. Das CR3-Register zeigt auf die physikalische Basisadresse.
- Bits 30-38 (9 bits): PDPT (Page Directory Pointer Table) Index
- Bits 21-29 (9 bits): PD (Page Directory) Index - Bei 2MB HugePages ist dies die Endstation.
- Bits 12-20 (9 bits): PT (Page Table) Index - Die letzte Tabelle für reguläre 4KB-Pages.
- Bits 0-11 (12 bits): Page Offset - Der Offset innerhalb der 4KB (4096 Byte) Page.
2.3 Vollständige Tabelle des 64-Bit-Layouts von Page Table Entries (PTE)
Jeder 64-Bit-Eintrag in der Page Table ist nicht nur ein Zeiger auf eine physikalische Adresse, sondern eine Sammlung von Metadaten für leistungsstarke Zugriffs- und Cache-Steuerung. Nachfolgend finden Sie das vollständige Bit-Layout eines PTEs in x86-64 und seine detaillierten Funktionen.
- Bit 0 [P] Present: Wenn 1, existiert es im physikalischen Speicher. Wenn 0, wurde es ausgelagert oder noch nicht zugewiesen. Ein Zugriff bei 0 löst eine Page Fault (#PF) Exception aus.
- Bit 1 [R/W] Read/Write: Wenn 0, Read-Only (nicht beschreibbar); wenn 1, Read/Write möglich. Spielt eine äußerst wichtige Rolle bei der Implementierung von CoW (Copy-on-Write).
- Bit 2 [U/S] User/Supervisor: Wenn 0, nur Zugriff im privilegierten Modus (Kernel) möglich. Wenn 1, Zugriff auch aus dem User-Modus (Ring 3) möglich. Wird durch Mechanismen wie KPTI und SMAP streng verwaltet.
- Bit 3 [PWT] Page-level Write-Through: Wenn 1, wird die Cache-Schreibrichtlinie für diese Page auf Write-Through gesetzt. Wenn 0, Write-Back.
- Bit 4 [PCD] Page-level Cache Disable: Wenn 1, wird der Cache für diese Page deaktiviert (Uncacheable). Wird verwendet, wenn direkt auf Register von PCIe-Geräten zugegriffen wird, wie bei Memory-Mapped I/O (MMIO).
- Bit 5 [A] Accessed: Wird automatisch von der Hardware auf 1 gesetzt, wenn die MMU auf diese Page zugreift (Read oder Write). Wird vom LRU-Algorithmus des OS (Page Reclaim) als Referenzbit verwendet.
- Bit 6 [D] Dirty: Wird automatisch von der Hardware auf 1 gesetzt, wenn die MMU einen “Schreibvorgang” auf diese Page ausführt. Ein wesentliches Bit für das OS, um zu entscheiden, ob ein Rückschreiben auf die Festplatte (Swap-Out) erforderlich ist.
- Bit 7 [PAT] Page Attribute Table: In Kombination mit PWT/PCD ein Index zur Angabe detaillierterer Speicher-Cache-Typen (z. B. WC: Write-Combining). Wird für schnelle Bulk-Transfers zum Grafikspeicher (VRAM) usw. verwendet.
- Bit 8 [G] Global: Wenn 1, wird dieser Eintrag nicht aus dem TLB geflusht, selbst wenn das CR3-Register umgeschaltet wird (Kontextwechsel). Wird hauptsächlich für Pages im Kernel-Space verwendet, um TLB-Miss-Penalties bei System Calls zu vermeiden.
- Bits 9-11 [AVL] Available: 3 Bits, die dem OS (Kernel) frei zur Verfügung stehen. In Linux werden sie oft für Metadaten von Swap-Einträgen oder zur Identifikation von NUMA-Nodes genutzt.
- Bits 12-51 [PFN] Physical Frame Number: Die Basisadresse (Physical Frame Number) der physikalischen Zielseite. Da diese auf 4KB ausgerichtet ist, werden die unteren 12 Bits immer als 0 behandelt.
- Bits 52-62 [AVL/PKU] Available/Ignored: Reserviert durch CPU-Generationen oder Funktionserweiterungen (wie Intel MPK: Memory Protection Keys) oder vom OS nutzbare Bereiche.
- Bit 63 [XD/NX] Execute-Disable / No-eXecute: Wenn 1, werden die Daten auf dieser Page “als Anweisungen nicht ausführbar” markiert. Ein mächtiger Sicherheitsmechanismus (DEP: Data Execution Prevention) zur Verhinderung von Code-Injection-Angriffen in Datenbereichen durch Pufferüberläufe etc.
Wie Sie sehen, ist jedes Bit im PTE eng mit den Speicherverwaltungsalgorithmen des OS (insbesondere Swap-Verarbeitung, Sicherheitsschutz, I/O-Steuerung) gekoppelt, was ein äußerst raffiniertes Design als Schnittstelle zwischen Hardware und Software darstellt.
Kapitel 3: Hardware-Page-Table-Walk durch die MMU und die Mauer der Latenz
Die Übersetzung von virtuellen zu physikalischen Adressen wird durch eine dedizierte Hardwareschaltung namens MMU (Memory Management Unit) innerhalb der CPU-Kerne durchgeführt.
3.1 Der vom CR3-Register ausgehende Mechanismus des Table Walks
Das Kontrollregister CR3 des Prozessors speichert die physikalische Adresse der Top-Level Page Table (PML4) des aktuell ausgeführten Prozesses. Wenn Betriebssysteme wie Linux einen Kontextwechsel durchführen und die CPU-Ausführungsrechte an einen anderen Prozess übergeben, schreiben sie die PML4-Adresse des neuen Prozesses in dieses CR3-Register. Dadurch wird der gesamte Speicherraum des Prozesses augenblicklich umgeschaltet.
Der konzeptionelle Ablauf sieht wie folgt aus:
- Extrahieren des höchsten Index aus der virtuellen Adresse und Lesen des entsprechenden Eintrags in der PML4-Tabelle, auf die CR3 zeigt.
- Extrahieren der PFN aus dem PML4-Eintrag und Berechnen der physikalischen Adresse der nächsten PDPT-Tabelle.
- Lesen des entsprechenden Eintrags in der PDPT-Tabelle.
- Ebenso Durchlaufen der PD-Tabelle und der PT-Tabelle, um die Basisadresse der endgültigen 4KB-Physikalischen Page zu erhalten.
- Schließlich Addieren des 12-Bit-Page-Offsets, um die vollständige physikalische Adresse zu konstruieren.
3.2 Die größte Hürde: Speicherbuszugriff und Latenz
Die größte Schwäche dieses 4-stufigen Page-Table-Walks ist die “Speicherzugriffslatenz” (Memory Access Latency). Um nur eine einzige virtuelle Adresse zu übersetzen, erfolgen im schlimmsten Fall vier Zugriffe auf den physikalischen Speicher (Lesen von PML4, PDPT, PD, PT). Die Zugriffslatenz moderner DRAMs liegt bei etwa 50 bis 100 Nanosekunden. Wenn alle vier Speicherzugriffe den CPU-Cache (L1/L2/L3) verfehlen (Miss) und den DRAM erreichen, entsteht allein dadurch eine Verzögerung von mehreren hundert Nanosekunden. Wenn man bedenkt, dass ein CPU-Taktzyklus etwa 0,3 Nanosekunden (3 GHz) beträgt, entspricht dies einem fatalen Verlust von Tausenden von Zyklen, wodurch die CPU-Pipeline vollständig austrocknet und stoppt. Um diese extrem gravierende Leistungsschranke zu überwinden, wurde der TLB entwickelt, der im Folgenden erläutert wird.
Kapitel 4: TLB-Architektur in Multi-Core-Umgebungen und die Qualen des Shootdowns
Der TLB (Translation Lookaside Buffer) ist ein in die MMU integrierter “Cache für die Übersetzungsergebnisse von virtuellen zu physikalischen Adressen” und besteht aus extrem schnellem SRAM (oder CAM: Content Addressable Memory).
4.1 Die hierarchische Struktur des TLB und Optimierung durch PCID (Process-Context Identifier)
In modernen CPUs weist auch der TLB eine hierarchische Struktur von L1/L2 auf. Der L1 D-TLB (für Daten) und L1 I-TLB (für Befehle) haben eine sehr geringe Kapazität (Dutzende von Einträgen), antworten aber in 1 Zyklus. Der L2 TLB besitzt Hunderte bis Tausende von Einträgen und antwortet in wenigen Zyklen. Wenn kein Eintrag im TLB vorhanden ist (TLB Miss), tritt der zuvor erwähnte Hardware-Table-Walk (Page Walk) auf. Um diesen zu unterstützen, ist auch ein dedizierter Cache für Page Walks (PWC: Page Walk Cache) implementiert.
Da sich die Bedeutung von virtuellen Adressen ändert, wenn der Prozess gewechselt wird, wurde in der Vergangenheit (frühes x86) der TLB beim Umschreiben von CR3 vollständig gelöscht (Flush). Dies führte jedoch zu häufigen TLB Misses direkt nach einem Kontextwechsel und verringerte die Leistung erheblich. Um dies zu lösen, wurde die Technologie namens PCID (Process-Context Identifier) (in der ARM-Architektur als ASID bezeichnet) eingeführt. Durch das Hinzufügen einer 12-Bit-ID (Tag), die einen Prozess im TLB-Eintrag eindeutig identifiziert, wurde es möglich, TLB-Einträge früherer Prozesse auch nach einem Kontextwechsel beizubehalten, was die Leistung in Multi-Prozess-Umgebungen wie Webservern und Datenbanken drastisch verbesserte.
4.2 Inter-Processor Interrupt (IPI) Protokoll beim TLB Shootdown
In Multi-Core-Umgebungen ist das virtuelle Speichersystem mit einem sehr kniffligen Synchronisationsproblem konfrontiert. Angenommen, ein Prozess, der auf Core 0 (CPU0) ausgeführt wird, gibt einen bestimmten Speicherbereich mit munmap() frei und invalidiert das PTE in der Page Table (Present = 0). Im lokalen TLB von Core 1 (CPU1) könnten jedoch noch “alte Übersetzungsinformationen (Stale TLB Entry)” von dieser virtuellen zur physikalischen Adresse als Cache vorhanden sein.
In diesem Zustand könnte Core 1 auf bereits freigegebenen Speicher zugreifen, was zu schwerwiegenden Sicherheitslücken führen könnte, wie z. B. der Zerstörung von Daten, die anderen Prozessen zugewiesen wurden, oder dem Auslesen vertraulicher Informationen. Um dies zu verhindern, muss das OS Core 1 zwingen, den entsprechenden Eintrag aus seinem TLB zu löschen. Dies ist der TLB Shootdown.
Der TLB Shootdown wird streng in folgenden Schritten (IPI-Protokoll) ausgeführt:
- Initiator (Core 0): Nach der Aktualisierung der Page Table (Löschen des PTE) gibt Core 0 eine Speicherbarriere (wie
mfence) aus und sendet einen IPI (Inter-Processor Interrupt) an den lokalen APIC (Advanced Programmable Interrupt Controller) der Zielkerne (Core 1). - Warten (Busy Wait): Core 0 wartet mit einem Spinlock, bis alle anderen Zielkerne die Unterbrechung verarbeitet haben.
- Ziel (Core 1): Wenn Core 1 den IPI empfängt, unterbricht er sofort den aktuell ausgeführten User-Code und wechselt zum Interrupt-Handler des Kernels (in Linux z.B. zu
flush_tlb_funcübersmp_call_function). - Flush-Ausführung: Core 1 invalidiert den Eintrag der angegebenen virtuellen Adresse aus seinem lokalen TLB (in x86 unter Verwendung des Befehls
INVLPG, oder durch Neuladen von CR3 bei einem vollständigen Flush). - Abschlussbenachrichtigung: Core 1 schreibt den Abschluss des Flushes in ein Flag im Speicher und hebt die Warteposition von Core 0 auf. Danach kehrt er zum unterbrochenen Prozess zurück (
iret).
Leistungsengpässe und Skalierbarkeitsgrenzen: Der TLB Shootdown ist eine extrem teure Operation, die Zehntausende von Zyklen verschlingt, da sie das hardwareseitige Ausstellen von IPIs, Kontextwechsel bei Unterbrechungen, Pipeline-Flushes und Spinlock-Warten über mehrere Kerne hinweg umfasst. Wenn die Anzahl der Kerne auf 16, 64 oder 128 steigt, steigen diese Synchronisationskosten exponentiell an und stellen ein schwerwiegendes Hindernis für die Skalierung von Multi-Thread-Anwendungen in Cloud-Servern und HPCs dar (insbesondere für solche, die häufig Speicher zuweisen und freigeben).
Kapitel 5: Vollständiger Trace der Page-Fault-Behandlung im Linux-Kernel
Wenn ein Programm auf einen Bereich zugreift, dessen Present-Bit in der Page Table 0 ist, oder auf einen Bereich ohne Berechtigung (z. B. Versuch, in einen Read-Only-Bereich zu schreiben, oder Zugriff aus dem User-Modus auf einen Kernel-Bereich), gibt die MMU eine Page Fault Exception (in x86 Exception 14, #PF) aus. Von hier aus beginnt die Reise in die tiefgreifende Ausnahmebehandlung des Linux-Kernels.
5.1 Steuerungsfluss bei Page Faults und Trace der architekturabhängigen Teile
In der x86-64 Linux-Kernel-Umgebung sieht der Funktionsaufruf-Graph (Call Trace) beim Auftreten eines Page Faults wie folgt aus. Die Steuerung geht vom architekturabhängigen Low-Level-Handler an das architekturunabhängige generische Speicher-Subsystem über.
asm_exc_page_fault(Assemblersprache: arch/x86/entry/entry_64.S)- Die CPU erkennt die Ausnahme, die Hardware setzt die virtuelle Adresse, bei der der Fault aufgetreten ist, in das Register
CR2, sichert den Registerzustand auf dem Interrupt-Stack und springt zum Entry-Point des Kernels.
- Die CPU erkennt die Ausnahme, die Hardware setzt die virtuelle Adresse, bei der der Fault aufgetreten ist, in das Register
exc_page_fault()(C-Sprache: arch/x86/mm/fault.c)- Dies ist der architekturabhängige Fault-Handler. Er analysiert den Fehlercode (Read/Write, User/Kernel, PF usw.) und überprüft den Interrupt-Kontext.
do_page_fault()/do_user_addr_fault()- Stellt fest, ob der Fault im Kernel-Space (z. B. Bug oder vmalloc-Bereich) oder im User-Space aufgetreten ist. Im Falle des User-Spaces durchsucht er die Memory Map des Zielprozesses (Rot-Schwarz-Baum der
vm_area_struct, VMA-Liste) und prüft, ob die Adresse zu einem gültigen Bereich gehört (also kein Segmentation Fault ist).
- Stellt fest, ob der Fault im Kernel-Space (z. B. Bug oder vmalloc-Bereich) oder im User-Space aufgetreten ist. Im Falle des User-Spaces durchsucht er die Memory Map des Zielprozesses (Rot-Schwarz-Baum der
handle_mm_fault()(C-Sprache: mm/memory.c)- Ab hier beginnen die architekturunabhängigen Kernfunktionen. Er durchläuft jede Ebene der Page Table (PGD -> P4D -> PUD -> PMD -> PTE) und identifiziert die endgültige PTE-Adresse, wobei er gegebenenfalls neue Zwischenverzeichnisse (
pmd_allocusw.) alloziert, falls diese noch nicht zugewiesen wurden.
- Ab hier beginnen die architekturunabhängigen Kernfunktionen. Er durchläuft jede Ebene der Page Table (PGD -> P4D -> PUD -> PMD -> PTE) und identifiziert die endgültige PTE-Adresse, wobei er gegebenenfalls neue Zwischenverzeichnisse (
5.2 Die Essenz der Speicherzuweisung: Verzweigungen ab handle_mm_fault
handle_mm_fault() verzweigt die eigentliche Speicherzuweisungsverarbeitung in Abhängigkeit vom Zustand des identifizierten PTEs (ob das PTE leer ist, ausgelagert wurde oder ein Berechtigungsfehler vorliegt).
do_anonymous_page()(Die Krönung des Demand Paging): Wird aufgerufen, wenn das PTE vollständig leer (Null) ist. Dies ist der erste Zugriff auf eine Anonymous Page, die nicht mit einer Datei verknüpft ist, wie z. B. bei der Heap- (brkodermmaphintermalloc) oder Stack-Erweiterung. Der Kernel sichert hier zum ersten Mal physikalischen Speicher (Frames) vom Buddy-System (Buddy System), löscht diesen mit Nullen und ordnet ihn dem PTE zu. Dies spart Speicher, der nicht verwendet wird.do_fault()/__do_fault()(File-Backed Paging): Wird beim ersten Zugriff auf Dateien aufgerufen, die mitmmapgemappt wurden. Liest Dateidaten aus dem Page Cache oder ruft den Treiber des Dateisystems (ext4 oder xfs) auf, um Daten von der Festplatte zu laden, und mappt sie in die Page Table.do_swap_page()(Die Qual des Swap-In): Wird aufgerufen, wenn das Present-Bit des PTEs 0 ist, aber in anderen Flag-Bits die Offset-Information des Swap-Bereichs gespeichert ist. Lädt die Daten von der Festplatte (Swap-Partition oder Swap-Datei) wieder in den physikalischen Speicher. Da dies mit Disk-I/O verbunden ist, tritt der Prozess hier in einen langen Schlafzustand (Block) ein.do_wp_page()(Copy-on-Write): Dies ist die Verarbeitung des später beschriebenen CoW. Wird aufgerufen, wenn Present=1 ist, aber versucht wird, in eine Page zu schreiben, für die keine Schreibrechte existieren.
5.3 Physikalischer Mechanismus von Copy-on-Write (CoW) und die Magie des Referenzzählers
Der Systemaufruf fork(), das Herzstück der Prozesserstellung in Linux, arbeitet durch einen Lazy-Evaluation-Mechanismus namens CoW (Copy-on-Write) extrem schnell. Selbst wenn der Elternprozess mehrere Gigabyte Speicher verbraucht, schließt fork() sofort ab. Im Folgenden wird der physikalische Mechanismus dahinter erläutert.
- Gemeinsame Nutzung der Page Table:
Wenn
fork()aufgerufen wird, kopiert der Kernel die Page Table des Elternprozesses exakt in den Kindprozess. Der physikalische Speicher selbst wird jedoch überhaupt nicht kopiert. Die PTEs von Eltern- und Kindprozess zeigen auf denselben physikalischen Speicher (Frames). - Erzwungenes Setzen des Read-Only-Bits (Write-Protect):
Zu diesem Zeitpunkt überschreibt der Kernel zwangsweise die
R/W-Bits aller gemeinsam genutzten Pages in den PTEs auf0(Read-Only) (einschließlich der Datenbereiche, die ursprünglich beschreibbar waren). - Inkrementieren des Referenzzählers (Reference Count):
Die Kernel-Datenstruktur zur Verwaltung der entsprechenden physikalischen Page (
_refcountinstruct page) wird inkrementiert, sodass ihr Zustand als “von 2 Prozessen referenziert” markiert ist. - Schreiben und Page Fault (Trigger für do_wp_page):
Wenn entweder der Eltern- oder der Kindprozess versucht, Variablen oder Heap-Bereiche, die gemeinsam genutzt werden, zu beschreiben (Write), erkennt die Hardware-MMU das
R/W=0und löst sofort einen Page Fault aus. - Duplizieren der Page (Duplication):
Vom Page-Fault-Handler wird
do_wp_page()aufgerufen. Der Kernel überprüft die VMA-Flags und kommt zu dem Schluss: “Dies ist kein unzulässiger Zugriff, sondern ein rechtmäßiger Fault durch CoW”. Er alloziert eine neue physikalische Page aus dem Buddy-System und kopiert die Daten der ursprünglichen Page komplett (copy_page). - Aktualisieren des PTE und Dekrementieren des Referenzzählers:
Das PTE des Prozesses, der den Schreibvorgang ausgeführt hat, wird auf die neue physikalische Page umgeleitet, und das
R/W-Bit wird auf1gesetzt (Read/Write möglich). Der Referenzzähler der ursprünglichen physikalischen Page wird dekrementiert. Wenn der Referenzzähler den Wert 1 erreicht, bedeutet dies, dass der andere Prozess diese Page exklusiv besitzt. Wenn dieser Prozess das nächste Mal einen Fault verursacht, muss der Speicher nicht mehr kopiert werden; das R/W-Bit wird einfach wieder auf 1 gesetzt (Wiederverwendung der Page).
Auf diese Weise ist CoW ein künstlerischer Algorithmus, bei dem die Hardware-Schutzfunktion der MMU (Read-Only-Trap) und die Software-Steuerung des Kernels perfekt miteinander verschmelzen und so drastische Speichereinsparungen und schnelle Prozessstarts realisieren.
Kapitel 6: Die Tiefen der Speicher-Reclaim-Algorithmen und das Urteil des OOM Killers
Physikalischer Speicher ist begrenzt. Wenn ein System über einen längeren Zeitraum läuft und Dateicaches sowie Prozess-Heaps den Speicher aufzehren, muss das OS bestehende Speicherbereiche freigeben und zurückfordern (Reclaim), um neuen Speicher zu sichern. Dieses Speicher-Reclaim-Subsystem ist einer der komplexesten und schwer verständlichsten Bereiche im Linux-Kernel.
6.1 Aktive/Inaktive LRU-Listen und Pseudo-LRU-Algorithmen
Der Linux-Kernel verwendet LRU-Listen (Least Recently Used), um physikalische Pages zu verwalten und zu verfolgen. Es ist jedoch aus Gründen der Lock-Konkurrenz und der Scan-Kosten unmöglich, alle Pages mit einem strikten LRU-Verfahren zu verwalten. Daher wird ein Pseudo-LRU-Algorithmus (eine Variante des Clock-Algorithmus) verwendet, der zwei Warteschlangen (Listen) einsetzt: eine “Active-Liste” und eine “Inactive-Liste”.
- Active-Liste: Eine Sammlung von “heißen” Pages, auf die in letzter Zeit häufig zugegriffen wurde. Diese stehen nicht zur Rückforderung an.
- Inactive-Liste: Eine Sammlung von “kalten” Pages, auf die schon länger nicht mehr zugegriffen wurde. Die Pages am Ende (tail) dieser Liste werden nacheinander zu Kandidaten für die Rückforderung.
Wie erfährt der Kernel, ob auf eine Page zugegriffen wurde? Hier kommt das im Kapitel 2 erläuterte Accessed-Bit (A-Bit) des PTEs ins Spiel. Der Kernel (kswapd) scannt regelmäßig die Page Tables, liest das A-Bit aus dem PTE aus, zeichnet die Zugriffshistorie auf der Softwareseite auf und löscht dann das A-Bit auf 0. Wenn das A-Bit durch die Hardware erneut auf 1 gesetzt wird, verbleibt diese Page in der Active-Liste oder wird von der Inactive-Liste hochgestuft. Wird es nicht gesetzt, wird sie allmählich an das Ende der Inactive-Liste degradiert.
6.2 kswapd-Daemon und der Schrecken des Direct Reclaims
Wenn der freie Speicherplatz (Free Pages) unter einen bestimmten Schwellenwert (Watermark: low) fällt, erwacht der Hintergrund-Thread des Kernels kswapd (der für jeden NUMA-Knoten existiert).
kswapd entnimmt Pages vom Ende der Inactive-Liste.
- Wenn es sich um einen sauberen Dateicache (unveränderte Dateidaten) handelt, wird dieser einfach verworfen (Drop), um Speicherplatz freizugeben.
- Wenn es sich um einen schmutzigen (geänderten) Dateicache handelt, wird er vor dem Verwerfen auf die Festplatte zurückgeschrieben (Writeback).
- Wenn es sich um eine Anonymous Page handelt (Heap oder Stack eines Prozesses), wird sie in den Swap-Bereich ausgelagert (Swap-Out).
Diese Hintergrundarbeit wird fortgesetzt, bis der freie Speicherplatz das
highWatermark erreicht.
Wenn jedoch die Speicherzuweisungsgeschwindigkeit (Memory Pressure) einer Anwendung extrem hoch ist und die Rückforderungsgeschwindigkeit von kswapd nicht Schritt halten kann, sodass der freie Speicher unter den äußersten Schwellenwert (min Watermark) fällt, wird das Direct Reclaim (Direct Reclaim) ausgelöst.
Beim Direct Reclaim wird die Speicher-Reclaim-Verarbeitung (Verwerfen von Caches oder Auslagern) synchron direkt im Kontext des Prozesses ausgeführt, der den Speicher angefordert hat (die Anwendung selbst). Sobald das Direct Reclaim eintritt, blockiert die Ausführung der Anwendung (Abschluss von malloc oder Page Faults) vollständig (Stall). Dies ist eine direkte Ursache für schwerwiegende Leistungseinbußen (Latency Spikes) von Hunderten von Millisekunden bis hin zu mehreren Sekunden. Für Datenbanken oder Echtzeitsysteme ist das Tuning (vm.swappiness oder Watermark-Anpassungen) zur Vermeidung dieses Problems unerlässlich.
6.3 Die Score-Berechnungsformel des OOM Killers und die Verurteilung von Prozessen
Selbst nach Durchführung des Direct Reclaims, wenn auch der Swap-Bereich erschöpft ist, alle Caches aufgebraucht sind und auf keine Weise mehr Speicher zugewiesen werden kann, beschwört der Linux-Kernel als letzten Ausweg den OOM (Out Of Memory) Killer.
Der OOM Killer verhindert, dass das gesamte System aus Speichermangel in Panik gerät (Kernel-Crash oder vollständiges Einfrieren), indem er Prozesse, die große Mengen an Speicher verbrauchen, “zwangsbeendet (SIGKILL)” und den Speicher zurückfordert. Es gibt einen unbarmherzigen Algorithmus zur Bestimmung des Opfers.
Die Entscheidung, welcher Prozess getötet wird, basiert auf einem Bewertungswert namens oom_score (berechnet durch die Funktion oom_badness() in mm/oom_kill.c des Kernels).
Die grundlegende Berechnungslogik des OOM Scores (Konzept):
- Basis-Score: Der Anteil des aktuell vom Prozess genutzten Speichers (RSS: Resident Set Size + Größe der Page Tables + Swap-Nutzung) am Gesamtspeicher. Maximal 1000 Punkte. Das heißt, je mehr Speicher ein Prozess verbraucht (z. B. ein Prozess, der ein Memory Leak hat), desto wahrscheinlicher ist es, dass er getötet wird.
- Milderung bei Root-Rechten: Prozesse, die mit Root-Rechten ausgeführt werden (z. B. Kern-Daemons des Systems), haben eine hohe Wahrscheinlichkeit, für die Systemwartung unerlässlich zu sein. Ihr Score wird daher etwas reduziert (Minus), was es schwieriger macht, sie zu töten.
- Benutzeranpassungswert (OOM Score Adj): Der Wert aus
/proc/[pid]/oom_score_adj(-1000 bis +1000) wird addiert. Systemadministratoren können dies verwenden, um das Verhalten des OOM Killers zu steuern. Ein Prozess, dessen Wert auf -1000 gesetzt ist (z. B. sshd, kubelet, Datenbank-Masterprozess usw.), wird “von der OOM-Killer-Auswahl ausgenommen (unbesiegbar)”.
Wenn der OOM Killer aktiv wird, wird eine Nachricht wie “Out of memory: Killed process 1234 (java)” im Kernel-Log (dmesg oder /var/log/messages) ausgegeben, zusammen mit der damaligen Prozessliste, den jeweiligen Scores und einem detaillierten Dump des Speicherzustands. Durch das Verständnis dieser Logs und des Score-Berechnungsmechanismus können Systemadministratoren die Ursachen für unerwartete Prozessbeendigungen ermitteln und angemessene Ressourcenbeschränkungen (cgroups oder ulimit) festlegen.
Kapitel 7: Neueste Hochgeschwindigkeits-Speichertechniken und Hardware-Sicherheit
7.1 Die Macht von 2MB/1GB HugePages und Vor- und Nachteile von THP
Ein wirkungsvolles Mittel zur Lösung der in den Kapiteln 3 und 4 beschriebenen Verzögerungen durch TLB Misses und Table Walks ist “HugePage”. Anstelle von regulären 4KB-Pages werden riesige Pages von 2MB (die bereits auf der Ebene des Page Directory direkt auf die physikalische Adresse zeigen, wodurch die PT-Ebene übersprungen wird) oder 1GB (direkt auf der PDPT-Ebene) verwendet.
Dadurch kann ein einziger TLB-Eintrag einen riesigen Speicherbereich (das 512-fache oder 260.000-fache von 4KB) abdecken, wodurch TLB Misses drastisch reduziert werden. In Datenbanken mit vielen zufälligen Zugriffen auf große Datenmengen (Oracle, PostgreSQL) oder in Virtualisierungsumgebungen (KVM/QEMU) ist die Nutzung von HugePages ein unerlässlicher Punkt beim Performance-Tuning.
THP (Transparent Huge Pages) von Linux ist ein Mechanismus, bei dem der Hintergrund-Thread des Kernels (khugepaged) kontinuierliche 4KB-Pages automatisch in 2MB-HugePages integriert (Defragmentierung), ohne dass die Anwendung dies bemerken muss. In Umgebungen mit starker Speicherfragmentierung verbraucht dieser Integrationsprozess (Speicherkompaktierung) jedoch selbst viel CPU-Leistung und verursacht Latency Spikes. Daher wird empfohlen, THP in In-Memory-KVS wie Redis zu deaktivieren (never oder madvise).
7.2 Kernel Page-Table Isolation (KPTI) und der Preis der Meltdown-Gegenmaßnahmen
Die 2018 entdeckte Schwachstelle der spekulativen Ausführung von CPUs, “Meltdown (CVE-2017-5754)”, war ein fataler Fehler, der die Grundlagen der Hardware erschütterte, da es dadurch möglich war, unzulässig aus dem Kernel-Speicherbereich (Cache) aus User-Prozessen herauszulesen.
Als Gegenmaßnahme wurde auf der Betriebssystemseite KPTI (Kernel Page-Table Isolation) (anfangs als KAISER bezeichnet) eingeführt.
Zuvor war der gesamte Kernel-Bereich in der oberen Hälfte der Page Table abgebildet, auch wenn Code im User-Space ausgeführt wurde, um den Overhead bei Kontextwechseln zu verringern (mit der Prämisse, dass die Privilegienprüfung durch das U/S-Bit des PTEs erfolgte und Zugriffe abgelehnt würden). Die spekulative Ausführung umging diese Privilegienprüfung jedoch.
Nach der Einführung von KPTI wird bei der Ausführung im User-Space eine “minimale Shadow Page Table (User PGD)” verwendet, die den Großteil des Kernels nicht mappt. Beim Wechsel in den Kernel-Space durch Systemaufrufe oder Interrupts muss das Register CR3 zwingend umgeschaltet und in die vollständige Kernel Page Table (Kernel PGD) neu geladen werden.
Dadurch wurde die Sicherheit zwar vollständig gewährleistet, aber bei jedem Systemaufruf oder Interrupt entsteht nun ein teurer CR3-Wechsel (und die Verwaltung von PCID/TLB-Flushes). Bei I/O-intensiven Anwendungen (Webserver oder Datenbanken, die häufig Syscalls nutzen) führt dies zu einem nicht vernachlässigbaren Performance-Overhead von einigen Prozent bis hin zu über zehn Prozent.
7.3 Direct I/O und die Evolution der Zero-Copy-Technologie
Um Dateieingaben und -ausgaben (File I/O) zu optimieren, wendet das OS die Mechanismen des virtuellen Speichers in vollem Umfang an.
Die Verwendung des Systemaufrufs mmap() bildet den Inhalt der Datei direkt in den virtuellen Adressraum ab. Bei einem Zugriff tritt ein Page Fault auf, die Dateidaten werden in den Page Cache geladen, und der User-Space kann direkt über einen Zeiger darauf zugreifen.
Darüber hinaus wird bei Netzwerkübertragungen oder Storage-I/O die Zero-Copy-Technologie eingesetzt, um das Kopieren von Daten durch die CPU zwischen Kernel-Space (Page Cache) und den Puffern im User-Space (ein Kopieren, das mit einem Kontextwechsel einhergeht) zu eliminieren. Durch den Systemaufruf sendfile() oder die neuesten Technologien wie io_uring und AF_XDP wird in Zusammenarbeit mit dem DMA-Controller (Direct Memory Access) der Netzwerkkarten (NIC) oder NVMe-Laufwerke das PTE in der Page Table so manipuliert, dass die Pages des Kernels direkt in den User-Space “umgehängt” (remapped) werden, wodurch der Overhead durch das Kopieren im Speicher vollständig eliminiert wird. Auch hier ist der zugrunde liegende Mechanismus die geschickte Manipulation der Page Tables.
Fazit
Virtueller Speicher und das Paging-System bilden eine äußerst hoch entwickelte Symphonie zwischen dem OS-Kernel und der CPU (Hardware). Angefangen von der Festlegung eines einzigen Flag-Bits in der Page Table, den Qualen der Spinlocks beim TLB-Shootdown, der Speichermagie durch den Referenzzähler in CoW bis hin zu den kalten Heuristiken des OOM Killers, birgt die Tiefe dieses Systems das gesammelte Wissen der Informatik zu der Frage: “Wie lassen sich begrenzte physikalische Ressourcen sicher und schnell abstrahieren, um Prozessen die Illusion von unendlichem Speicher zu vermitteln?”
Das Verständnis dieser Low-Level-Mechanismen ist nicht nur unerlässlich für die Optimierung in Systemprogrammiersprachen wie C/C++ oder Rust (Entwurf von Datenstrukturen im Hinblick auf Cache-Lines oder effektive Nutzung von mmap), sondern auch, um Pausenzeiten der Garbage Collection (STW) oder das Verhalten von Speicherallokatoren (wie jemalloc oder tcmalloc) in höheren Sprachen wie Go oder Java tiefgreifend zu verstehen. Wer den Schleier der System-“Magie” lüftet und den Puls der Hardware und des Kernels direkt spürt, dem öffnet sich der Weg zu einem herausragenden Architekten, der fähig ist, elegantere und skalierbarere Software zu entwerfen.